Claude变笨真相:调错Effort比换大模型更烧钱
现象级困惑:Claude为何突然“降智”?
近期,开发者社区中流传着一种普遍的不满情绪:曾经犀利高效的Claude Code似乎变得迟钝、笨拙,甚至频繁出现“罢工”行为。许多用户反馈,原本流畅的代码生成任务突然中断,该读取的文件被忽略,该执行的测试被跳过,甚至在处理复杂工程任务时,AI会突然停止输出并反向索取更多上下文信息。
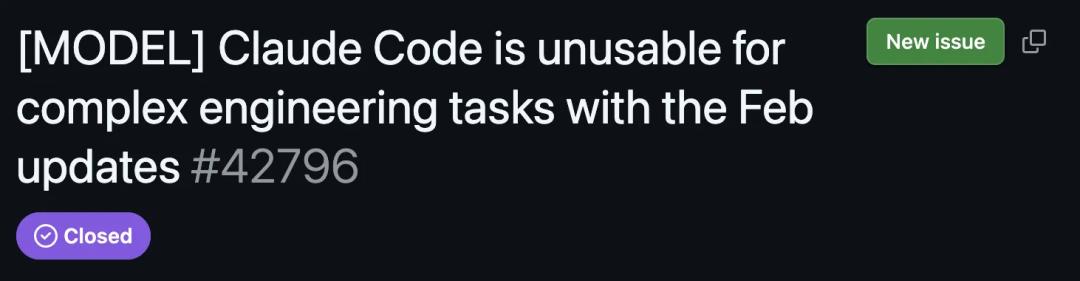
这种体验上的落差迅速发酵。AMD的AI负责人Stella Laurenzo在GitHub上发布了一项令人震惊的分析,通过对6852个会话日志的实测,指出Claude的思考量相比此前下降了67%。这一数据成为引爆舆论的关键点,甚至有观点直言“Claude已无法胜任复杂的工程工作”。
面对铺天盖地的质疑,Anthropic官方最终出手澄清。这场风波的根源并非模型算法的退化,也非权重的错误,而是一个被无数用户忽视的设置开关。问题的本质,在于用户混淆了“智力”与“努力”的概念,错误地将效能瓶颈归咎于模型本身的实力。
核心误区:Model是脑子,Effort是态度
要理解这一现象,首先必须厘清Claude Code中两个关键选项的本质区别:Model(模型)与Effort(努力度)。
Model选项,本质上是在更换一套“冻结的权重”。大语言模型的能力上限由训练数据决定,推理阶段无法改变其底层知识。当你切换Sonnet、Opus或Fable时,你改变的是模型的认知边界、逻辑推理能力和知识储备。这解决的是“会不会”的问题。例如,对于训练后出现的新库或新API,模型本身并未记忆,若强行要求调用,它可能因权重惯性而胡编乱造。
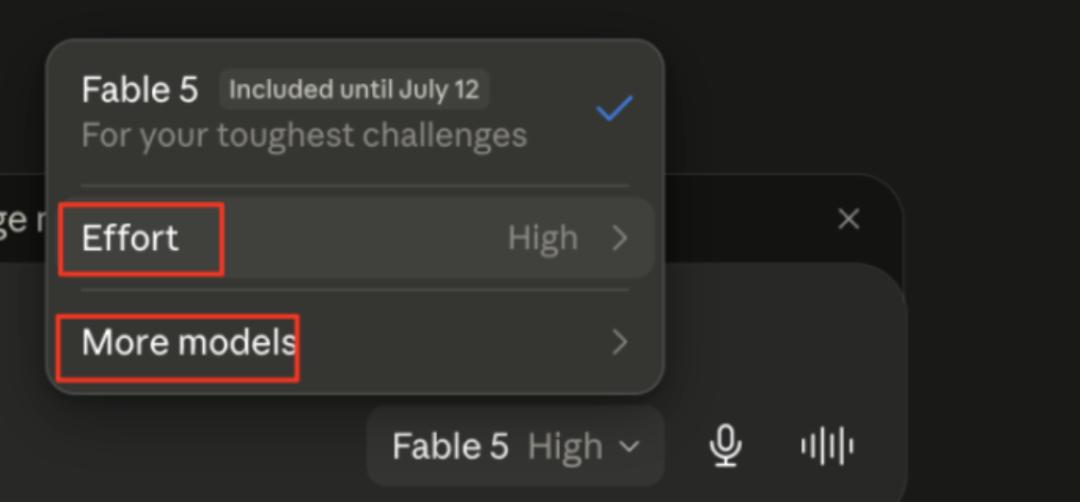
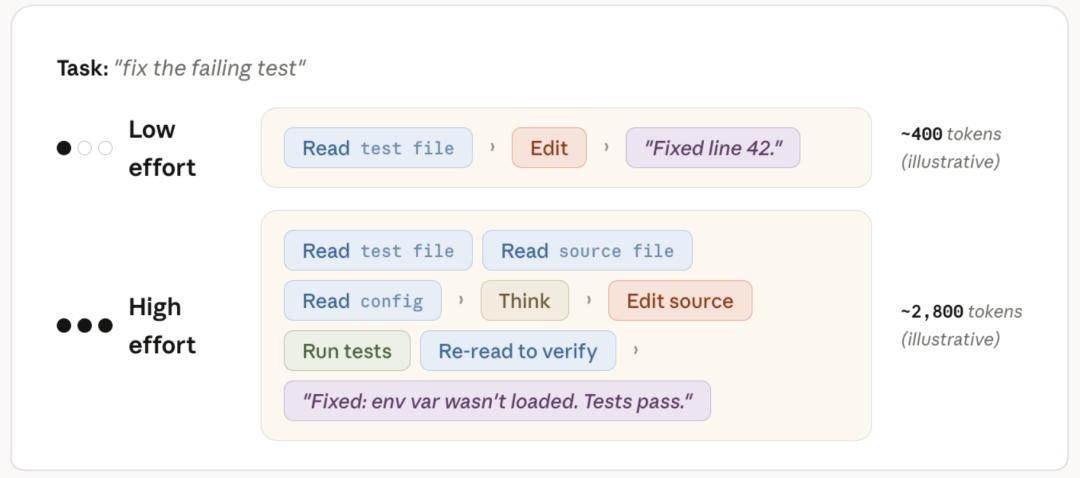
相比之下,Effort选项调控的是AI在单次任务中的“投入程度”。它并不改变模型的智力水平,而是决定AI愿意为你耗费多少计算资源去探索问题。低Effort模式下,AI倾向于快速给出一个“足够好”的回答,避免深度的文件读取或复杂的工具调用;而高Effort模式下,AI会被允许进行更广泛的上下文扫描、多次工具验证以及长链条的逻辑推演。
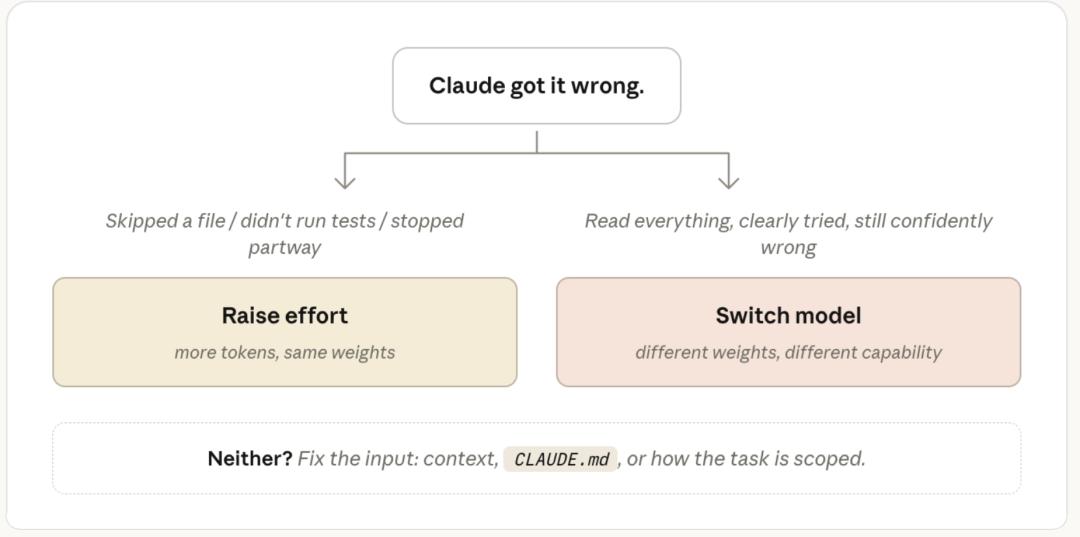
官方数据显示,在同一条Prompt下,开启高Effort生成的Token数量约为低Effort的7倍。这些多出的Token并非冗余废话,而是被用于读取更多代码文件、执行测试用例、交叉验证逻辑细节。换言之,Effort换的是AI的工作态度和勤奋程度。
深度解析:为何“小马拉大车”有时更优?
这一认知反转揭示了一个反直觉的工程真理:在特定场景下,小模型配合高Effort,其表现可能远超大模型配合低Effort。
我们可以将不同的模型角色化以辅助理解。
Sonnet如同一位“全能型选手”,拥有扎实的常规技能,若给予充足的时间(高Effort),它会仔细审阅项目结构,执行测试,确保代码的正确性与完整性。它虽不具备顶尖专家级的直觉,但胜在全面且稳定。
Opus则像一位“限时专家”,拥有深厚的行业直觉和丰富的避坑经验,但其可用时间(Token预算或思考深度)受到严格限制。若开启低Effort,Opus可能仅能扫视关键文件,难以覆盖整个项目的全貌。
Fable则是“专科专家”,仅在常规手段无效时启用,用于解决极高难度的特定难题。
在实际工程中,若将Opus设为低Effort,它可能因未深入阅读所有依赖文件而忽略潜在冲突;而Sonnet设为高Effort,虽推理速度慢,却可能通过全面覆盖上下文发现并修复更多隐蔽Bug。因此,简单迷信“大模型=高质量”是严重的认知偏差。
决策框架:如何精准诊断AI错误?
面对AI的输出错误,开发者应建立一套标准化的诊断流程,而非盲目换模型。
第一步:检查上下文完整性。 80%以上的“AI变笨”案例,根源在于Prompt描述不清、关键文件未加载或CLAUDE.md配置缺失。确保AI获取了完成任务所需的所有背景信息。
第二步:区分“能力不足”与“努力不足”。 若AI跳过文件读取、中断测试流程或中途反问索取信息,这属于“努力不足”。此时,提升Effort档位是最佳解法。若AI在充分阅读代码、执行测试后仍给出错误逻辑,则属于“能力不足”,此时应考虑升级至更强的模型(如从Sonnet升级至Opus)。
第三步:动态分配资源。 简单的语法修改、格式化任务,使用Sonnet低Effort即可秒回,成本低廉。 大型重构、多模块联动调整,使用Sonnet或Opus高Effort,确保逻辑严密。 极端疑难Bug排查,调用Fable高Effort,发挥其专项突破能力。
范式转移:从算力竞争到调度艺术
这场风波标志着AI应用进入新阶段:竞争焦点正从“谁的模型参数更大”转向“谁更擅长智能体调度”。
过去的开发模式是“人挑最强模型,全盘托管”。现在的模式要求开发者具备“项目经理”思维,根据任务难度动态分配模型与资源。
Anthropic近期推出的Ultracode模式,正是这一理念的体现。它不仅提供极高的Effort等级,还授权AI在遇到复杂任务时,自主启动多智能体协作(Multi-Agent),将任务拆解、并行处理。这进一步验证了“调度”已成为核心生产力。
对于企业而言,忽视Effort设置而一味购买顶级模型,等同于用最昂贵的赛车跑出租车业务,既浪费算力又无法发挥其性能。反之,合理利用Effort机制,让合适的模型做合适深度的思考,不仅能显著提升代码质量,更能将Token成本降低数倍。
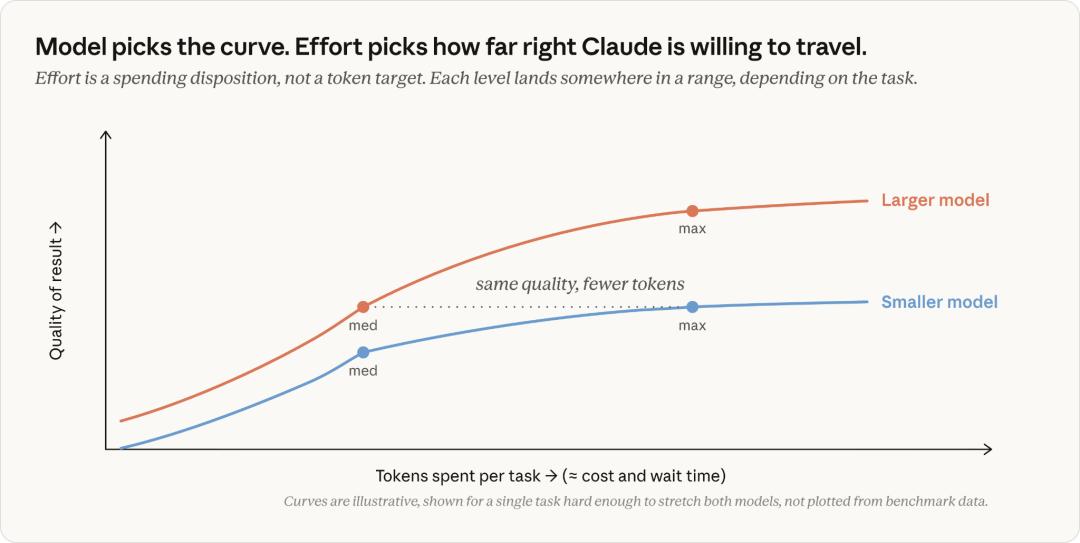
在AI编程日益普及的今天,掌握“如何给AI派活”已成为开发者的必备硬技能。只有深刻理解模型能力边界与努力度机制,才能真正驾驭智能化工具,将每一分算力都花在刀刃上。否则,再强大的模型,也不过是一个更昂贵的搜索引擎。