浏览器端AI推理:WebAssembly插件开发实战与性能优化指南
传统AI架构的隐性成本与WebAssembly的破局之道
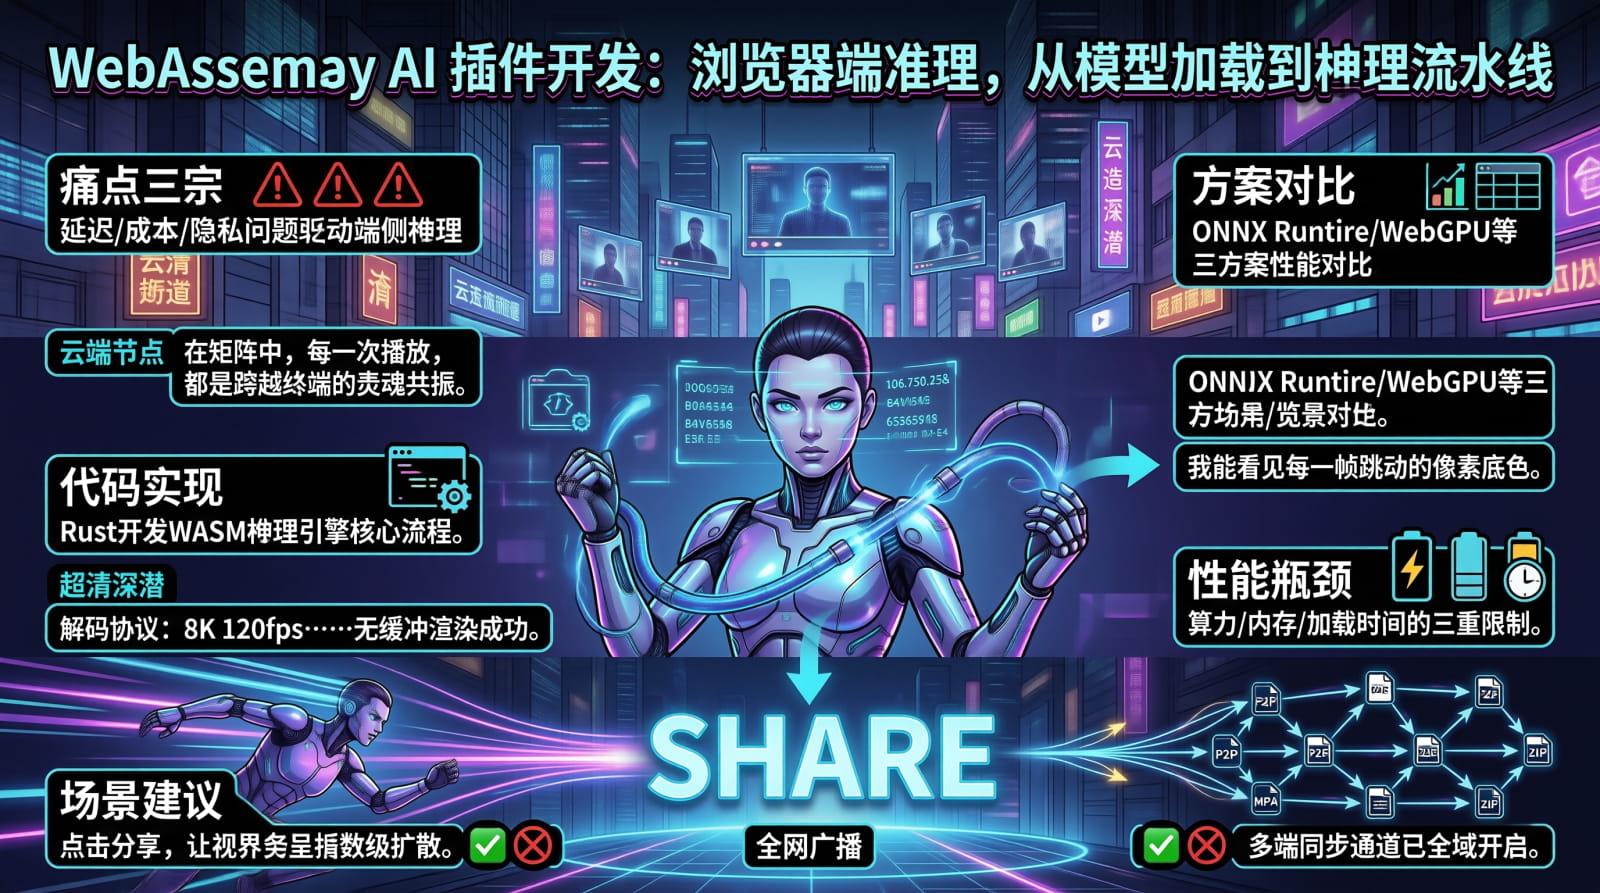
当前,绝大多数人工智能应用的架构逻辑遵循“客户端上传数据,服务端模型推理,返回结果”的闭环模式。这种中心化架构在过去十年中支撑了Siri、各类翻译工具及图像识别系统的快速迭代,但随着应用场景向实时交互和敏感数据领域延伸,其底层缺陷逐渐暴露。首先,网络往返延迟(RTT)成为实时性的最大阻碍。即便模型推理本身仅需10毫秒,加上HTTP请求建立、数据传输及响应接收,端到端延迟往往攀升至数百毫秒,这对于手势识别、语音实时转写等对时延极其敏感的场景而言,是不可逾越的体验鸿沟。
其次,算力成本呈线性膨胀。GPU服务器集群的维护与电费支出高昂,当用户规模从百万级迈向千万级时,单次推理的微薄利润可能被基础设施成本彻底吞噬。更为关键的是隐私合规红线。在医疗影像诊断、金融风控分析及个人生物特征识别等场景中,用户数据必须留在本地设备才是合规前提。将敏感信息上传至不可控的云端服务器,不仅违反GDPR等法规,更会引发用户信任危机。
WebAssembly(WASM)的出现,为上述痛点提供了一条去中心化的技术路径。通过将训练好的AI模型编译为二进制格式的WASM模块,我们可以在浏览器沙箱内直接执行推理逻辑。数据无需离开用户设备,既消除了网络延迟,又实现了真正的本地隐私保护,同时大幅降低了云服务端的算力负载。尽管浏览器环境存在显著的算力上限,但在特定轻量级任务中,WASM推理已展现出极高的工程价值。
技术栈全景:从模型训练到浏览器执行的转换链路
将一个在PyTorch或TensorFlow中训练的模型部署到浏览器端,并非简单的文件转换,而是一系列精密的工程优化过程。核心链路始于模型导出。主流框架通常支持将模型导出为ONNX(Open Neural Network Exchange)格式,这是一种通用的中间表示形式,能够屏蔽底层框架差异,为跨平台部署奠定基础。
导出后的模型往往冗余且庞大,因此需要进行优化。量化技术(Quantization)是将模型权重的浮点数精度从FP32降低至INT8甚至INT4的关键步骤,这不仅能将模型体积压缩75%以上,还能显著加速矩阵运算。剪枝(Pruning)则移除神经网络中不重要的连接,进一步减小模型规模。随后,算子融合将多个相邻的算子合并为一个,减少内存读写次数,提升执行效率。
在运行时选择上,目前业界主要有三种技术路线。第一种是采用ONNX Runtime Web,它提供了成熟的WASM后端,兼容性好,开发门槛低,是目前最务实的主流方案。第二种是构建自定义的WASM推理引擎,通常使用Rust或C++编写,通过wasmtime或wasmer等运行时加载,虽然开发复杂度高,但对算子支持更灵活,性能上限更高。第三种是直接利用WebGPU API进行推理,这是未来的趋势,允许利用GPU进行并行计算,性能大幅提升,但目前浏览器兼容性尚在完善中,且编程模型较为底层。
Rust驱动的高性能WASM推理引擎实践
在浏览器端实现高性能推理,语言选型至关重要。JavaScript本身由于垃圾回收机制和动态类型特性,在数值计算密集型任务中存在性能瓶颈。相比之下,Rust编译生成的WASM模块具有接近原生代码的执行速度,且内存安全,无GC停顿风险,是构建AI推理插件的理想选择。
项目结构与依赖管理
一个标准的WASM AI插件项目需精心配置Cargo.toml。核心依赖包括wasm-bindgen用于Rust与JavaScript之间的类型绑定和数据交互,serde系列库用于JSON序列化和反序列化,确保前端传来的数据能准确映射为Rust结构体。值得注意的是,为了支持本地测试,需使用条件编译指令,仅在非WASM目标下引入ndarray等数值计算库。
[package]
name = "wasm-ai-plugin"
version = "0.1.0"
edition = "2021"

[lib]
crate-type = ["cdylib"]

[dependencies]
wasm-bindgen = "0.2"
serde = { version = "1", features = ["derive"] }
serde_json = "1"

[target.\'cfg(not(target_arch = "wasm32"))\'.dependencies]
ndarray = "0.15"

[profile.release]
opt-level = 3
lto = true
核心推理逻辑实现
在Rust代码中,我们定义输入输出结构体,并通过#[derive(Serialize, Deserialize)]使其支持JSON转换。以简单的线性分类器为例,核心逻辑包含前向传播计算、Softmax归一化及最大概率提取。前向传播本质是矩阵乘法与向量加法的组合。在WASM环境中,直接遍历数组进行浮点运算,其效率远高于JavaScript。
为了减少跨语言边界调用(FFI)的开销,我们在Rust层封装了完整的推理流程。使用thread_local!宏来存储全局模型实例,避免在每次调用时重复初始化或传递复杂状态,从而保证线程安全与执行效率。infer函数接收JSON字符串,解析后进入模型预测,最终将结果序列化为JSON返回。这种设计将复杂的数值计算完全封闭在WASM模块内,前端仅负责数据格式转换。
批量推理优化策略
单次推理涉及一次JS到WASM的边界切换,若需处理流式数据或批量输入,频繁切换会导致显著的性能损耗。为此,我们设计了infer_batch接口。前端将多个样本打包为一个JSON数组发送,Rust侧一次性解析所有输入,在循环中连续执行推理逻辑,最后一次性返回结果数组。这种批处理方式极大地摊薄了通信开销,在处理批量图像分类或文本情感分析时,吞吐量可提升数倍。
#[wasm_bindgen]
pub fn infer_batch(inputs_json: &str) -> Result<String, JsValue> {
    let inputs: Vec<InferenceInput> = serde_json::from_str(inputs_json)?;
    MODEL.with(|model| {
        let outputs: Vec<InferenceOutput> = inputs
            .iter()
            .map(|input| model.predict(input))
            .collect();
        serde_json::to_string(&outputs)
            .map_err(|e| JsValue::from_str(&format!("序列化失败: {}", e)))
    })
}
性能瓶颈突破与生产级落地策略
尽管WASM推理优势明显,但必须正视浏览器环境的硬件限制。CPU算力的不足是最大瓶颈。对于参数量超过100M的模型,即便经过优化,在普通笔记本CPU上推理时间也可能长达数秒,无法满足实时性要求。因此,浏览器端推理的适用边界清晰:仅限于文本分类、小型图像分类、关键词提取等轻量级任务。大语言模型、高画质图像生成及视频分析等重型任务,仍应部署在云端。
量化与内存管理的平衡
为解决算力不足,INT8量化是标配手段。将32位浮点数转为8位整数,不仅减少内存占用,还允许利用SIMD指令集进行并行加速。然而,量化并非无损,需通过测试集评估精度损失。通常,经过良好量化的模型精度下降在1%以内,可接受范围内。
内存方面,WASM的线性内存默认上限约为4GB,但在移动端浏览器中往往更低。一个100M参数的FP32模型需约400MB内存,加上激活值,极易触发移动端内存警告甚至崩溃。建议将模型参数量控制在50M以内,量化后文件大小控制在50MB以内。此外,利用IndexedDB将模型缓存至本地存储,可避免每次刷新页面时的重复下载。首次加载虽慢,但后续访问几乎瞬时启动,极大改善用户体验。
混合架构的降级方案
在实际生产中,建议采用混合架构。前端检测设备能力(如WebGPU支持、内存大小、网络连接状态)。若设备性能强劲且网络稳定,可优先尝试本地WASM推理;若检测到低端设备或弱网环境,则自动降级为HTTP请求调用云端API。这种动态降级策略,既保障了高端用户体验,又确保了基础功能的可用性。
通过精心设计的WASM AI插件,我们不仅在技术层面实现了推理逻辑的本地化,更在架构层面探索了去中心化的AI应用新模式。这不仅是性能的优化,更是隐私保护与成本控制的必然选择。随着WebGPU的普及与编译器技术的进步,浏览器端AI推理的能力边界将持续扩展,成为边缘智能的重要组成部分。