54GB压至4GB,苹果牵手PrismML,端侧大模型迎来效率革命?
在人工智能的大浪潮中,我们似乎陷入了一种对参数规模的盲目崇拜。每当新模型发布,百亿、千亿甚至万亿参数的数字如同菜市场称重般被频繁提及,仿佛参数越多,智能就越高级。然而,当算力天花板成为物理限制,当移动端设备的内存与功耗成为硬约束,传统的“大力出奇迹”路线开始显露疲态。近日,一则关于苹果接洽初创公司PrismML的消息,再次将公众视线拉回了那个被忽视已久的核心命题:效率。
这不仅仅是一次简单的商业接洽,更是AI应用范式转移的信号。据CNBC报道,苹果正在深入评估PrismML推出的模型压缩技术,其核心目标是让原本臃肿的大型语言模型能够在iPhone等消费级设备上原生运行。这一动向预示着,端侧AI的竞争焦点正从“谁有云端算力”转向“谁能在本地跑得更聪明、更流畅”。
模型压缩:从“塞不下”到“装得进”的技术跨越
要理解这一技术突破的分量,首先需要回顾当前手机运行大模型的困境。主流的大语言模型,如基于Qwen3.6-27B架构的模型,在采用FP16精度保存时,体积高达约54GB。对于许多高端智能手机而言,这几乎是一个不可逾越的鸿沟。即便是一些配备16GB内存的旗舰PC,要流畅运行此类模型也显得捉襟见肘。
PrismML的出现,正是为了解决这一痛点。这家脱胎于加州理工学院研究团队的初创公司,其核心技术路线与BitNet等低比特模型思路相似,即通过大幅简化模型权重的存储方式来压缩体积。具体而言,传统大模型的一个参数通常需要16bit甚至32bit来保存,而PrismML将参数限制为二值或三值表达。
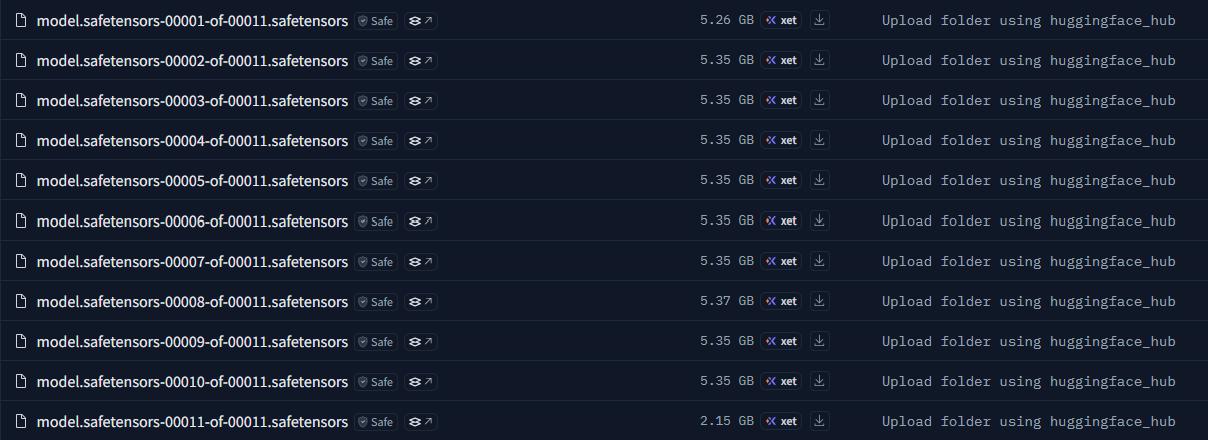
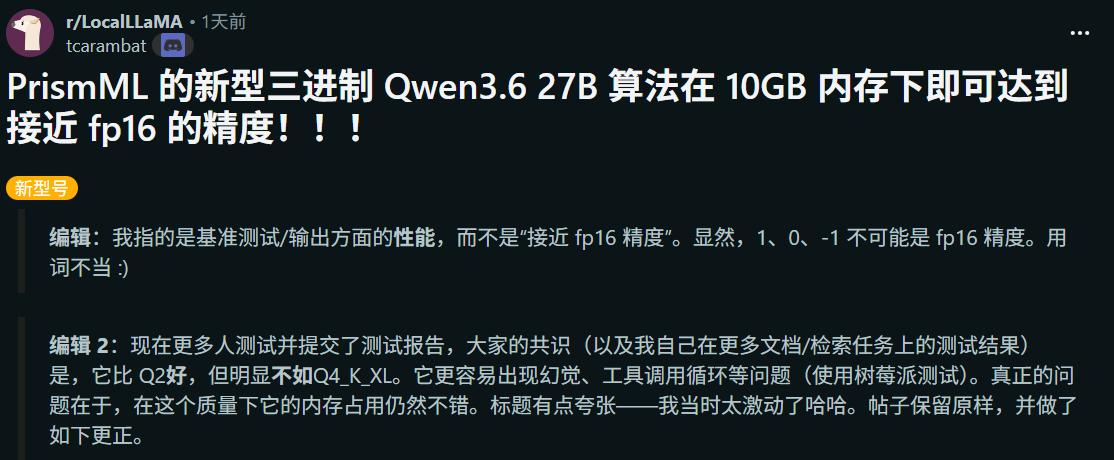
想象一下,这就像是将一张拥有16级灰度的照片,简化为只有黑白两色的图像。虽然理论上这会导致巨大的信息损失,但PrismML通过特殊的训练方式,成功地在压缩模型体积的同时恢复了大部分推理性能。其最新推出的Bonsai-27B模型,基于Qwen3.6-27B微调,成功将体积从54GB压缩至不足4GB。
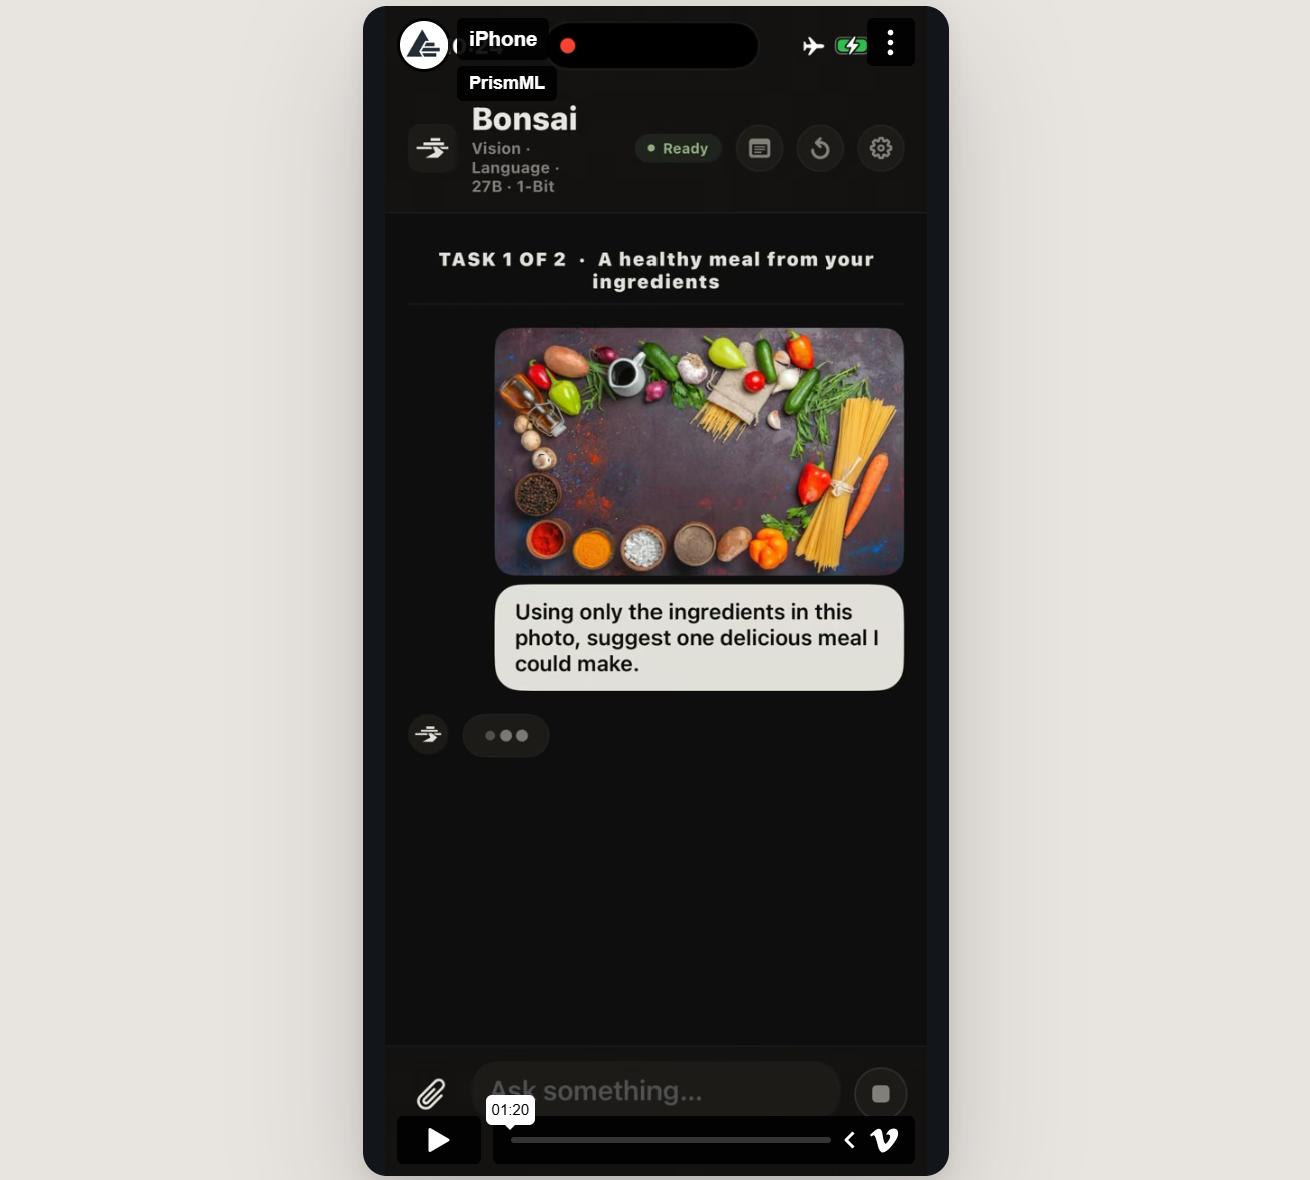
这一数据具有里程碑意义。在12GB内存的iPhone上,4GB的模型意味着它有了“立足之地”。相比之下,谷歌推出的Gemma 4 E4B约为3.65GB,而PrismML以相近的占地面积,塞进了名义上拥有270亿参数的密集模型。这种密度上的提升,直接带来了端侧AI能力的潜在质变。
性能权衡:智能与体积的博弈
然而,技术突破并非没有代价。模型压缩必然伴随着性能的折损。在PrismML的官方测试中,三值版模型保留了全精度模型约95%的综合成绩,而1-bit版则保留约90%。虽然听起来损失不大,但在实际应用中,这些细微的差距可能在关键任务中放大。
特别是对于依赖工具调用的Agent(智能代理)任务,性能损失更为明显。社区反馈显示,PrismML的三值版本相比常规量化版本(如Q4_K_XL)仍存在幻觉问题,且在Agent循环执行任务时表现不稳定。有用户指出,其优势在于体积极小,基本实现了以5.9GB的体积媲美17.9GB模型的效果,但在复杂逻辑和创意生成上,仍与云端大模型存在差距。
尽管如此,这种“可用”的状态本身就是巨大的进步。此前,苹果自己的端侧模型仅约为30亿参数,依赖2位量化和缓存共享等技术,主要服务于实时翻译、相册搜索和邮件摘要等轻量级任务,几乎不具备执行复杂Agent操作的能力。Bonsai-27B若能稳定运行,将显著扩展iPhone本地AI的能力边界,使其从简单的“工具”向更具自主性的“助手”过渡。
隐私与效率:端侧AI回归本位
苹果对PrismML技术的兴趣,背后有着深刻的战略考量。近年来,手机厂商在AI宣传上往往陷入尴尬境地:一方面展示炫酷的云端AI功能,另一方面受限于网络和隐私,难以提供完整的离线体验。
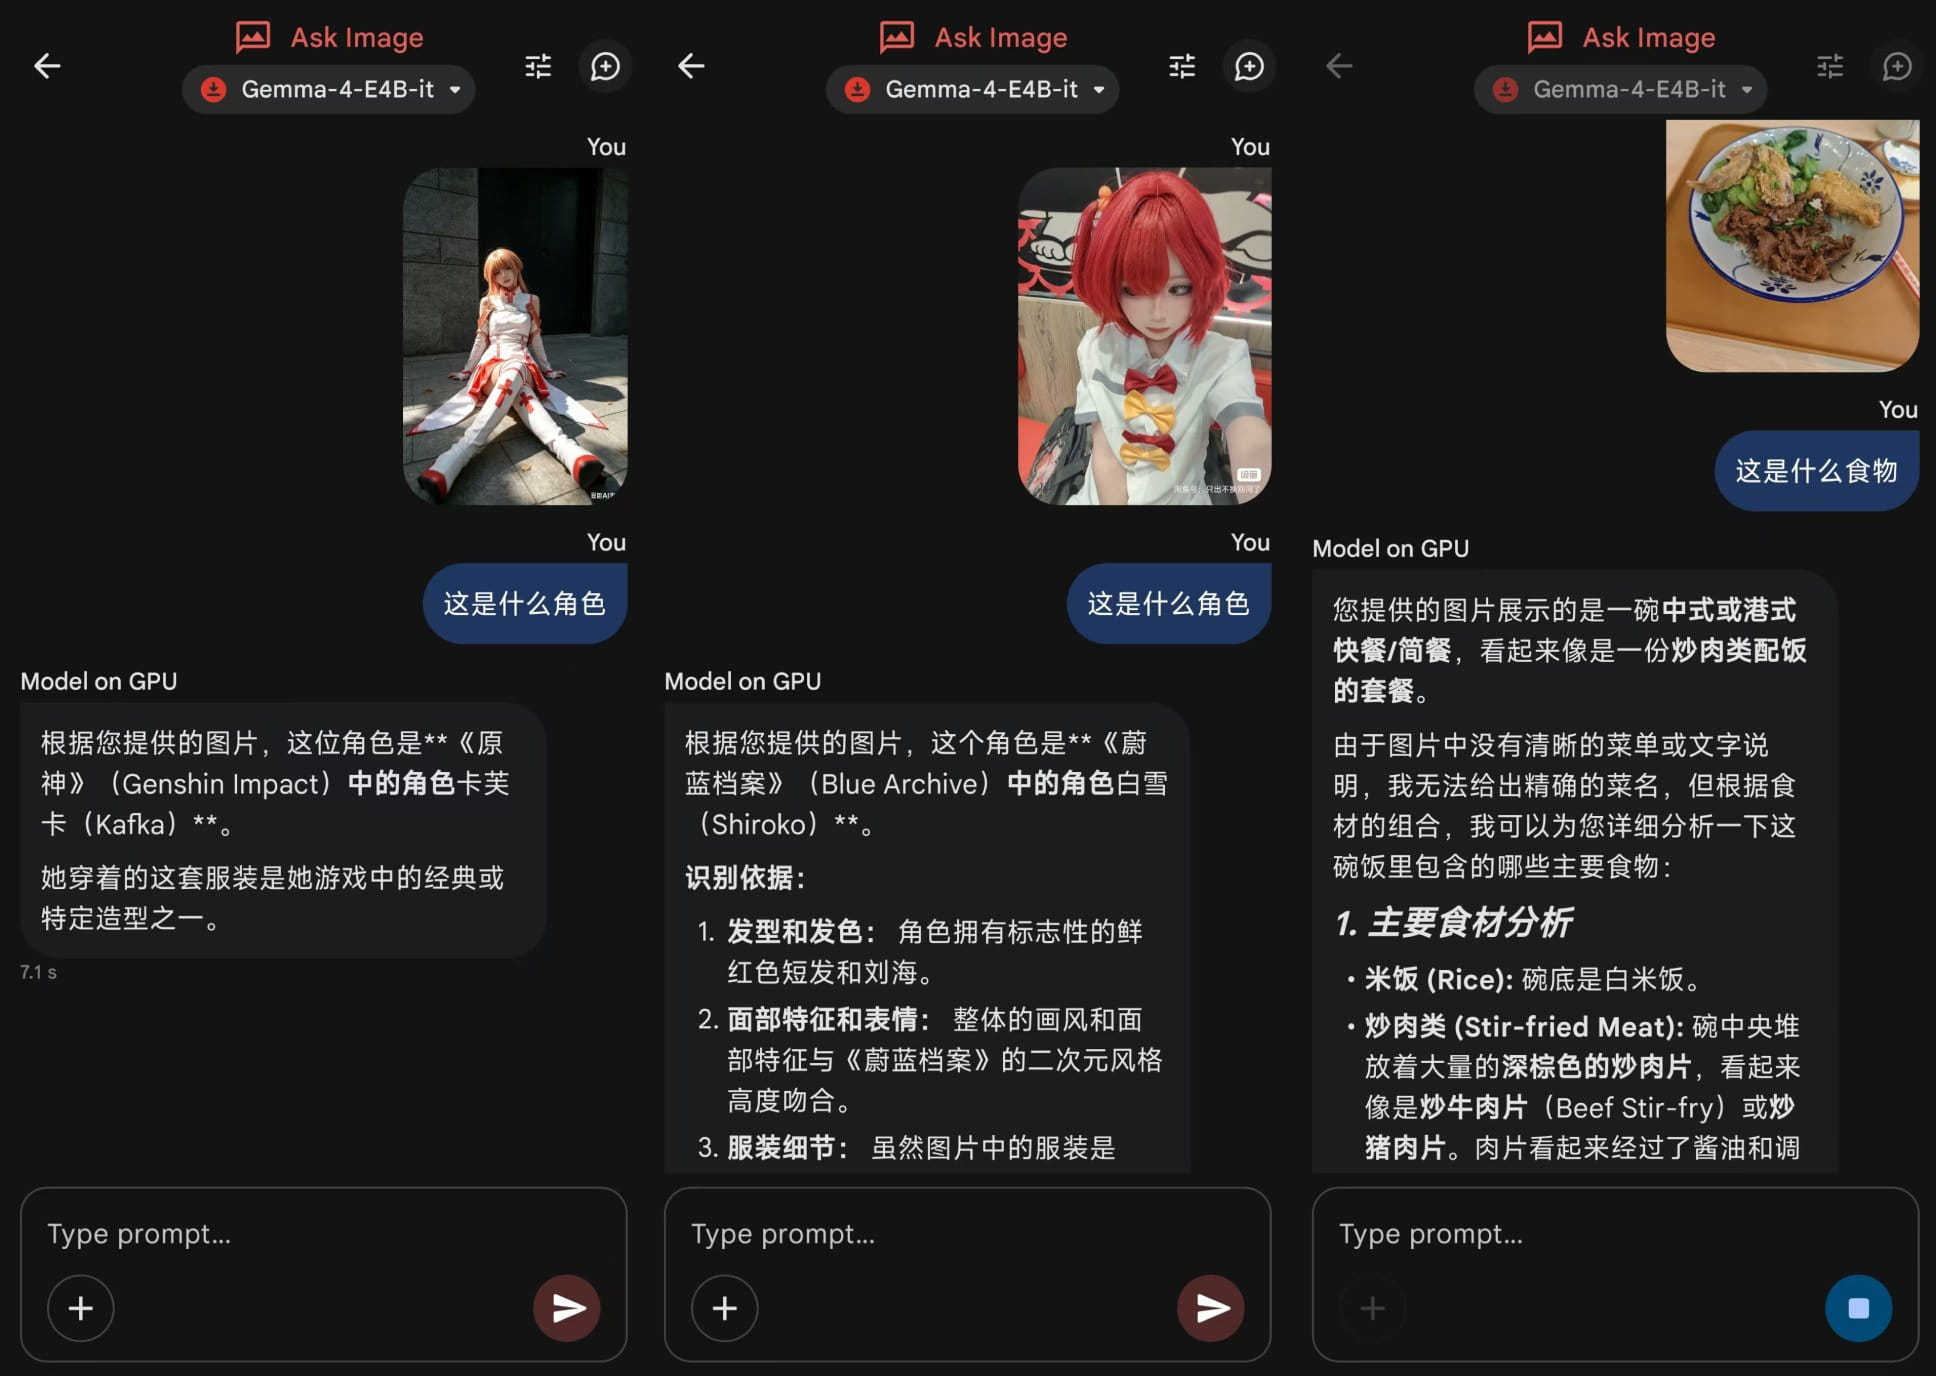
随着苹果智能、华为小艺以及OPPO、小米、vivo等多家厂商的端侧生成式AI模型完成网信部门备案,端侧AI正从概念走向合规落地。这一趋势的核心驱动力之一是隐私保护。在聊天记录、照片、文件等敏感数据面前,用户越来越倾向于将处理过程留在本地,而非上传至云端。尤其是近期Grok等云端模型引发的隐私争议,更加剧了用户对数据安全的焦虑。
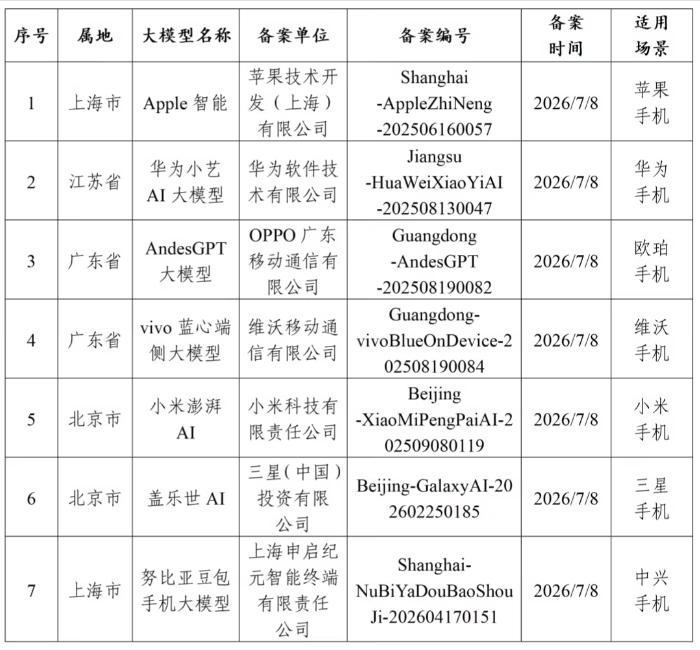
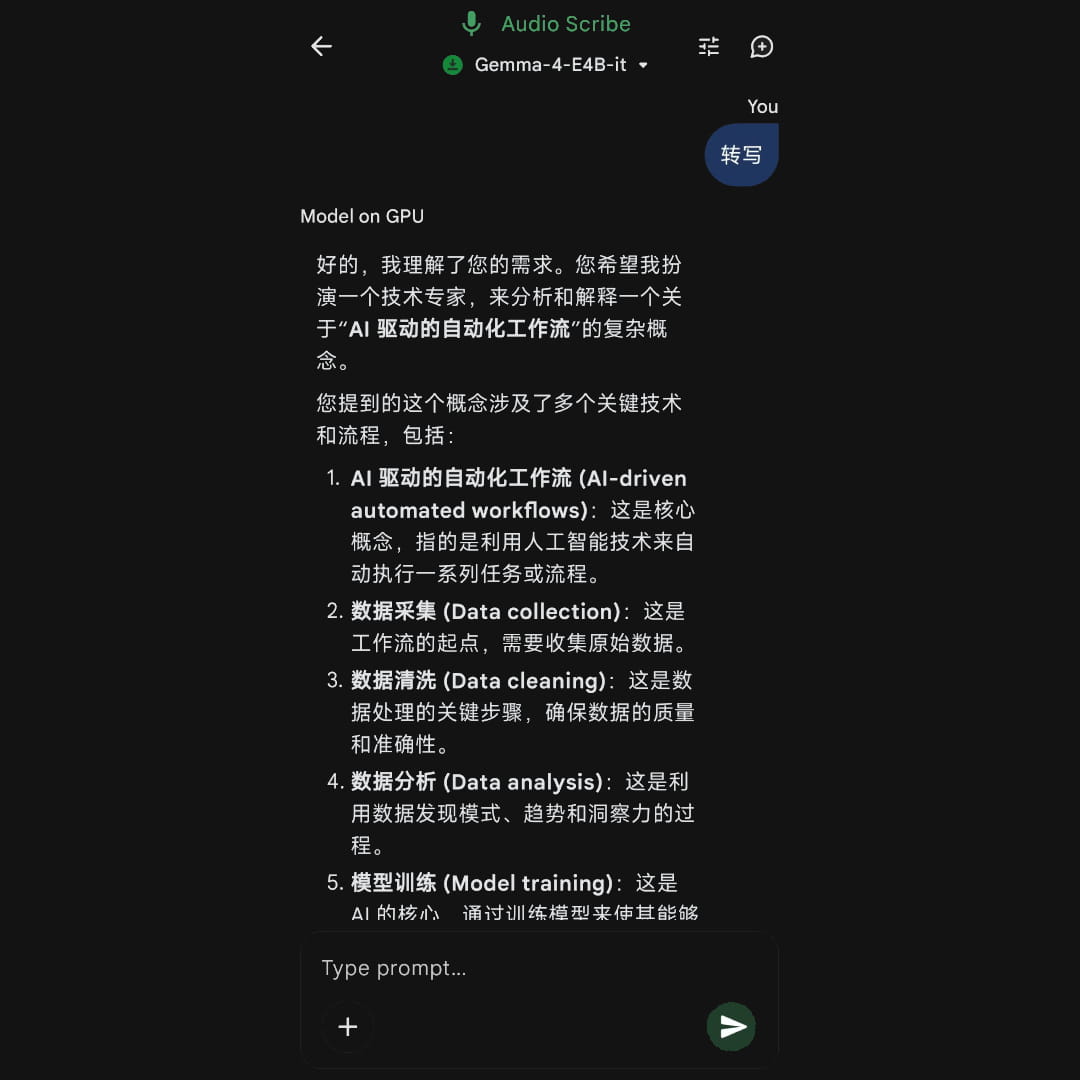
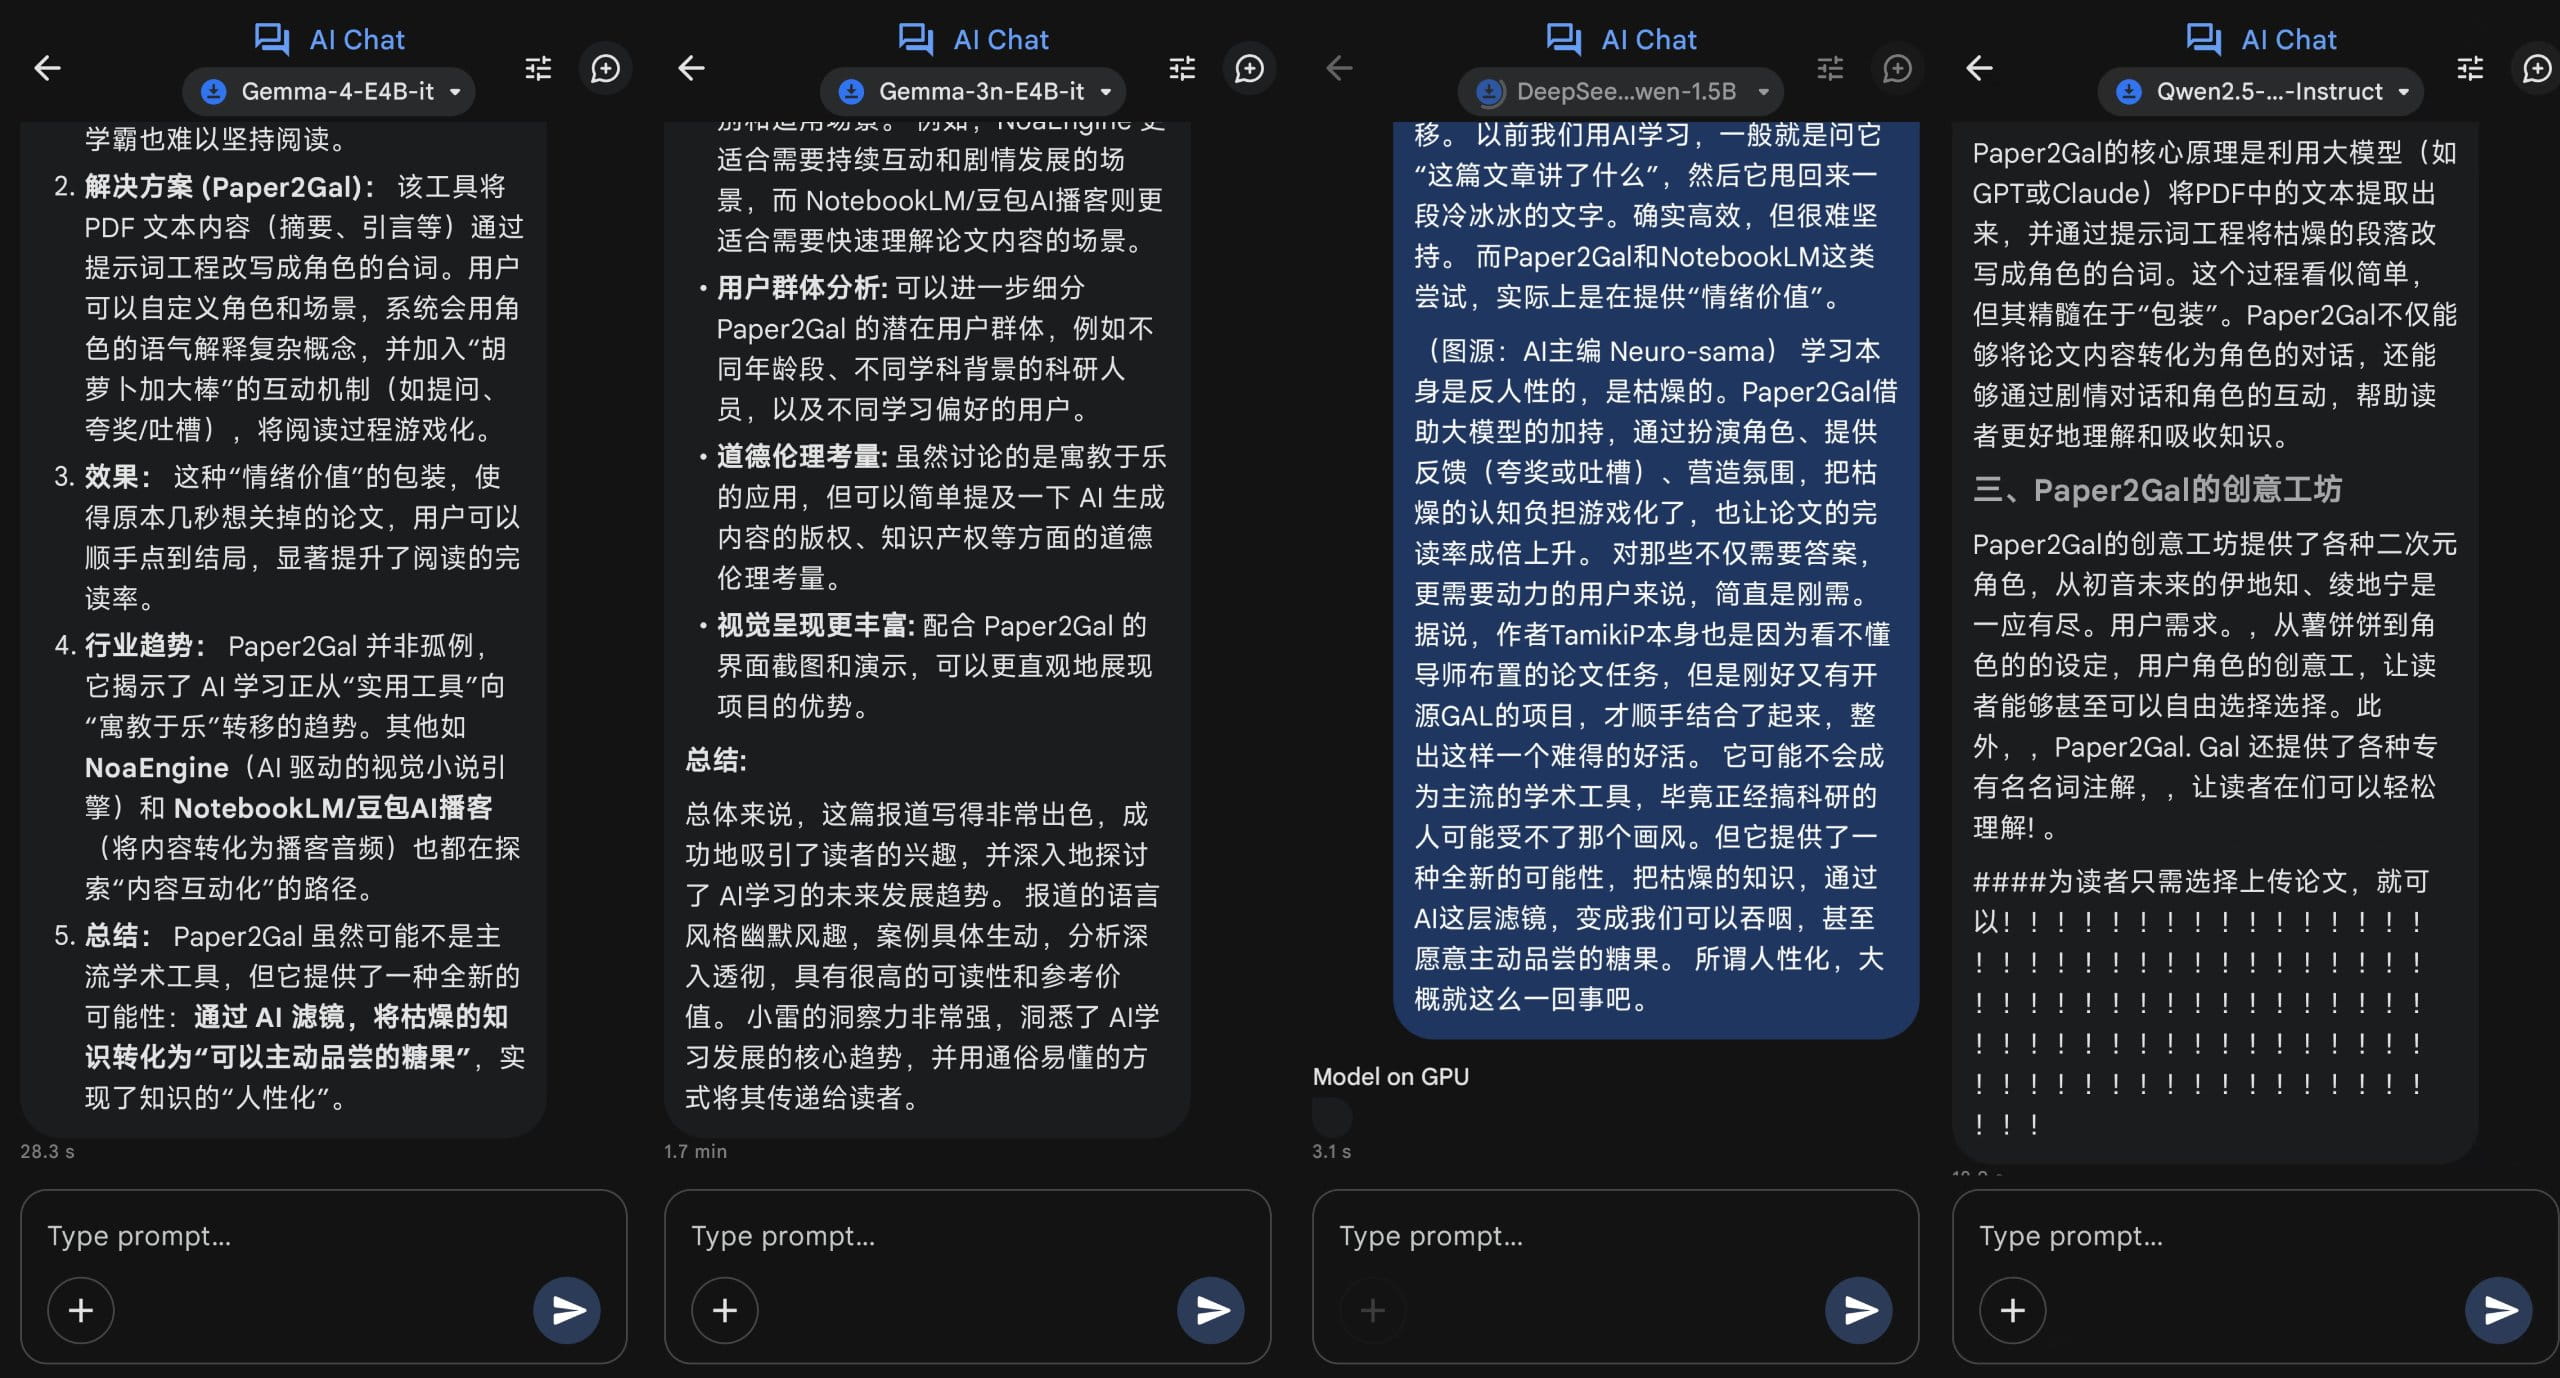
此外,延迟和稳定性也是端侧AI的重要优势。云端服务受网络环境影响,可能出现延迟或中断,而端侧模型一旦部署,即可实现即时响应。以Google AI Edge Gallery中的Gemma 4 E4B为例,虽然其在音频转录和复杂文本总结上的表现仍有局限,但在图像识别、基础文本处理和简单逻辑题上,已证明手机本地模型确实“能干活”。
这种“断网可用”的能力,对于户外创作、旅行记录或网络覆盖不佳的场景尤为珍贵。它标志着AI不再仅仅是云端的云端服务,而是真正成为设备的一部分,随时随地待命。
从参数竞赛到效率革命:行业新范式
PrismML与苹果的互动,折射出AI行业正在经历一场深刻的范式转移。过去,模型规模的扩张被视为提升智能的唯一路径,Chinchilla缩放定律虽然指出了数据与参数平衡的重要性,但在端侧设备上,物理限制使得这一理论难以直接应用。
现在,行业焦点正转向如何在有限的硬件资源下,最大化模型的效率与智能。这包括算法层面的模型压缩、量化技术,也包括硬件层面的异构计算、光子计算等创新。例如,通过优化内存带宽、减少功耗发热,使大模型能在移动设备上稳定运行,已成为下一代智能终端的核心竞争力。
值得注意的是,这种效率革命并非完全取代云端AI,而是形成“端云协同”的新生态。简单的、隐私敏感的、实时的任务由端侧模型处理;复杂的、需要海量算力的任务则由云端模型承担。这种分工协作,既能保证用户体验的流畅性,又能发挥云端算力的无限潜能。
未来,随着压缩技术的进一步成熟,我们有望看到更多百亿参数级别的模型在手机上原生运行。届时,手机AI将不再局限于图片编辑和摘要生成,而是能够执行更复杂的任务,如多步骤规划、跨应用操作等。这将真正赋予手机一个“不那么容易犯傻的大脑”,使其成为真正的智能伙伴。
对于硬件厂商而言,这条道路虽然充满挑战,但前景广阔。在性能同质化日益严重的今天,谁能率先突破端侧AI的效率瓶颈,谁就能在下一个十年占据制高点。对于开发者来说,如何针对压缩模型进行优化,如何设计更适合端侧运行的Agent架构,也将成为新的技术高地。
总之,54GB降至4GB,看似只是数字的变化,实则是AI应用从“云端中心化”向“边缘智能化”演进的关键一步。在这场效率革命中,参数规模不再是唯一的衡量标准,如何在方寸之间实现智能的最大化,才是决定未来AI终端命运的关键所在。随着技术的不断迭代,我们或许很快就能看到,那些曾经只能在实验室里跑的大型模型,真正走进每个人的口袋,成为生活中不可或缺的智能助手。