为何AI Agent上线难?掌握这套评估方法论破解“鸿沟”困局
在数十亿个智能体即将广泛运行的前景描绘之下,现实却显得颇为骨感。亚马逊云科技CEO Matt Garman曾预测未来将有数十亿个Agent在各行各业运行,这一愿景固然诱人,但冰冷的数据揭示了“GenAI鸿沟”的存在。MIT Project NANDA的一份报告指出,尽管企业对生成式AI投入了数百亿美元,仅有5%的组织成功实现了规模化部署并获得显著财务回报。绝大多数企业被困在“高采用率、低转化率”的试点阶段,这种困境在Agent领域尤为突出:Demo效果惊艳,一旦接入真实业务场景便频频失效。
问题的根源往往不在于底层大模型能力的不足,而是工程化落地过程中的结构性难题。传统软件工程的方法论在面对Agent时显得捉襟见肘,这源于Agent与传统软件存在的三个本质差异。首先是非确定性,传统软件遵循逻辑确定,而Agent基于概率模型,相同输入未必产生相同输出,且没有任何主流模型提供商承诺完全确定性。其次是“Prompt即源代码”,自然语言提示词的微调可能引发行为剧烈波动,却缺乏版本控制和静态分析工具。最后是隐式依赖,底层模型的后台静默升级可能导致Agent服务质量突然变化,而代码未动,问题难寻。这三个因素叠加,导致传统评估测试体系全面失效,企业Agent因此陷入生产停滞。
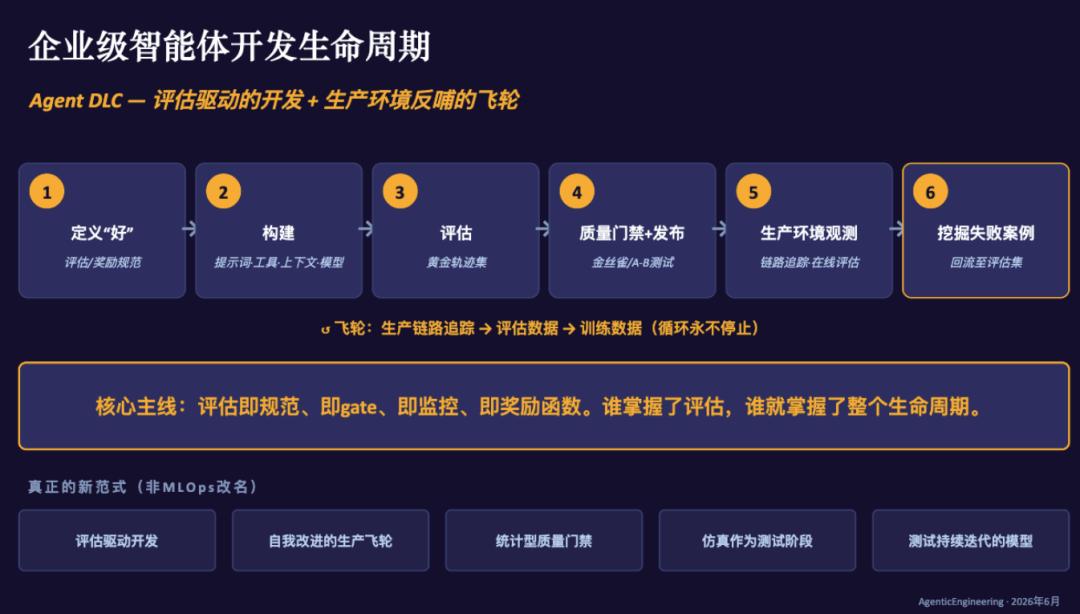
要破解这一困局,企业需要从传统的SDLC(软件开发生命周期)思维转向ADLC(Agent开发生命周期)。ADLC并非线性的流水线,而是一个持续旋转的飞轮。它包含定标准、开发实现、效果评估、灰度上线、持续监控和改进循环六个环节,且从监控回流至标准制定。在这个过程中,评估不再是最后一步,而是起点也是终点。企业在启动Agent项目前,必须先定义“好”的标准,包括智能体定义、语气个性、工具参数及基准数据集。没有完善的可观测性系统,如OpenTelemetry,就无法实现持续评估,飞轮也就无法转动。
构建有效的Agent评估体系,需要依靠“两根支柱”的方法论。第一根支柱决定评估的粒度,分为看最终响应的黑盒评估、看完整执行轨迹的玻璃盒评估,以及看单步细节的白盒评估。黑盒回答“结果对不对”,玻璃盒回答“过程对不对”,白盒回答“每一步对不对”。日常开发以玻璃盒评估为主,黑盒和白盒作为补充,从而实现对Agent输出结果的全方位覆盖。
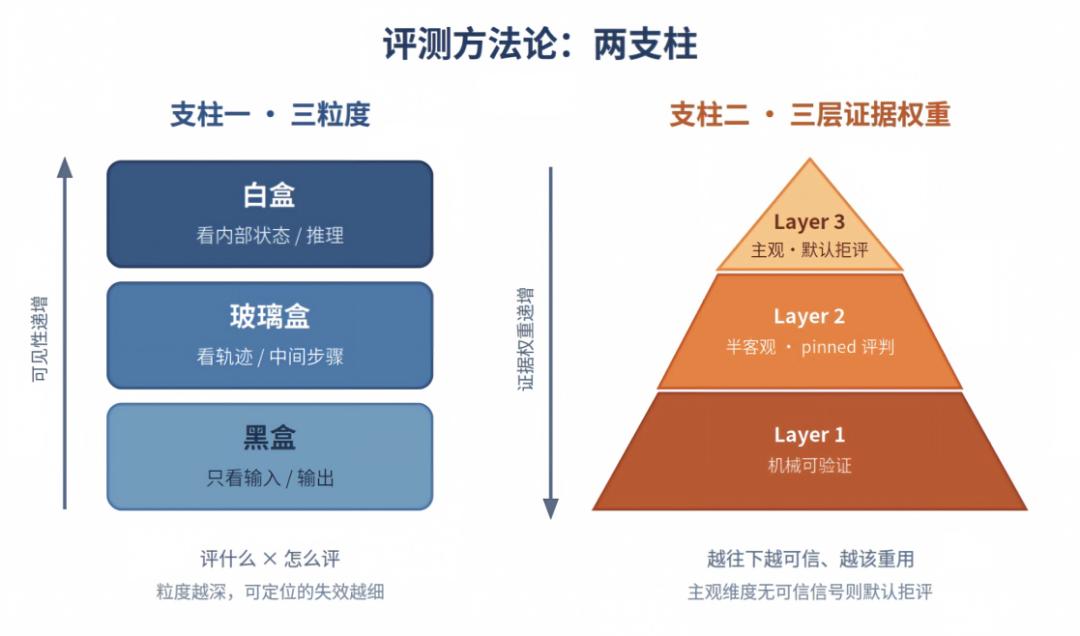
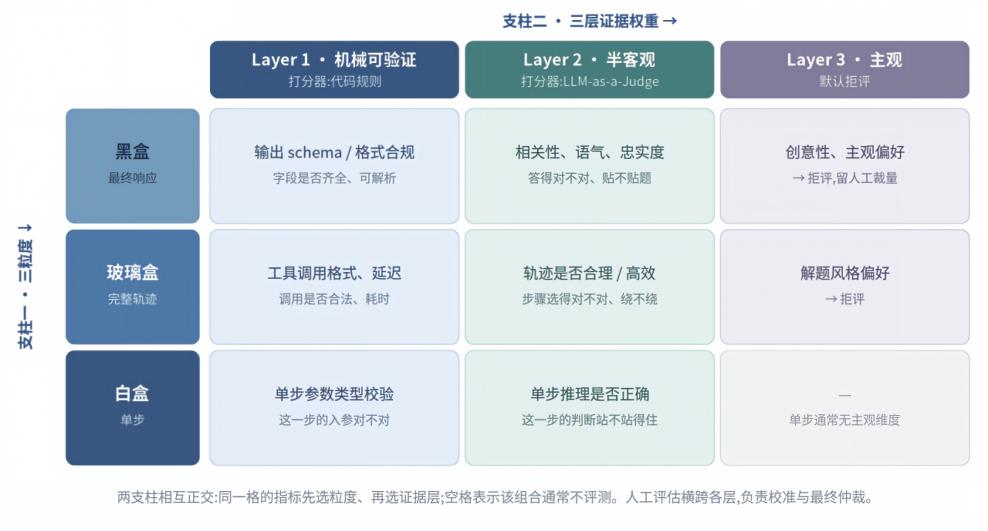
第二根支柱决定每个分数的证据权重,分为机械验证、半客观评判和主观默认评判。机械验证是100%自动化的,如JSON格式检查;半客观评判使用固定评估器和明确标准;主观评判则依赖人或LLM的判断力。这两根支柱相互正交,形成一个3x3的矩阵。例如,在评估客服Agent时,AWS采用了“真实数据+虚拟客户模拟”的双轨方法,既测试意图识别的准确度,也测试多轮对话的连贯性。这种组合策略确保了评估既全面又精准。
评估数据集的质量直接决定了评估的上限,企业必须建设经过人工标注和验证的高质量测试集,这将成为企业的核心资产。不同形态的Agent关注不同维度,如客服Agent重视意图识别准确率,工具使用Agent看重参数准确性,多Agent协作系统关注任务拆分合理性。没有通用的“感觉差不多”,只有针对具体场景的量化标准。
从底层模型到上层Agent,就像大树长出枝叶,每一个Agent都需要专门的评估方案。企业自主掌控评估标准和黄金数据集,是构建核心竞争壁垒的关键。技术平台可采购,但评估能力必须内生。进入Agent时代,能否交付可衡量的业务结果,是判断智能体价值的最终标准。企业需通过严谨的工程化方法和持续的迭代评估,打破从Demo到生产的壁垒,真正释放AI的生产力价值。这不仅是技术挑战,更是商业决心的试金石。