云原生AI调度难题:如何突破GPU利用率瓶颈?
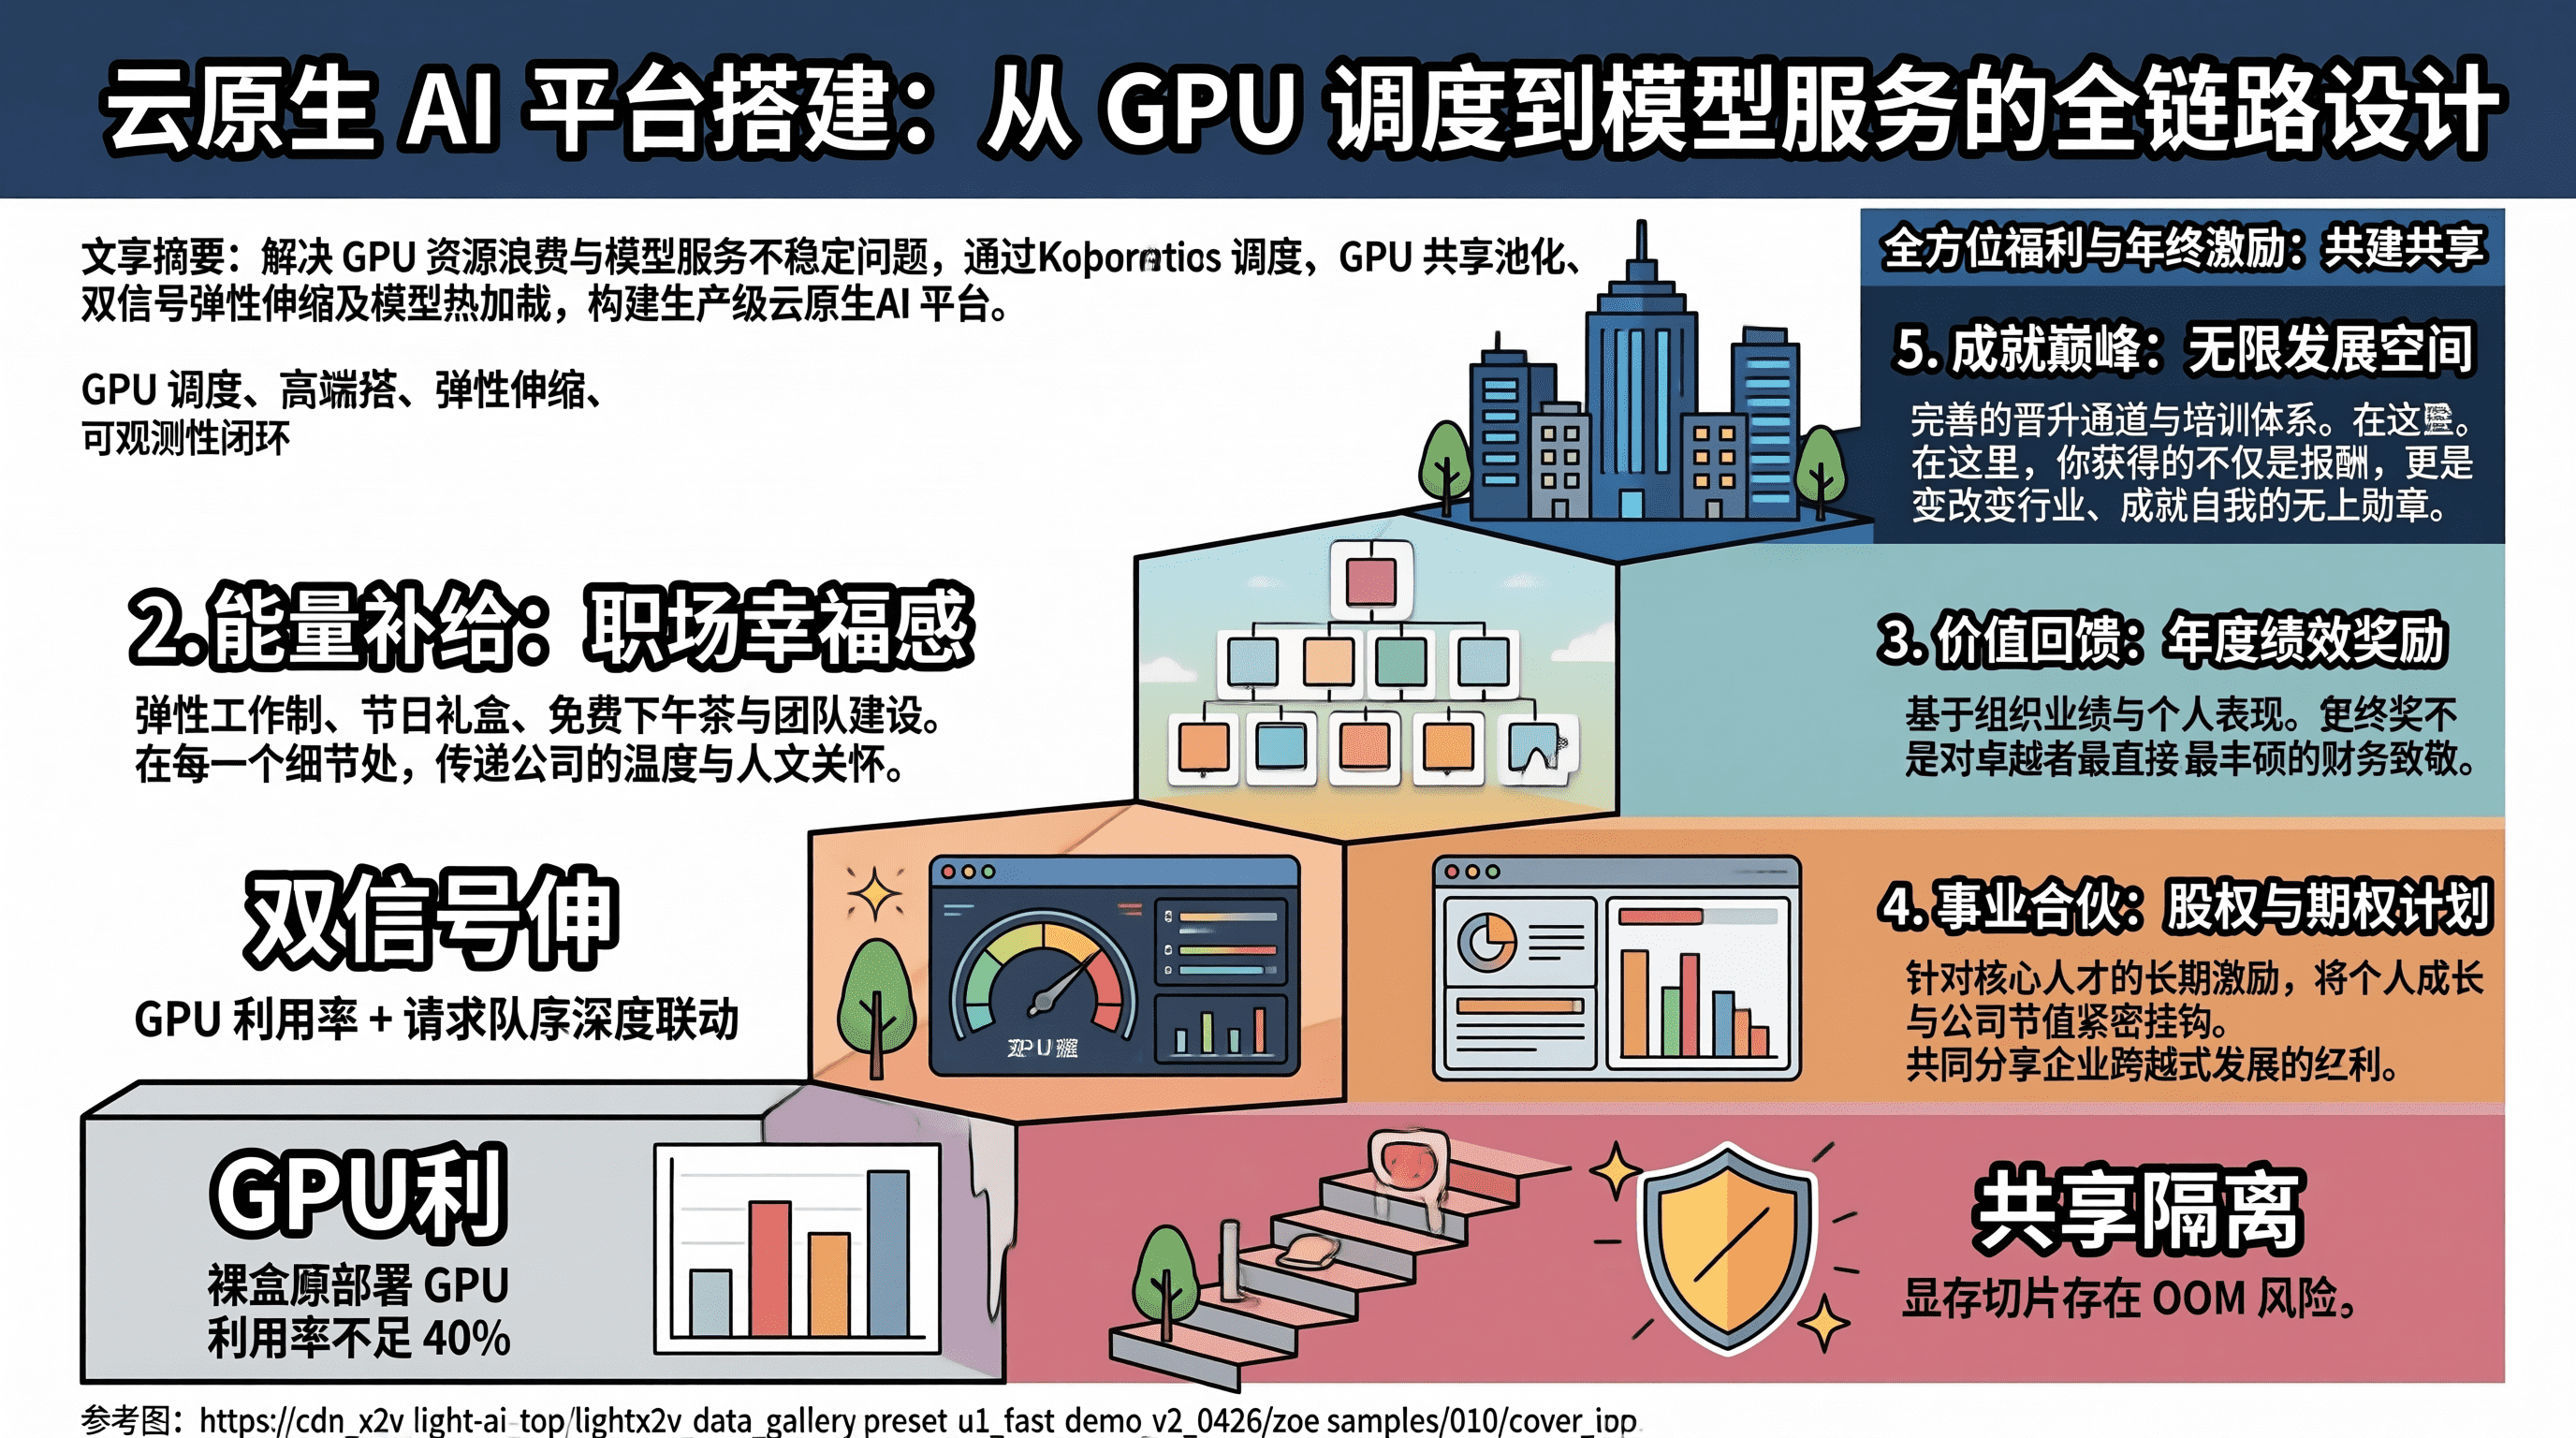
在人工智能模型从实验室验证迈向大规模生产部署的过程中,基础设施的支撑能力直接决定了业务的稳定性和成本效率。然而,许多企业在初期往往采用裸金属服务器直接部署GPU集群的方式,这种传统模式在生产环境中暴露出明显的弊端。数据显示,裸金属部署的GPU集群平均利用率通常不足40%,大量算力资源处于闲置状态。与此同时,当业务流量出现突发波动时,由于缺乏自动伸缩能力,推理服务的P99延迟可能会飙升至正常值的五倍以上,导致用户体验严重下降。这种资源浪费与服务不稳定并存的局面,根源在于缺乏统一的资源调度与服务编排层。
传统的裸金属模式下,每个模型实例往往独占一张物理GPU卡。即使模型在大部分时间内处于空闲状态,这些资源也无法被其他任务复用。面对推理请求的突增,服务只能被动排队,进而引发延迟雪崩。云原生AI平台的出现,旨在通过Kubernetes强大的调度能力和容器隔离机制,将GPU从“独占”模式转变为“共享池”模式,并为模型服务提供弹性伸缩的基础设施。这并非仅仅为了构建一个美观的资源监控仪表盘,而是要搭建一条从模型文件存储到最终推理请求处理的可靠、高效管道。
一个生产级的云原生AI平台架构,需要调度器、模型服务运行时、GPU资源池以及可观测性层这四个核心组件的高效协同。它们之间并非简单的线性调用关系,而是一个闭环的控制生态系统。调度器作为整个平台的大脑,必须具备多维度的感知能力。它不仅要处理Pod的生命周期管理,还需深入感知底层硬件的GPU拓扑结构,例如哪些GPU位于同一个NUMA节点上,同时实时获取模型对显存和算力的具体需求,以及当前的实时负载情况。
为了实现上述目标,平台需要对Kubernetes原生的kube-scheduler进行扩展。通过Scheduler Framework提供的插件机制,可以注册自定义的Filter和Score插件,将GPU拓扑亲和性纳入调度的核心决策逻辑中。在Filter阶段,调度器会优先排除那些GPU拓扑不满足亲和性要求的节点,从而避免跨NUMA节点访问GPU所带来的性能衰减。实测表明,这种优化措施可以降低30%以上的显存带宽损耗,显著提升推理吞吐量。
在资源分配层面,传统的NVIDIA设备插件通常以整卡为单位进行GPU分配,这在推理场景下造成了巨大的资源浪费。为解决这一问题,平台引入了GPU共享调度机制,将一张物理GPU卡虚拟化为多个逻辑切片。例如,将16GB显存的A100卡切分为四个4GB的虚拟设备,允许多个推理Pod共享同一张物理卡。这需要设备插件支持MIG(Multi-Instance GPU)技术,或者采用自研的显存隔离方案,确保不同业务间的资源互不干扰。
除了资源调度,弹性伸缩闭环的设计也是平台稳定性的关键。这里的伸缩控制器并非简单的HPA(Horizontal Pod Autoscaler),它需要同时监控两个关键信号:GPU利用率和请求队列深度。GPU利用率反映了计算资源的饱和度,而队列深度则揭示了服务容量的瓶颈所在。当GPU利用率较低但队列深度持续增长时,说明瓶颈可能出现在CPU或网络I/O环节,此时盲目扩容GPU不仅无效,反而增加成本。正确的做法是扩容Pod的副本数,以平衡整体负载。
在模型服务层面,如何实现模型的快速更新和版本切换也是关键议题。通过定义自定义CRD(Custom Resource Definition),可以声明模型版本及加载策略,使调度器能够在不重建Pod的情况下完成模型的热切换。这对于A/B测试和灰度发布至关重要。传统的Pod重建方式会导致冷启动延迟,可能长达数十秒,而热加载技术可以将切换时间压缩至秒级,确保业务连续性和用户体验的无缝衔接。
然而,云原生AI平台并非完美的银弹,它在提升资源利用率的同时,也引入了新的复杂度和潜在风险。首先是显存隔离的不彻底性问题。目前主流的GPU共享方案,包括MIG和自研的显存切片,均无法实现真正的显存硬隔离。MIG虽然在硬件层面提供了L2缓存和显存带宽的隔离,但仅适用于A100/H100等高端显卡,且切分粒度固定。自研方案则依赖软件层面的地址空间隔离,一旦某个推理Pod发生显存泄漏或OOM(内存溢出),可能会波及同一物理卡上的其他Pod。因此,在生产环境中,必须对共享GPU的Pod设置显存使用上限,并配合cgroup的内存控制器进行二级防护。
其次是调度延迟的增加。自定义调度器逻辑的引入,不可避免地增加了单次调度决策的时间。原生kube-scheduler的调度延迟通常在100毫秒以内,而加入GPU拓扑感知和共享调度逻辑后,这一时间可能延长至500毫秒至1秒。对于需要快速响应突发流量的场景,这一延迟不可忽视。缓解策略包括将GPU拓扑信息缓存于内存中,采用增量更新而非全量同步的方式,以减少调度器的计算负担。
此外,平台运维成本的上升也是不可忽视的挑战。一个完整的云原生AI平台包含调度器、设备插件、伸缩控制器、模型运行时及可观测性组件等至少五个定制化模块。每个组件都需要独立的版本管理、灰度发布流程和故障排查机制,这对团队的技术能力和人力投入提出了更高要求。对于团队规模较小的企业,建议优先采用如KubeRay、Volcano等成熟的社区方案,将自研精力集中在业务层的差异化需求上,而非重复造轮子。
该架构方案主要适用于GPU利用率低、模型服务数量多且流量波动较大的场景。如果企业拥有的模型数量极少且流量稳定,裸金属部署反而更为简单可靠。对于需要严格SLA保证的金融级推理服务,GPU共享带来的隔离风险可能需要谨慎评估。在平台复杂度与业务收益之间找到平衡点,是构建成功云原生AI平台的关键所在。
综上所述,云原生AI平台的核心价值在于将GPU资源从静态独占转变为动态共享,将模型服务从人工运维转变为自动伸缩。通过扩展Kubernetes调度器实现GPU拓扑感知,优化NUMA亲和性,可以显著提升推理性能。借助GPU共享技术和双信号驱动的弹性伸缩策略,能够有效提升资源利用率并应对流量波动。同时,通过自定义CRD实现模型热加载,保障了业务发布的敏捷性。在实施过程中,需充分考量显存隔离、调度延迟及运维复杂度等因素,选择合适的技术路径,以实现技术投入与业务产出的最大化。