6000万买路钱变烫手山芋?Reddit为何欲切断谷歌AI数据授权
在互联网内容的演进史中,2024年曾被视为一个关键的分水岭。彼时,被誉为“美国贴吧”的Reddit与科技巨头谷歌达成了一项备受瞩目的协议:谷歌每年支付6000万美元,以获取使用Reddit海量用户生成内容(UGC)来训练其人工智能模型的权限。这一合作当时被资本市场广泛解读为传统内容社区在AI时代成功转型的标杆,甚至成为Reddit顺利推进IPO的重要叙事支撑。然而,时间来到2026年,风向骤变。据多方消息源透露,Reddit高层正在重新审视这笔交易的真实收益,内部甚至出现了切断谷歌AI数据访问权限的激烈讨论。这种从“拥抱”到“后悔”的态度转变,并非一时冲动,而是基于对AI产业底层逻辑变化及自身生存危机的深刻反思。
要理解Reddit的焦虑,首先必须回顾其当初为何选择“卖身”。作为一家成立于2005年的老牌互联网社区,Reddit在长达近二十年的时间里始终未能实现稳定盈利。在2022年全球互联网行业遭遇寒冬、IPO窗口几乎关闭的背景下,2023年爆发的生成式AI浪潮为其提供了一条全新的逃生通道。Reddit联合创始人史蒂夫·霍夫曼曾自豪地指出,平台拥有互联网上最大、由真实人类经验持续更新的对话档案库。对于急需高质量语料来“浇灌”大模型的OpenAI、Anthropic、谷歌和Meta而言,Reddit的数据不仅是丰富的,更是具备独特社会语境和情感维度的宝贵资源。通过将自己包装为“AI模型语料供应商”,Reddit成功迎合了资本市场对AI概念的狂热追捧,其股价随之飙升。然而,这种基于数据规模的红利期正在迅速消退。
当前的AI行业已经跨越了单纯追求数据量的初级阶段,进入了注重数据质量与垂直深度的新周期。早期的大模型训练依赖于海量通用数据的广度拓展,旨在建立基础的世界常识和语言能力。但随着技术成熟,市场焦点已转向年度经常性收入(ARR)和商业落地能力。投资机构和技术厂商发现,相比于泛泛而谈的“通才”模型,能够在特定垂直领域解决复杂问题的“专才”模型更具商业价值。例如,在编码、法律、医疗等专业领域表现卓越的模型更受青睐,而依赖通用网络数据训练的模型则面临同质化竞争。这意味着,Reddit所持有的那些碎片化、非结构化的日常对话数据,其边际效用正在急剧下降。谷歌支付的6000万美元,在几年前或许是巨款,但在今天看来,可能仅相当于维持基本运营的成本,而非高溢价的资产变现。
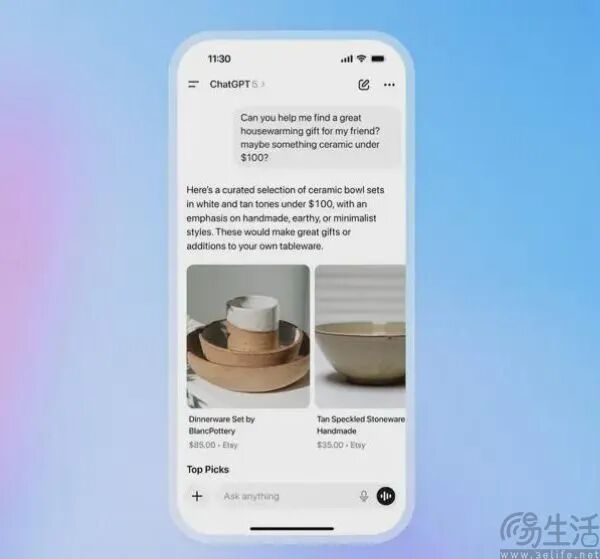
更为致命的打击来自于流量生态的重构。在传统搜索引擎时代,Google搜索虽然会抓取Reddit的内容,但最终会将用户引导至Reddit网站。这种“引用-点击”的模式为社区带来了巨大的外部流量和新用户增长。然而,生成式AI的介入彻底改变了这一链条。当用户向Gemini或其他AI助手提问时,系统直接整合Reddit上的帖子内容生成答案,用户无需离开聊天界面即可获得所需信息。这种“零点击”体验虽然提升了用户效率,却对内容源头造成了毁灭性的流量截断。Reddit贡献了核心内容,却失去了用户访问、广告曝光以及社区互动的机会。从商业本质上看,这不再是简单的内容授权,而是一种隐性的流量掠夺。
谷歌方面曾辩称,其在AI回答中添加了来源链接,并声称来自AI的用户具有更高的粘性和转化潜力。但现实数据往往并不支持这一乐观预期。大多数使用AI助手的用户倾向于接受现成的答案,缺乏动力去点击参考链接进行二次验证或深度阅读。AI助手就像一只只进不出的“貔貅”,不断吞噬着内容社区的养分,却很少反哺流量。对于Reddit这样的依赖用户活跃度和社区氛围的平台而言,流量的枯竭意味着社区活力的衰退。一旦用户不再需要登录平台即可获取信息,社区的互动频率、新用户注册率以及广告库存价值都将受到不可逆的侵蚀。
此外,这种合作关系还引发了深刻的身份认同危机。AI聊天机器人与Reddit在某种程度上构成了同业竞争关系。两者都在争夺用户的时间和注意力,都在试图成为用户获取信息和解决问题的首选入口。当AI能够完美模拟人类的建议、经验分享甚至情感安慰时,它实际上是在替代Reddit的核心功能。向竞争对手出售赖以生存的数据资源,无异于“资敌”。Reddit高管们逐渐意识到,这6000万美元的授权费,本质上是一笔高昂的“买量成本”,只不过这次买单的不是广告主,而是正在逐步取代自己的技术巨头。而且,这种流量损失是永久性的,不同于电商或游戏行业的周期性买量,AI对用户习惯的培养是一次性且长期的。
从更宏观的行业视角来看,Reddit的困境反映了所有内容平台在AI时代面临的共同挑战:如何平衡数据开放与生态保护?如果完全封闭数据,可能会失去与大模型合作的机会,甚至在搜索排名中被边缘化;如果过度开放,则可能沦为AI的免费打工者,最终失去独立生存的能力。目前,行业内开始出现分化。一些平台选择通过技术手段限制爬虫,或要求AI公司支付更高的溢价以换取实时数据访问权;另一些平台则尝试自建垂直大模型,将数据价值内化,打造专属的智能服务。Reddit内部的讨论正是这种战略迷茫期的体现。
值得注意的是,AI行业对数据的需求并未消失,而是发生了结构性转移。厂商们现在更渴望获得经过专家标注、具有高信噪比的垂直领域数据,而非海量的普通用户闲聊。Reddit虽然拥有庞大的用户基数,但其内容的专业密度相对较低,难以满足高端模型训练的需求。相比之下,Stack Overflow等技术社区或专业期刊数据库的价值正在上升。这也解释了为何知识覆盖面最广的Gemini在某些专业评测中显得乏力,而专注于代码和逻辑推理的Claude等模型却能占据风口。Reddit若不能提升其数据的专业附加值,其在AI供应链中的地位将进一步边缘化。
面对这一局面,Reddit可能的破局之道在于重构其与AI的关系。首先,可能需要重新谈判授权协议,将费用模式从固定的年费转变为基于流量转化或商业使用的分成模式,以确保能从AI带来的间接价值中分一杯羹。其次,加强社区的专业化建设,鼓励高质量、深度内容的生产,提升数据的稀缺性和不可替代性。最后,探索自身的AI应用,利用自有数据开发智能助手或推荐系统,将数据价值留在平台内部,增强用户粘性。例如,推出基于社区历史数据的个性化咨询工具,让用户在平台内获得更精准的服务,从而减少对通用AI助手的依赖。
总之,Reddit与谷歌合作的动摇,标志着互联网内容产业从“流量为王”向“数据主权”时代的过渡。6000万美元的买路钱之所以变得烫手,是因为它掩盖了平台长期价值流失的风险。对于所有内容创作者和社区运营者而言,这是一个明确的信号:在AI重塑信息分发格局的今天,盲目拥抱技术巨头而不设防,可能会付出失去自主权的惨重代价。未来的竞争,将不再是单纯的内容数量之争,而是对数据控制权、用户关系链以及垂直领域话语权的深度博弈。Reddit的下一步抉择,不仅关乎其自身的命运,也将为整个互联网内容生态提供重要的参考范式。