GPT-5.6自进化揭秘:成本降20%背后的全栈工程化革命
在人工智能技术迭代进入深水区的当下,单纯依靠扩大参数规模来提升模型性能的路径已显疲态。OpenAI近期释放的一系列信号表明,大模型竞争的焦点正迅速从“更大”转向“更精”与“更快”。随着GPT-5.6系列的发布,尤其是旗舰版本GPT-5.6 Sol在自我优化能力上的展现,行业见证了一次典型的全栈工程化胜利。这不仅是一次模型版本的更新,更是AI基础设施底层逻辑的重构。
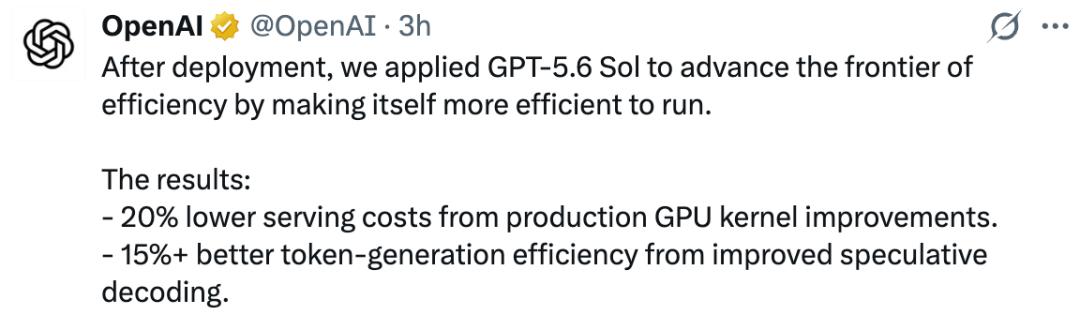
此次技术突破的核心在于对现有硬件潜力的极致挖掘。面对全球算力需求增速远超硬件扩容速度的现实困境,OpenAI选择了一条向内求索的道路。通过GPT-5.6 Sol自主优化生产环境中的GPU内核,推理服务的部署成本实现了20%的大幅下降。这一数据背后,是模型对Triton和Gluon等底层编程语言的深度掌握与应用。模型不再仅仅是被动的执行者,而是成为了系统优化的参与者,能够分析线上真实业务流量,定位算力失衡点,并迭代出更高效的路由策略。
在提升效率方面,推测解码技术的优化起到了关键作用。传统的大模型推理是一个串行的过程,每个Token的生成都依赖于前一个Token的计算结果。而GPT-5.6 Sol通过引入并优化小型预测模型,实现了并行校验机制。草稿模型先行预生成一串Token,主模型随后进行并行校验。若校验通过,即可一次性输出多个Token,从而大幅削减串行计算开销。经过数百组架构对比实验与自动化训练值守,整体Token生成效率提升了15%以上。这种效率的提升,直接转化为用户体验的改善和企业使用成本的降低。
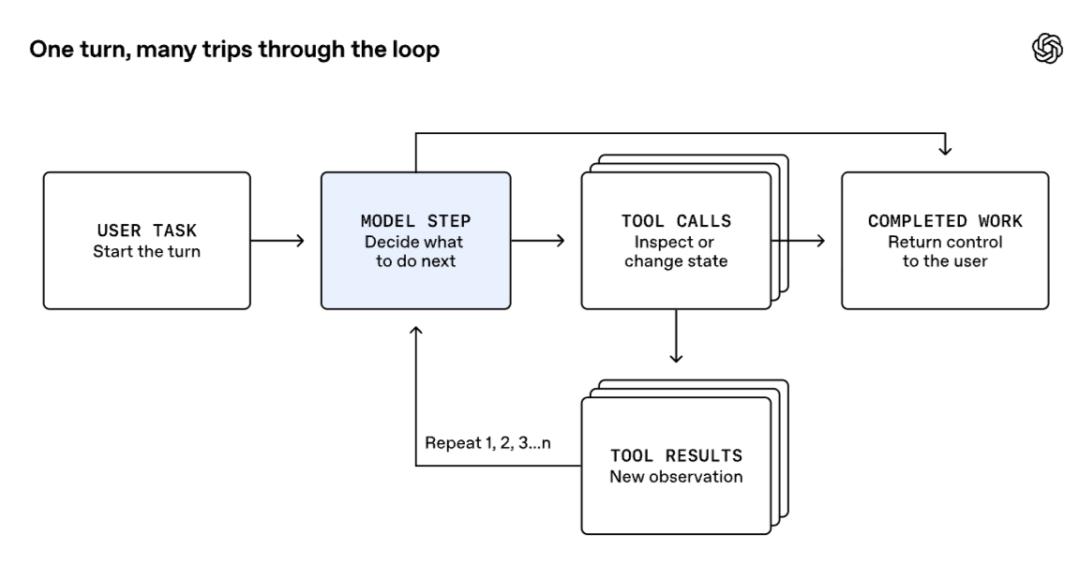
除了底层算力的优化,智能体调度基座的改进也是此次升级的重点。在实际应用中,智能体往往需要执行查看代码、检索记录、编辑文件等一系列复杂操作,每一步都涉及模型请求与工具调用。如果缺乏有效的调度机制,上下文膨胀、重复计算和冗余操作将严重拖慢系统响应速度。OpenAI通过三大手段解决了这一问题:管控上下文膨胀、优化工具加载机制以及复用已有计算成果。
针对上下文膨胀问题,新的调度框架采用了延迟加载检索机制。各类集成组件、自定义工具及插件仅在被实际调用时才会载入上下文,避免了无关信息占用宝贵的窗口空间。同时,系统默认限制工具返回内容的长度,防止单一工具输出过多冗余数据干扰模型判断。这种精细化的资源管理,使得模型能够更专注于核心任务的处理,而非在海量无关信息中迷失方向。
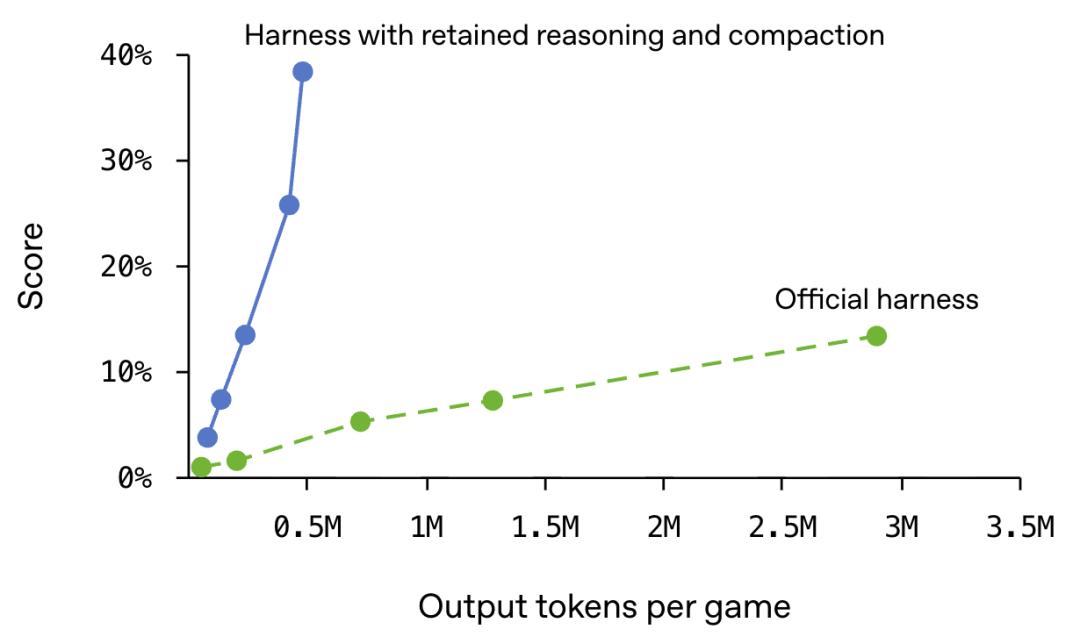
在计算成果复用方面,提示词缓存机制发挥了重要作用。通过将模型可见的历史数据设置为仅追加写入模式,系统能够稳定保留前缀缓存内容。新增的消息、工具返回数据等只会接续在上下文末尾,不会破坏已有的缓存结构。这意味着,对于重复出现的指令或相似的任务场景,系统可以直接复用之前的计算结果,无需重新进行高耗能的推理运算。这种机制在处理批量任务或长期对话时,能显著降低延迟和算力消耗。
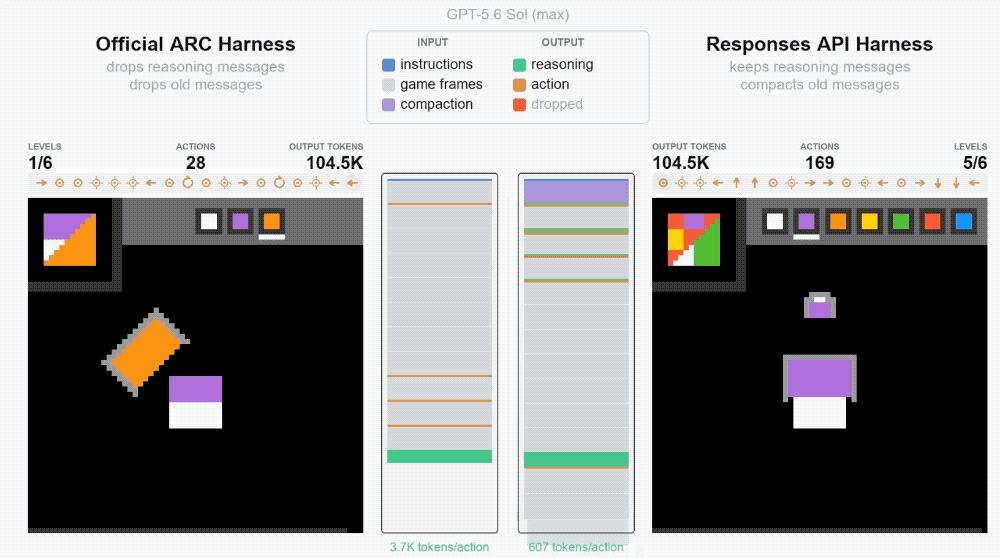
值得注意的是,GPT-5.6 Sol在ARC-AGI-3二维解谜基准测试中的表现,揭示了智能体调度框架对模型性能的巨大影响。起初,在使用极简通用型调度框架且未挂载专属增强功能的情况下,GPT-5.6 Sol的正确率仅为7.8%。然而,当研究人员启用推理记忆留存与上下文压缩配置后,得分迅速提升至38.3%。这一现象表明,模型能力的发挥高度依赖于其与环境交互的方式。
原有的滚动截断机制会导致早期操作记录和推理思路的丢失,使模型在长任务中陷入“失忆”状态。而通过Responses API重构的调度框架,允许模型在多轮交互中完整保留私有推理报文。即使上下文长度超限,系统也会通过摘要压缩而非直接丢弃的方式来处理历史数据。这使得模型能够汲取过往的经验,形成连贯的解题策略,从而在复杂任务中表现出更强的鲁棒性和智能性。
人才层面的变动同样值得关注。前Thinking Machines Lab联合创始人翁荔的回归,被视为OpenAI加强AI自进化研究的重要信号。翁荔在AI代理系统和自动化研究领域的深厚积累,将为OpenAI在模型自主迭代、自我修复及持续学习等方面提供关键支持。她的加入,预示着AI自进化将从理论探索走向更深层次的工程实践,未来模型可能具备更强的自主适应环境和解决未知问题的能力。
与此同时,OpenAI在硬件领域的布局也初露端倪。总裁格雷格·布罗克曼透露,公司正在打造AI硬件设备,并认为人与电脑的对话将成为主流交互方式。虽然具体形态尚未公布,但结合其在软件层面的优化成果,可以推测这款硬件将在端侧推理、隐私保护及无缝交互体验上有所突破。这将进一步模糊云端与本地的界限,推动AI技术向更普及、更个性化的方向发展。
用户规模的爆发式增长也为这些技术优化提供了丰富的数据燃料。OpenAI宣布其用户规模首次突破10亿,服务企业数量达到200万家。如此庞大的用户基数,不仅验证了产品的市场接受度,更为模型优化提供了海量的真实场景数据。这些数据反馈形成的闭环,使得GPT-5.6 Sol能够不断发现系统短板,进行针对性的迭代优化,从而形成越用越强、越用越快的正向循环。
从行业视角来看,大模型竞争已进入全栈工程化比拼阶段。单纯的算法创新已不足以构建护城河,如何在保证智能性的前提下,实现低成本、高效率、可规模化的产业落地,成为各大厂商角逐的关键。OpenAI通过GPT-5.6系列展示的工程化能力,包括底层内核优化、中间层调度改进以及上层应用适配,为行业树立了新的标杆。
对于开发者而言,理解并应用这些优化策略至关重要。在进行API开发或模型部署时,应充分考虑上下文管理、缓存利用及工具调用的效率问题。采用与官方评估一致的设置,如开启推理记忆留存和上下文压缩,能够更准确地模拟实际应用场景,从而获得更优的性能表现。此外,关注模型在特定任务中的行为模式,针对性地调整调度框架参数,也是提升应用效果的有效途径。
展望未来,随着AI自进化技术的成熟,模型将具备更强的自主优化能力。从代码编写到系统调优,从数据处理到策略制定,AI将在更多环节替代人工,实现真正的自动化闭环。这不仅将极大提升生产效率,也将催生新的商业模式和应用形态。然而,这也带来了关于安全性、可控性及伦理问题的新挑战,需要行业共同关注和解决。
总之,GPT-5.6的发布不仅是技术参数的提升,更是AI发展范式的一次重要转变。它标志着我们正从“制造智能”迈向“培育智能”,从“被动使用”转向“主动协同”。在这一进程中,全栈工程化的深度优化将成为推动AI技术普惠化、规模化落地的核心动力。对于每一位从业者和关注者来说,深入理解这一变革背后的逻辑,把握技术演进的方向,将是应对未来挑战的关键所在。