Agentic Infra重塑AI基建:从算力聚合到具身智能的进化逻辑
算力困境与范式转移:从线性堆叠到效率突围
随着人工智能技术从预训练向后训练、推理时扩展乃至智能体扩展(Agentic Scaling)演进,底层基础设施正面临前所未有的压力。单纯依靠增加硬件数量来弥合算力供需缺口,这种线性的“堆料”模式已触及瓶颈。在2026年世界人工智能大会期间,无问芯穹联合创始人兼CEO夏立雪提出的Agentic Infra理念,标志着AI基础设施正从单纯的资源供给向“原生智能”范式转变。
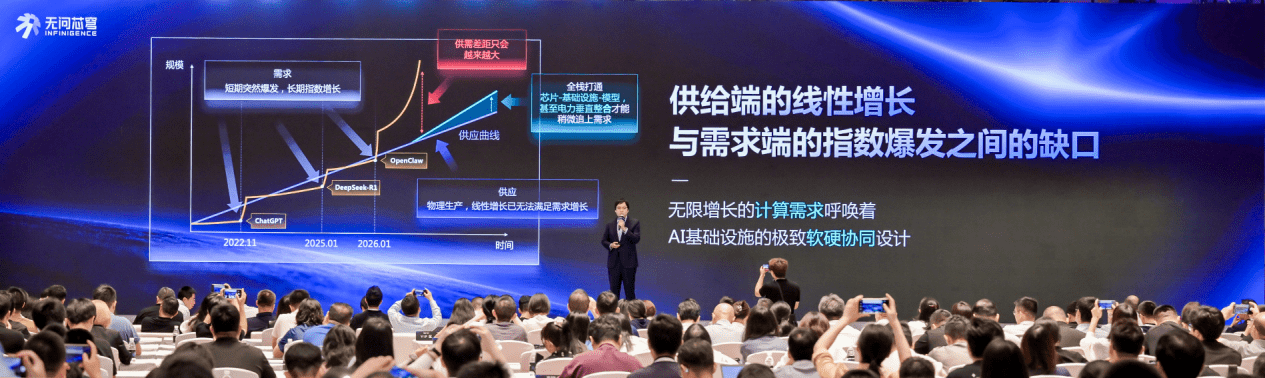
这一转变的核心逻辑在于,基础设施不再仅仅是被动的计算载体,而是需要主动适应智能体时代对规模与效率的极致追求。无问芯穹提出的AI生产力公式——AI生产力等于智能资源规模、Token转化效率与AI生产力转化效率的乘积,清晰地界定了下一代基建的竞争焦点。在此框架下,基础设施必须具备“自主式”能力,通过智能体蜂群机制,实现资源的自我优化、自我调度与自我进化,从而在降低边际成本的同时,支撑更大规模的模型迭代与应用落地。

自主式基础设施:破解异构算力的全球性难题

当前,全球AI行业普遍面临算力异质化、碎片化的痛点。不同厂商的芯片、不同年代的设备、不同地域的数据中心,往往形成一个个“算力孤岛”。无问芯穹将“算力集散中心”定义为Agentic Infra的第一大核心能力,旨在通过软硬件协同技术,将这些分散的资源聚合为一个逻辑统一的超级集群。

这一能力的验证并非纸上谈兵。无问芯穹已在国内部署了触达37,000P算力的跨域训练系统,覆盖16种主流芯片。其技术突破体现在三个维度:一是超远距离聚合,通过联合中国电信,在新疆哈密与广东深圳之间完成超4000公里的大模型跨域混训,性能提升165%,证明了广域网环境下的协同可行性;二是多数据中心聚合,打通四个不同代际的GPU集群,协同性能提升41%,有效盘活了存量异构资源;三是混合云聚合,实现本地私有云与公有云的安全互通,性能提升68%,解决了资源错配问题。
面对强化学习这一下一代AI进步的关键手段,无问芯穹进一步聚焦跨集群强化学习场景。该场景不仅对算力规模要求极高,更对稳定性提出苛刻要求——在万卡级规模下,故障频率以小时计,而传统恢复任务耗时长达数十分钟。为此,无问芯穹通过计算通信重叠技术,将跨域通信效率提升3-4倍,实现了通信开销的完全掩盖,并构建了故障无感训练机制,实现了跨域强化学习训练连续一周零中断。这一突破让大规模训练不仅能“跑得通”,更能“跑得快、跑得稳”,为十万卡级以上的智能体进化奠定了坚实基础。
Token工厂:以极致效率重构推理经济
在Agentic时代,智能体交互呈现出上下文极长、轮次极多、缓存命中率极高的特征,这对推理系统的吞吐量和时延提出了远超传统对话场景的要求。无问芯穹将自身的MaaS平台定义为“Token工厂”,核心目标是通过技术创新,将Token的生产成本降至最低,从而释放智能体的商业潜力。
其首创的跨集群异构PD分离架构(PDD),是这一“工厂”的核心生产线。传统推理中,Prefill(预填充)和Decode(解码)阶段往往在同一集群内完成,导致不同硬件的特性无法得到极致利用。PDD架构利用高性价比的以太网,将分布式的同构数据中心连接起来,让算力强的集群专攻Prefill,让显存带宽高的集群专攻Decode。这种“偏科硬件做擅长事”的设计,极大提升了整体效率。
为解决跨集群传输中的带宽与延迟瓶颈,无问芯穹引入了跨集群KV Cache去重技术,将传输数据量降低一个数量级。同时,创新的三级分离式推理架构(P-RLD-MD),通过RelayDecode先行输出Token,掩盖了以太网传输的数十秒延迟,确保用户端感知的流畅性。实测数据显示,该架构使首Token延迟降低51.5%,单Token成本降低37.5%。过去一年,无问芯穹通过此类优化推动推理成本下降10倍,并预判随着PDD架构的规模化落地,仍有10倍的降本空间。这种“优化即利润”的增长飞轮,正在通过Kimi、智谱等头部客户的业务反哺,加速技术迭代。

智能体蜂群:基础设施的自主进化能力

Agentic Infra的另一大显著特征,是将智能体技术反向赋能给基础设施本身,形成一套“基础设施智能体蜂群”。这套蜂群系统由平台管家、集群运维和算子生成三大智能体子集构成,旨在实现基础设施的自主迭代与自我优化。

平台管家智能体作为全局统筹者,通过自然语言交互降低用户使用门槛,能独立解决80%的日常资源运营与排障问题。集群运维智能体则扮演7×24小时的“运维专家团”,通过主智能体协同故障排查、环境部署等子智能体,实现从“人找问题”到“问题自动解决”的转变。生产环境验证表明,该系统使运维人效提升5倍以上,关键故障处理效率提升6倍。

在算力释放的最后一公里——算子优化上,KernelMind算子生成智能体系统通过“需求分析-智能调度-内核生成-沙箱验证-评审沉淀”的五步闭环,实现算子的持续自迭代。在GLM5.2模型的实测中,该系统在NVIDIA旗舰卡上实现7.3%的性能提升,在AMD旗舰卡上更是带来39%的性能跃升,证明了AI原生能力在硬核性能优化上的巨大潜力。

迈向物理世界:具身智能的云边端协同
无问芯穹的视野并未局限于云端数字世界,而是延伸至物理世界的具身智能(Embodied AI)。夏立雪指出,具身智能的Scaling Law同样需要高效率、大规模的基础设施支持。为此,无问芯穹发布了首个面向大规模具身任务的云边端一体化管理与调度平台。
该平台将云端GPU集群、边缘算力节点和机器人真机设备统一接入,支持训练、数据采集、评测和真机执行的统一编排。针对具身智能的核心痛点,无问芯穹推出了RLinf V0.3框架,支持具身智能的大规模真机跨域端云协同强化学习。通过与智元、清华大学的合作,RLinf V0.3支持真机设备1000+次在线上下线训练零中断,并将近百台真机的专线需求降至2Gbps以下,大幅降低了规模化训练成本。

在端侧推理优化方面,Mizar-Robo全栈优化体系通过流水线调度、算子内核、量化压缩等四层协同,释放低功耗硬件的潜力。在与自变量机器人WALL-OSS模型的联合优化中,实现了7.14倍的推理性能提升,端侧时延从500ms压缩至70ms,降幅达86%。这不仅保障了实时交互的流畅度,更为机器人产品从实验室走向规模化商用提供了关键的基础设施支撑。
结语:让智能无处不在
从聚异构算力为整体,到降Token成本到极致,再到赋能具身智能跨越虚实边界,无问芯穹的Agentic Infra体系构建了一个完整的闭环。它不再仅仅是提供算力的“水电煤”,而是成为具备自主进化能力的智能体底座。在AGI时代,基础设施的竞争将从单一的性能指标转向系统级的效率与智能水平。正如夏立雪所言,“让智能无所不能是AGI,让智能无处不在是AGI Infra”。这一愿景的实现,依赖于每一行代码的优化、每一次算力的调度以及每一个智能体的进化。随着Agentic Infra范式的成熟,我们有理由相信,未来数字与物理世界的所有AI生产力,都将建立在这样高效、自主且普惠的基础设施之上。
