从Harness到Loop:LoopsBench如何重塑长周期编程智能体评测范式
近年来,编程智能体(Coding Agent)的能力边界不断拓展。早期系统主要聚焦于解决单一问题——修复一个bug、实现一个独立功能或完成一个GitHub issue。围绕这类任务,SWE-bench等基准建立了成熟的评测范式:给定代码仓库和需求描述,智能体修改代码,最终通过测试用例判断任务是否成功。这种“输入-输出”式的评估逻辑清晰、可复现,有效推动了智能体在局部代码理解与生成上的进步。
然而,当智能体开始承担更复杂的角色——如持续数小时的开发会话、自主推进多阶段功能、动态协调子任务并维护长期状态时,仅关注最终结果的评测方式便显露出局限性。一个典型的软件开发过程往往包含多个前后依赖的环节:先设计数据结构,再定义接口,接着实现业务逻辑,最后集成CLI与异常处理。后续步骤不仅依赖前置成果,还必须确保已有功能不被新修改破坏。若只在终点运行一次测试,我们虽知最终成败,却无法回答:智能体是否识别了任务间的依赖?它是否按合理顺序推进?哪些功能曾被正确实现又因后续修改而退化?
正是在这一背景下,微软、南京大学等机构提出了LoopsBench——首个面向长周期软件工程(long-horizon software engineering)的编程智能体评测基准。该工作标志着评测焦点正从“一次性工具调用”向“持续性开发循环”迁移,其核心理念是:评测不应止步于终端结果,而应深入执行过程本身。
LoopsBench的关键创新在于重构了软件任务的表示方式。传统基准将任务视为整体需求,而LoopsBench将其拆解为多个可独立验证的开发单元(Development Unit),并通过真实代码证据重建它们之间的依赖关系,最终形成一张依赖有向无环图(Dependency DAG)。图中节点代表具体的工程产出(如新增API、扩展schema、实现模块),边则表示明确的前置依赖——例如后一单元调用了前一单元定义的函数,或继承了其类结构。值得注意的是,这张DAG并非强制规定唯一正确顺序,而是一个评估契约(evaluation contract):只要智能体的执行路径符合依赖约束(即不违反拓扑序),无论其选择串行、并行或回溯修改,均被视为有效探索。
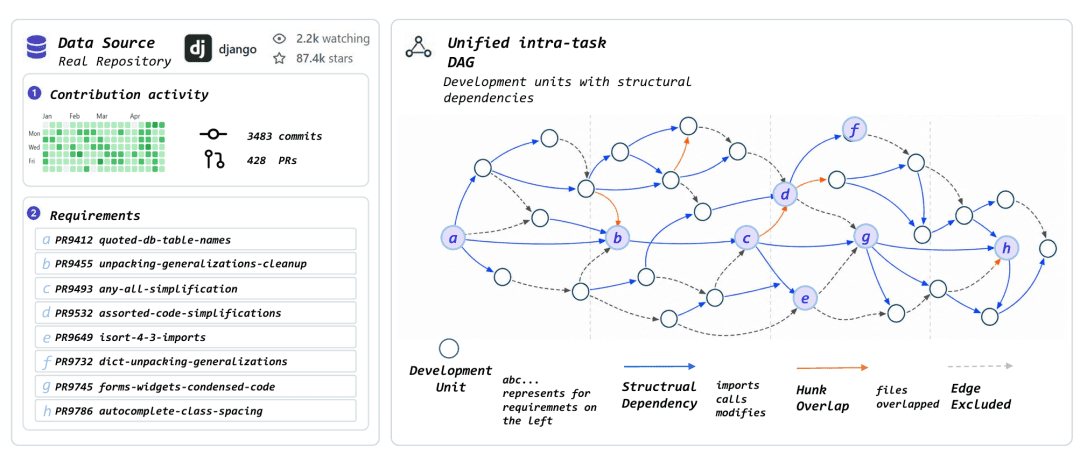
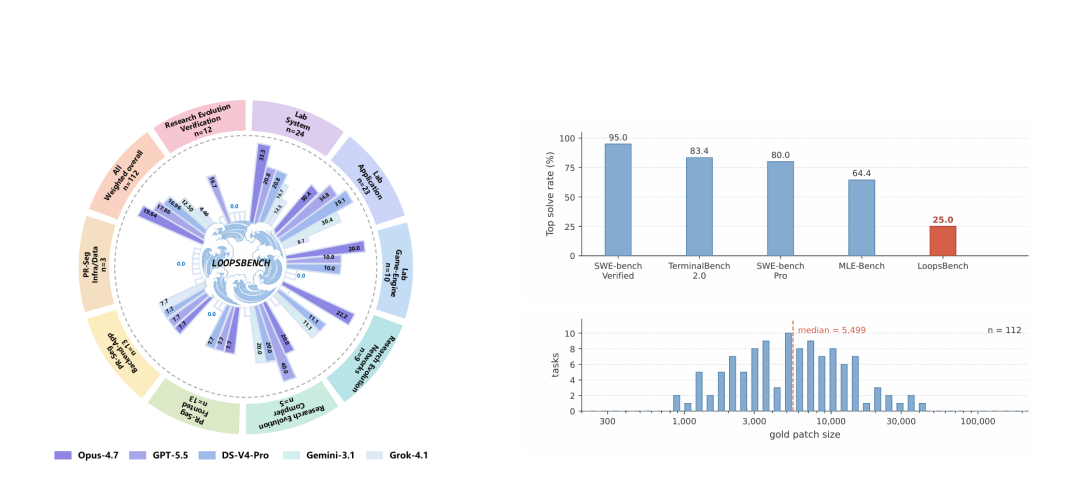
为确保DAG的真实性与工程意义,LoopsBench从三类真实软件演化材料中构建任务:大学课程实验(Course Labs)、连续Pull Request序列(PR Sequences)和研究代码演进链(Research Evolutions)。课程项目天然具备阶段性目标;开源项目的连续PR常呈现清晰的接口扩展与模块叠加;研究代码则随论文方法迭代逐步深化。最终发布的112个任务包含超过5,300个开发单元,覆盖Python、Java、C++等8种语言及Web开发、系统工具、机器学习等9大领域,任务依赖深度中位数达6层,充分体现了长周期开发的复杂性。
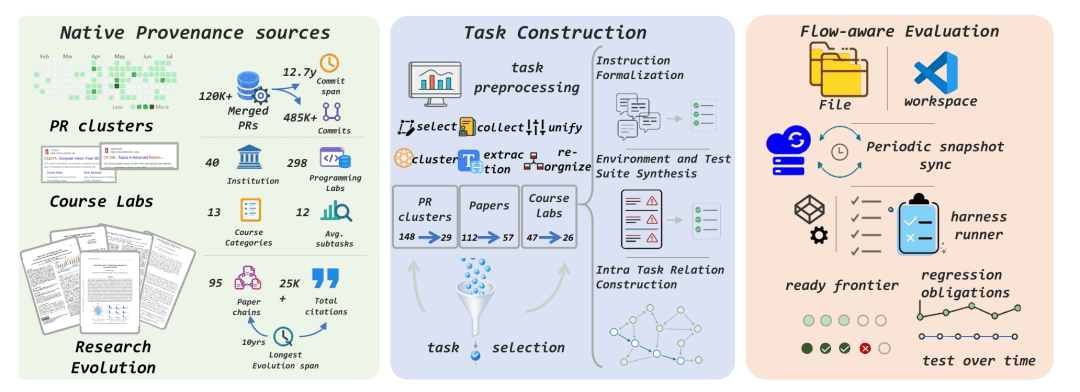
将原始材料转化为可执行基准并非易事。PR历史中混杂无关修改,课程要求分散于文档与测试,研究代码变化涉及算法与工程耦合。LoopsBench采用保守策略:仅当存在符号级证据(如函数调用、类继承、结构复用)时才建立依赖边,宁可遗漏隐式依赖也不引入猜测性连接。每个开发单元均配备可执行测试,且需通过黄金解验证流程——确保测试在未实现时失败、正确实现后通过,且不能被前置工作提前满足。这使得评测对象不再是抽象里程碑,而是真实可验证的代码状态。
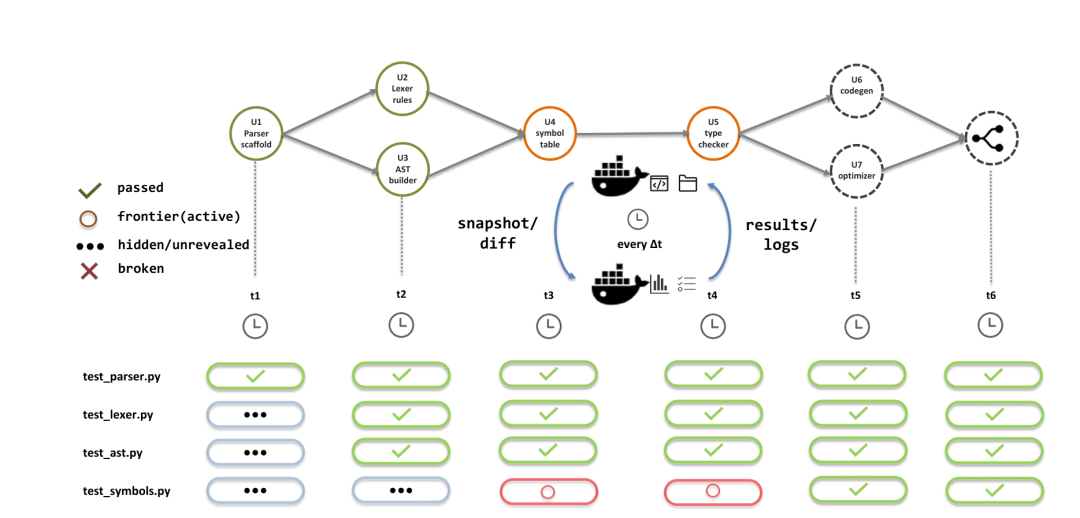
有了依赖DAG,评测器还需动态决定“何时检查何任务”。LoopsBench为此设计了流感知运行时(Flow-aware Runtime)。系统维护一个就绪前沿(Ready Frontier):仅当某开发单元的所有前置依赖均完成后,其对应测试才被激活纳入评估。随着智能体逐步完成任务,前沿沿DAG拓扑向前推进。这一机制使评测不仅能统计通过率,还能刻画智能体在依赖结构中的推进深度——是否打通了关键前置节点?是否卡在某个阻塞点?更重要的是,它不要求智能体遵循预设路径,而是评估其自主发现合理工程路线的能力。
长周期开发的另一核心挑战是状态维护。在真实工程中,已完成的功能不会因进入下一阶段而“消失”,新代码必须兼容旧有正确行为。LoopsBench通过回归义务(Regression Obligation)机制模拟此约束:一旦某开发单元被标记为完成,其测试将持续存在于后续所有评估轮次中。智能体每前进一步,所承担的正确性义务便增加一分。这迫使系统在实现新功能的同时,守护已有成果。为精确追踪状态演变,LoopsBench将智能体编辑环境与评测环境分离——前者持续工作,后者基于代码快照独立运行测试,从而记录完整的开发轨迹。
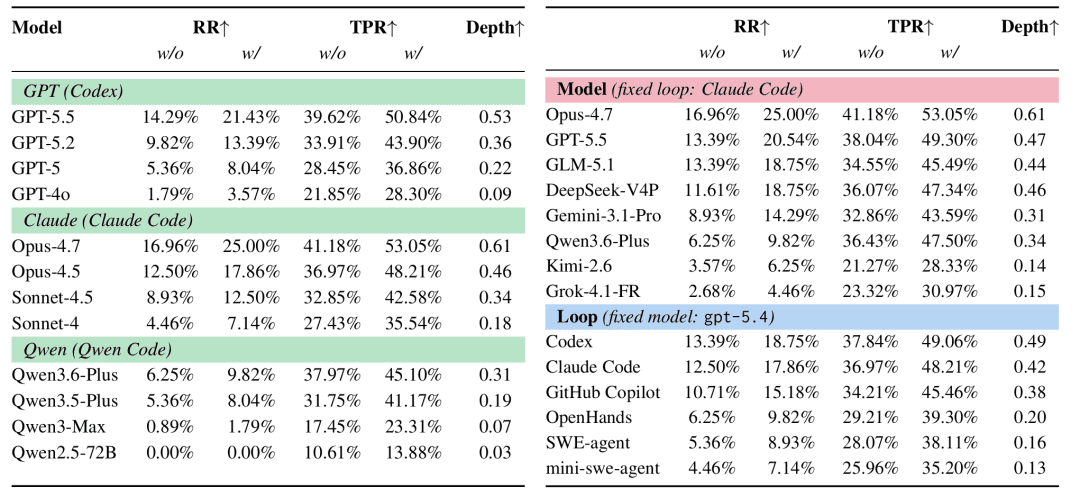
基于此框架,研究团队开展了三项关键实验。首先,在112个任务上测试当前主流智能体,结果显示:即使采用最强模型与外层续执行机制(outer continuation),任务解决率(Resolve Rate)仅为25.00%,测试通过率53.05%。这表明长周期任务仍是巨大挑战。进一步分析发现,模型能力与Loop设计分别影响不同层面:更强的基础模型提升局部代码质量,而Loop机制决定能力如何在时间维度上组织利用。引入continuation可将解决率从16.96%提升至25.00%,说明部分失败源于过早终止,但续执行无法自动解决深层依赖识别与状态维护问题。
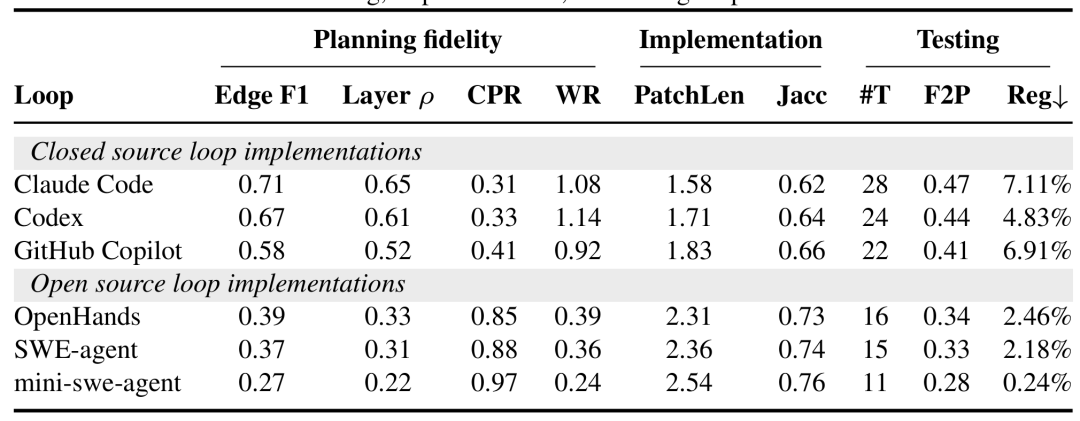
其次,通过对执行轨迹的细粒度分析,研究揭示了三大瓶颈。在规划层面,智能体生成的计划仅覆盖部分依赖关系,常将并行任务压成线性链,或过早并行本应串行的任务——关键不在于并行与否,而在于是否匹配真实软件结构。在实现层面,即使成功单元的补丁也普遍比参考实现更冗长,暗示额外修改随任务累积,增大后续维护负担。在测试层面,智能体虽运行现有测试,却极少主动编写新测试,导致新增功能缺乏回归保护,已完成单元在后续修改中频繁退化。
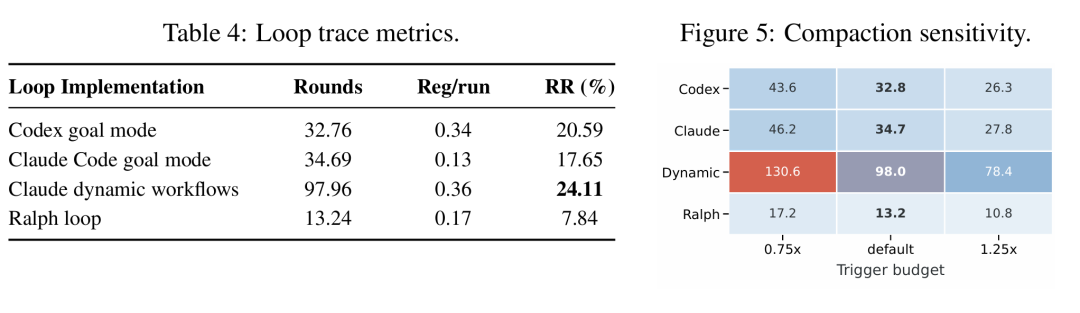
最后,研究比较了不同Loop机制的影响。Goal Mode通过长期维护目标持续推进,动态工作流(dynamic workflows)拆分任务给多worker取得较高解决率,而单纯依赖全新调用(fresh invocation)接管残余工作的机制在复杂任务上表现较弱。但所有机制均未能完全消除回归,凸显状态保留(state retention)、残余路由(residual routing)与回归义务继承是Loop工程的核心难题。
这些发现共同指向一个范式转移:过去十年,编程智能体的进步很大程度上依赖Harness Engineering——优化模型与环境的交互接口,如改进文件搜索、编辑工具、沙箱隔离与上下文窗口。这解决了“模型如何与软件环境交互”的问题。但当任务延伸至小时级甚至更长,新问题浮现:“智能体如何跨时间持续工作”?这属于Loop Engineering范畴——涉及目标持久化、上下文更新、任务调度、状态同步与回归防控。Harness是智能体与环境的“手”和“眼”,Loop则是其“记忆”与“计划中枢”。
LoopsBench的意义正在于此:它不仅提供了一个新基准,更倡导一种新评测哲学——Benchmark应帮助我们理解智能体为何停在那里,而不仅是它最终到达何处。通过将开发过程展开为时间轨迹,结合依赖结构、就绪前沿、回归义务与Loop痕迹,研究者得以诊断失败根源,指导系统设计。未来,随着智能体向全周期软件开发伙伴演进,Loop Engineering将成为与Harness Engineering同等重要的研究支柱,而LoopsBench为此提供了不可或缺的测量标尺。