ClinFusion:视觉为核的多模态医疗大模型如何突破临床落地瓶颈?
近年来,多模态大模型在通用领域展现出强大能力,但在医疗场景的临床落地仍步履维艰。根本原因在于,医学影像的复杂性远超自然图像——从病理切片的微观纹理到CT/MRI的三维解剖结构,数据形态高度异构;而临床诊断并非文本匹配游戏,而是基于申请单指征、病史背景和影像特征的定向推理过程。现有模型要么依赖单一视觉编码器强行适配所有模态,要么评测体系仅关注表面语义相似度,忽视了放射科医师真实的读片逻辑。
在此背景下,ClinFusion的提出具有范式革新意义。它不再将视觉模块视为辅助输入通道,而是以视觉为核心重构整个多模态架构,并同步建立与临床实践对齐的评测标准。这种“架构+评测”双轮驱动的思路,直击医疗AI落地的核心痛点。
组合式视觉编码:打破单一架构的局限
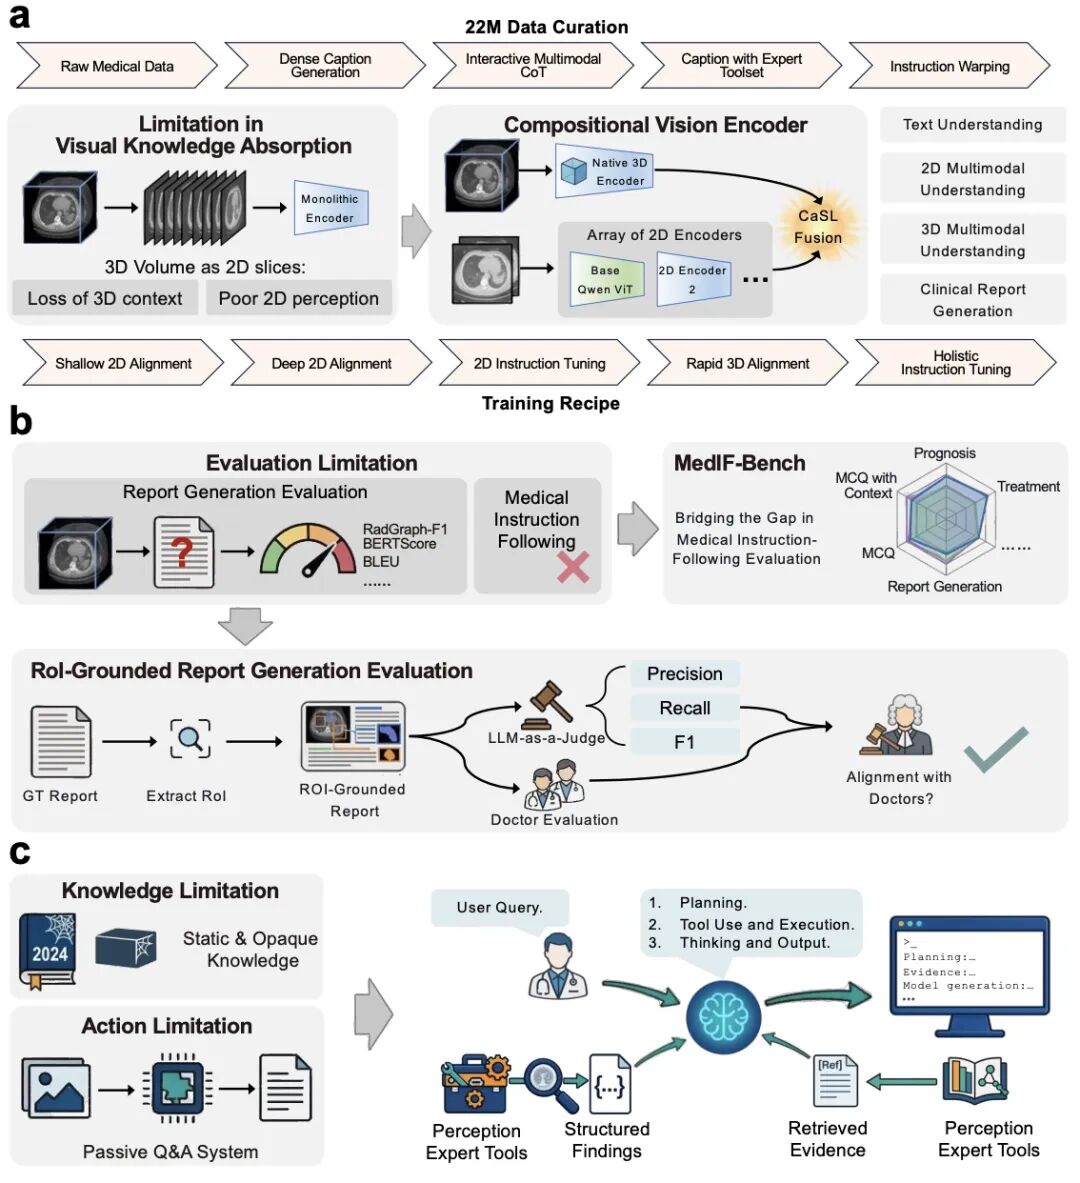
传统医疗多模态模型通常采用统一的2D或3D编码器处理所有影像。2D方案虽计算高效,但将CT等体数据切片化处理会丢失关键的层间空间关系;3D方案虽保留结构完整性,却因数据稀疏、标注成本高而难以充分训练,且与语言模型的对齐流程极为复杂。
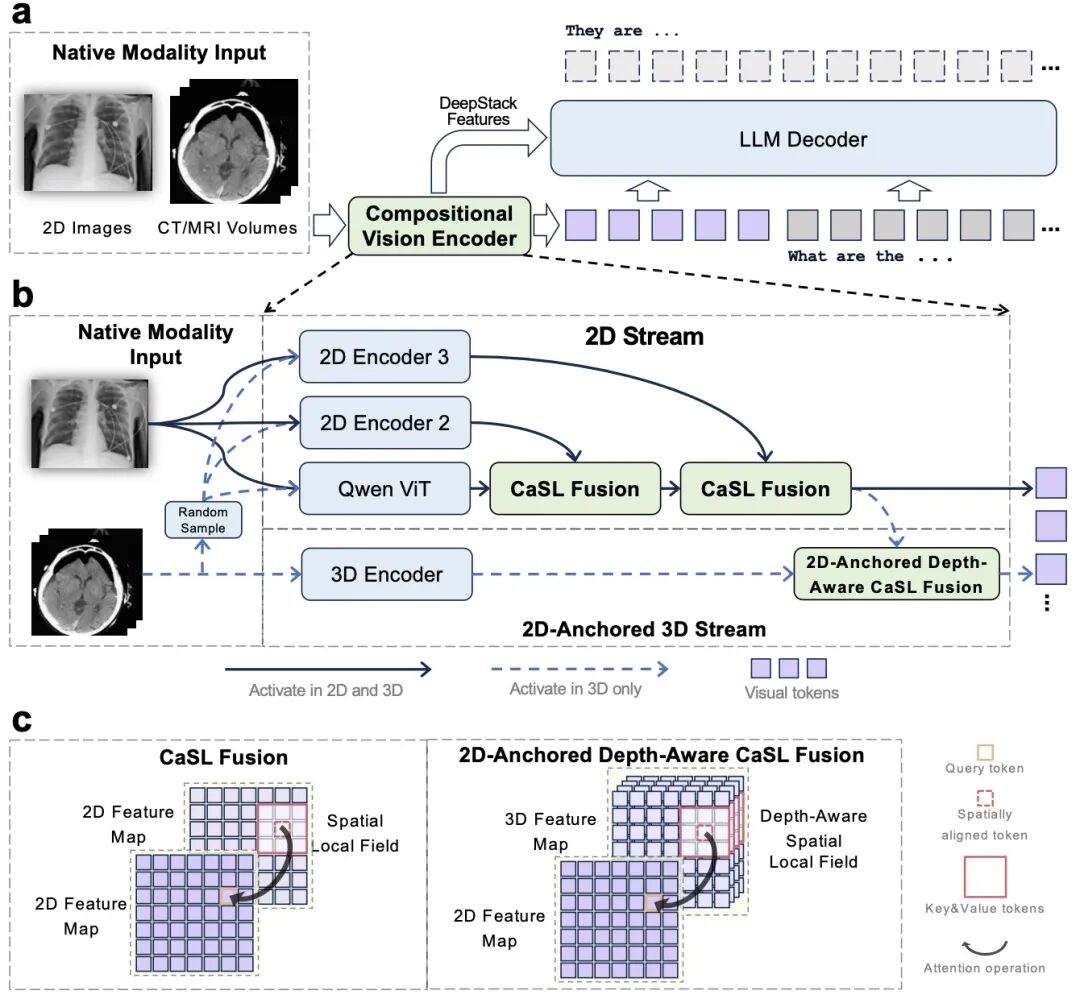
ClinFusion的创新在于引入“组合式专家编码器”策略。主干采用Qwen ViT作为基础视觉表征,再并联两个专业化编码器:ConvNeXt擅长捕捉高频细节(如肺结节边缘、组织异型性),DINOv2则提供更鲁棒的高层语义(如器官整体形态、病变分布模式)。关键在于,这些专家知识并非简单拼接,而是通过CaSL Fusion(Context-aware Spatially Localized Fusion)机制进行渐进式融合。
具体而言,CaSL Fusion以Qwen ViT的每个视觉token为query,在DINOv2或ConvNeXt对应空间位置的k×k局部邻域内提取key/value进行交叉注意力计算。这种设计有三大优势:一是保持视觉token数量不变,避免LLM输入膨胀;二是将计算复杂度从O(N²)降至O(N),适合高分辨率医学图像;三是非对称、左结合的级联结构确保主干表征始终主导,专家编码器仅作增强而非替代。消融实验证明,级联融合在报告生成任务上比并行融合高出1.5个F1点,说明渐进富化对开放式输出更为有效。
2D锚定的3D理解:低成本实现体数据建模
对于CT、MRI等3D数据,ClinFusion并未直接采用端到端3D编码,而是提出“2D锚定”的深度感知策略。系统首先从体数据中采样4张具有代表性的锚定切片(如包含关键解剖标志的层面),利用已充分预训练的2D编码器提取强语义特征。随后,在CaSL Fusion中将注意力范围从k×k空间邻域扩展为“k×k × 全深度维”,即每个锚定token可跨切片聚合信息。
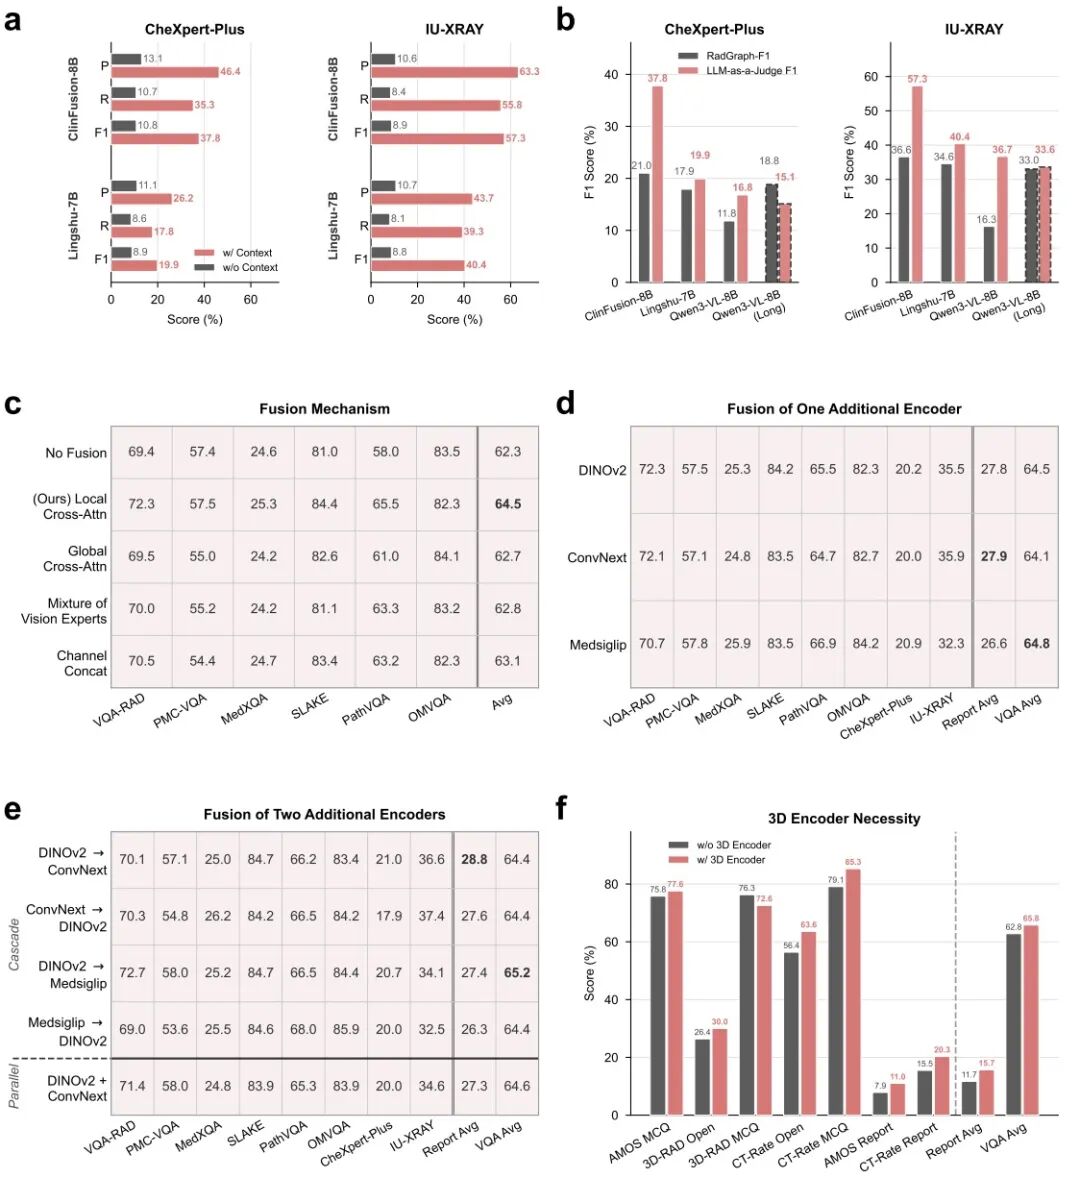
这一设计巧妙复用了2D模型中丰富的预训练知识,同时通过对比学习预对齐的专用3D编码器PE-3D补充深度上下文。实验显示,若在推理时关闭3D通路,3D VQA性能平均下降3.0分,报告F1下降4.0分,证明体数据中的解剖连续性无法被稀疏2D切片替代。更重要的是,该方法避免了从头训练庞大3D编码器的成本,实现了效率与性能的平衡。
临床对齐的评测新范式:从文本匹配到事实判定
如果说架构创新解决了“如何看”的问题,那么评测体系的重构则回答了“如何评”。传统医疗报告生成评测存在致命缺陷:要求模型生成“全面”报告并与参考文本比对,但现实中放射科医师只会根据临床指征聚焦特定区域。例如,一份因咳嗽就诊的胸片,医师可能只关注肺部感染征象,忽略无关的骨骼细节。若模型描述了参考报告未提及的正常结构,会被误判为“幻觉”;反之,若遗漏了指征相关异常,则可能因未出现在参考文本中而逃过检测。
ClinFusion团队提出的RoI-Grounded评测框架彻底改变了这一逻辑。流程分为三步:首先,用LLM从参考报告中提取“临床指征”(如“评估肺部感染”)和“关注解剖区域”(如“双肺下叶”),并将这些上下文注入待测模型;其次,模型基于此生成聚焦的区域锚定报告;最后,由另一个LLM判官逐条比对论断,明确标记[MATCHED](正确命中)、[MISSED](漏诊)、[HALLUCINATED](幻觉)三类结果,直接计算Precision、Recall与F1。
这种设计不仅贴合临床实际,还规避了传统指标的固有缺陷。例如,RadGraph-F1将报告解析为固定schema的实体关系,导致同义表述(如“肝肿大”vs“hepatomegaly”)被判为错误,且存在长度偏置——冗长报告更容易与参考文本重叠而得分虚高。ClinFusion的判官机制则能识别语义等价性,并对无意义冗余进行惩罚。数据显示,当人为增加输出长度时,RadGraph-F1从11.8升至18.8,而ClinFusion判官反而从16.8降至15.1,更符合临床评价逻辑。
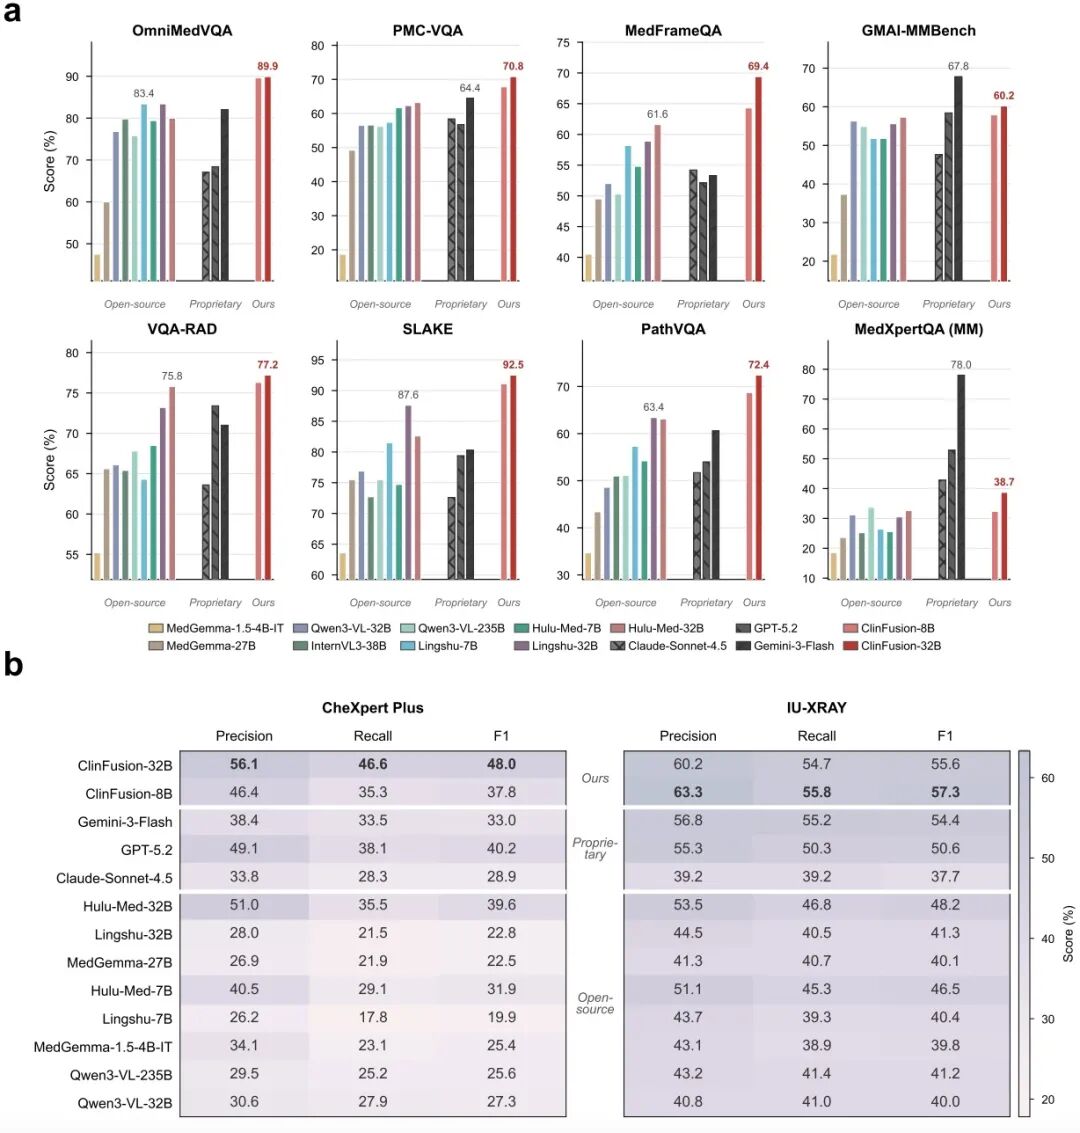
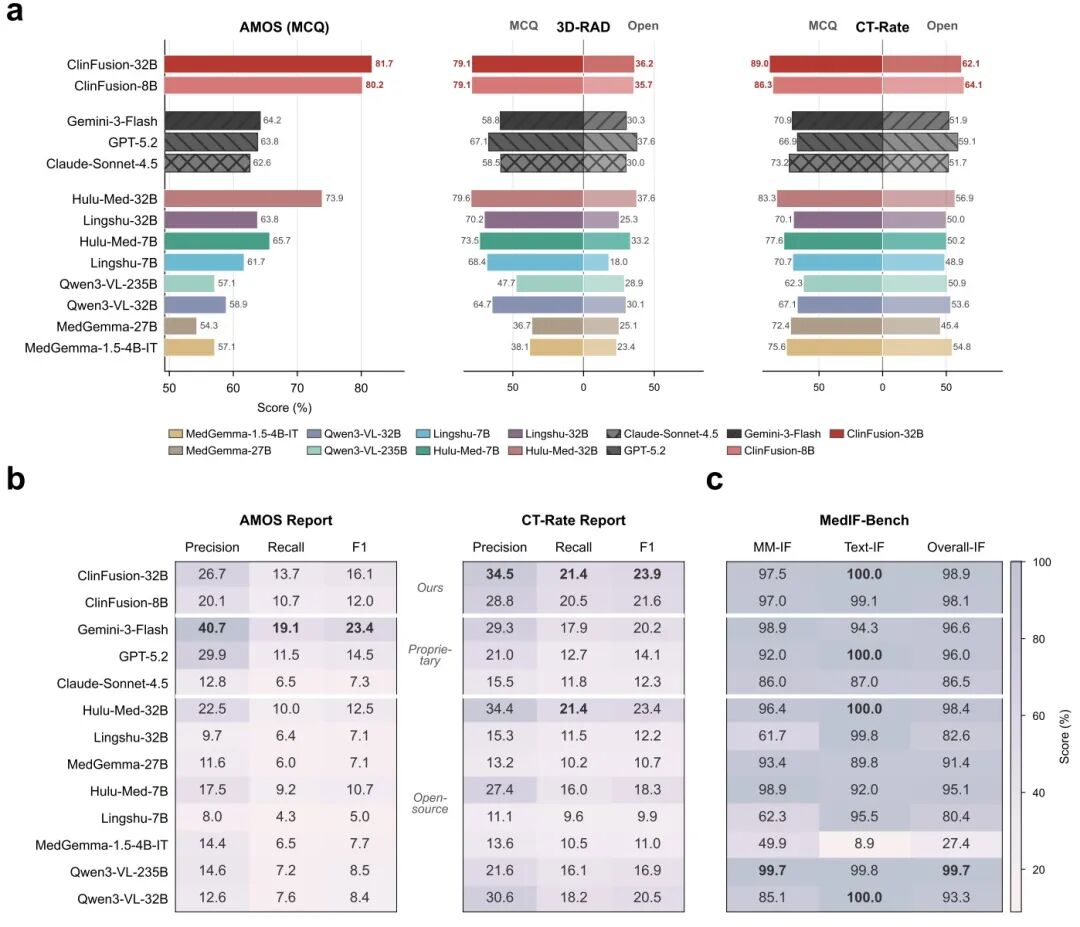
此外,MedIF-Bench专门评估指令跟随能力。医疗微调常导致模型忽略输出格式要求(如必须返回JSON结构),而该基准包含900个样本,涵盖七类结构化输出任务(如带标准标题的报告、对接EMR的字段填充),仅评测格式合规性。ClinFusion-8B在此项得分高达98.1,远超Lingshu-7B的80.4,证明其在领域适配中未牺牲基础能力。
实证效果:3D优势显著,临床盲评验证
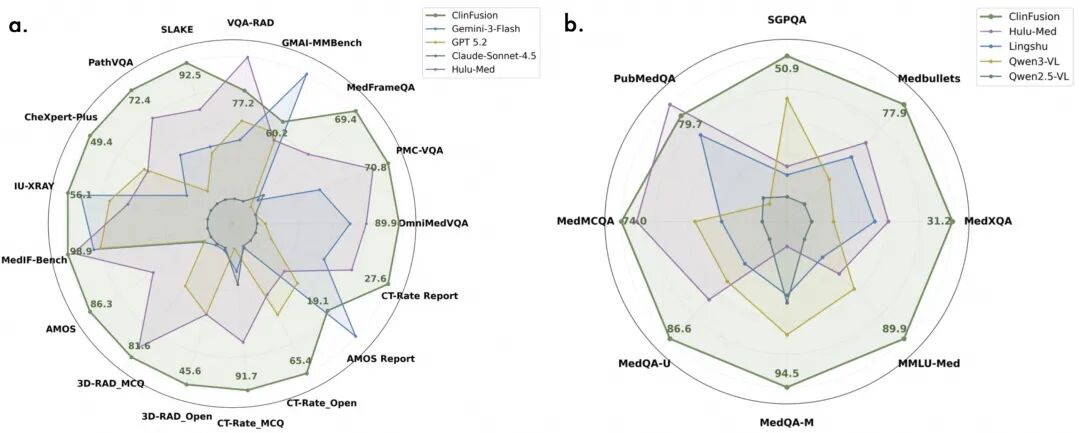
在八大2D医学VQA基准上,ClinFusion-8B在七个任务中取得医疗模型最佳成绩,多数超越Gemini-3-Flash。而在3D任务中优势更为突出:在腹部CT问答上,8B版本比同量级最强开源模型高出14.5分,甚至超过参数量四倍的32B基线;32B版本在CT报告生成F1上达到所有参评模型最高。
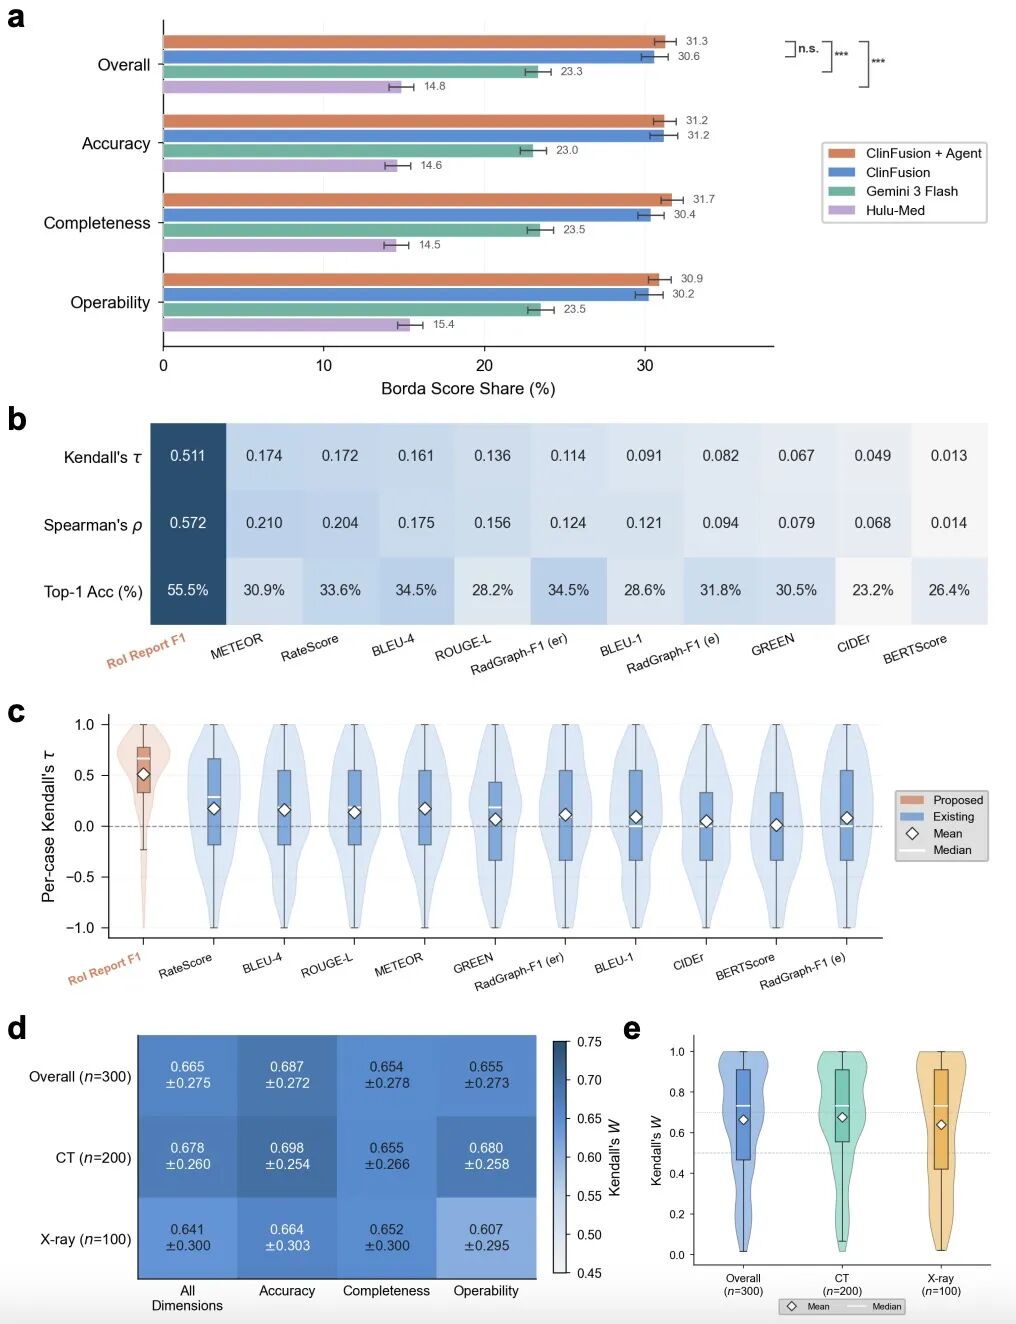
更具说服力的是六位资深放射科医师(临床经验≥6年)的盲评结果。在300例胸部X光、胸部CT、腹部CT病例中,ClinFusion(含agentic版本)在事实准确性、完整性、临床可用性三个维度均排名第一,且与Hulu-Med、Gemini-3-Flash的差异具有统计显著性(p<0.001)。值得注意的是,自动指标与专家判断的相关性分析显示,RoI-Grounded评测的Kendall's τ达0.511,显著高于其他指标,证明其更能反映真实临床质量。
Agentic扩展:从静态模型到可审计临床助手
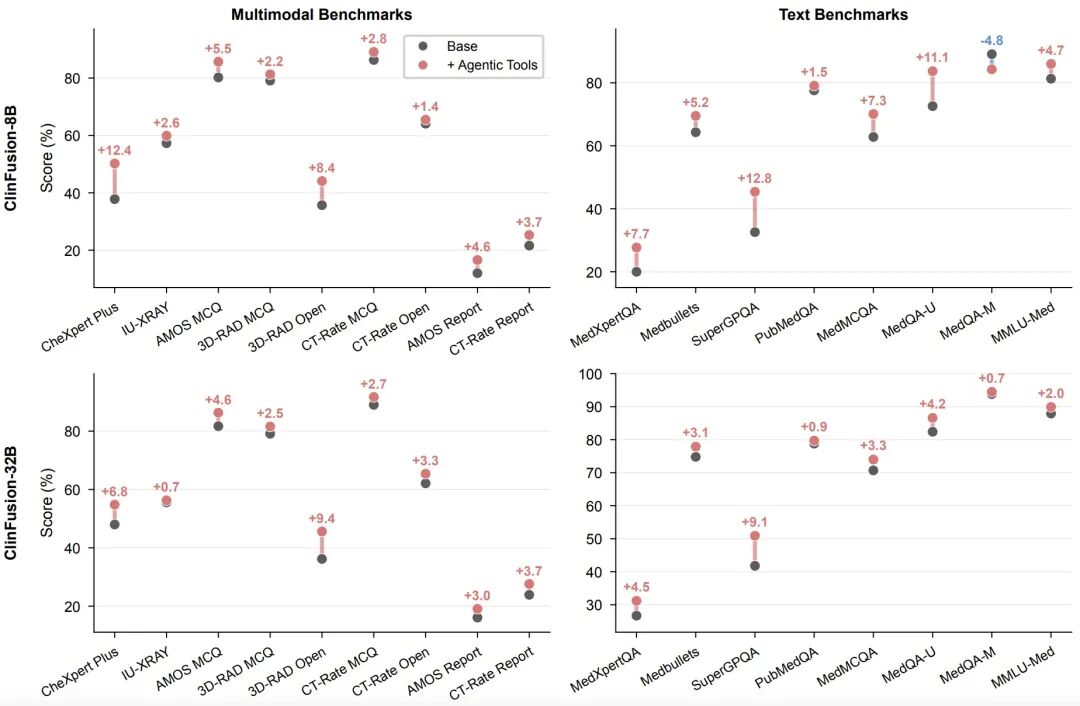
ClinFusion进一步通过工具调用实现动态知识增强。系统采用plan–act工作流:先规划工具调用序列,再执行并收集结构化中间证据(如病灶分割结果、指南检索片段),最终综合生成临床回复。工具库包含两类:一是知识工具(混合RAG,整合PubMed、临床指南、教科书等1.8万份中美指南及10万篇文献);二是感知专家工具(如多器官分割、脂肪肝评估模型)。
这种设计在描述性任务上增益显著:CheXpert-Plus报告F1提升12.4,3D-RAD开放问答提升8.4。更重要的是,所有中间输出均可追溯审计,使推理链条透明化。例如,当模型判断“肝右叶低密度灶”时,可同步展示分割掩码与相关指南条款,便于医师复核。
当然,ClinFusion仍有局限:工具集尚未覆盖超声、MRI等模态;在纯文本知识密集型任务上与顶级闭源模型存在差距,主要受限于训练数据规模;真正的临床部署还需严格的human-in-the-loop验证。但其核心贡献在于证明了:医疗多模态模型的成功不在于堆砌参数,而在于架构与评测是否真正对齐临床本质——以视觉为核,以事实为准,以医师逻辑为尺。