ASI-Bench:衡量AI能否真正自主科研的第一把标尺
近年来,人工智能在各类标准化测试中屡创高分,从数学竞赛到编程挑战,从医学诊断到法律推理,模型的表现令人惊叹。然而,这种“聪明”背后隐藏着一个根本性局限:它们所展示的能力,几乎全部建立在对人类已有知识的高效学习、记忆与重组之上。换句话说,当前的AI擅长的是“已知世界的最优解”,而非“未知领域的首次探索”。
真正的科学突破往往诞生于无人踏足的认知荒原——那里没有现成的问题定义,没有标准答案,甚至没有明确的方法论。爱因斯坦提出相对论时,并非在解答一道已有题库中的物理题;沃森与克里克发现DNA双螺旋结构,也不是在执行一份预设的实验流程。他们的伟大之处,在于能在混沌中识别出值得追问的问题,并自主构建通往答案的路径。
这正是人工超级智能(Artificial Superintelligence, ASI)区别于当前先进AI的核心所在。ASI并非指代科幻中无所不能的“神级AI”,而是一个可操作、可测量的概念:AI系统能否在缺乏人类方法指导的前提下,独立完成从问题提出、方法选择、实验执行到结果验证的完整科研闭环? 要回答这个问题,首先需要一把精准的“尺子”——这正是ASI-Bench诞生的初衷。
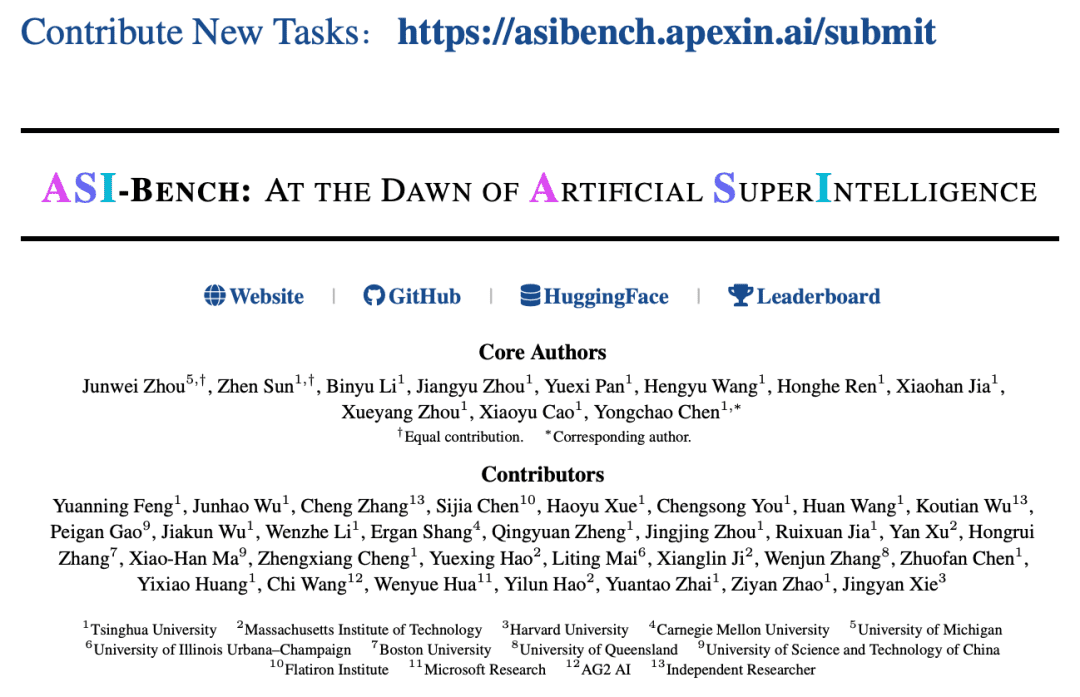
ASI-Bench由清华大学人工智能学院助理教授陈勇超牵头,联合麻省理工学院、哈佛大学、卡内基梅隆大学、中国科学技术大学、微软研究院等十余家全球顶尖机构共同开发。它不满足于测试AI在封闭问答或预设任务中的表现,而是将评测场景直接置于真实的科研项目之中,通过系统性地控制人类干预的程度,观察AI在多大程度上能够“自己走完科研之路”。
该基准的设计核心在于“信息梯度”机制。同一个科研任务被赋予四种不同层级的指导信息:
- B1层级:提供完整的科研方法与实现步骤,仅测试AI的执行力——即能否准确复现既定流程;
- B2层级:仅告知方法名称(如“使用蒙特卡洛模拟”),要求AI自行推导具体实施细节;
- B3层级:仅给出科研目标、原始数据与约束条件,AI需完全自主决定研究路径、选择方法、设计实验并解释结果;
- B4层级:在B3基础上引入正确但无关的干扰信息,检验AI的抗干扰与聚焦能力。
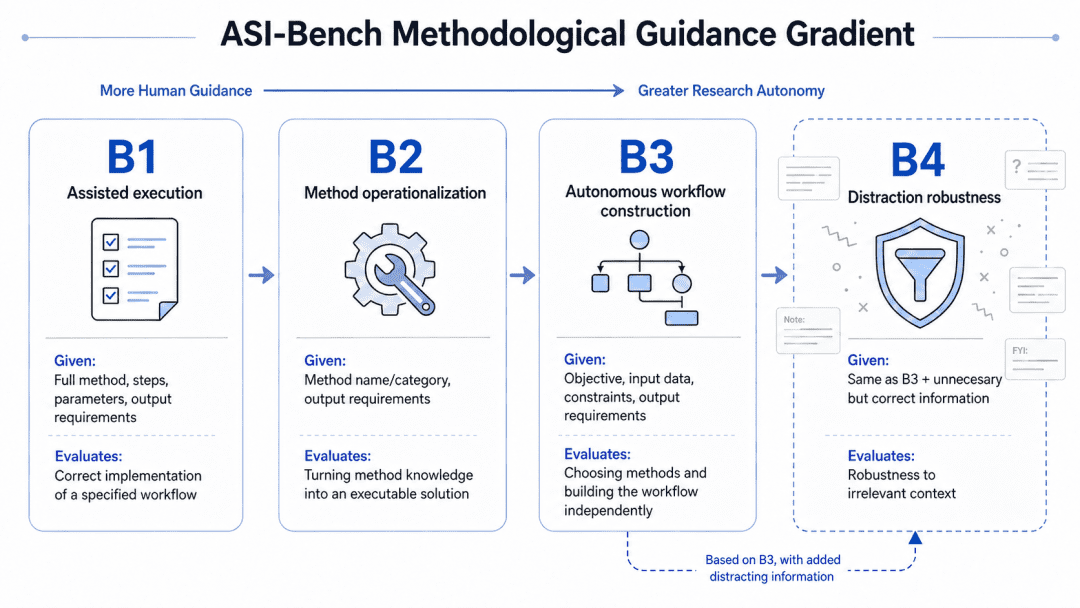
这种递进式设计巧妙地剥离了人类指导的“脚手架”,从而量化AI对人类方法论的依赖程度。如果一个系统在B1中表现优异但在B3中骤降,说明它本质上仍是一个高级执行器,而非真正的研究者。
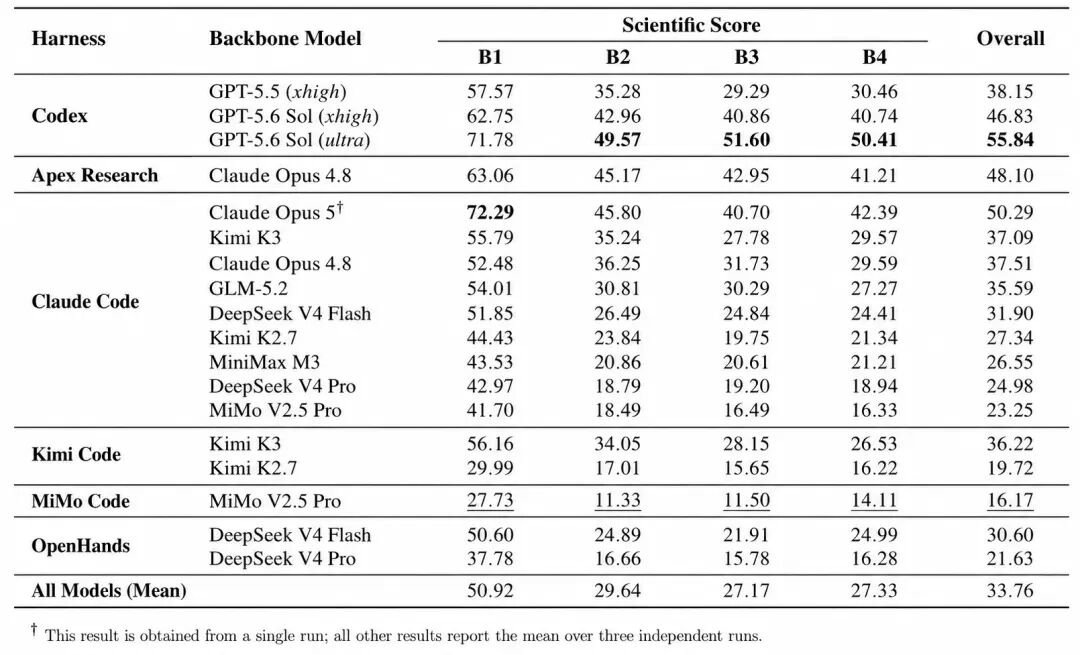
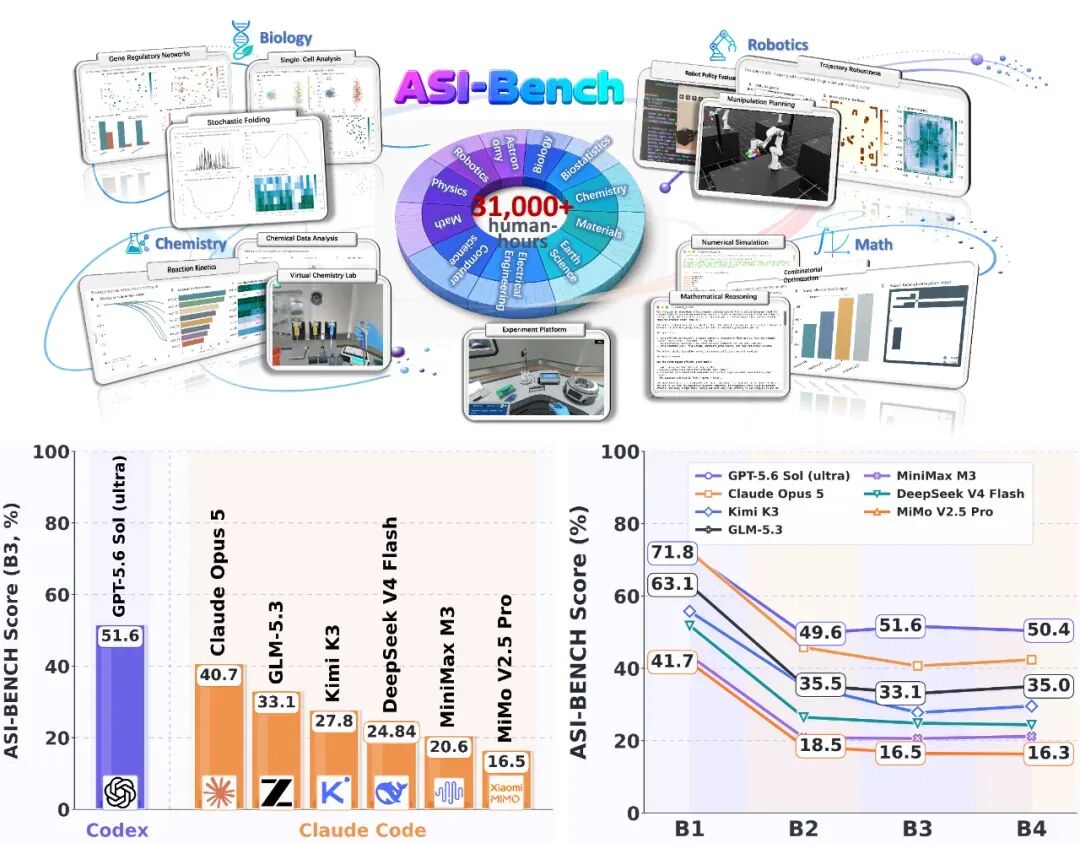
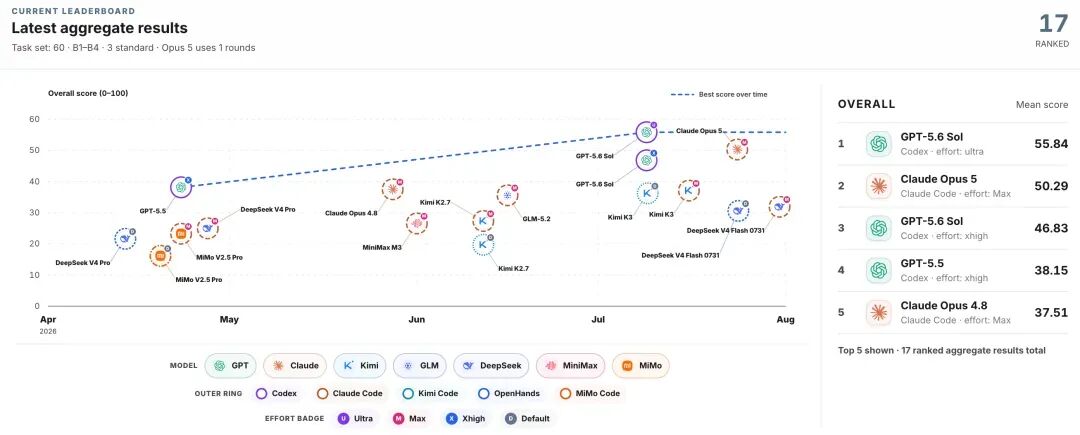
初步测试覆盖60个跨学科科研项目,横跨数学、物理、化学、生物、天文、材料、地球科学、医学统计、计算机、机器人与电子工程等11个领域。研究团队评估了18种不同的“智能体框架×基础模型”组合,包括Codex、Apex Research、Claude Code等主流Agent架构,搭配GPT-5.6 Sol、Claude Opus、Kimi、GLM等前沿大模型。
结果令人深思:在B1条件下,所有组合的平均科学得分为50.92分;而当进入完全无方法提示的B3阶段,平均分骤降至27.17分,跌幅接近一半。即便是表现最佳的Codex + GPT-5.6 Sol组合,其B3得分(51.60)也远低于B1(71.78)。更值得注意的是,性能断崖主要发生在B1到B2的过渡阶段——平均下降21.28分,远高于B2到B3的2.47分。这表明,AI最大的短板并非“知道方法名但不会做”,而是“连该用什么方法都不知道”。
失败归因分析进一步印证了这一点:62%的失败源于科学决策环节,包括问题建模错误、方法选择不当或对结果鲁棒性判断失误;仅有26%属于纯粹的数值计算或代码执行错误。换言之,当前AI在科研任务中的瓶颈,不在“手”,而在“脑”——它们缺乏在不确定性中构建科学逻辑的能力。
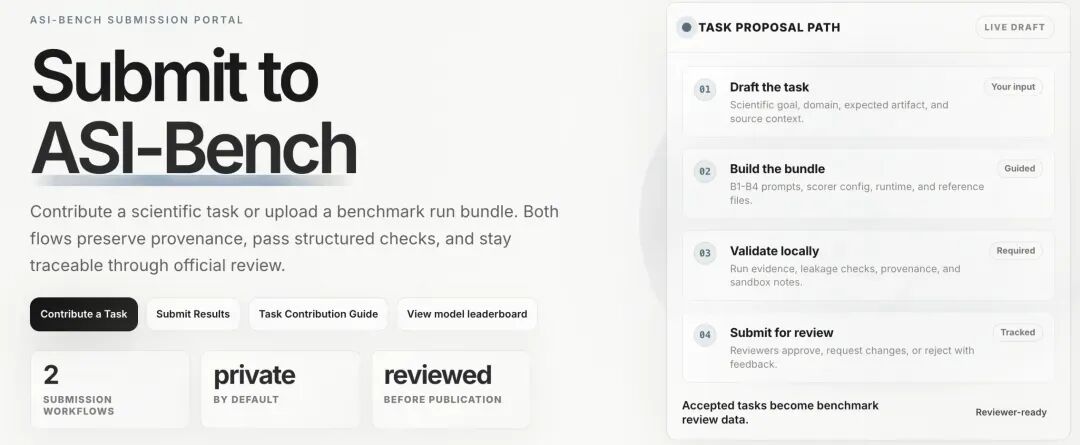
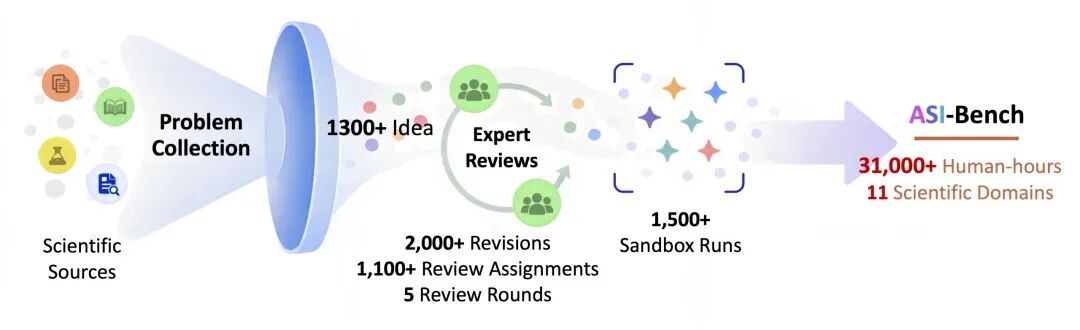
为确保评测的科学性与可信度,ASI-Bench采用了极为严苛的任务构建与验证流程。每个任务需经历四轮审查:首轮由两名非作者专家独立评审;次轮核查修改落实情况;第三轮进行智能体轨迹分析;第四轮则由同领域专家结合AI辅助工具(如Claude Code)进行深度扫描。审查内容涵盖科学逻辑一致性、评分规则合理性、信息泄漏风险及是否存在硬编码捷径。
此外,所有任务必须通过沙箱环境的端到端执行验证:包括环境配置检查、参考方案自评、受限工具运行、匹配实例测试及固定随机种子复现。任何在运行时出现故障或评分不一致的任务都将被退回重制。这种“做对科学问题才能拿高分”的原则,在Richards-Topmodel水文模型任务中体现得尤为明显。最初版本因评分规则未能捕捉核心水文机制,导致通用基线模型虚高得分;团队随即调整权重、单位与边界条件,使正确方法得分回归90分以上,而错误方法降至20分以下,确保分数真实反映科学理解深度。
ASI-Bench的价值不仅在于评测,更在于推动。对于模型研发团队而言,在B3条件下的分数提升比在B1中更有意义——它代表系统在自主决策层面的真实进步。对于AI Scientist或科研智能体开发者,四层梯度能精准定位系统短板:若B1→B2掉分严重,说明实现能力不足;若B2→B3大幅下滑,则暴露方法选择与创新规划的缺陷。而对于智能体框架设计者,ASI-Bench提供的项目级长程任务比短平快的终端指令更具区分度,能更真实地反映架构在复杂科研场景中的适应性。
尤为关键的是,ASI-Bench并非封闭体系。其首批60道题目已汇聚全球多所高校与研究机构的智慧,而未来的发展更依赖社区共建。研究者可通过提交课题构想、构建完整任务、设计评分规则、参与审查或提交运行结果等方式深度参与。因为衡量超级智能的标准,不应由单一团队垄断定义,而应由整个科学共同体共同塑造。
当未来的AI真正能够独立开展前沿科学研究时,回望今天,ASI-Bench或许正是那把在黎明前刻下第一道刻度的尺子。它告诉我们:天虽未亮,但光已在地平线上显现;AI虽未抵达自主科研的彼岸,但我们已能清晰丈量这段距离。而缩短它的每一步,都需要更严谨的评测、更开放的协作,以及对“智能”本质更深刻的理解。