开源模型自验证新范式:低成本实现超越闭源大模型的推理能力
近年来,大型语言模型(LLM)的能力边界不断拓展,但高昂的推理成本和对闭源模型的依赖始终是实际应用中的主要瓶颈。然而,随着开源模型性能的快速提升,一种新的范式正在浮现:让模型自己生成多个候选答案,并利用自身能力进行验证与筛选。这一被称为「自验证」(Self-Verification)的策略,不仅显著提升了任务成功率,还在成本上实现了数量级的优势。
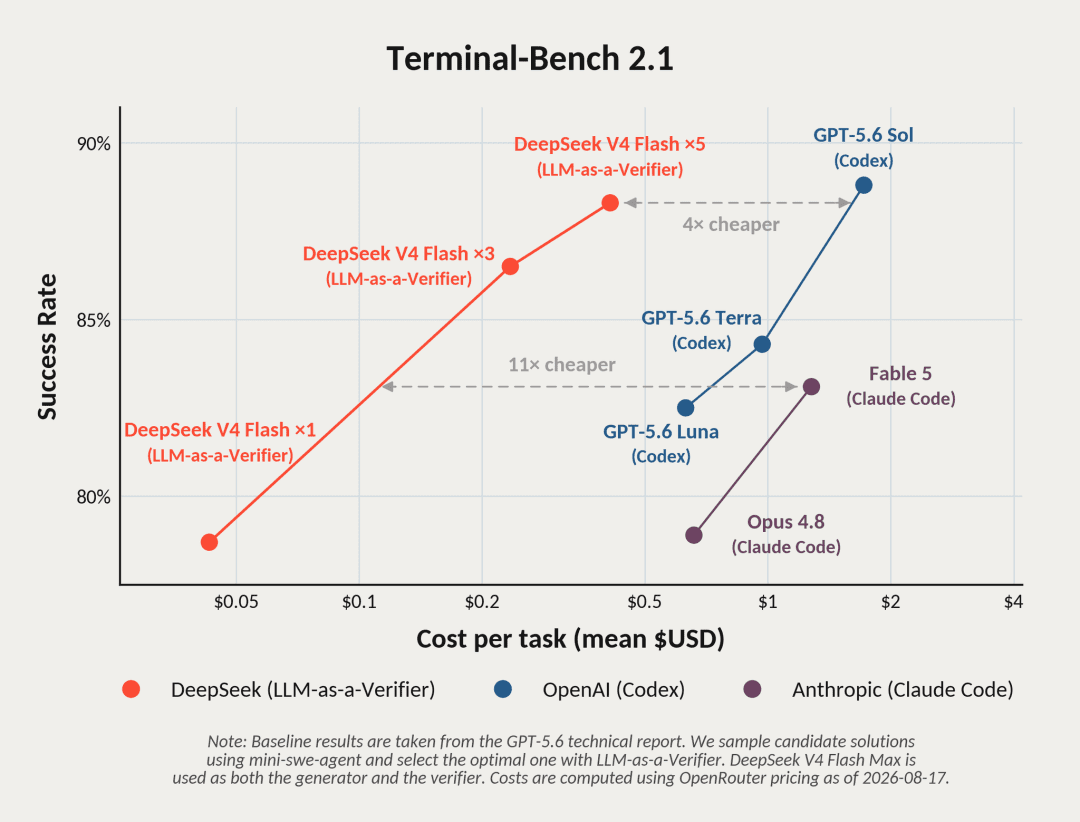
斯坦福大学研究团队近期发布的 LLM-as-a-Verifier 项目,正是这一趋势的典型代表。他们使用开源模型 DeepSeek V4 Flash,在不引入任何更强闭源模型的前提下,通过生成 5 条候选 Agent 轨迹并由同一模型进行验证打分,成功在 Terminal-Bench 2.1 基准测试中将任务成功率从 79% 提升至 88%,同时整体单任务成本仅为 Claude Fable 5 的约 1/11。值得注意的是,这一成本已按 DeepSeek 最新涨价后的价格计算,充分体现了开源模型在经济性上的巨大潜力。
自验证的核心机制:不止于“打分”
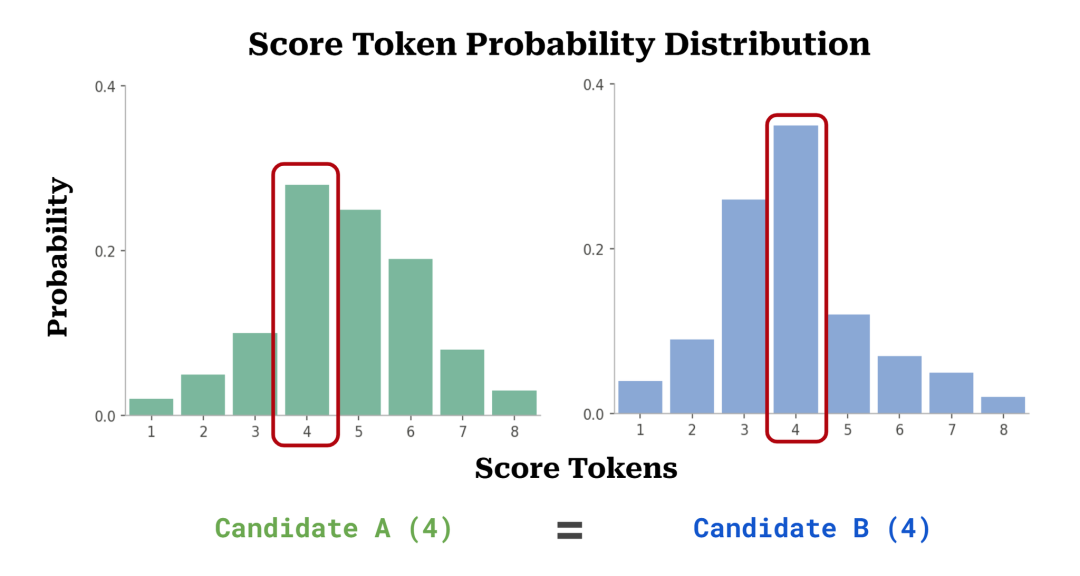
传统上,模型评估常采用 LLM-as-a-Judge 的方式,即让一个模型对多个输出进行离散评分(如 1-5 分)。然而,这种方法在面对高质量且相近的候选方案时,极易出现“平局”——即多个明显不同的结果被赋予相同分数。在 Terminal-Bench V2 上,此类平局率高达 27%,严重限制了筛选效果。
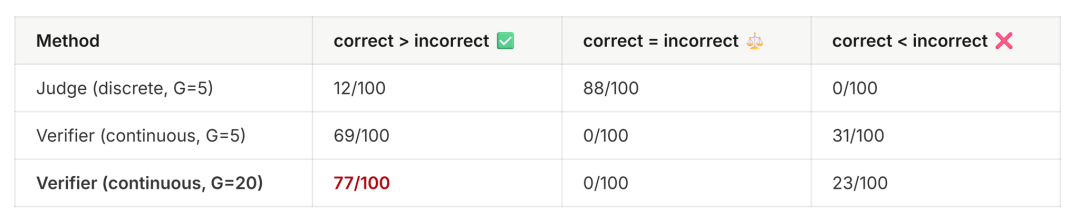
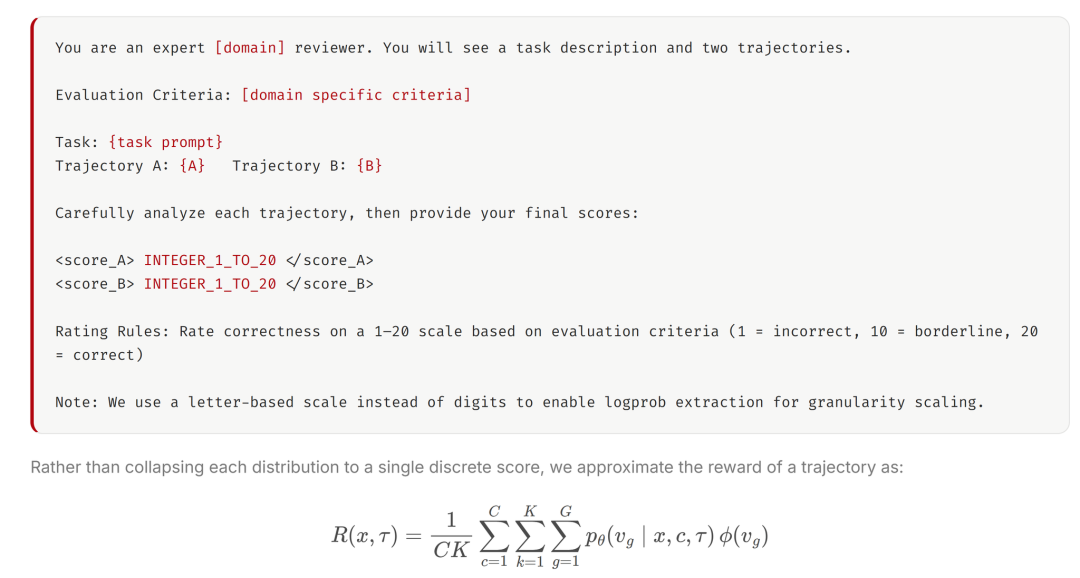
LLM-as-a-Verifier 的突破在于不再仅依赖最终输出的离散评分,而是深入利用评分 Token 的完整 logit 概率分布。通过对该分布求期望,系统可将原本粗糙的整数评分转化为连续、细粒度的概率性评价。例如,在 query-optimize 任务中,传统 Judge 几乎总是给出相同分数,而 LLM-as-a-Verifier 在 100 次比较中正确选出更优轨迹达 77 次,且零平局。
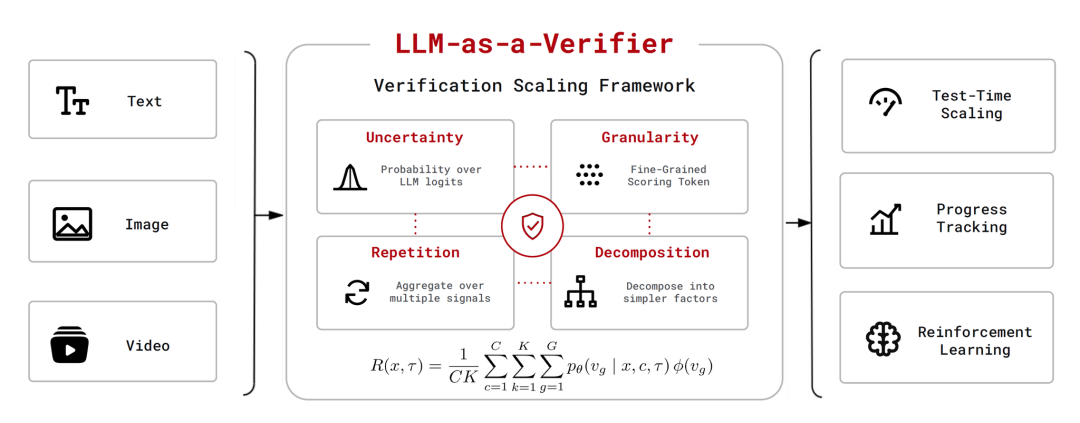
这种基于概率分布的验证方式,使得模型不仅能判断“哪个更好”,还能量化“好多少”,从而为后续决策提供更可靠依据。更重要的是,它无需额外训练,即可适配不同模态和任务,展现出极强的通用性。
多维扩展:验证也能“Scaling”
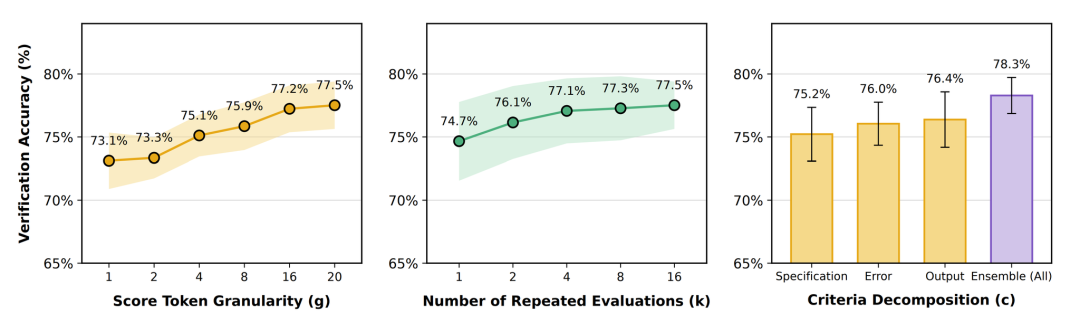
受 Kaplan 等人提出的 Scaling Laws 启发,研究团队进一步提出:验证过程本身也可以像模型训练一样进行规模化扩展。他们识别出三个关键维度:
- 评分粒度(Score Granularity):将评分范围从传统的 1-5 扩展至 1-20,提升区分能力;
- 重复评估(Repeated Evaluation):对同一对候选进行多次独立验证,通过聚合降低随机误差;
- 评价标准拆分(Criteria Decomposition):将整体评分分解为多个子维度(如正确性、效率、安全性),分别评估后再综合。
实验表明,这三个维度具有互补性,联合扩展可带来协同增益。这标志着“Verification Scaling”可能成为继预训练、后训练和测试时缩放(Test-Time Scaling)之后,第四条重要的能力提升路径。
高效候选选择:从 O(N²) 到 O(Nk)
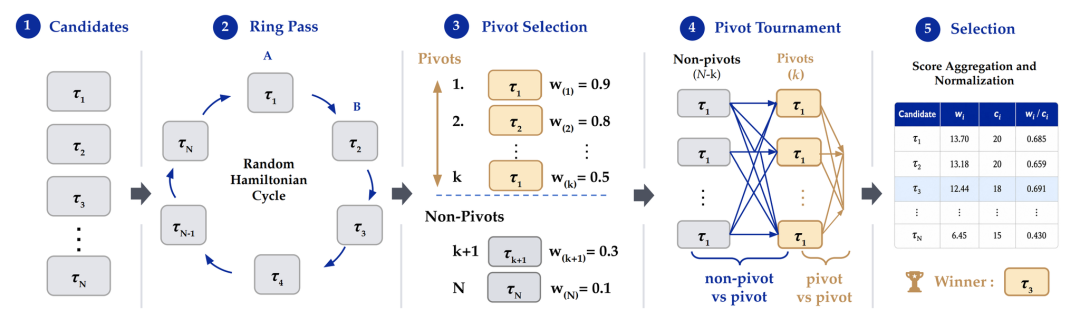
随着候选轨迹数量增加,验证成本成为现实挑战。若采用两两比较,复杂度为 O(N²),难以扩展。为此,团队设计了一种基于 pivot candidates 的近似排序算法:
- 随机选取少量 pivot(如 k=3)作为参考点;
- 每个候选仅需与这些 pivot 比较,获得 preference probability;
- 基于概率值对所有候选进行排序。
该方法将验证复杂度从 O(N²) 降至 O(Nk),在保持高准确率的同时大幅降低计算开销。这对于需要生成数十甚至上百条轨迹的任务(如 Pass@100 场景)尤为重要。
跨领域验证能力:从代码到机器人
LLM-as-a-Verifier 的通用性已在多个 benchmark 上得到验证:
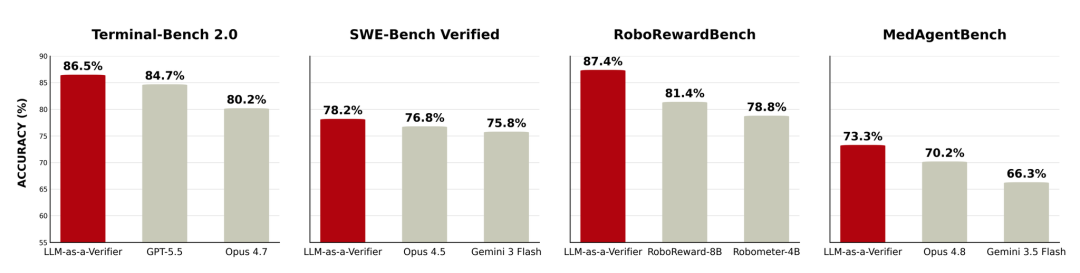
- Terminal-Bench V2:86.5% 成功率,聚焦终端命令与系统交互;
- SWE-Bench Verified:78.2%,评估软件工程修复能力;
- RoboRewardBench:87.4%,用于机器人任务评估;
- MedAgentBench:73.3%,面向医疗决策代理。
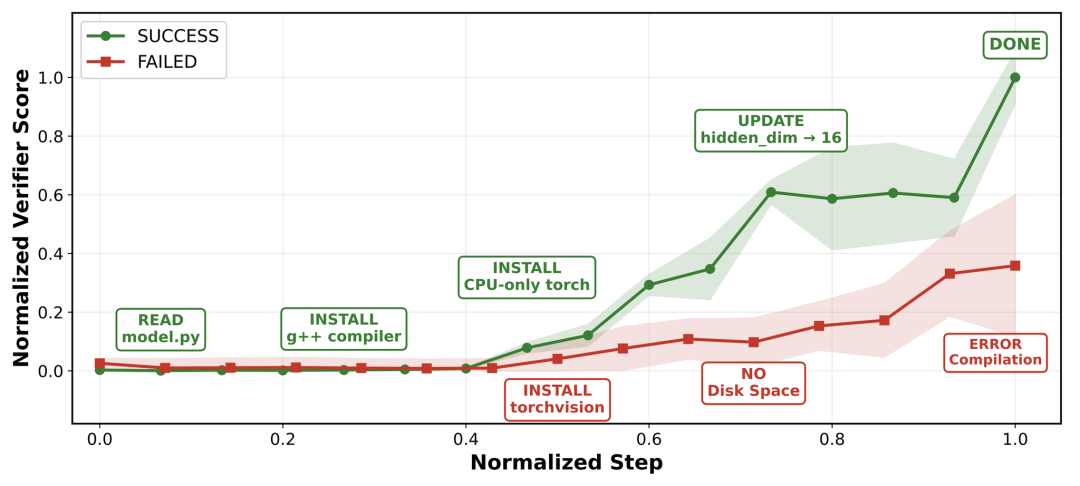
尤为引人注目的是其在任务进度追踪方面的表现。在代码生成过程中,Verifier 的评分与实际任务进展高度相关——随着代码逐步接近正确解,分数平滑上升。类似现象也出现在机器人 rollout 中:系统不仅能给出与时间对齐的奖励信号,还能区分多种失败模式,如任务理解错误、抓取偏差或动作偏离目标。这种实时反馈能力,为动态调整 Agent 行为提供了可能。
强化学习中的稠密奖励信号
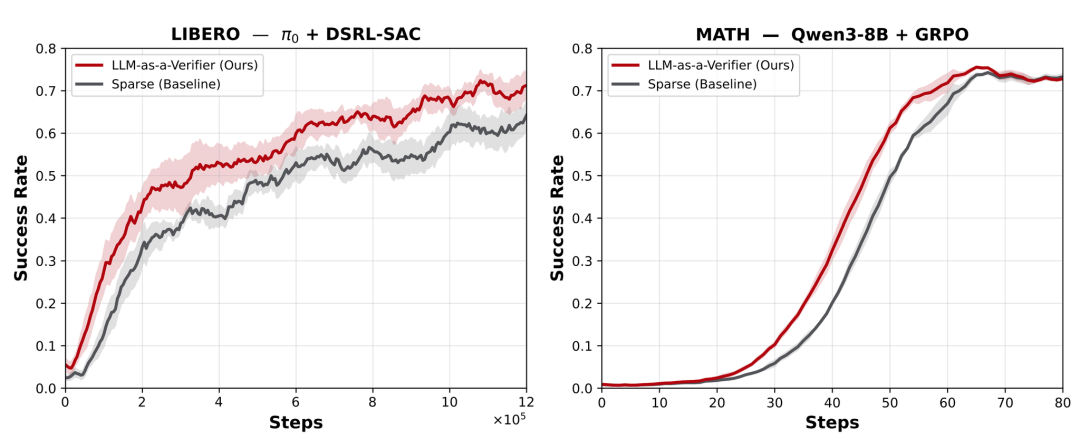
传统强化学习常面临稀疏奖励问题,而 LLM-as-a-Verifier 可直接作为稠密奖励函数。研究团队将其集成到 SAC(Soft Actor-Critic)和 GRPO(Generalized Reward Policy Optimization)算法中,在机器人控制和数学推理任务中显著提升了样本效率。这意味着,即使没有真实环境反馈,仅靠模型自身的验证能力,也能驱动有效学习。
本地部署与社区生态:开源 AI 的新机遇
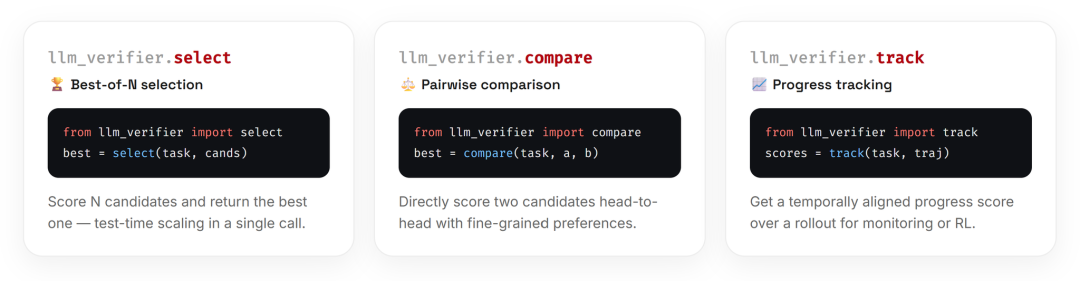
随着项目代码开源(GitHub Trending #2)及 API 发布(pip install llm-verifier),全球开发者已开始在 DGX Spark 等本地硬件上部署 GLM、DeepSeek 等模型,复现自验证流程。这一趋势揭示了一个重要方向:当本地推理足够廉价时,与其依赖单次高成本生成,不如通过“多次采样 + 自我验证”持续换取更高可靠性。
并行计算进一步缓解了延迟担忧。多个候选轨迹可并发生成,验证步骤亦可并行执行。在资源充足的情况下,端到端延迟仅相当于最长一次 rollout 加上少量验证轮次,几乎不随候选数量线性增长。
核心洞察:Agent “会做”,但不知“哪次做对”
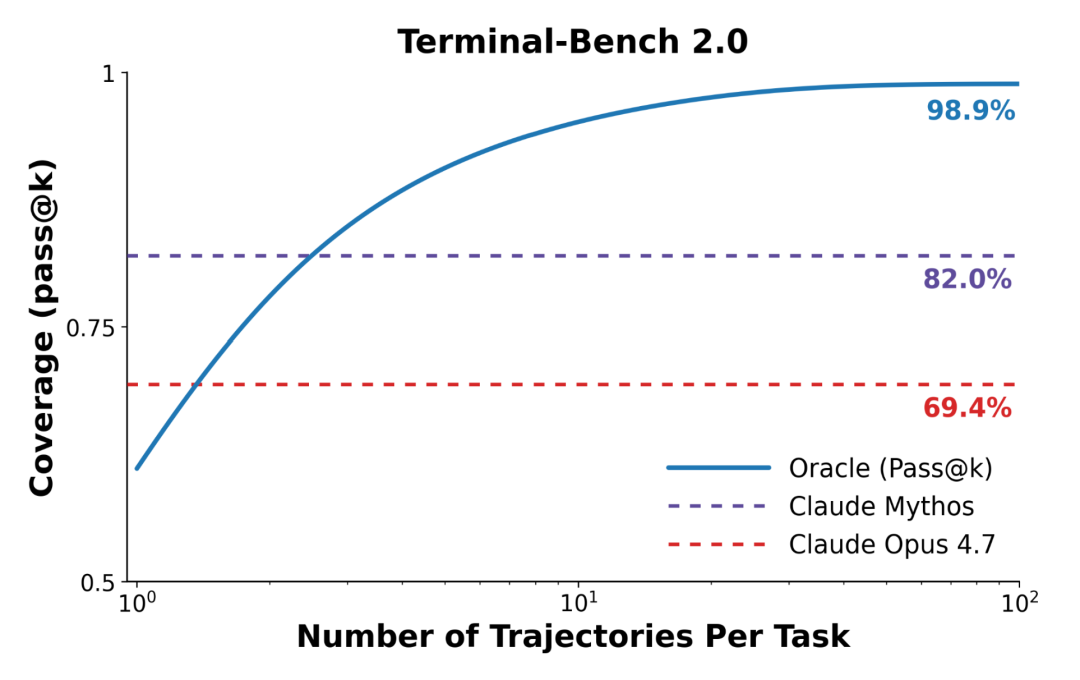
LLM-as-a-Verifier 背后的根本观察是:许多 Agent 实际上已经具备完成任务的能力,真正的瓶颈在于无法从自身生成的多个结果中识别出最优解。以 Terminal-Bench 为例,若每题生成 100 条轨迹,Pass@100 几乎可解决整个 benchmark。问题转化为:如何高效、可靠地选出那条正确的轨迹?
自验证框架正是对此问题的直接回应。它不追求单次生成的完美,而是通过低成本冗余计算换取确定性,这与人类解决问题时常采用的“试错-反思-选择”策略高度一致。
未来展望:Verification Scaling 或成新范式
随着开源模型推理成本持续下降、上下文长度不断扩展、工具调用能力日益成熟,“自验证”有望成为主流部署策略。它不仅适用于文本生成,还可延伸至多模态、具身智能、科学计算等领域。更重要的是,它降低了对闭源 API 的依赖,推动 AI 能力向本地化、去中心化演进。
可以预见,在不久的将来,一个典型的开源 Agent 工作流可能是:并行生成 N 条轨迹 → 利用自身 Verifier 进行细粒度评估 → 基于概率排序选择最优 → 必要时迭代优化。这种以计算换智能、以冗余换可靠的方式,或将重新定义我们对“模型能力”的理解——能力不仅体现在单次输出的质量,更体现在系统整体的纠错与选择机制之中。
综上所述,LLM-as-a-Verifier 不仅是一项技术突破,更代表了一种思维范式的转变:在开源时代,最强大的模型或许不是那个“一次就对”的模型,而是那个“知道自己哪里错了,并能选出最好答案”的模型。