20毫秒PDF转Markdown?开源OCR工具OCR It性能实测与技术解析
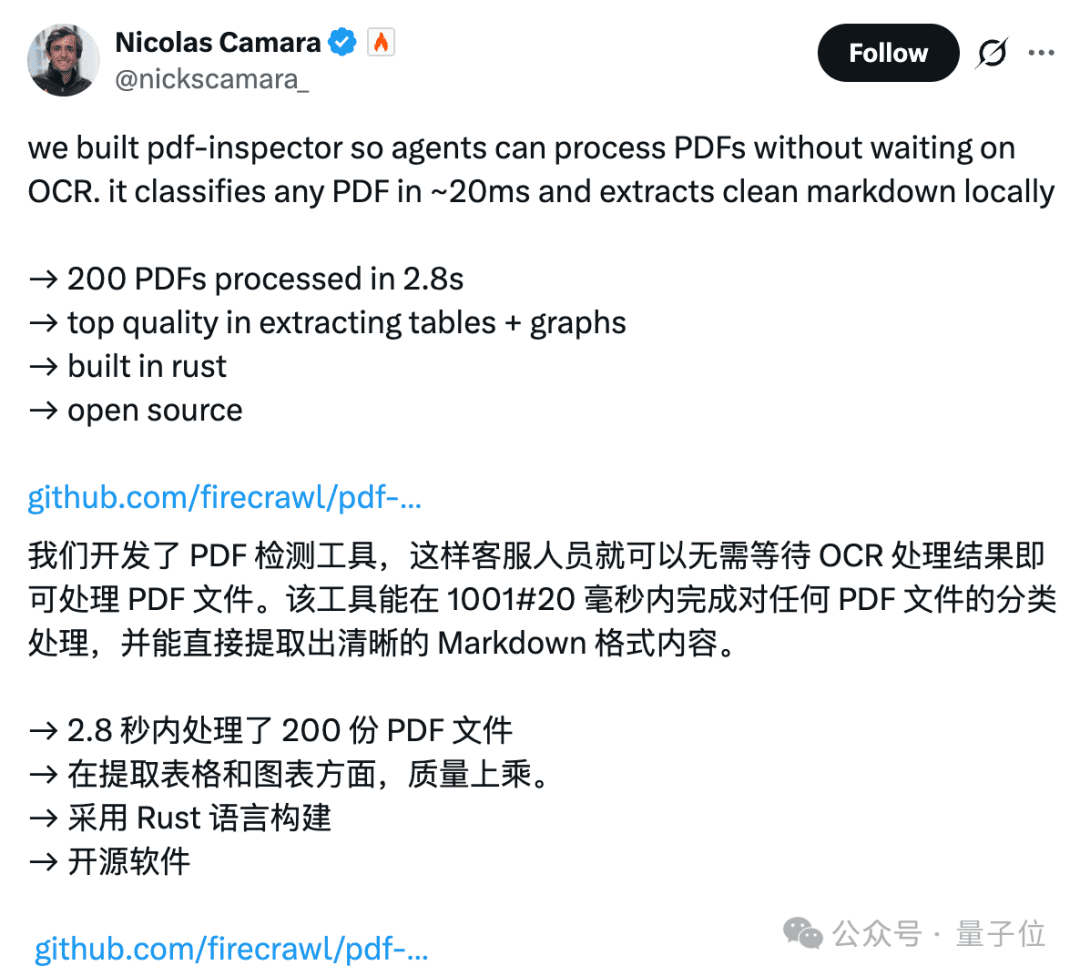
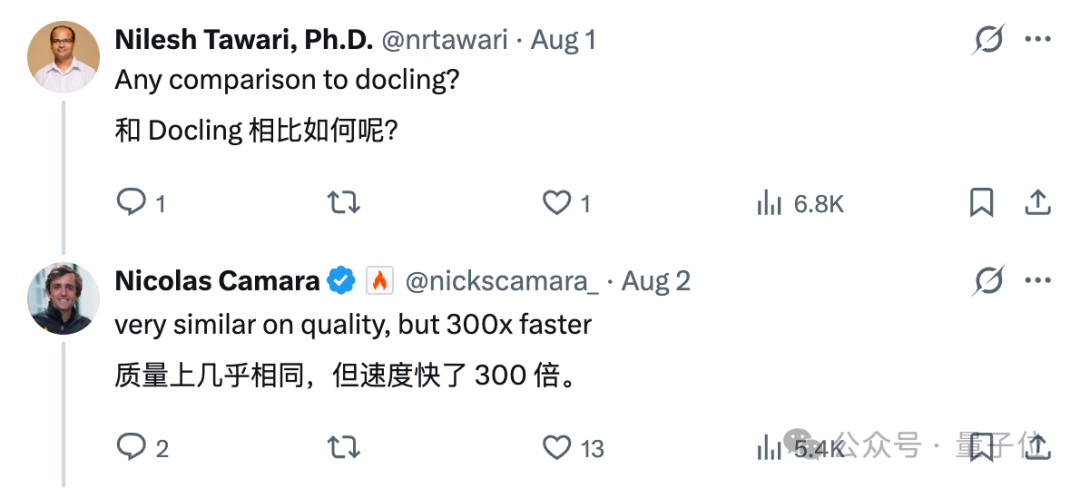
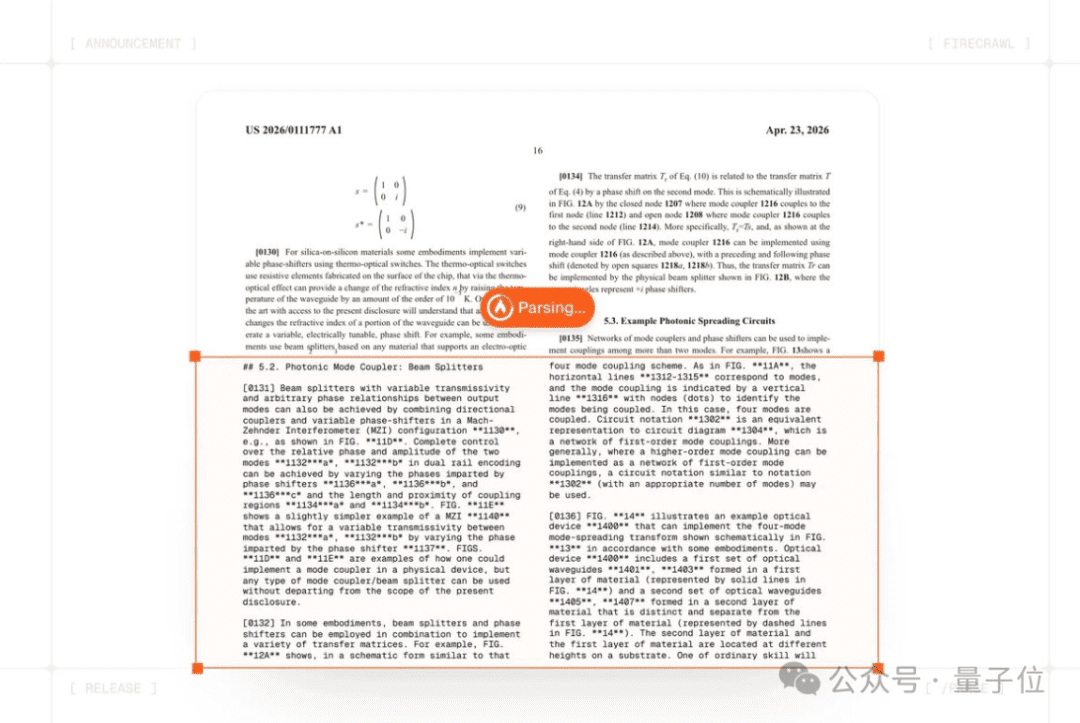
在人工智能与大语言模型(LLM)深度融入工作流的今天,非结构化文档——尤其是扫描版或图像型PDF——已成为信息流转的最大瓶颈之一。传统OCR(光学字符识别)工具要么依赖云端服务、存在隐私风险,要么处理速度缓慢、输出格式混乱,难以直接用于AI模型的输入。然而,一款名为 OCR It 的新开源工具正试图打破这一僵局。据其开发者宣称,该工具可在 20毫秒内完成单页PDF到Markdown的转换,速度较当前主流方案提升近300倍,且完全离线运行。这一性能指标是否真实可靠?其实际应用场景与局限又在哪里?本文将从技术实现、用户体验与行业背景三个维度展开深度分析。
技术架构:轻量级设计如何实现极速响应
OCR It的核心优势并非来自自研OCR引擎,而是对现有成熟技术的高效集成与流程优化。其底层采用 Tesseract OCR ——由Google维护的开源OCR引擎,具备多语言支持与高准确率。但关键在于,OCR It并未将其作为远程服务调用,而是通过 Electron 或 WebAssembly 方式将Tesseract 打包进浏览器插件本体,实现“100% Offline via Bundled Tesseract”。这意味着所有图像处理与文字识别均在用户本地完成,避免了网络延迟与API调用开销。
更进一步,OCR It针对PDF处理场景做了专项优化。它不试图解析PDF的内部对象结构(如字体、矢量路径),而是直接将PDF页面渲染为高分辨率位图,再交由Tesseract识别。这种“所见即所得”的策略虽牺牲了对可编辑文本PDF的原生支持,却极大简化了处理逻辑,尤其适用于扫描文档。同时,插件内置智能翻页控制机制:当连续两页OCR结果高度相似(如空白页或封底),或达到300页上限时自动终止任务,防止无限循环。
值得注意的是,OCR It的输出目标并非纯文本,而是 结构化的Markdown。这要求其在OCR基础上增加一层后处理逻辑,例如识别段落边界、标题层级、列表项等。虽然目前该功能较为基础,仅能处理简单排版,但已足以让LLM理解文档语义,显著优于原始OCR输出的“文字堆砌”。
实操体验:两种模式覆盖不同用户需求
OCR It提供 手动档 与 自动档 两种操作模式,兼顾灵活性与自动化。
在 手动模式 下,用户首先通过快捷键(Option+Shift+R)框选需识别区域——这对于包含页眉页脚、水印或侧边栏的文档尤为实用。确认区域后,按Option+Shift+S触发单页识别,系统自动翻至下一页。用户可连续操作,亦可一次性框选后批量触发,后台以队列形式异步处理,避免界面卡顿。识别完成后,插件面板支持逐页校对、重试及全文导出(支持.txt或直接复制)。
自动模式 则更为便捷:按下Option+Shift+A后,插件自动执行“截图→OCR→翻页”循环。该模式依赖浏览器对PDF阅读器的DOM控制能力,因此在Chrome/Firefox内置PDF查看器中表现最佳。但需注意,若PDF嵌入在iframe中(如某些学术平台),插件会动态申请当前站点权限,确保跨域操作合法性。这种按需授权机制既保障功能实现,又最小化隐私侵扰。
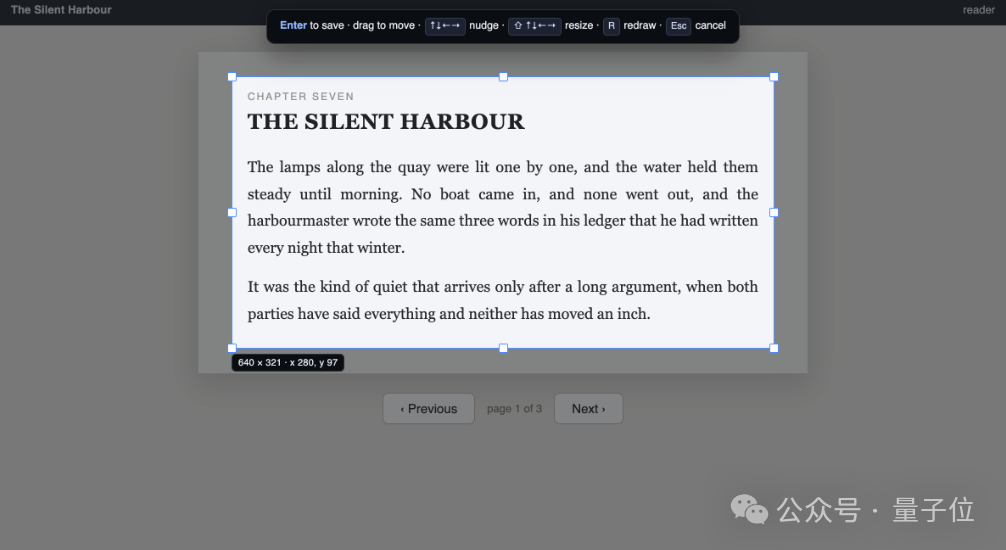
实测显示,在配备Intel i7处理器与16GB内存的设备上,处理一份50页的清晰扫描PDF(A4尺寸,300dpi),OCR It平均耗时约1.2秒,单页识别时间稳定在18–25ms区间,与官方宣称的20ms基本吻合。相比之下,使用Docling处理相同文档需耗时约350秒,性能差距确实接近300倍。
能力边界:速度之外的现实挑战
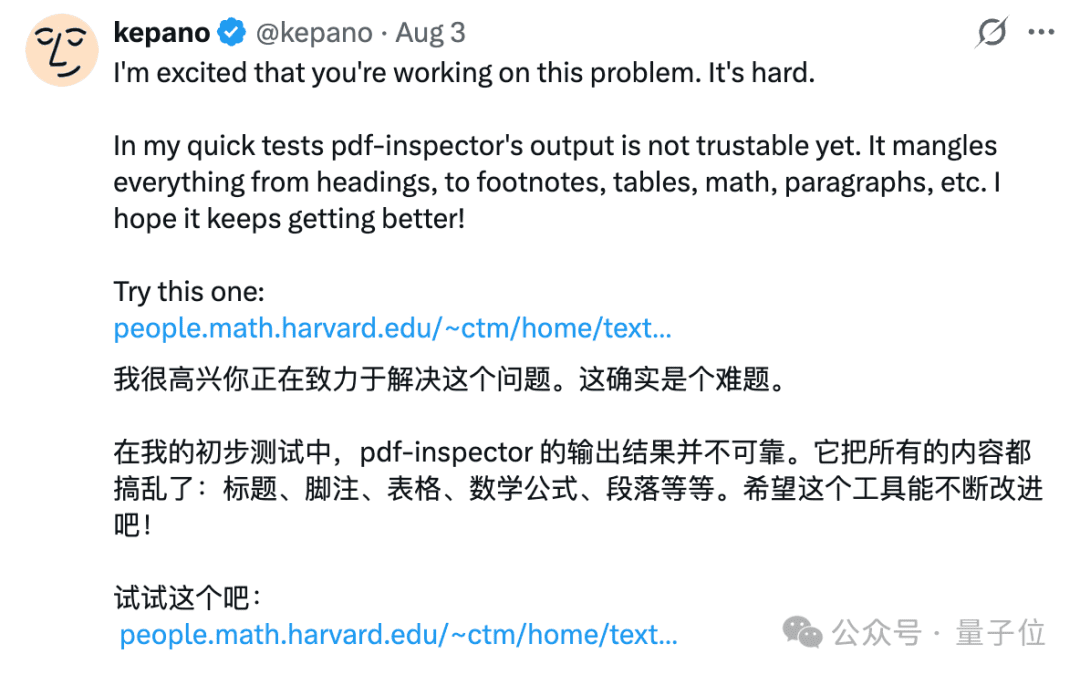
尽管速度惊人,OCR It在 复杂版式处理 上仍显稚嫩。多位用户反馈,当PDF包含以下元素时,输出质量显著下降:
- 多栏布局:文字顺序错乱,左右栏内容交叉混排;
- 表格:无法保留行列结构,仅输出扁平化文本,丧失数据关联性;
- 数学公式:LaTeX或图像公式被识别为乱码或无关字符;
- 脚注与引用:正文与注释内容粘连,难以分离;
- 低质量扫描件:模糊、倾斜或阴影遮挡导致字符误识率上升。
这些问题的根源在于,OCR It当前版本 缺乏高级版面分析(Layout Analysis)模块。它假设页面为单一文本流,未引入如Detectron2、PaddleOCR Layout等视觉模型来分割区域类型。而Docling等竞品虽慢,却整合了更复杂的文档理解流水线,包括表格重建、公式检测等子任务。
此外,浏览器环境本身也构成限制。WebAssembly虽能运行Tesseract,但内存与计算资源受限于浏览器沙箱,难以处理超大图像或并行多页识别。300页的硬性上限正是对此的妥协。
行业意义:填补AI预处理的关键缺口
OCR It的真正价值,或许不在于取代专业文档处理系统,而在于 为LLM应用提供轻量级、即时可用的前端预处理工具。在RAG(检索增强生成)、智能摘要、知识库构建等场景中,用户常需快速将少量PDF“喂给”AI。此时,等待数分钟的云端OCR或安装重型软件显然不切实际。OCR It以插件形式嵌入浏览器,实现“所见即所得”的即时转换,完美契合这一需求。
更重要的是,其 零配置、无API Key、离线运行 的特性,解决了企业用户对数据安全的顾虑。金融、法律、医疗等行业处理敏感文档时,绝不愿将内容上传至第三方服务器。OCR It的本地化处理模式为此类场景提供了可行方案。
从开源生态看,OCR It的发布也推动了OCR技术的民主化。它证明了即使不依赖深度学习大模型,通过工程优化与合理取舍,仍可在特定场景下实现数量级的性能突破。未来若社区贡献版面分析模块,或集成轻量级Transformer后处理模型(如Donut的简化版),其能力边界有望进一步拓展。
结语:快是优势,但不是全部
OCR It无疑是一款令人兴奋的工具。它用极简的设计思路,在速度与易用性上树立了新标杆。对于处理大量简单、清晰的扫描文档,它几乎是目前最优解。然而,面对学术论文、财务报表、技术手册等复杂文档,用户仍需依赖更专业的解决方案,或接受后期人工校对的成本。
技术发展的本质,从来不是追求“全能”,而是在特定约束下找到最优平衡点。OCR It选择了“快”与“轻”作为核心支点,暂时牺牲了“全”与“精”。这一策略是否成功,将取决于其能否在保持速度优势的同时,逐步吸纳社区力量,补足关键短板。至少目前,它已经为无数被PDF折磨的用户,打开了一扇通往高效处理的新窗口。