学生数字孪生如何赋能AI教师训练?StudentSim框架解析
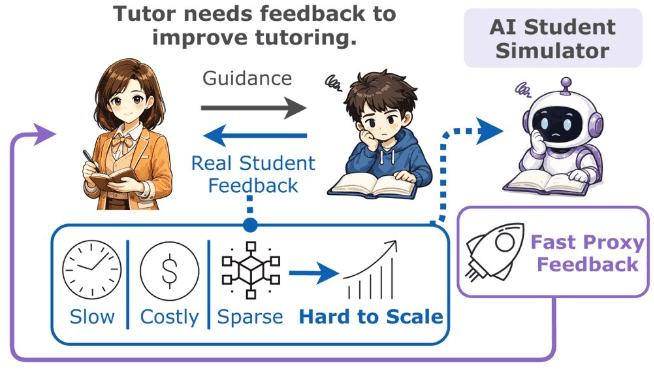
近年来,人工智能在教育领域的渗透日益加深,从自动批改作业到个性化推荐,再到实时答疑辅导,AI教师正逐步承担起传统教学中的多项职能。然而,一个核心问题始终悬而未决:AI教师如何知道自己讲得有没有用? 在真实课堂中,教师通过观察学生的表情、提问、练习表现等即时反馈调整教学策略;但对于AI系统而言,获取这类高质量、个性化的教学效果信号极为昂贵——往往需要组织大规模人类实验,耗时数周甚至数月,严重制约了AI教师的迭代速度。
为解决这一瓶颈,研究者开始探索“模拟用户”(User Simulator)在教育场景中的应用。不同于客服或电商领域中相对简单的用户行为模拟,教育场景下的“用户”即学生,其认知状态具有高度复杂性与动态性。一个有效的学生模拟器不仅需复现学生当前的知识水平、常见错误和解题习惯,还必须能对教学干预作出合理响应——这正是维果茨基(Vygotsky)提出的“最近发展区”(Zone of Proximal Development, ZPD)理论的核心:教学的价值在于帮助学生跨越其独立能力与潜在能力之间的鸿沟。
在此背景下,微软与伊利诺伊大学厄巴纳-香槟分校(UIUC)合作推出的 StudentSim 框架,为构建高保真学生数字孪生提供了系统性解决方案。该研究直指当前主流方法的两大缺陷:一是传统知识追踪模型虽能精准预测学生历史行为,却缺乏对自然语言教学指导的响应能力;二是直接使用大语言模型(LLM)进行角色扮演虽能流畅交互,但其输出常受模型自身强大知识库干扰,无法真实反映目标学生的认知边界。
行为保真与指导响应:学生模拟器的双重能力
StudentSim 的核心创新在于明确定义并量化评估学生模拟器的两项关键能力:行为保真度(behavioral fidelity)。前者衡量模拟器在无干预状态下是否能准确复现特定学生的行为模式,包括错误类型、解题路径偏好及语言表达特征;后者则检验模拟器在接受教师指导后,能否产生符合该学生学习潜力的认知更新——例如修正错误、尝试新策略或暴露新的误解。
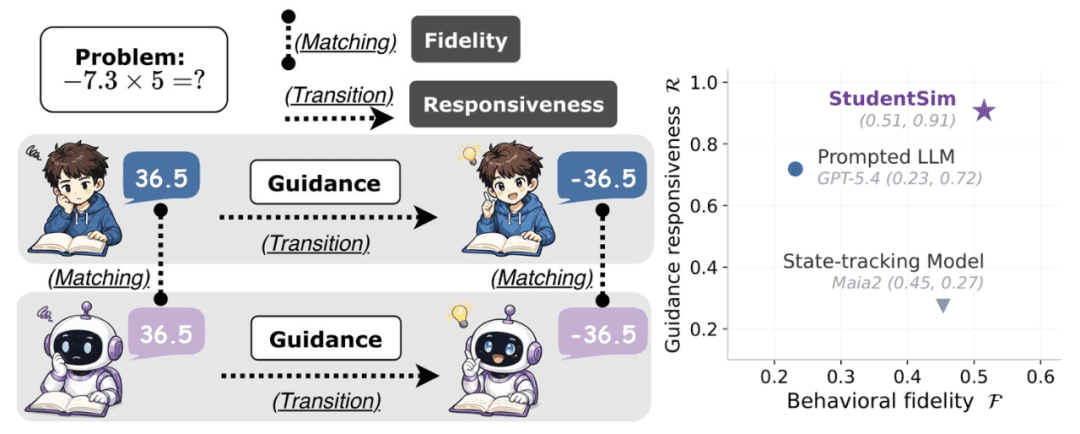
这两项指标共同构成了AI教师训练所需的完整反馈信号链:一个个性化的起点(fidelity)。没有前者,AI教师无法针对学生现状定制策略;缺乏后者,则无法验证教学干预是否真正推动了学习进程。
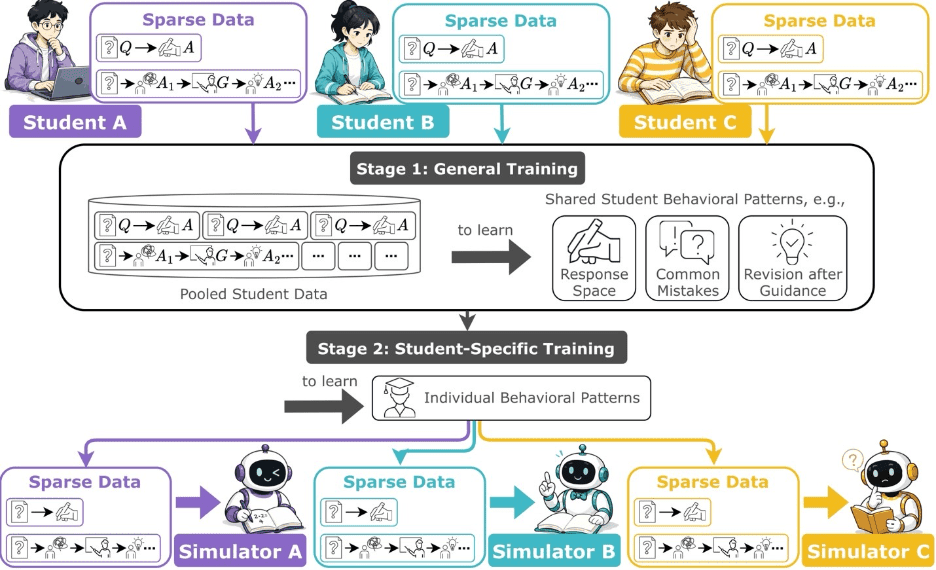
为实现这一目标,StudentSim 采用两阶段训练范式。第一阶段,利用同一学科领域内多个学生的聚合数据训练一个领域级基础模拟器(domain-level base simulator),使其掌握该领域的共性错误模式、典型回答结构以及常见的指导-修正映射关系。第二阶段,基于单个学生的少量历史交互记录(通常仅数十条),对该基础模型进行个性化微调(specialization),从而捕捉个体独特性。这种“群体先验 + 个体微调”的设计巧妙应对了教育数据的典型困境:单个学生数据极度稀疏,但群体间存在大量结构性共性。
跨领域验证:从国际象棋到数学解题
为避免结论局限于单一任务,研究团队构建了 StudentSimEval 评估基准,覆盖三个截然不同的学习领域:
- 国际象棋:模拟器需预测特定玩家在给定棋局下的下一步走法,并在接收自然语言教练提示(如“注意你的王翼安全”)后生成修正走法;
- 第二语言英语写作:模拟器需生成符合某位学习者错误分布(如主谓不一致、冠词误用)的英文段落,并根据教师修改建议重写;
- 基础数学:模拟器需预测学生对某道题的原始解答(可能包含概念性错误),并在阅读分步提示后输出修正答案。
实验共纳入60名真实学生(每领域20人),所有方法均在相同的个体训练记录上拟合,并在留出的测试记录上评估。结果表明,StudentSim 在三项任务中均显著优于现有基线。
以国际象棋为例,StudentSim 的 behavioral fidelity 达到 0.5150,远超专为棋手建模设计的 Maia2(0.4535)和直接提示的 GPT-5.4(0.2316);其 guidance responsiveness 更高达 0.9067,而 Maia2 因缺乏自然语言接口仅得 0.2721,GPT-5.4 虽能响应指导但因认知失真导致响应质量不稳定(0.7186)。这一对比清晰揭示了两类基线的根本局限:Maia2 精于行为预测却无法理解教学语言,GPT-5.4 善于语言交互却难以抑制自身知识干扰。
从模拟器到强化学习:闭环训练AI教师
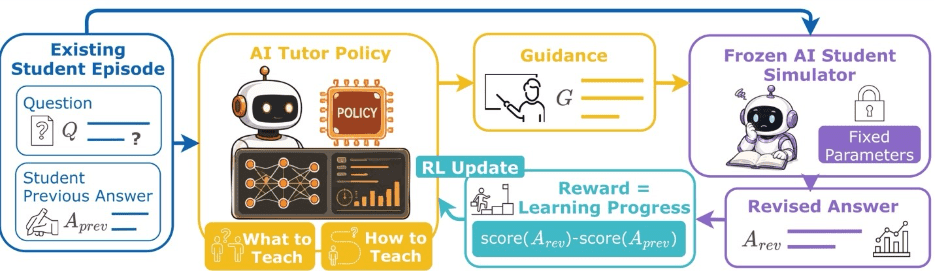
StudentSim 的价值不仅在于评估,更在于赋能AI教师的主动优化。研究团队进一步设计了一个强化学习(RL)实证实验:在国际象棋教学场景中,AI教师根据学生原始错误走法生成指导语;冻结的 StudentSim 模拟器读取该指导后输出修正走法;奖励函数则基于修正走法相对于原走法在 Stockfish 引擎评分上的提升幅度计算。
对照组包括:(1) 仅通过监督微调(SFT)训练的教师模型(无RL);(2) 使用 GPT-5.4 作为学生模拟器提供奖励信号的RL教师。三组共享相同的初始策略、SFT起点和GRPO算法设置,唯一变量是奖励来源。
最终由8名国际象棋专家进行盲评,结果显示:StudentSim 奖励训练出的AI教师在准确性(90.5%)。相比之下,无RL组准确率仅75.7%,而GPT-5.4奖励组甚至更低(71.6%),表明其提供的反馈信号存在噪声或偏差。这一结果有力证明:一个兼具行为保真与指导响应能力的学生模拟器,能够为AI教师提供更可靠、更有效的优化信号。
对AI教育生态的深远影响
StudentSim 的提出标志着AI教育系统向“数据驱动闭环”迈出关键一步。过去,真实学生数据主要用于事后评估;如今,这些数据可被转化为可复用、可扩展的学生数字孪生资产,持续为AI教师的策略迭代提供高通量反馈。尤其值得注意的是,StudentSim 支持本地部署与定制,无需依赖云端大模型API,既保障数据隐私,又降低使用门槛。
当然,挑战依然存在。例如,如何将StudentSim扩展至更复杂的开放式任务(如科学探究或创意写作)?如何处理学生情绪、动机等非认知因素对学习的影响?但无论如何,该研究已为构建下一代智能教育系统奠定了重要基石——真正的个性化教学,不仅需要AI会讲题,更需要它能“看见”学生如何思考、如何改变。
未来,随着更多高质量教育交互数据的积累与StudentSim类框架的成熟,我们有望看到一个良性循环:真实学生参与生成数据 → 训练高保真学生模拟器 → 模拟器加速AI教师优化 → 更优的AI教师服务更多真实学生。在这个闭环中,教育公平与效率或将迎来前所未有的协同提升。