GPT-6带火的循环Transformer,阿里两篇论文早有布局
GPT-6 Astra引爆“循环深度”争议
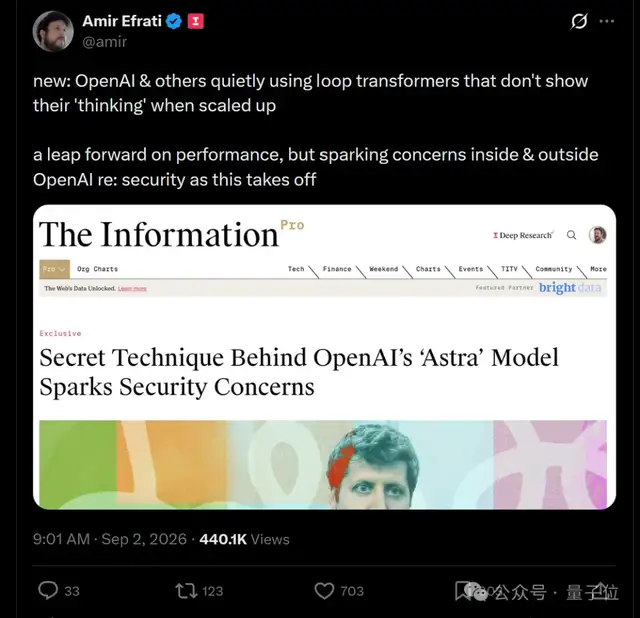
GPT-6 Astra一发布,AI圈突然开始热议一个词:recurrent depth(循环深度)。据The Information爆料,Astra采用了这种技术——让同一组Transformer层反复运行多次,从而在不增加参数量的前提下,实现更深的计算路径。
听起来很划算:8层参数跑3遍,理论上能完成24层的计算深度,却只需存储8层的权重。模型不用继续“长胖”,也能变强。
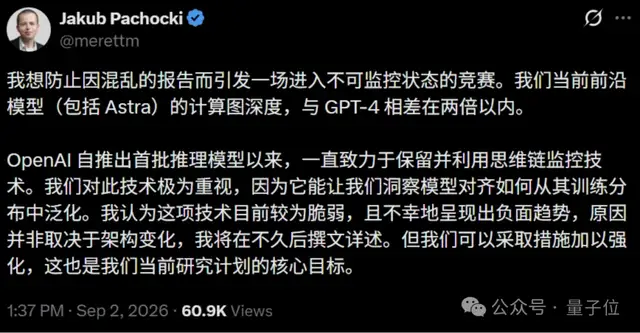
但争议紧随其后。由于循环发生在hidden state内部,中间过程未必生成人类可读的思维链,安全专家担心模型行为更难监测。OpenAI首席科学家Jakub Pachocki甚至亲自下场回应,称将发布详细说明。
其实,循环架构并非新概念。早在2018年,Universal Transformer就尝试过重复使用共享层。近年Claude Mythos在图搜索任务中表现惊人——在GraphWalks BFS测试中得分接近GPT-5.4的四倍,外界猜测它可能也用了循环结构。虽然官方未证实,但大家期待的是同一件事:让现有参数多“想”几轮,而不是一味堆参数。
然而,多算几轮 ≠ 多算出东西。问题出在“计算冗余”上。
循环为何容易“空转”?
研究发现,循环Transformer常出现一种尴尬现象:第一轮计算带来显著状态更新,后续几轮的hidden state变化却迅速衰减。纵轴显示相对变化幅度,横轴是计算流程,中间三个蓝色柱子代表三次核心循环——第一个高高耸立,后两个几乎贴地。
注意,柱子变矮不代表算力节省。Attention和矩阵乘法照样全跑一遍,只是产出增量微乎其微。这就像工人第一天拼命干活,后面两天只是机械打卡。
阿里与合作高校团队深入分析后,找到了三个“摸鱼证据”:
- 后续循环更新幅度急剧下降:首轮承担主要计算,后面几轮贡献甚微。
- 相邻轮次表示高度相似:用CKA(中心核对齐)分析发现,不同循环输出的hidden state几乎雷同。
- 表示逐渐坍缩到低维空间:奇异值谱显示,信息表达越来越单一,多样性丧失。
归根结底,问题出在两点:计算无分化和信息过载。
同一组网络反复使用,却没有明确的轮次标识,难以形成阶段分工;同时,hidden state既要保留原始输入,又要累积历史结果,还要处理当前计算,所有任务挤在一起,最终谁都干不好。
MeSH:给循环加个“动态资料柜”
针对上述问题,团队在2025年10月提出MeSH(Memory-enhanced Shared Transformer),现已被ICLR 2026接收。
MeSH的核心思路是:别把所有信息都塞进hidden state,而是引入一个可动态读写的Memory Buffer(记忆缓冲区)。这个缓冲区由多个记忆槽组成,专门存放原始输入和各轮计算的中间结果。
配套的还有两个“管理员”:
- Write Router:决定本轮新结果如何按权重分配到各个记忆槽。
- Read Router:在下一轮开始前,按不同权重从各槽读取信息,重组为新的hidden state。
关键在于,这些路由器是动态且个性化的:每轮循环有自己的路由器,每个token也有独立的读写权重。模型可以自主学习“本轮该记什么、下轮该看什么”。
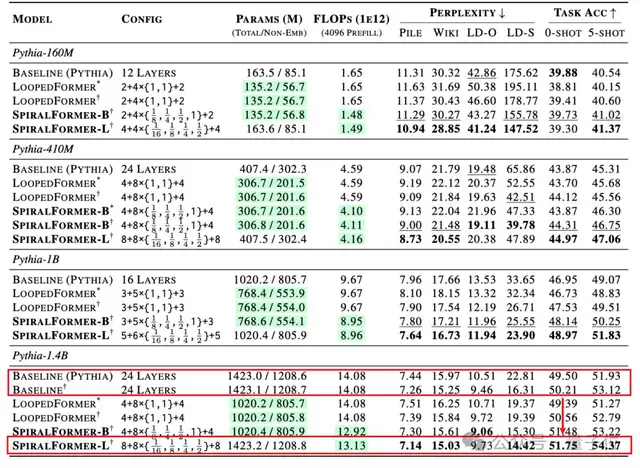
实验效果显著。在Pythia-1.4B规模下,基础循环模型因参数共享减少了约33%的非嵌入参数,但零样本准确率略低于普通Transformer(49.50% vs 49.56%)。加入MeSH后,准确率反超至50.56%,而新增路由器参数仅占原模型的0.005%,额外计算开销约0.014%。
再用之前的三项指标检验,三个“摸鱼症状”均有明显改善:状态更新更均衡、轮次间表示差异拉大、表示多样性恢复。
有意思的是,MeSH的设计与近期热门的Hyper-Connections、mHC有相似之处——都是通过可学习的多路信息调配提升表达能力。但MeSH聚焦于循环之间的信息交接,而非层间传播。
不过,MeSH解决了“拿什么算”,却没改变“怎么算”的粒度:每轮仍需处理完整token序列。这就引出了第二个问题。
SpiralFormer:让每轮看不同尺度的世界
如果不同循环处理的信息不同,为什么还要让它们盯着同样长度的序列?
带着这个问题,团队提出了SpiralFormer,刚被EMNLP 2026接收。其核心创新是:让每轮循环的序列长度(seq_len)可变。
灵感来自Coconut等“隐式思考”工作——模型中间的推理未必需要显式的完整token序列,可以先压缩成紧凑表示,在潜空间继续计算。
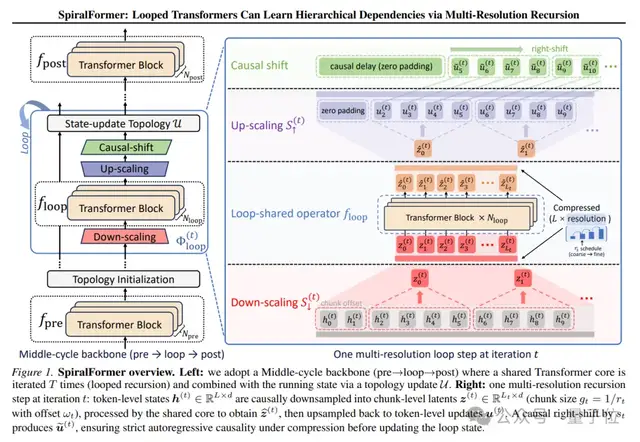
SpiralFormer的具体做法是:从粗到细逐步放大序列分辨率。例如,首轮用原序列的1/8长度,第二轮1/4,第三轮1/2,最后一轮回到完整长度。
操作上,每轮开始前,将相邻token聚合成更粗的表示(通过可学习权重),形成短序列;计算完Attention后,再将结果分配回原始token位置。为避免泄露未来信息(自回归生成要求),写回时做了右移处理。
效果如何?在Pythia-1.4B实验中,SpiralFormer-L与普通Transformer参数量相当,计算量从14.08T FLOPs降至13.13T,5-shot平均准确率却从51.93%提升至54.37%——算得更少,成绩更高。
团队还做了两项probing实验验证设计是否有效:
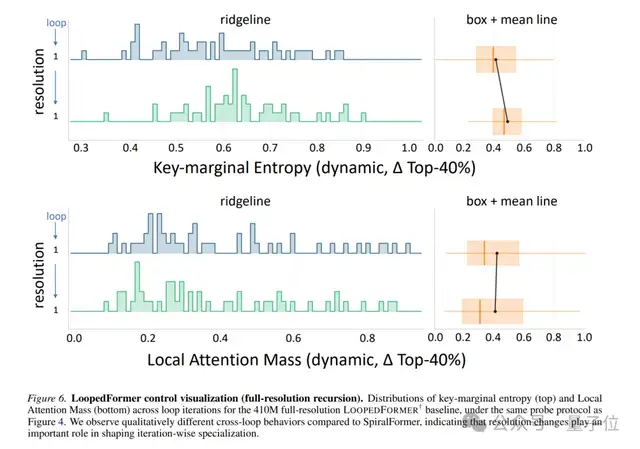
- 注意力分散度:早期低分辨率循环中,Attention分布更广;后期高分辨率时,逐渐聚焦于少数关键位置。
- 局部关注度:随着分辨率提高,落在邻近token上的注意力比例显著上升。
这说明,模型确实学会了“先看全局关系,再抠局部细节”。相比之下,始终处理完整序列的LoopedFormer虽有类似趋势,但更弱且不稳定——证明多分辨率设计才是驱动分工的关键。
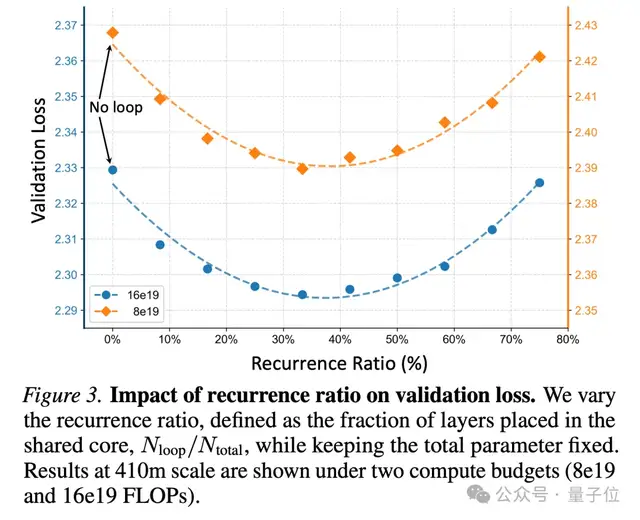
进一步实验发现,在固定总计算预算下,循环层占比存在最优区间(约30%-40%)。太少则深度不足,太多则参数过度共享拖累性能。这也打开了新的Scaling维度:除了循环次数,还能调整每轮的压缩尺度。
两篇论文,补上循环架构的关键拼图
回头看,MeSH和SpiralFormer恰好补上了循环Transformer最缺的一环:分工机制。
- MeSH解决“拿什么算”:通过动态记忆缓冲,让每轮获取差异化信息,避免重复劳动。
- SpiralFormer解决“以什么粒度算”:通过多分辨率序列,让早期关注全局模式,后期聚焦局部细节。
过去大模型Scaling依赖三大支柱:参数、数据、训练算力。推理模型兴起后,又多了“用更长思维链换更好答案”的路径。如今,循环架构提供了第四种可能:在hidden state内部深化计算,用同一组参数反复思考。
当然,这并非免费午餐。循环省下的是参数存储,不是计算量。但如果能让每一轮都“算得值”,就有望用更小模型达到更强性能。
阿里团队的做法很务实:不争论“是否该用循环”,而是直接拆解内部卡点——从诊断病因、修改结构到实验验证,一步步把可能性做实。两篇顶会论文的接收,也为这条路线增加了技术可信度。
Astra的发布让循环架构站上风口,但真正的突破往往来自那些默默填坑的人。从Universal Transformer到Looped Transformer,再到今天的MeSH和SpiralFormer,学术界已经在这条路上走了八年。
下一代高效大模型会不会从这里长出来?现在下结论还早。但至少,我们离答案又近了一步。