DiffuTester:利用代码结构模式加速扩散语言模型的单元测试生成
扩散语言模型的提速困境
扩散语言模型(Diffusion Large Language Models,dLLMs)在代码生成任务中展现出独特优势:它不像传统自回归模型那样逐个 token 生成,而是在每一步去噪过程中并行预测多个位置的内容。这种机制天然适合需要批量产出相似代码片段的场景——比如为一个函数生成多个单元测试用例。
但问题也随之而来:想跑得快,就容易摔跤。如果在每轮去噪中只保留模型最确信的少数 token,生成结果稳定但速度慢;若强行让模型一次“吐”出更多 token,虽然步数减少、整体耗时下降,但错误率明显上升,生成的测试用用例可能连基本语法都通不过,更别说有效覆盖分支逻辑了。
这种“速度-质量”的权衡,在单元测试生成(Unit Test Generation, UTG)中尤为棘手。现实项目里,一个类可能有几十个方法,每个方法又需要多个测试用例来覆盖不同输入路径。开发者等不起慢吞吞的生成器,但也绝不能接受一堆跑不通的“假测试”。
单元测试里的隐藏规律
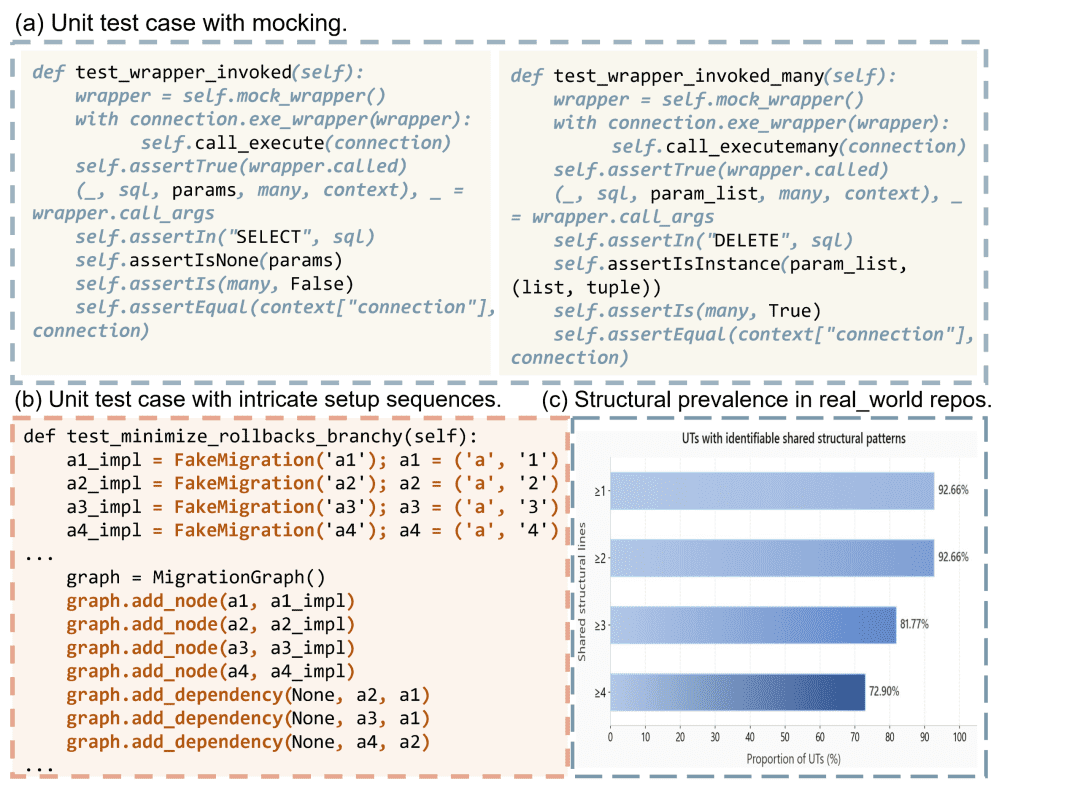
研究者注意到一个朴素但关键的现象:针对同一个被测方法生成的多个测试用例,往往长得非常像。
比如,测试一个 calculate_discount(price, user_type) 函数时,不同用例可能只是传入不同的 price 数值或 user_type 字符串,但外围的调用结构、断言语句、变量声明几乎完全一致。这种重复性不是偶然——它是单元测试本身的规范性和目的性决定的。
这种高度结构化的重复,恰好可以被 dLLM 利用。既然多个候选测试共享大量相同代码骨架,那在去噪过程中,模型其实不需要对每个位置都“从头猜起”。只要识别出这些公共部分,就可以放心地一次性确定更多 token,而不必担心出错。
DiffuTester:用 AST 挖掘结构共性
基于上述观察,清华大学 AI Agent 课题组提出了 DiffuTester——一个无需重新训练、直接作用于推理阶段的加速框架。
它的核心操作发生在每次去噪步骤中:
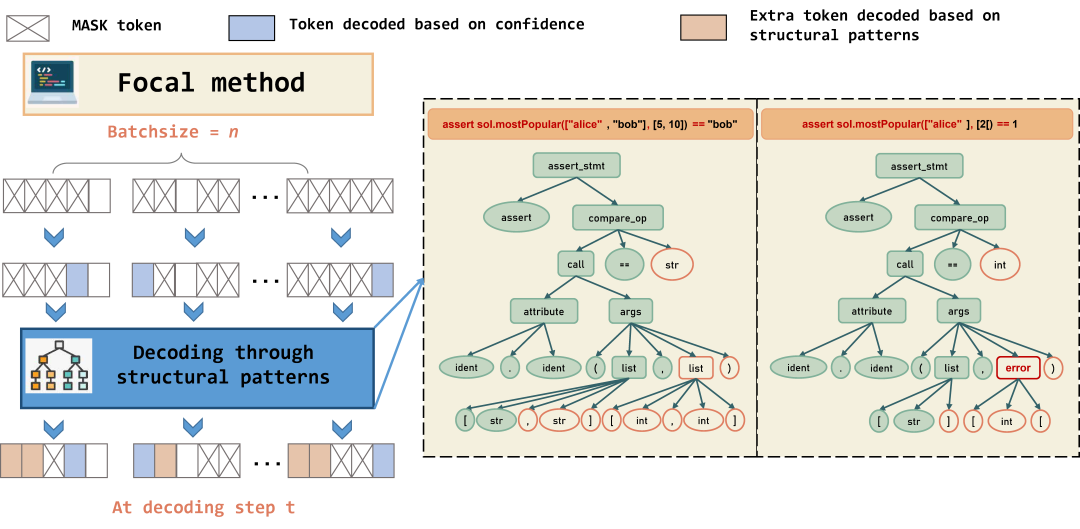
- 先做常规置信度过滤:保留模型预测概率高于阈值的 token,这是大多数 dLLM 加速方法的基础。
- 再挖结构共性:对当前 batch 中所有正在生成的测试用例,尝试构建抽象语法树(AST)。由于早期生成的代码可能有语法错误,DiffuTester 不强求整段解析,而是采用逐行解析策略——只要某一行能成功转成 AST 节点,就纳入分析。
- 合并 AST 找公共子结构:将多个测试用例的 AST 进行比对,找出频繁出现的子树模式(比如相同的函数调用链、相同的 assert 结构)。
- 额外保留结构对应 token:凡是属于这些高频结构的 token,即使其置信度略低于阈值,也会被强制保留下来。
这样一来,每一步去噪实际确定的 token 数量显著增加,整体所需的迭代步数自然减少。
为控制开销,DiffuTester 并非每一步都做 AST 分析,而是每隔若干步执行一次。同时,它仍会过滤掉置信度过低的 token,避免把明显错误的代码“固化”下来。
实验:提速不降质
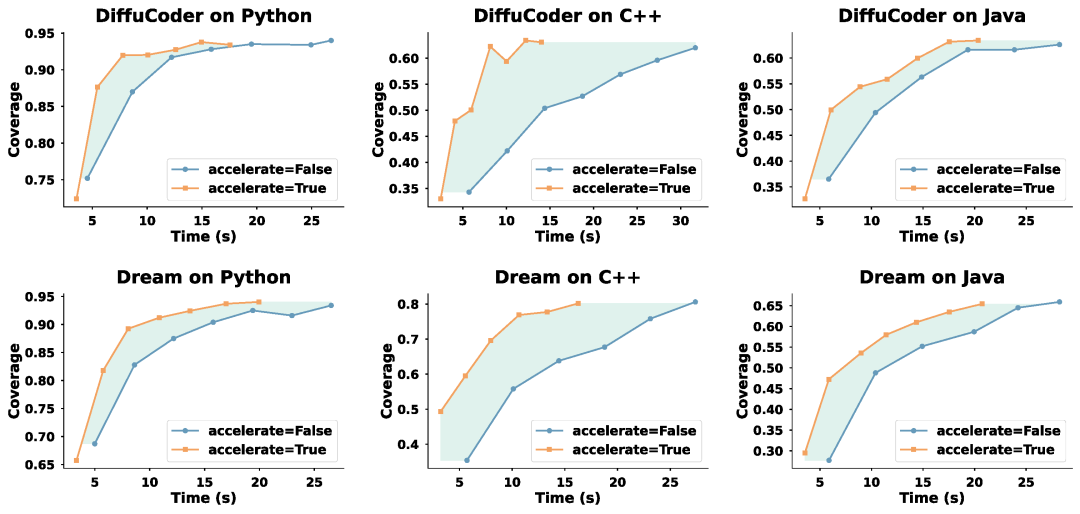
研究团队在两个主流扩散语言模型——DiffuCoder 和 Dream 上测试了 DiffuTester,并将标准的 TestEval 数据集扩展到 Python、Java 和 C++ 三种语言。
结果很清晰:
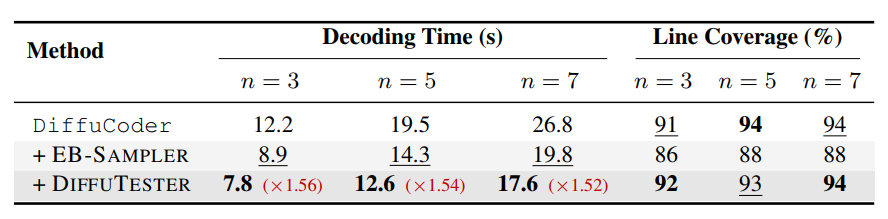
- 加速效果稳定:在保持峰值语句和分支覆盖率不变的前提下,DiffuTester 将生成速度提升了 2 到 3 倍。这意味着原本需要 30 秒生成的测试套件,现在 10–15 秒就能完成。
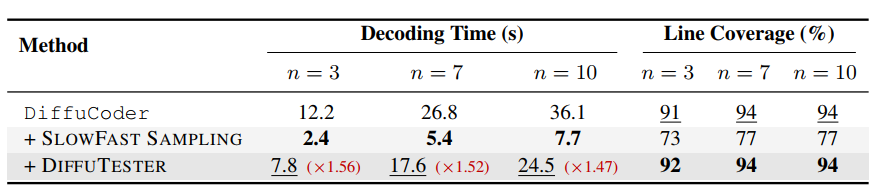
- 优于其他采样加速法:与仅靠提高采样数量或调整温度的加速策略相比,DiffuTester 在相同速度下生成的测试用例通过率更高,无效或崩溃的比例更低。
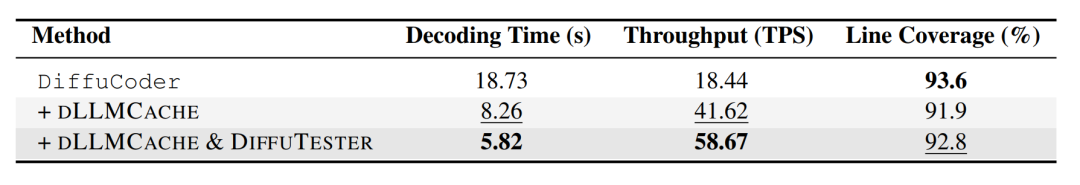
- 可与缓存优化叠加:另一类 dLLM 加速方法(如复用 KV Cache)侧重降低单步计算成本,而 DiffuTester 减少的是总步数。两者目标不同,因此可以组合使用,进一步压缩端到端延迟。
值得注意的是,这种加速并非来自硬件优化或模型压缩,而是对任务特性的精准利用——单元测试的结构重复性成了 dLLM 的“加速燃料”。
为什么这个思路值得重视?
过去很多 dLLM 加速方案试图“通用化”,比如设计更聪明的采样算法或更高效的缓存机制。但 DiffuTester 走了另一条路:深入理解目标任务的内在规律,并将其反馈给生成过程。
这其实更接近人类程序员的做法。当我们为一个函数写多个测试时,不会每次都从零开始构思,而是复制已有用例,修改参数即可。DiffuTester 相当于让模型也学会了这种“模板复用”的技巧。
更重要的是,这种方法具有可迁移性。虽然目前聚焦于单元测试,但任何具备结构重复性的代码生成任务——比如 API 调用示例、配置文件生成、甚至某些类型的文档注释——都可能从中受益。
开源与后续
相关论文《DiffuTester: Accelerating Unit Test Generation for Diffusion LLMs via Mining Structural Pattern》已被 EMNLP 2026 接收,代码已在 GitHub 开源。对于希望在 CI/CD 流程中集成 AI 测试生成的团队来说,这类 training-free 的加速方案尤其友好——无需重新训练模型,只需在推理时加载 DiffuTester 插件,就能获得显著性能提升。
当然,挑战依然存在。比如如何处理结构差异较大的测试(如异常路径 vs 正常路径),或者在更复杂的集成测试场景中是否还能挖掘有效模式。但至少在单元测试这个高频刚需场景里,DiffuTester 提供了一条兼顾效率与质量的可行路径。
说到底,AI 写代码的终极目标不是“快”,而是“快且可靠”。DiffuTester 的价值,正是让扩散模型在这条路上又稳又快地多走了一步。