OpenAI把Codex拆成API,开发者能直接调用Agent核心能力
OpenAI把Codex“拆开卖了”
2026年9月10日,OpenAI一口气发布了四款新产品:Agents API、GPT-Live-1 API、Data agent 和 ChatGPT for Financial Services。横跨语音、数据、金融和智能体四大方向,每一条线都够单独写一篇分析。但其中最值得细看的,其实是 Agents API——因为它标志着 OpenAI 正式把 Codex 的核心能力“拆开卖”了。
过去,Codex 是一个完整的产品:你给它一个代码仓库,它能在云端沙盒里自动修改代码、运行测试、修复 bug,还能同时处理多个长期任务。但支撑这些功能的底层系统——负责 Agent 循环、工具调度、上下文压缩、子智能体协作和状态管理的那一整套机制——一直藏在幕后。
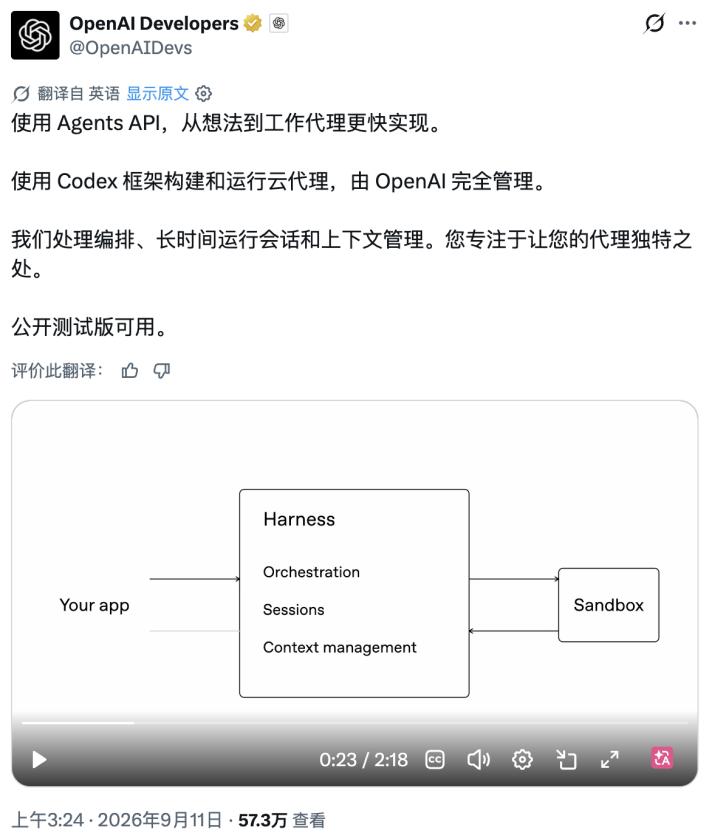
现在,这套机制被命名为 Codex Harness,并通过 Agents API 直接开放给开发者调用。你不再需要自己搭建和维护复杂的运行时环境,只需告诉 API 四件事:任务目标、使用的模型、可用的工具列表,以及执行环境(可以是 OpenAI 的沙盒,也可以是你自己的服务器,甚至是 Cloudflare、E2B 或 Modal 等第三方平台)。剩下的,比如如何让 Agent 持续工作几十分钟、如何在长对话中压缩上下文、如何协调多个子 Agent 协同完成复杂流程,全部由 OpenAI 托管。
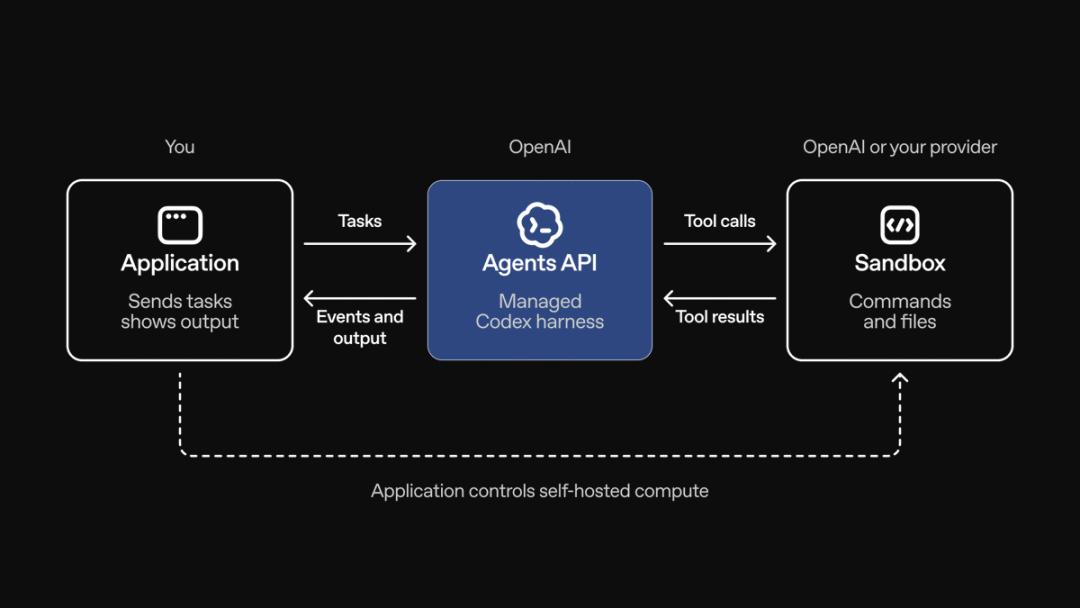
更关键的是,OpenAI 明确表示:Agents API 本身不额外收费。你只为实际消耗的模型 Token 和调用的工具付费;如果选择使用 OpenAI 提供的计算沙盒,才另计资源费用。这意味着,Harness 的托管和维护成本,OpenAI 自己扛了。
一年拆解:从 CLI 到平台
其实,OpenAI 拆解 Codex 的动作早就开始了。回看过去一年多的时间线,几乎是一步步把一个封闭产品变成可组合的平台。
2025 年 4 月,OpenAI 首次开源了 Codex CLI。它像一个本地终端工具,开发者可以直接在命令行里运行 Agent,查看每一步的推理和工具调用过程。所有逻辑都公开在 GitHub 上,愿意折腾的人可以自行修改、集成到自己的工作流中。但这只是“给了源码”,用不用、怎么用,全靠开发者自己。
一个月后,Codex 云端版上线。用户可以把整个代码库交给它,每个任务在一个隔离的沙盒中运行,支持并行处理多个长期作业。这时候,Codex 开始具备产品化的体验,但仍是黑盒。
到了 2025 年 10 月,OpenAI 推出 Codex SDK。这是一套面向开发者的工具包,允许用几行 TypeScript 代码启动与 CLI 相同的 Agent 引擎,获取结构化输出,并支持任务暂停与恢复。SDK 特别适合嵌入到后台服务、自动化脚本或 CI/CD 流程中。但它主要面向程序调用,要做一个完整的交互式客户端(比如 IDE 插件),还是不够。
转机出现在 2026 年 2 月。OpenAI 发布了 Codex App Server,首次系统性地解释了 Codex 背后的统一架构。无论是 Web 版、Mac 应用、VS Code 插件还是 JetBrains 扩展,底层其实都运行着同一套 Harness。App Server 为这套系统提供了一个双向 JSON-RPC 接口,任何客户端只要连接它,就能驱动完整的 Codex 功能,无需重复实现 Agent Loop 或状态管理。
但问题还没彻底解决。App Server 本身仍是一个需要开发者自行部署和维护的常驻进程。如果你要做一个在线 Coding Agent 网站,前端可以轻松接入,但用户点击“修复仓库”之后的大量计算、沙盒隔离、资源调度等问题,还得你自己搞定。
直到 2026 年 8 月 19 日,OpenAI 将 CLI、SDK、App Server 统一纳入“开放 Codex Harness”的叙事,并宣布 Codex 不再只是一个产品,而是一个平台。紧接着,9 月 10 日的 Agents API 公测,终于补上了最后一块拼图:Harness 托管服务化。
现在,开发者可以选择三种方式使用 Codex 能力:
- 完全自托管:用开源 CLI 或 SDK,自己跑一切;
- 半托管:用 App Server,自己管理进程,但复用统一接口;
- 全托管:直接调用 Agents API,把 Harness 和长期任务管理交给 OpenAI。
这很像当年 SaaS 的演进路径——只不过这次被服务化的不是 CRM 或邮箱,而是智能体的执行引擎。有人戏称这是 “Codex as a Service”,倒也贴切。
Harness 的两条路线:开放生态 vs 托管服务
OpenAI 并不是唯一盯上 Harness 的公司。国内的大模型厂商 DeepSeek 早在其 DeepSeek Harness(DSH)发布时就提出了一个清晰的公式:Agent = Model + Harness。
在 DeepSeek 看来,模型只负责“想”,而 Harness 才负责“做”——包括理解环境、调用工具、管理会话状态、持续执行任务、处理错误恢复等。两者缺一不可。DSH 的设计哲学是“一切皆插件”:模型、工具、技能库、沙盒、存储、UI 层都可以替换。它的目标是成为 Agent 时代的通用底座,无论上面跑的是 DeepSeek、Llama 还是其他模型,底层都能用同一套 Harness。
这和 OpenAI 当前的策略形成了鲜明对比。虽然 OpenAI 也开源了 Codex Harness,但 Agents API 明显在推动另一条路:如果你嫌麻烦,干脆别管 Harness,我来替你跑。开发者只需关注业务逻辑——任务是什么、用什么工具、在哪执行——其余的运维、升级、扩缩容,全部由 OpenAI 承担。
可以说,DeepSeek 想把 Harness 做成 Linux——开放、模块化、社区共建;而 OpenAI 则想把它做成 AWS——开箱即用、按需付费、免运维。
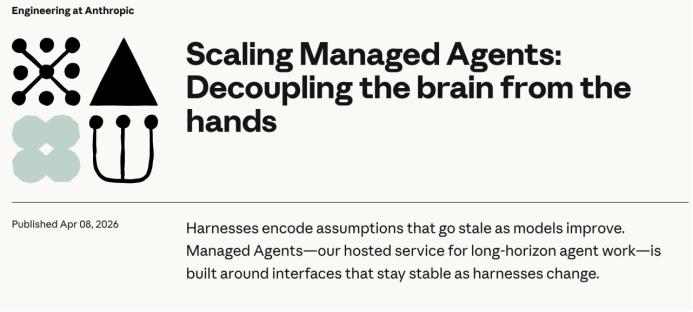
有趣的是,在“托管 Harness”这条路上,Anthropic 其实比 OpenAI 更早。2025 年 9 月,Anthropic 就推出了 Claude Agent SDK,开放了 Claude Code 背后的工具调用、权限控制和子智能体协作能力。今年 4 月,它进一步推出 Claude Managed Agents,将 Session、Harness 和沙盒拆成三层:Anthropic 托管前两层,沙盒可选自建或第三方。这个架构和今天的 Agents API 已经非常接近,Anthropic 自己就称之为“用于长期 Agent 任务的托管服务”。
谷歌也没落下。今年 5 月 I/O 大会上,Gemini API 推出 Managed Agents,同样将 Antigravity Harness 和执行沙箱服务化。但谷歌的野心不止于此——它手握 Search、Gmail、Calendar、Drive、YouTube、Maps 等一系列天然可被 Agent 调用的产品,正在底层逐步统一这些能力。Gemini Spark、Workspace Studio、Search 中的信息智能体,未来可能共享同一套执行系统。
不过对普通用户来说,谷歌目前的产品线还是有点乱:Gemini Enterprise、Workspace Studio、Antigravity、Spark……面对不同场景,但缺乏一个统一入口。如果谷歌真能整合成一个“有问题找谷歌”的 Agent 工作台,全球格局恐怕要再变一次。可惜,国内用户大概只能围观。
为什么大家都在抢 Harness?
问题的核心在于:模型决定 Agent 的智力上限,但 Harness 决定它能不能把活干完。
一个聪明的模型可以生成完美的代码片段,但如果不知道项目结构在哪、无法调用 Git、不能运行测试、出错后不会回滚,那它终究只是个“纸上谈兵”的助手。而真正的 Agent 需要能接入现实世界的工具链:邮件系统、文档库、会议日历、数据库、API 权限……这些恰恰是传统平台公司过去十几年积累下来的资产。
国内正在上演的“办公 Agent 大战”就是典型例子。表面看是比谁家 AI 员工更聪明,实则是在重新激活各自生态里的平台优势。谁手里有企业微信、钉钉、飞书、WPS、百度网盘,谁就更容易让 Agent 真正完成端到端的任务。
换句话说,AI 公司需要连接现实世界,而平台公司手里本来就有一大串钥匙。
OpenAI 的 Agents API,本质上是在降低开发者接入这串钥匙的门槛。你不需要成为基础设施专家,也能构建能干活的智能体。而 DeepSeek 的开放框架,则是给那些想深度定制、掌控全局的团队留了空间。
未来胜负,或许不取决于谁的模型更强,而在于谁的 Harness 能更快成为开发者的默认选择——就像当年的 React 或 Spring Boot 一样,成为构建智能应用的事实标准。
现在,牌已经打出来了。接下来,就看开发者用脚投票了。