用 WorkBuddy 自动分析 12306 高铁余票:从数据抓取到报告生成
要解决的实际问题
节假日或出差时,很多人会频繁查询 12306 高铁票。但官方 APP 或网页只能一页页翻看车次,无法一次性获取整条线路的所有车次信息。如果想做余票统计、时段分析或筛选最优车次,手动复制粘贴几十上百趟车次到 Excel 再画图,效率极低。
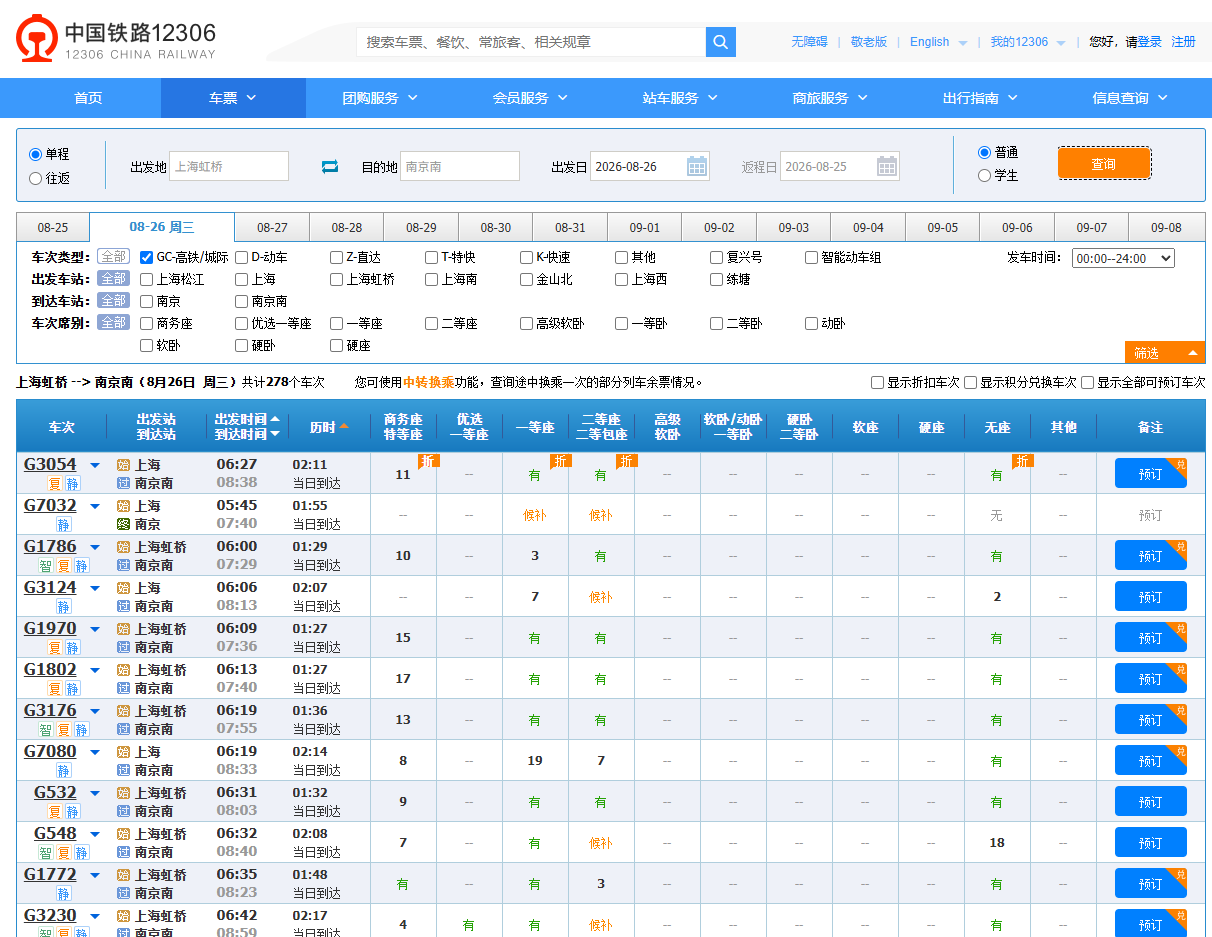
我们真正需要回答的问题包括:
- 这条线路一天到底有多少趟 G 字头高铁?运力在各时段如何分布?
- 二等座整体紧张吗?哪些时间段的车次最容易没票?
- 最快的标杆车有哪些?它们的余票情况如何?
- 能不能直接输出一份带表格和图表的正式报告,方便存档或分享?
手动处理这些问题,半天时间就没了。而借助 WorkBuddy AI 工作台,可以把整个流程自动化:数据获取 → 清洗整理 → 可视化 → 文档生成。
工具环境说明
本次操作完全在 WorkBuddy 内部完成,无需在本地安装 Python 或其他依赖。平台提供隔离的运行环境,开箱即用。核心组件包括:
- WorkBuddy AI 工作台:支持技能调用、文件读写和脚本执行
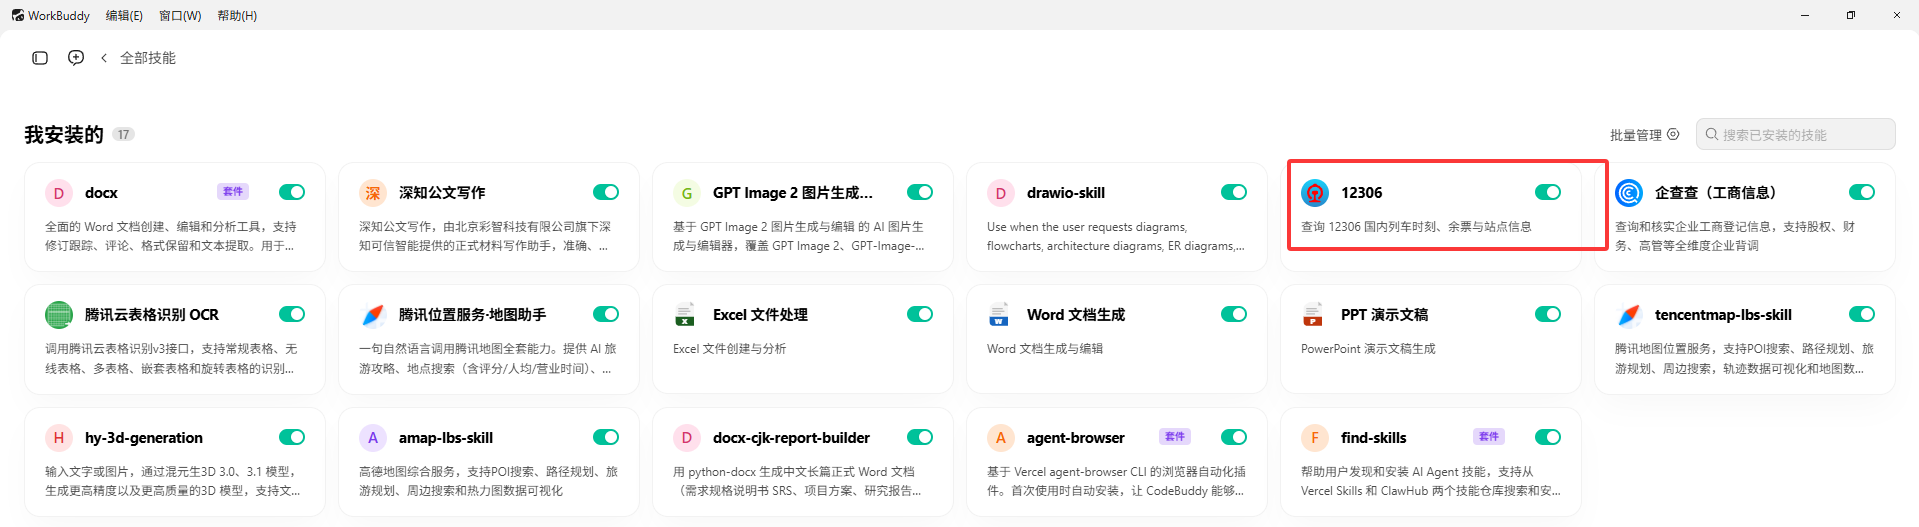
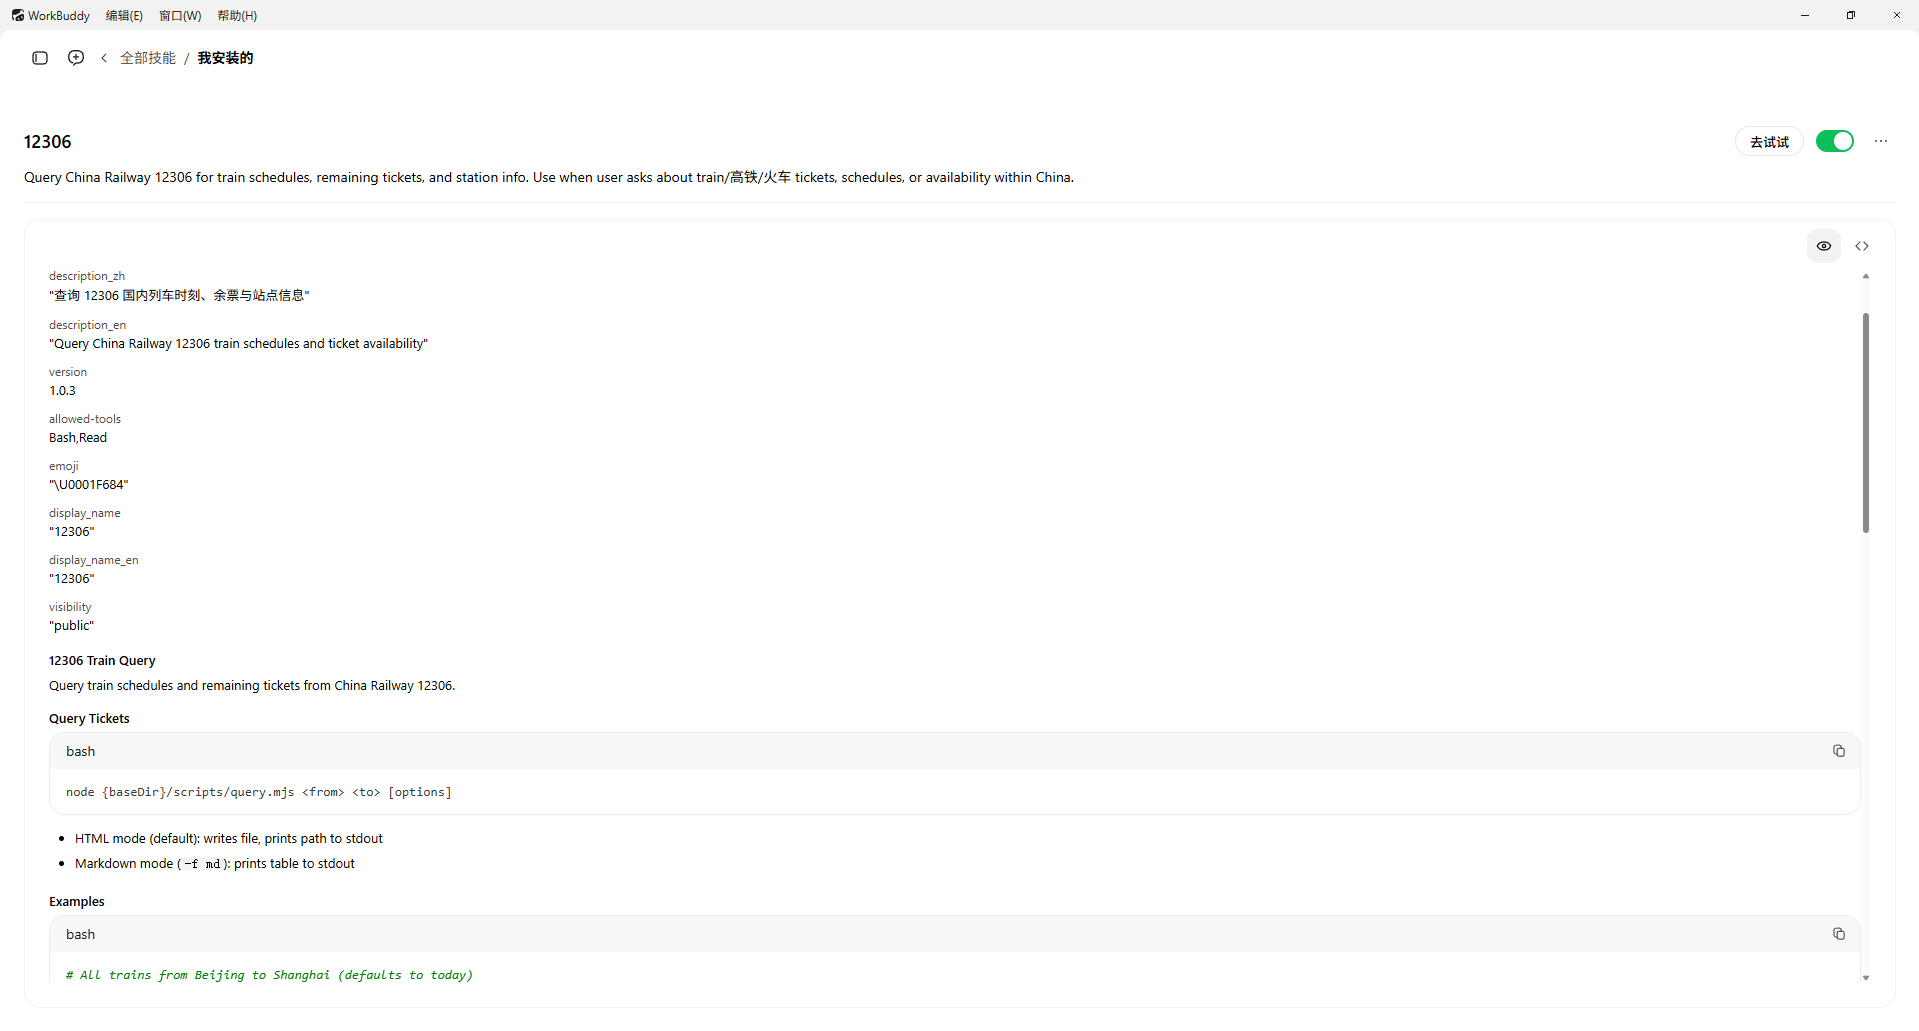
- 内置 12306 技能:封装官方查询接口,可指定日期、车站和车次类型,返回结构化 JSON 数据
- Python 3.13 + openpyxl:将 JSON 数据导出为格式化的 Excel 表格
- python-docx + matplotlib:生成带图表和目录的 Word 分析报告
所有脚本都在平台沙盒中运行,这是该方案最大的便利之处——零环境配置。
获取原始车次数据
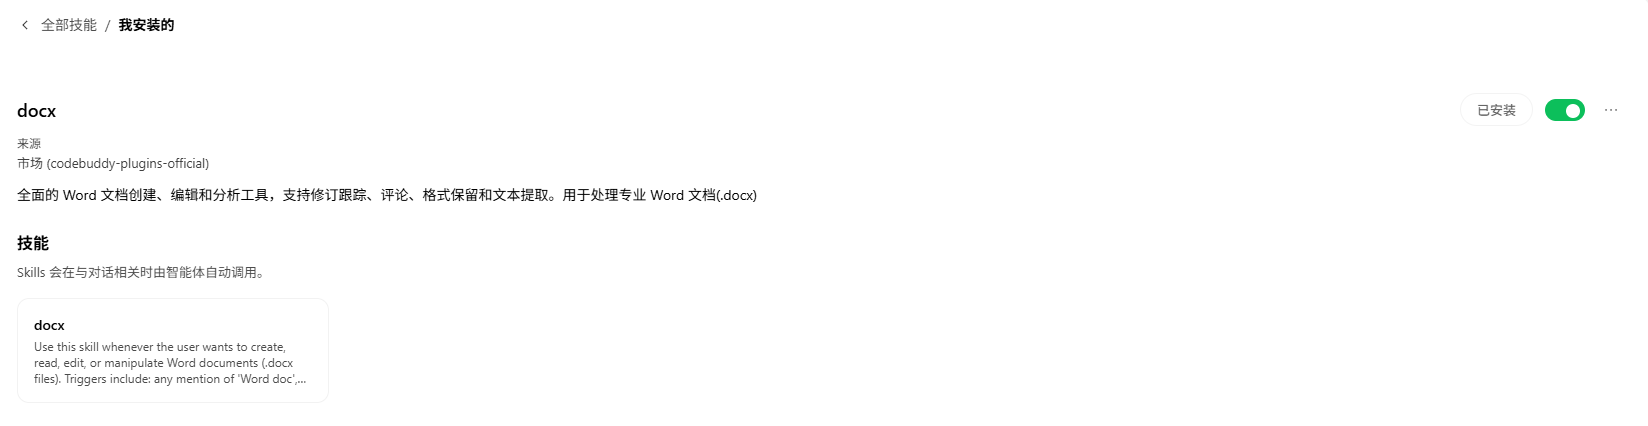
首先,在 WorkBuddy 中安装 12306 技能(免费)。然后输入以下指令:
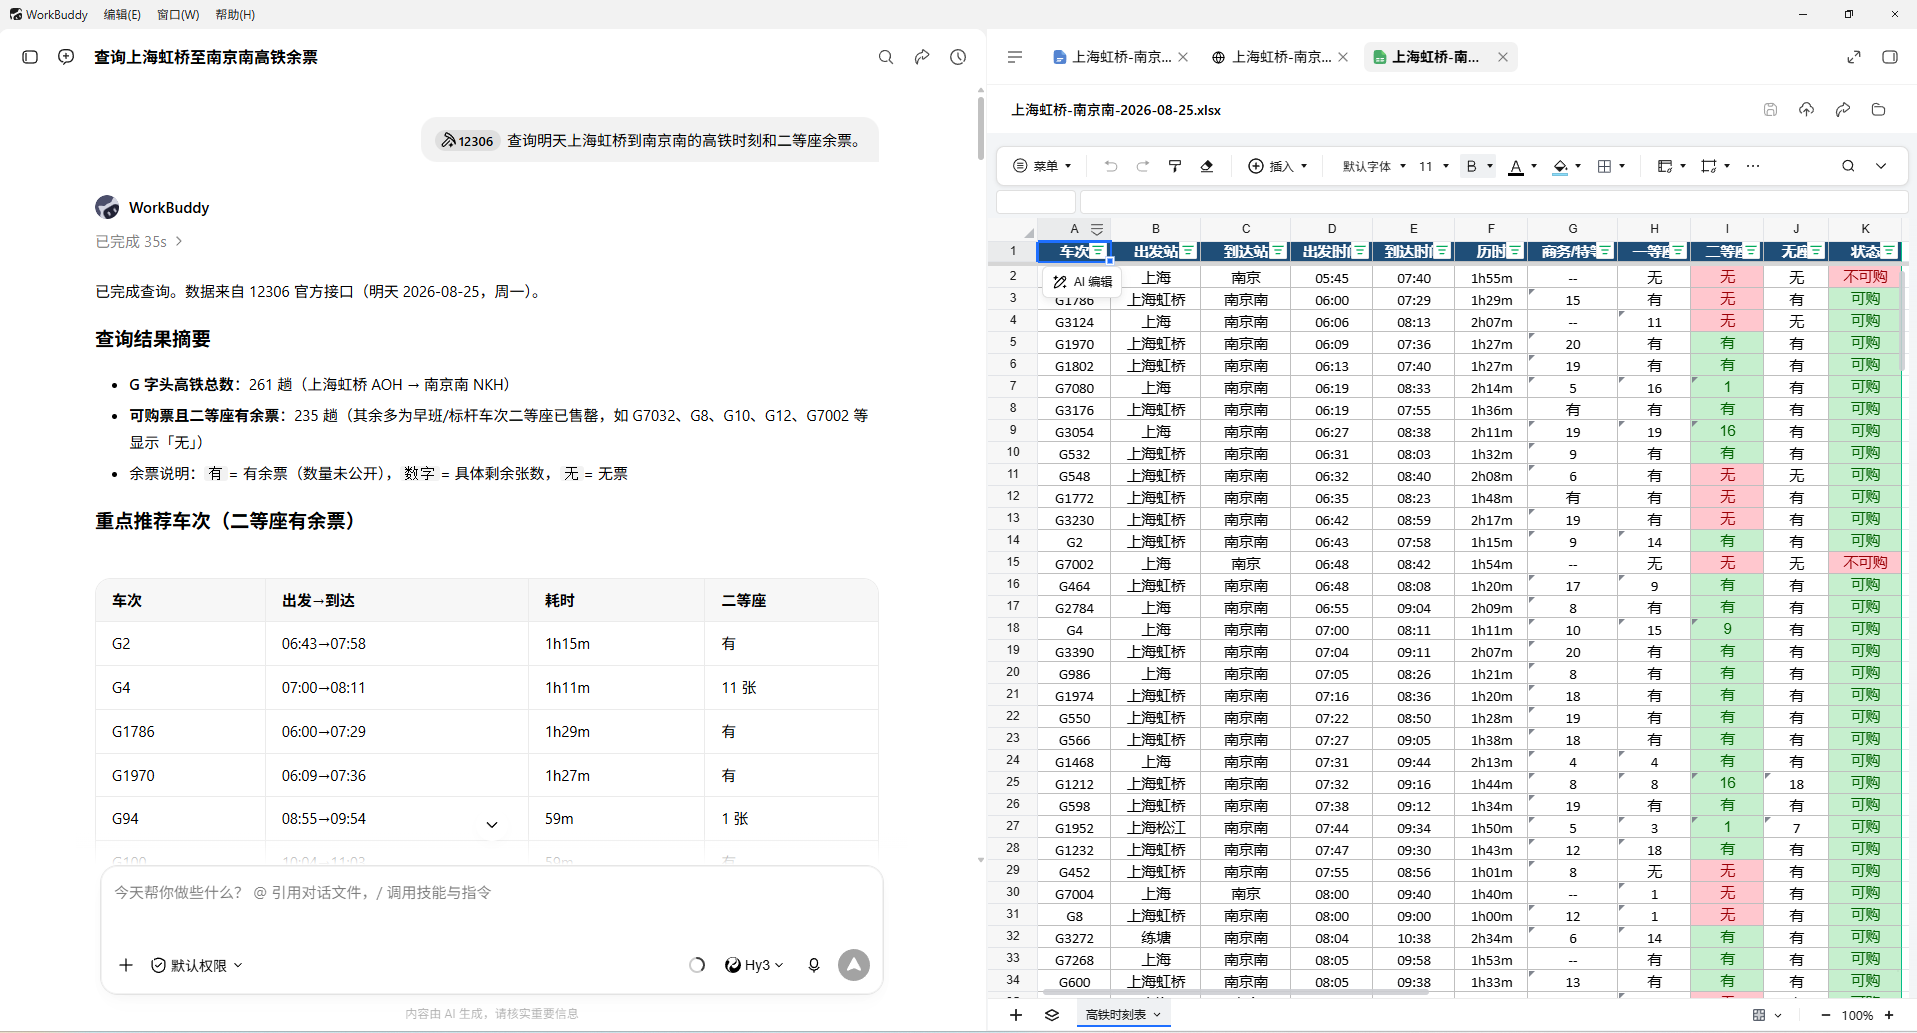
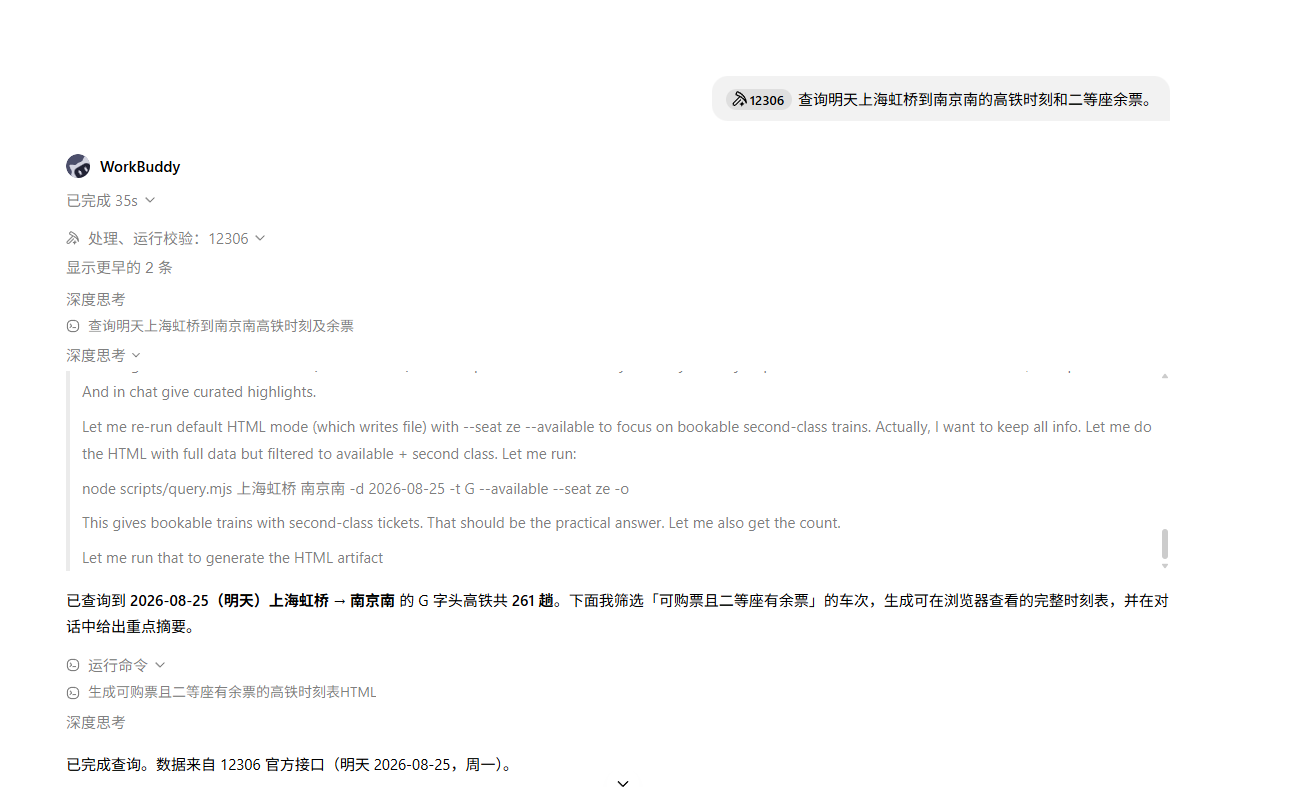
@skill:12306 查询明天上海虹桥到南京南的高铁时刻和二等座余票。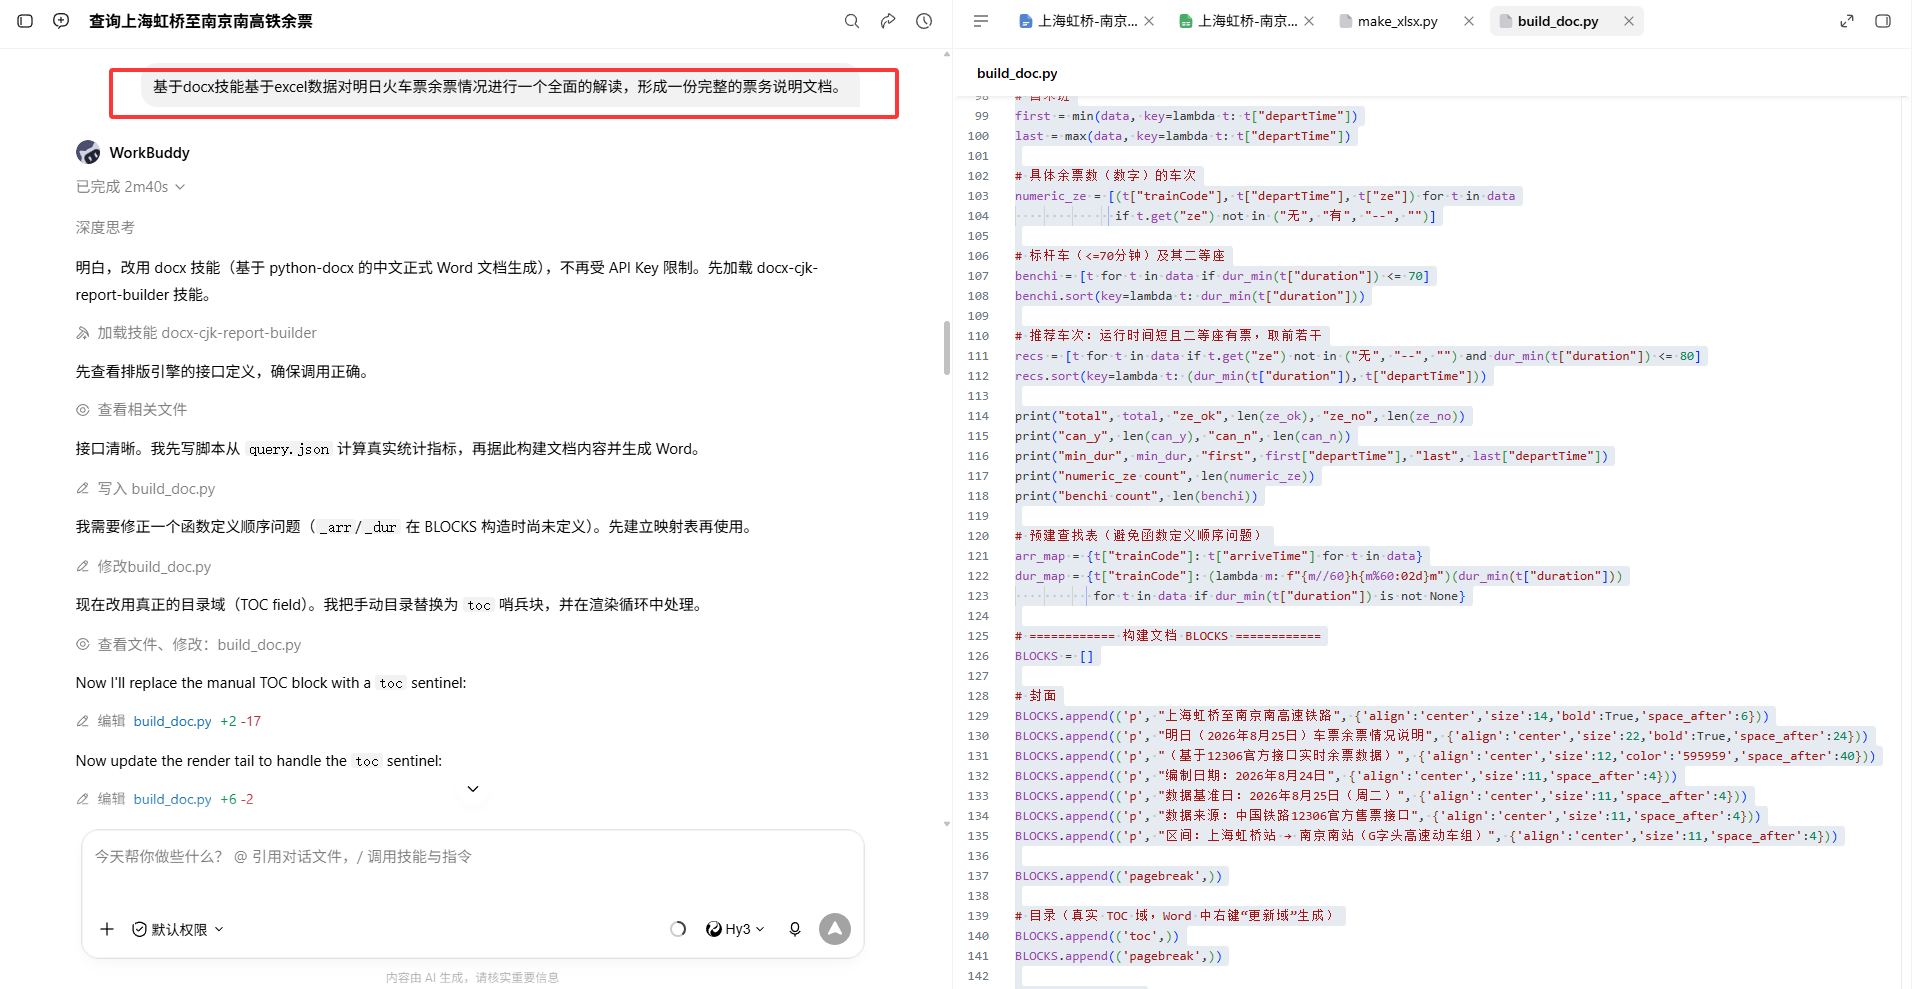
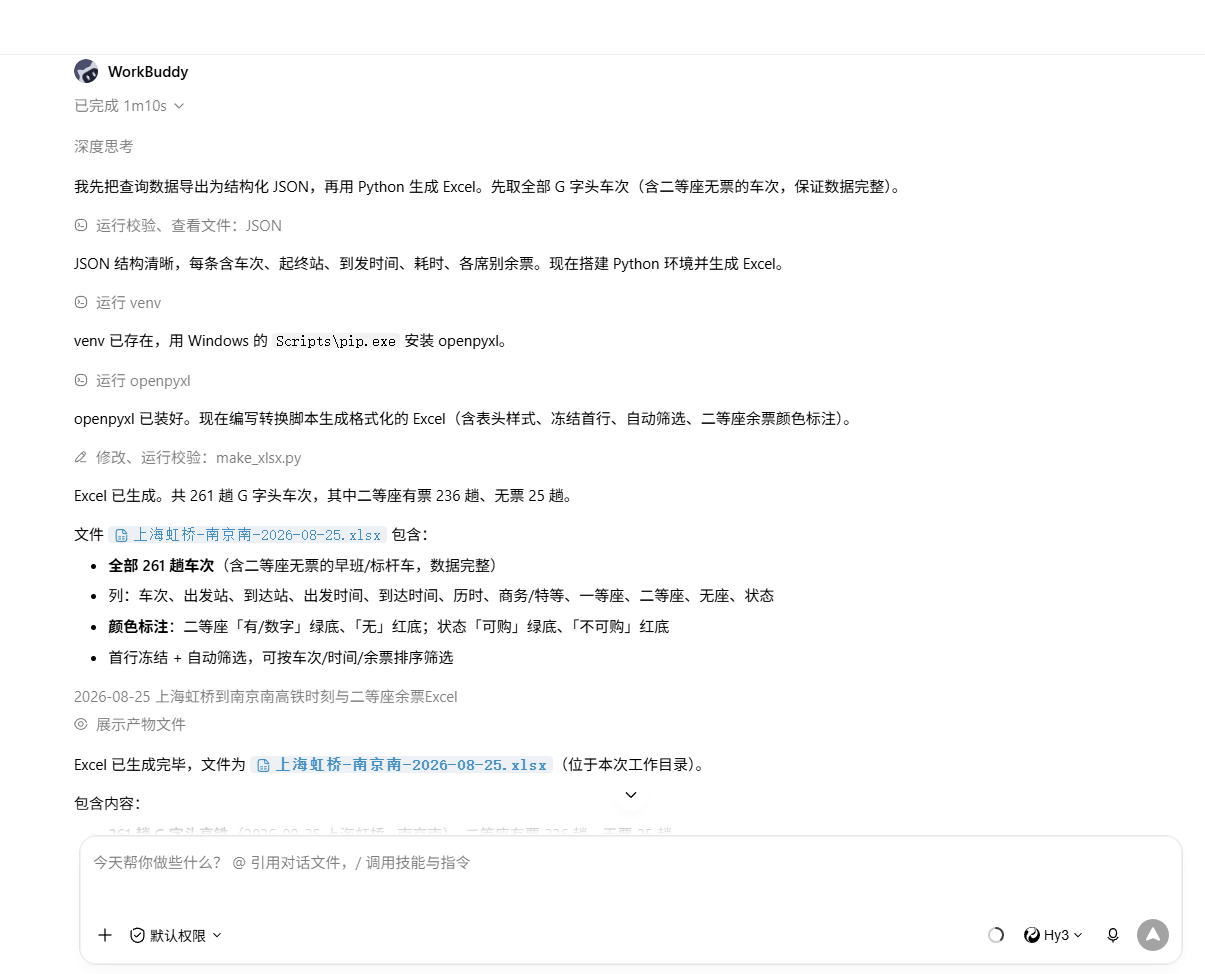
系统会自动调用接口,返回结构化 JSON 数据。测试时间为 2026 年 8 月 24 日晚间,目标日期为次日(8 月 25 日),仅统计 G 字头高速动车组。
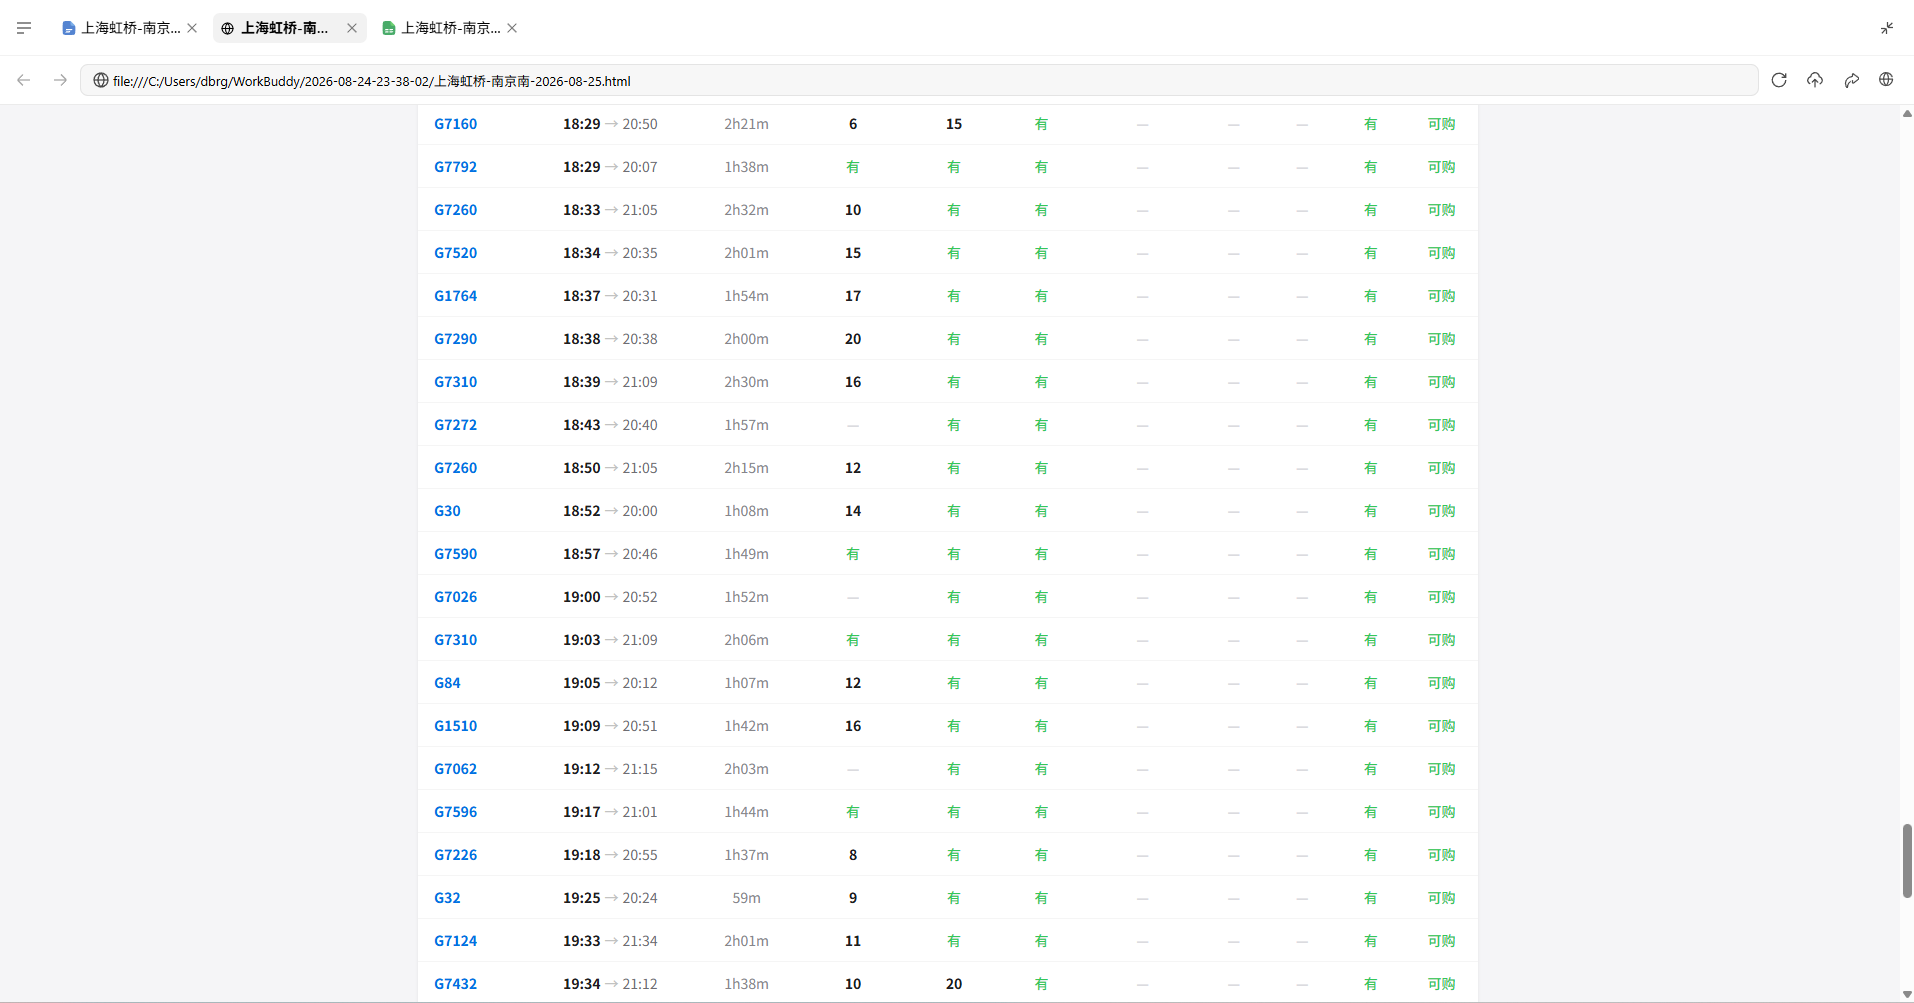
返回的部分车次示例如下:
| 车次 | 出发→到达 | 耗时 | 二等座 |
|---|---|---|---|
| G2 | 06:43→07:58 | 1h15m | 有 |
| G4 | 07:00→08:11 | 1h11m | 11 张 |
| G94 | 08:55→09:54 | 59m | 1 张 |
| G100 | 10:04→11:03 | 59m | 有 |
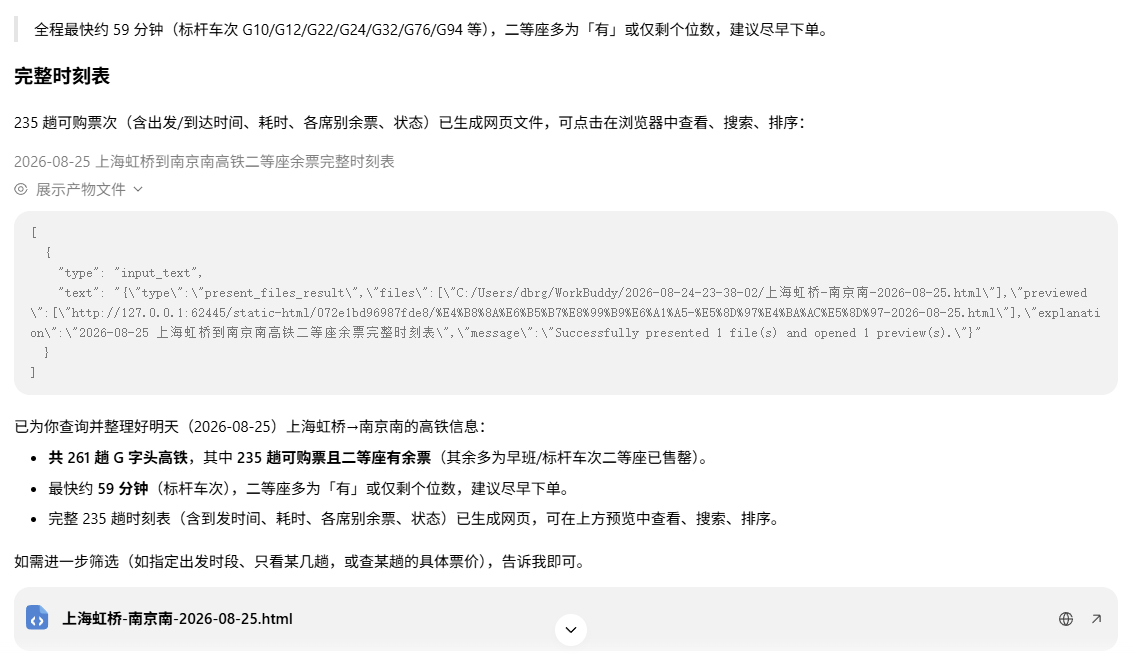
WorkBuddy 会将结果以 HTML 表格形式展示,点击即可查看完整列表。
数据统计与业务洞察
基于返回的 JSON 数据,我们先做整体统计:
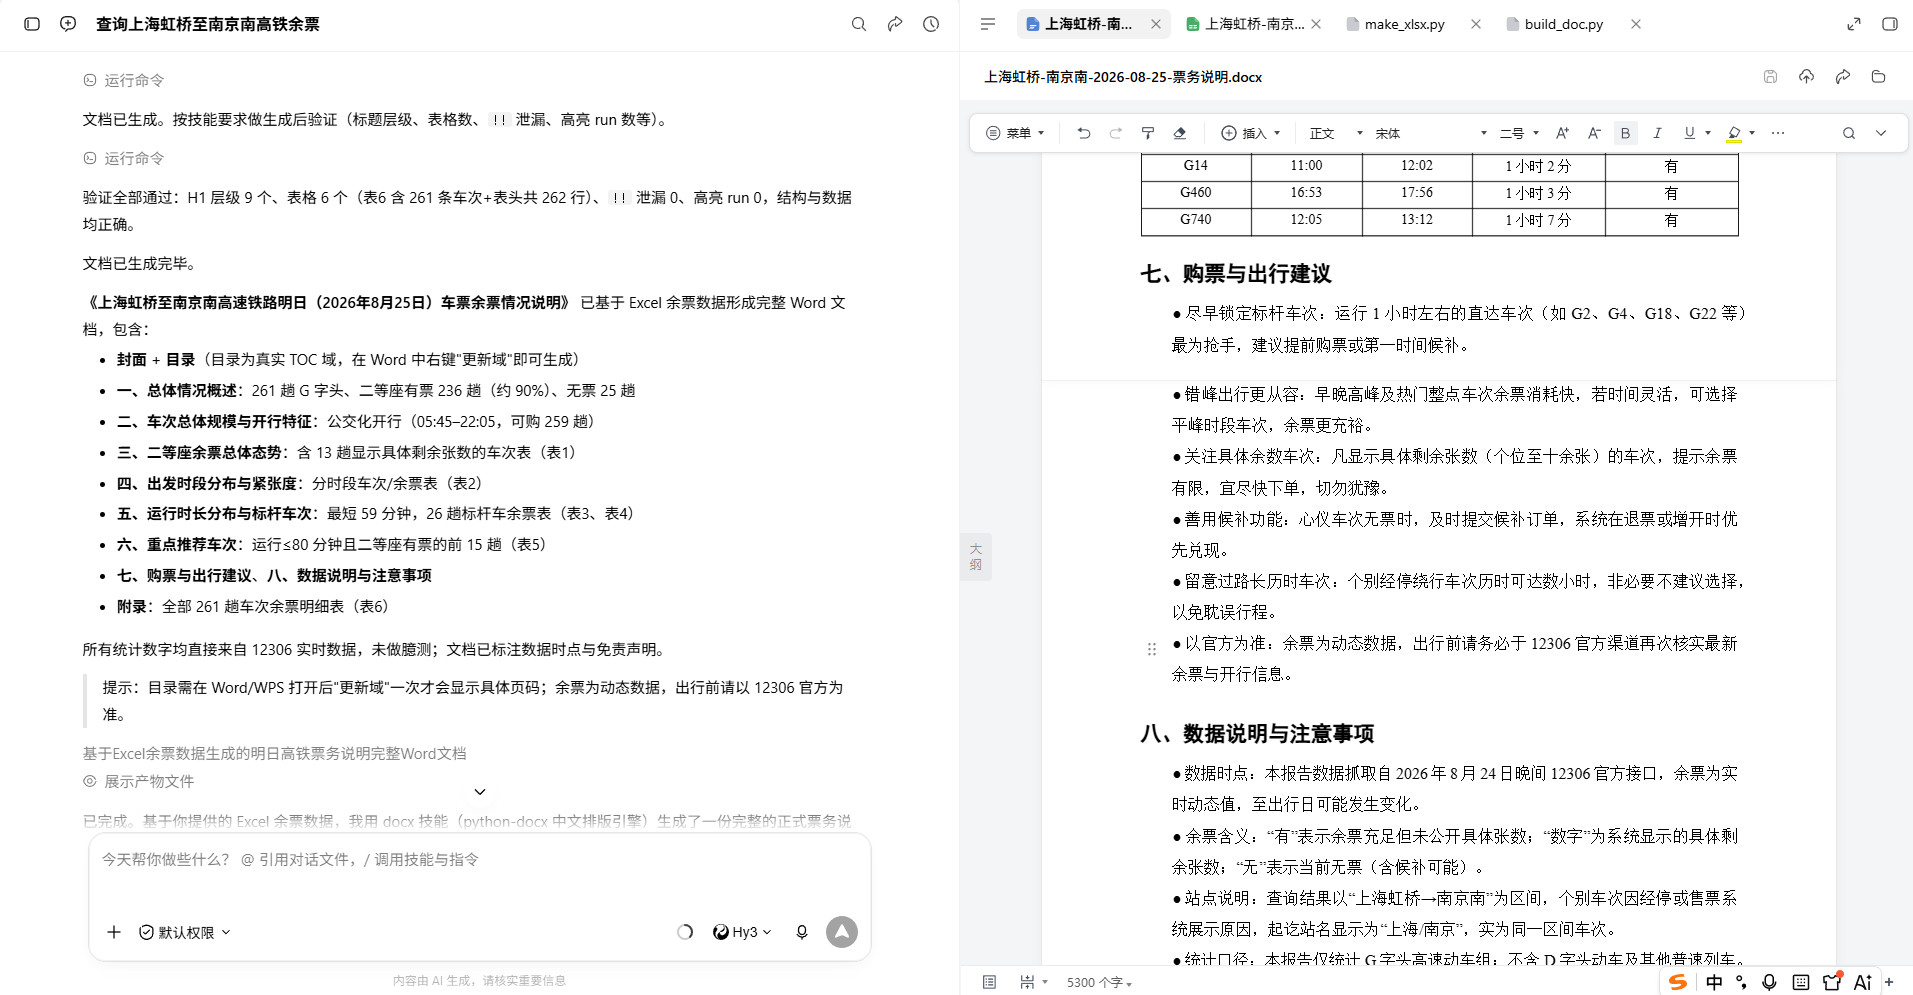
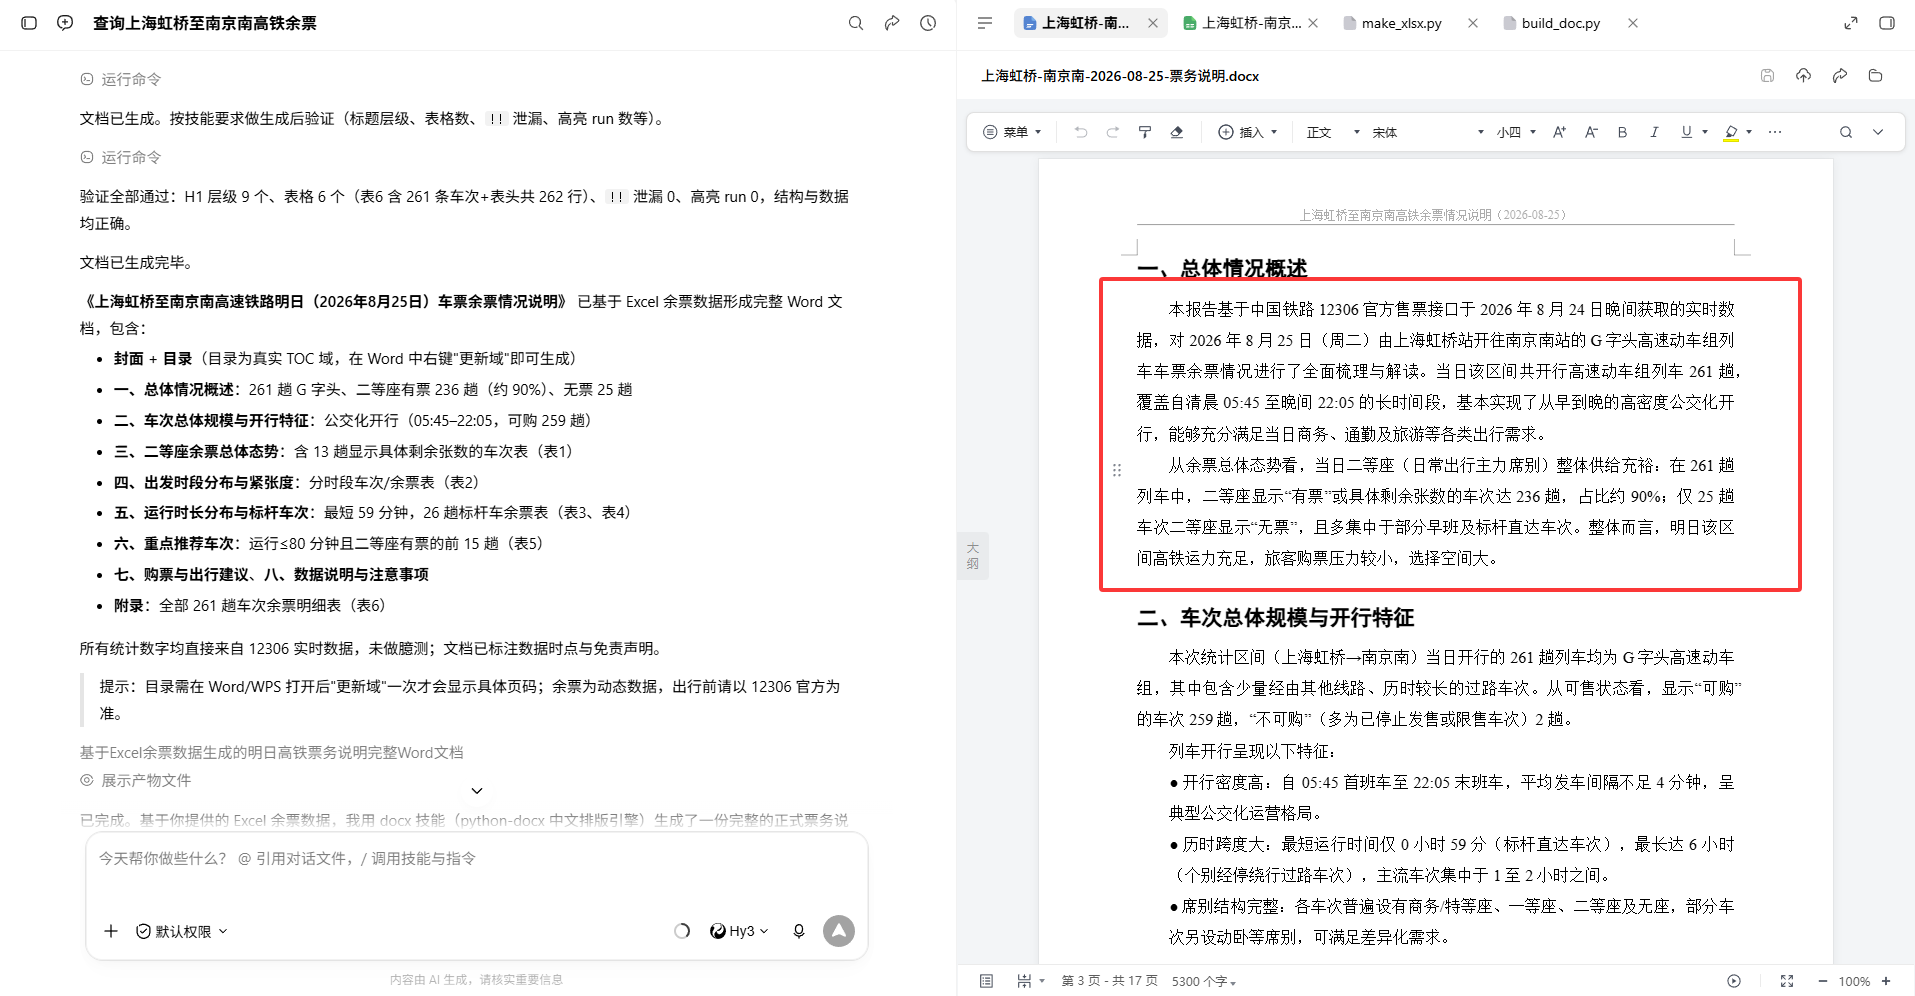
- G 字头总车次:261 趟
- 二等座有票:236 趟(约 90.4%)
- 二等座无票:25 趟(约 9.6%)
- 首末班车:05:45 / 22:05
- 最短运行时间:59 分钟
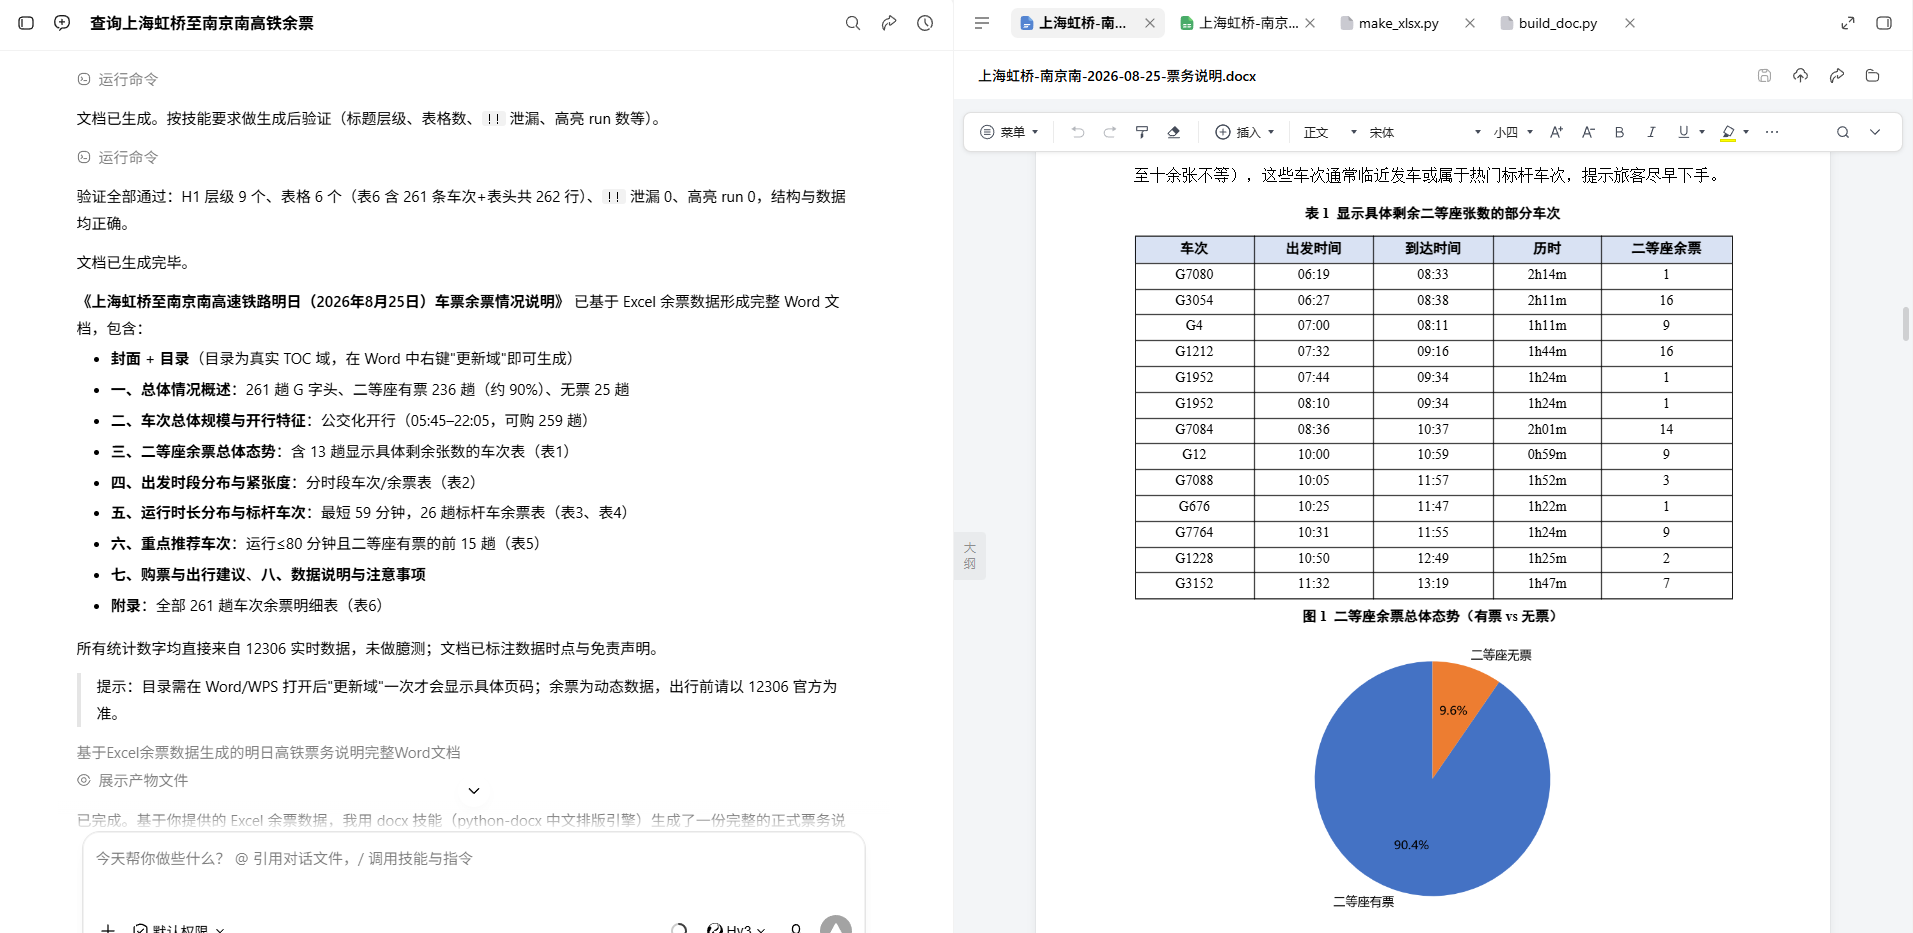
- 显示具体余票张数的车次:13 趟
可以看出,上海虹桥至南京南是典型的公交化运营线路,平均不到 4 分钟就有一班车,整体运力非常充足。无票车次主要集中在早高峰和运行时间最短的标杆快车(59–70 分钟),这些车因耗时短、停站少而抢手。
时段分布分析
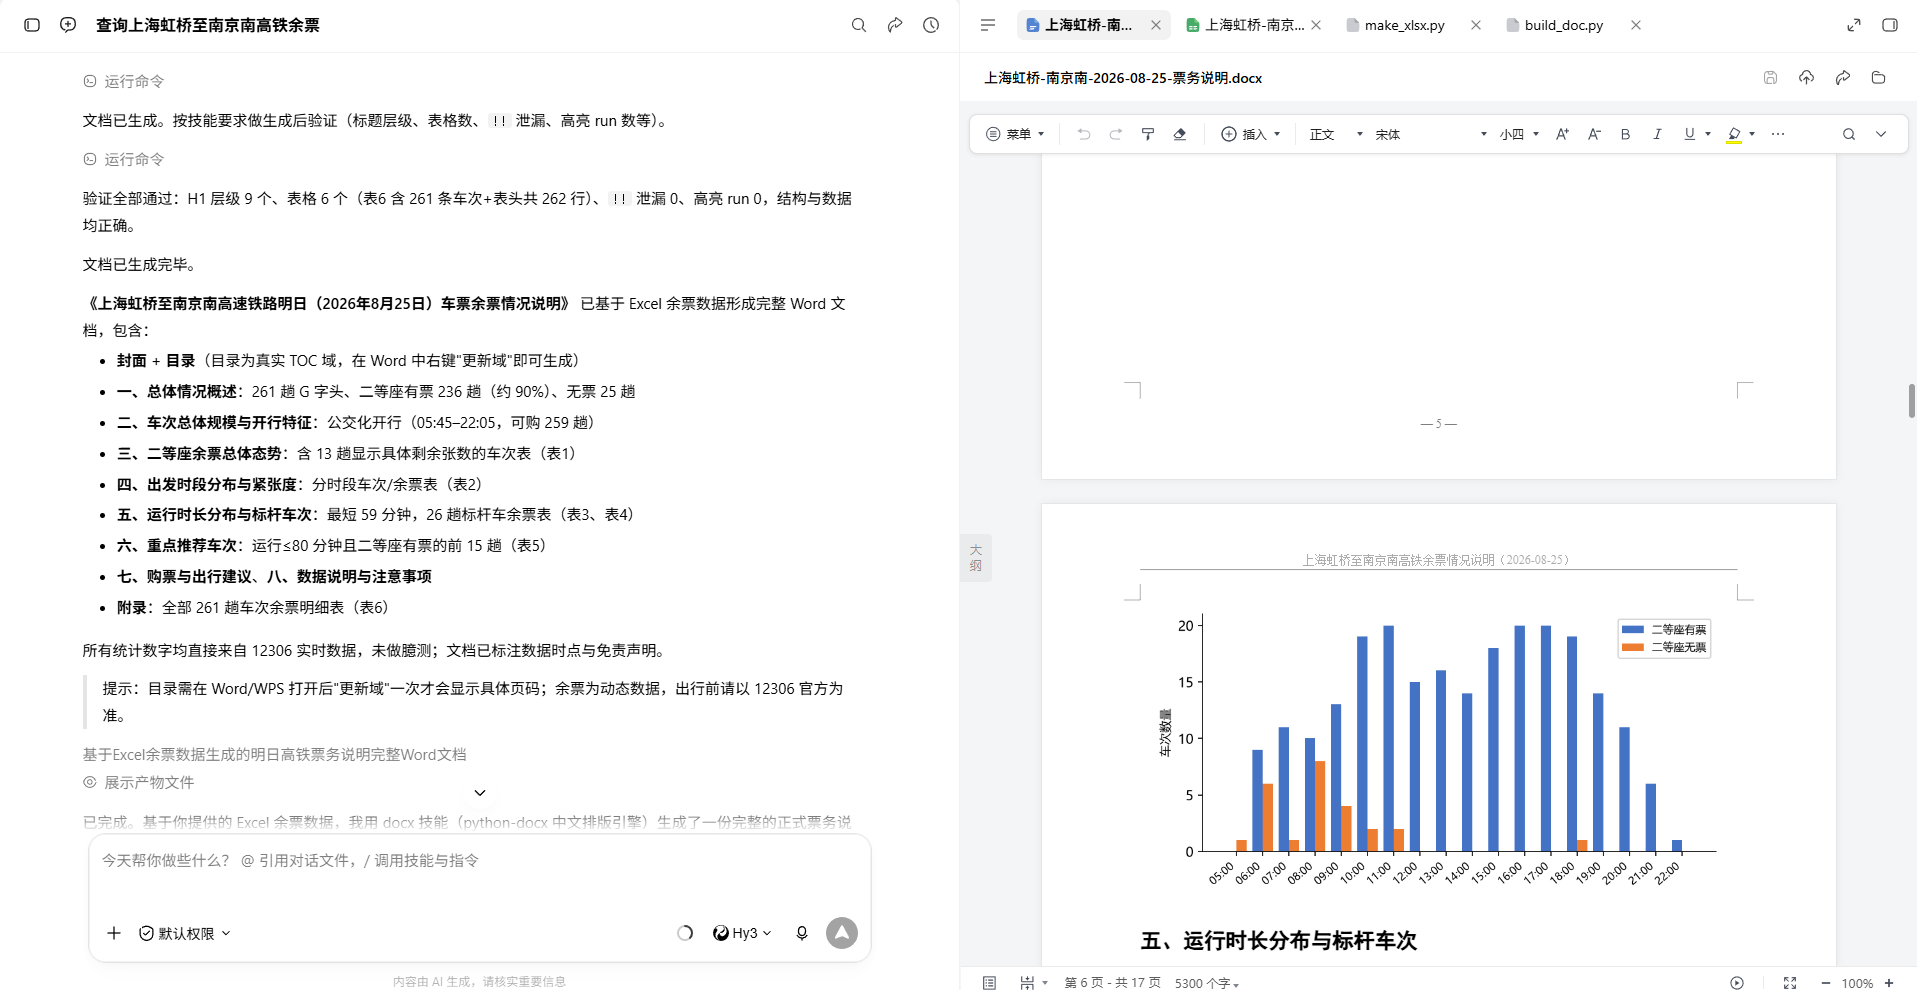
将车次按出发小时分组后发现,全天各时段均有稳定投放,二等座无票车次呈零散分布,并未出现某个大时间段整体无票的情况。这意味着只要出行时间稍灵活,避开热门标杆车,很容易买到票。
运行时长分布
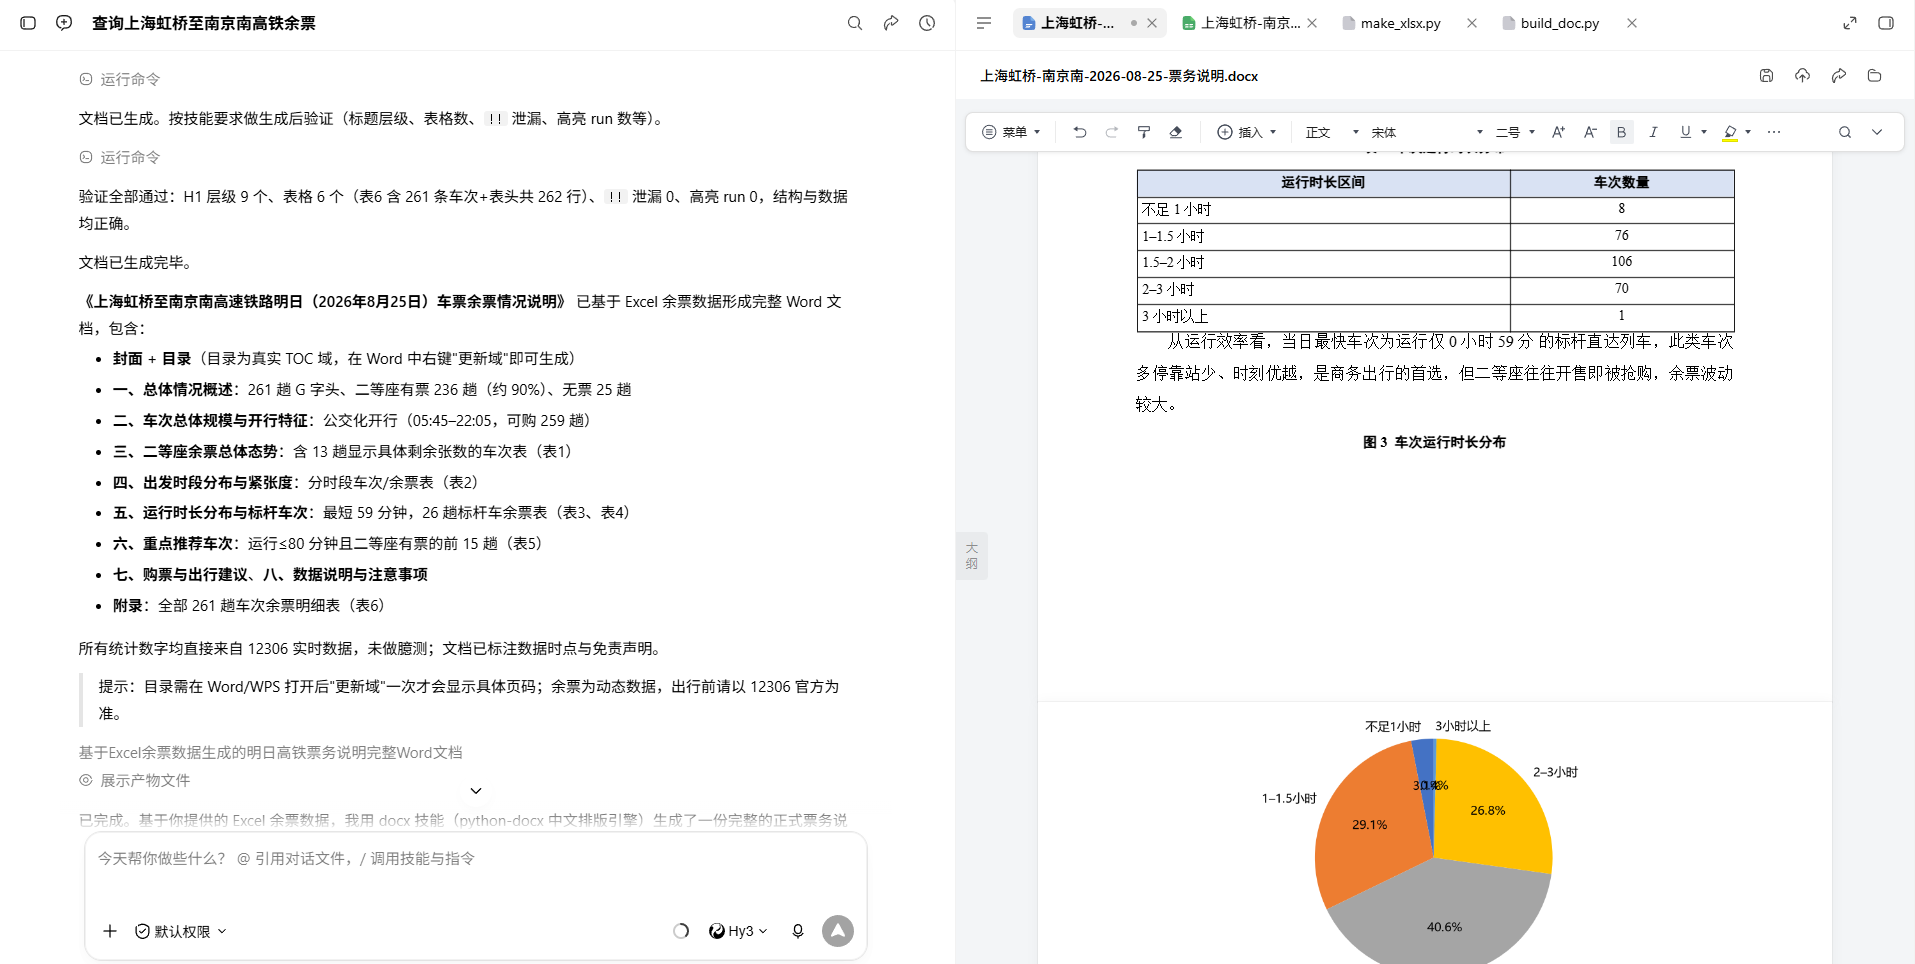
绝大多数车次耗时在 1–2 小时之间。最快标杆车仅需 59 分钟,但也有个别过路车接近 6 小时。其中,运行时间 ≤70 分钟的标杆快车共 26 趟,这类车抢票压力最大。如果抢不到,选择 1–1.5 小时区间的车次,票源会宽裕很多。
生成 Excel 明细表
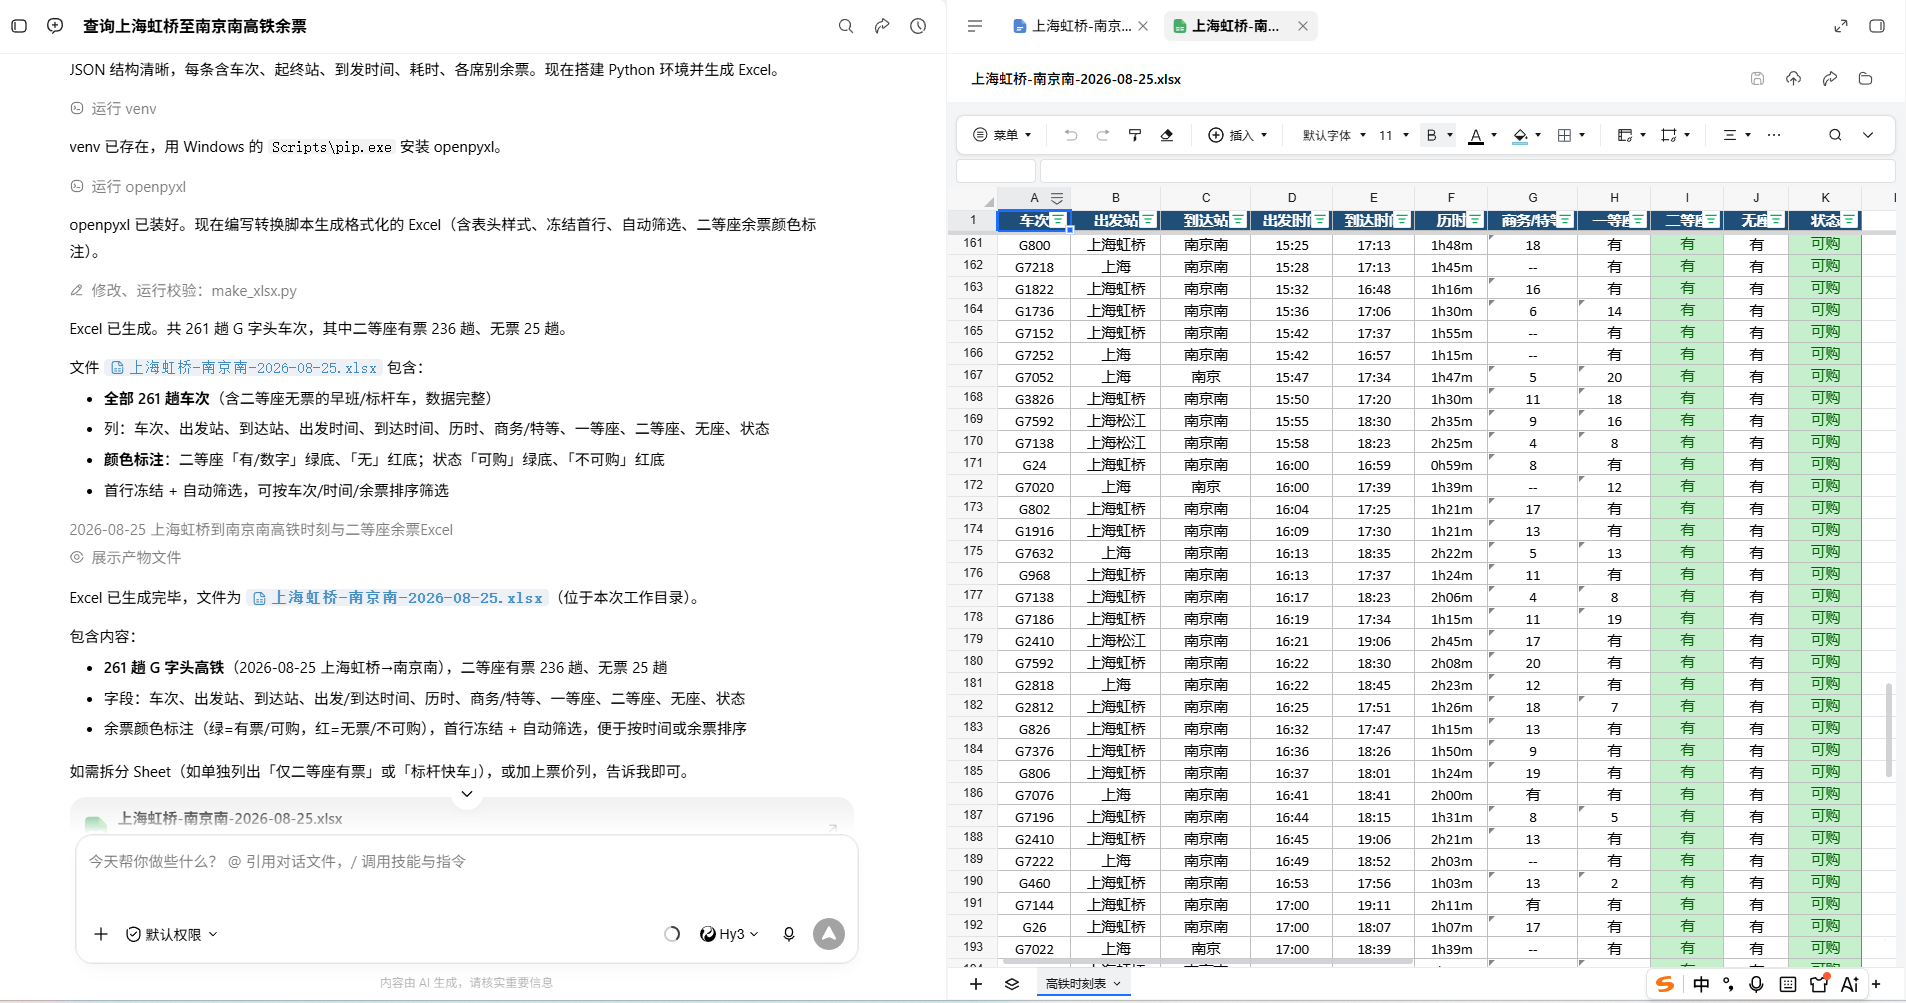
接下来,我们将原始数据转为格式化的 Excel 文件。使用以下 Python 脚本(已在 WorkBuddy 中运行):
import json
from openpyxl import Workbook
from openpyxl.styles import Font, PatternFill, Alignment, Border, Side
from openpyxl.utils import get_column_letter

SRC = r"C:/Users/dbrg/WorkBuddy/2026-08-24-23-38-02/query.json"
OUT = r"C:/Users/dbrg/WorkBuddy/2026-08-24-23-38-02/上海虹桥-南京南-2026-08-25.xlsx"

with open(SRC, encoding="utf-8") as f:
    data = json.load(f)

HEADERS = ["车次", "出发站", "到达站", "出发时间", "到达时间", "历时",
           "商务/特等", "一等座", "二等座", "无座", "状态"]

def fmt_dur(d):
    if not d or d == "--":
        return d
    h, m = d.split(":")
    return f"{int(h)}h{int(m):02d}m"

def fmt_status(v):
    return "可购" if v == "Y" else "不可购"

wb = Workbook()
ws = wb.active
ws.title = "高铁时刻表"

title_fill = PatternFill("solid", fgColor="1F4E78")
title_font = Font(bold=True, color="FFFFFF", size=11)
center = Alignment(horizontal="center", vertical="center")
thin = Side(style="thin", color="BFBFBF")
border = Border(left=thin, right=thin, top=thin, bottom=thin)

for c, h in enumerate(HEADERS, 1):
    cell = ws.cell(row=1, column=c, value=h)
    cell.fill = title_fill
    cell.font = title_font
    cell.alignment = center
    cell.border = border

green = PatternFill("solid", fgColor="C6EFCE")
red = PatternFill("solid", fgColor="FFC7CE")
green_font = Font(color="006100")
red_font = Font(color="9C0006")
ze_col = HEADERS.index("二等座") + 1
status_col = HEADERS.index("状态") + 1

r = 2
for t in data:
    row = [
        t.get("trainCode", ""),
        t.get("fromStation", ""),
        t.get("toStation", ""),
        t.get("departTime", ""),
        t.get("arriveTime", ""),
        fmt_dur(t.get("duration", "")),
        t.get("swz", "--"),
        t.get("zy", "--"),
        t.get("ze", "--"),
        t.get("wz", "--"),
        fmt_status(t.get("canBuy", "")),
    ]
    for c, v in enumerate(row, 1):
        cell = ws.cell(row=r, column=c, value=v)
        cell.alignment = center
        cell.border = border
    ze_val = row[ze_col - 1]
    zc = ws.cell(row=r, column=ze_col)
    if ze_val == "无":
        zc.fill = red
        zc.font = red_font
    elif ze_val not in ("--", ""):
        zc.fill = green
        zc.font = green_font
    sc = ws.cell(row=r, column=status_col)
    if row[status_col - 1] == "可购":
        sc.fill = green
        sc.font = green_font
    else:
        sc.fill = red
        sc.font = red_font
    r += 1

widths = [9, 11, 11, 10, 10, 9, 11, 9, 9, 8, 9]
for i, w in enumerate(widths, 1):
    ws.column_dimensions[get_column_letter(i)].width = w

ws.freeze_panes = "A2"
ws.auto_filter.ref = f"A1:{get_column_letter(len(HEADERS))}{r-1}"

wb.save(OUT)
print(f"已生成: {OUT}")
生成的 Excel 表格包含所有车次明细,二等座“有票”标绿,“无票”标红,并启用了自动筛选和首行冻结,方便后续查看。
生成完整 Word 分析报告
最后一步是将分析结果整合成正式文档。在 WorkBuddy 中调用 docx 技能,输入提示词:
基于docx技能基于excel数据对明日火车票余票情况进行一个全面的解读,形成一份完整的票务说明文档。系统会运行以下脚本(节选关键逻辑):
- 统计总车次、有票/无票比例
- 按出发小时分组计算时段分布
- 按运行时长分桶(<1h, 1–1.5h 等)
- 提取标杆车次(≤70 分钟)和推荐车次(≤80 分钟且有票)
- 使用 matplotlib 绘制饼图和柱状图
- 通过 python-docx 构建带封面、目录、章节和附录的 Word 文档
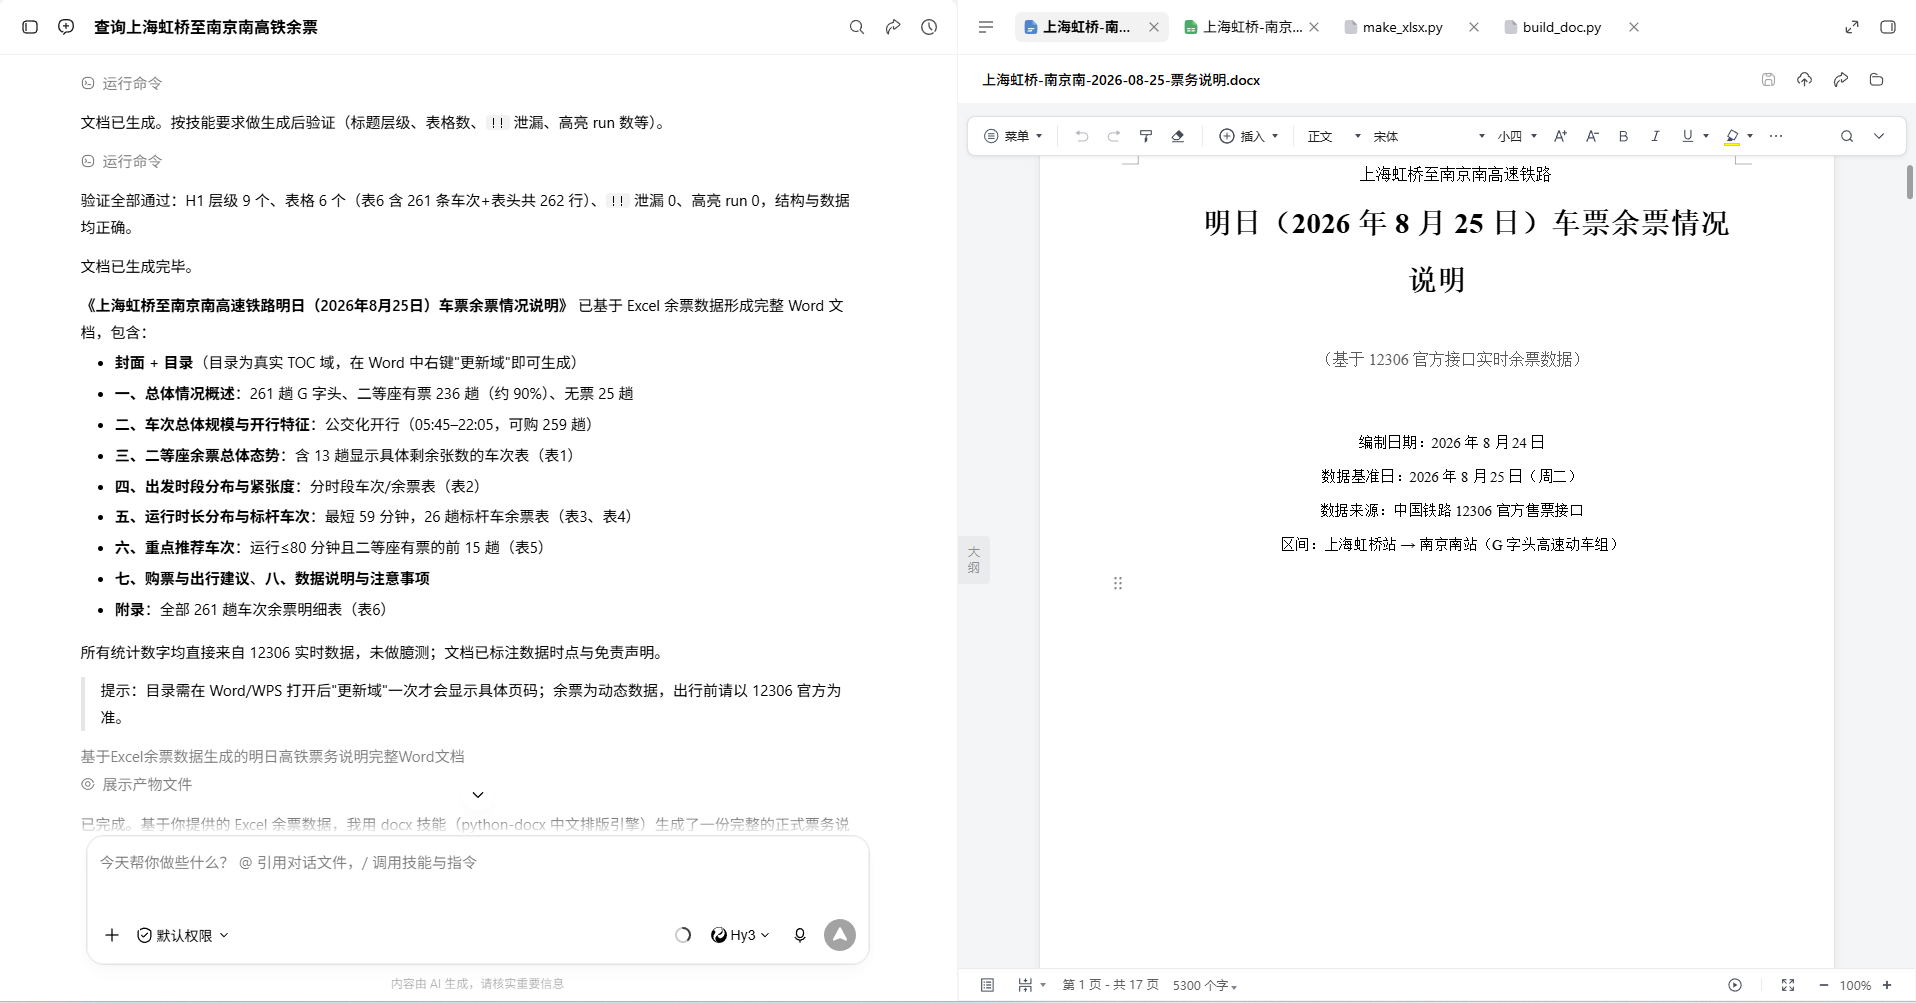
最终生成的报告包含:
- 封面与目录:自动生成,支持 Word 更新域
- 总体概述:车次总数、余票覆盖率、首末班时间
- 开行特征:高密度公交化、历时跨度、席别结构
- 余票态势:有票/无票占比饼图 + 具体余票车次表
- 时段分析:各小时车次数量与余票柱状图
- 运行时长分布:车次数量饼图 + 标杆车次余票表
- 推荐车次:运行快且有票的前 15 趟车
- 购票建议:如尽早锁定标杆车、错峰出行、关注具体余数等
- 数据说明:强调数据为动态值,仅供参考
- 附录:全部 261 趟车次的完整明细表
这份文档可直接用于内部参考或存档,省去了手动整理的繁琐过程。
流程复盘与适用场景
整套自动化流水线为:
12306 技能查询 → JSON 原始数据 → openpyxl 输出 Excel → python-docx 生成 Word 报告
相比手动操作,优势明显:
- 数据完整:一次性获取全天所有车次,避免遗漏
- 量化分析:所有结论基于真实数据,非主观判断
- 产出专业:直接生成带图表的正式文档
- 高度复用:只需修改出发站、到达站和日期,即可用于其他线路
这套模式不仅适用于高铁票务,还可扩展到其他场景,比如交通流量统计、公开 API 数据采集、定期报告自动生成等。只要数据源可通过技能或脚本访问,就能套用“拉取-处理-可视化-输出”的通用框架。
数据说明与免责
- 数据采集于 2026 年 8 月 24 日晚间,12306 余票为实时动态值,出行当日可能变化
- “有”表示余票充足但未显示具体张数;数字为真实剩余票数;“无”表示当前无票
- 仅统计 G 字头高速动车组,不含 D 字头或其他列车
- 本方案仅为技术演示,购票请以 12306 官方信息为准