Prompt 设计中的语义歧义陷阱与规避策略
语义歧义:Prompt 设计中最隐蔽的坑
很多人以为只要把需求“说清楚”,AI 就能准确执行。但现实是,哪怕你觉得自己写得明明白白,大模型仍可能跑偏——原因往往不是模型笨,而是你的 Prompt 里藏着语义歧义。
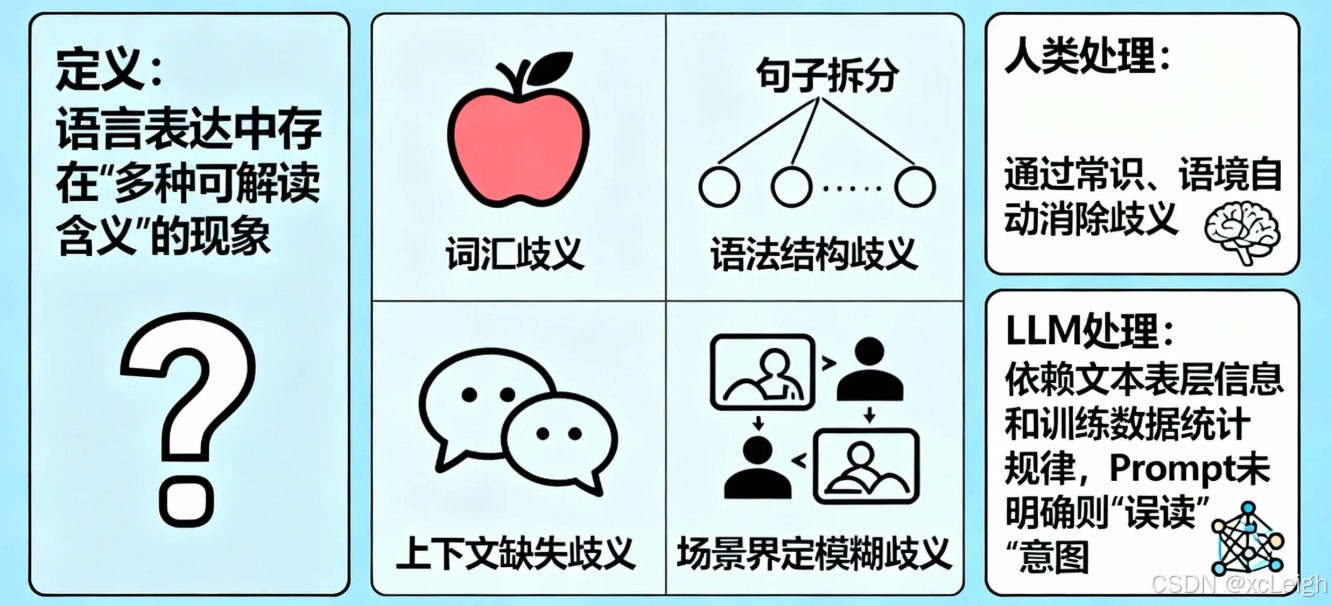
语义歧义指的是同一句话存在多种合理解读。人类靠常识和上下文自动消歧,但大语言模型(LLM)只能依赖文本表面信息和训练数据中的统计规律。一旦 Prompt 没把边界划清,模型就会按它“最熟悉”的方式理解,结果南辕北辙。
这类问题在实际使用中极为普遍:你让 AI 分析“苹果”的市场表现,它给你讲水果供需;你要求整理用户反馈并生成解决方案,它只列了问题没给对策;你说“优化方案”,它改得面目全非却自认完美。这些都不是模型能力不足,而是指令本身留了太多解读空间。
四类最常见的语义歧义
根据歧义来源,可归纳为以下四种类型,几乎覆盖了日常 Prompt 设计中的主要雷区。
词汇歧义:同一个词,多个意思
很多词天生多义。比如“苹果”可以是水果,也可以是科技公司;“表现”可以指销量、口碑或股价;“便宜”对学生和商务人士的标准完全不同。
典型失败案例:
请分析苹果的市场表现。
模型很可能默认“苹果”是水果,尤其当上下文没提科技或消费电子时。即使它猜对是 Apple 公司,“表现”具体指什么?营收增长?用户满意度?新品发布节奏?没有定义,输出必然泛泛而谈。
语法结构歧义:句子怎么断句?
中文不像英文有严格语法标记,长句容易产生不同切分方式。比如:
请生成关于上海和北京的旅游攻略及美食推荐。
这句话可以理解为:
- (上海)和(北京的旅游攻略 + 美食推荐)
- (上海 + 北京)的旅游攻略 +(上海 + 北京)的美食推荐
前者漏掉上海的美食,后者才完整。模型若按第一种理解,输出就缺了一半内容。
上下文缺失歧义:背景信息没给全
人类交流常省略“显而易见”的背景,但对模型来说,一切都要明说。比如:
请优化这个方案。
没说明是什么类型的方案(营销?技术?产品?),优化目标是什么(降本?提效?增转化?),当前痛点在哪(逻辑漏洞?执行难?)。模型只能按通用模板处理,结果往往不痛不痒。
指代歧义:那个“它”到底指谁?
代词在连续对话中很自然,但在单次 Prompt 里极易混淆。例如:
先对比 ChatGPT-4 和 Claude-3 的功能,再基于它的优势推荐适合客服的模型。
“它”是指 GPT-4?Claude-3?还是两者共性?模型若随机选一个,推荐理由就站不住脚。
歧义带来的实际后果
语义歧义不只是“有点偏差”,它会直接导致输出失效:
- 完全跑题:如把 Apple 公司误作水果品牌,整篇分析毫无价值;
- 内容残缺:因语法歧义漏掉部分任务,比如只做北京攻略没做上海;
- 逻辑矛盾:同时采用两种含义,比如既说“便宜=2000元以下”,又说“便宜=高性价比(可能3000元)”;
- 反复调试:用户不得不多次修改 Prompt 才能得到想要结果,效率大打折扣。
六个实操策略,精准避开歧义陷阱
要解决这些问题,核心思路是:把模糊变具体,把隐含变显性,把笼统变结构化。以下是经过验证的六项策略。
1. 定义模糊词汇:把主观词转为客观标准
“好”“优秀”“优化”这类词必须拆解成可衡量的维度。
错误示范:
写一篇好的社交媒体文案。
正确做法:
为面向25-35岁职场女性的便携咖啡机写小红书文案。“好”需满足:① 开头点出职场痛点(如“早上来不及买咖啡”);② 突出卖点(10秒出咖啡、体积小于保温杯);③ 结尾带互动引导和话题标签。
关键在于问自己:这个词的衡量标准是什么?能否量化或举例说明?
2. 明确场景背景:补全模型不知道的信息
必须交代清楚四个要素:时间、行业、目标人群、任务目的。
错误示范:
分析竞争对手的优势。
正确做法:
分析2024年Q3国内电商行业中,拼多多相对于淘宝在下沉市场的竞争优势,为我司制定差异化策略提供参考。
少了任何一项,模型都可能按默认假设处理,结果偏离实际需求。
3. 拆分多任务:用步骤化避免遗漏
多个任务混在一句话里,模型容易漏做或错序。应拆成编号步骤,每步明确输入、要求和输出。
错误示范:
整理用户反馈,提取问题、统计频次、生成解决方案,用表格呈现。
正确做法:
按以下步骤处理2024年Q1用户反馈(共1000条):
- 提取出现≥50次的高频问题;
- 统计每个问题的具体频次;
- 为每个问题生成1个可落地的解决方案;
- 输出为Markdown表格,列名:“问题”“频次”“解决方案”。
4. 避免代词:用具体名称替代“它”“该”
当前文涉及多个对象时,坚决不用代词。要么重复全称,要么明确指代。
错误示范:
对比A和B的功能,再基于它的优势推荐方案。
正确做法:
先对比产品A(便携咖啡机)和产品B(胶囊咖啡机)在价格、操作复杂度、咖啡豆兼容性上的差异;再基于产品A支持多种咖啡豆的优势,推荐适合家庭用户的使用方案。
5. 使用结构化格式:列表和表格更清晰
纯文字描述容易产生歧义,而结构化格式能强制模型识别任务边界。

错误示范:
写产品介绍,包含功能、价格、适用人群和购买链接。
正确做法:
为便携咖啡机写朋友圈介绍,包含以下四部分(每部分1-2句):
- 核心功能:10秒出咖啡、体积小于保温杯、USB充电;
- 价格:原价399元,现价299元(活动至10月31日);
- 适用人群:25-35岁职场女性、经常出差者;
- 购买引导:附链接和话题#便携咖啡机。
6. 添加反歧义约束:提前告诉模型“不要做什么”

对高频误解场景,直接在 Prompt 中设禁令。

错误示范:
分析苹果的市场份额,对比去年同期。
正确做法:
分析2024年Q3苹果公司(非水果)手机产品(非电脑/平板)在国内市场的份额,对比2023年Q3数据。注意:① 不包含其他产品线;② 数据需注明来源;③ 计算同比增长率。
实战演练:从模糊到精准的 Prompt 改造
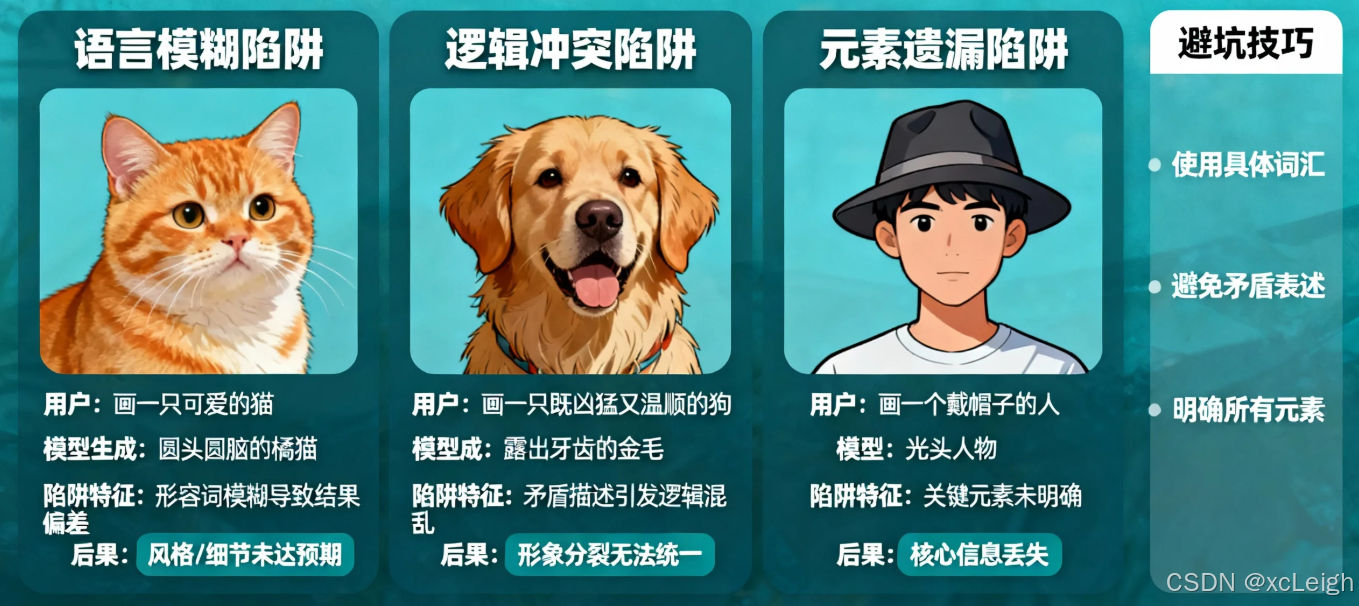
编程场景:生成 Python 代码

原始 Prompt:
写一段Python代码,处理数据,计算平均值,保存到文件里。
问题很明显:数据格式?处理什么?哪列求平均?保存为何种格式?
优化后:
按以下步骤处理学生成绩CSV文件(路径./students_scores.csv,含姓名、数学成绩、语文成绩):
- 删除任一成绩为空的行,剔除<0或>100的异常值;
- 分别计算数学、语文平均分(保留2位小数);
- 将结果(科目、平均分)存入./average_scores.csv; 要求:用pandas,加注释,处理文件不存在异常。
教育场景:生成小学练习题
原始 Prompt:
为小学生写一些数学练习题,难度适中,用于课后作业。
“适中”对一年级和六年级天差地别,“一些”到底是多少?
优化后:
为小学3年级(人教版)生成30分钟内完成的数学作业:
- 10道两位数×一位数计算题(无进退位,如25×3);
- 5道一步计算应用题(场景如超市购物); 输出:先列题目(分两类编号),后附答案(应用题写过程); 注意:不超3年级范围,场景贴近生活。
核心原则:精准化、结构化、场景化
总结起来,避开语义歧义的关键在于三点:
- 精准化:消灭模糊词,定义标准,杜绝代词;
- 结构化:任务拆步骤,要求列清单,输出定格式;
- 场景化:补全时间、行业、人群、目标等背景。
记住,好的 Prompt 不是“模型能看懂”,而是“模型不会误解”。当你把所有潜在歧义点都堵死,AI 的输出自然会贴合你的预期,调试成本也会大幅降低。
下次写 Prompt 前,不妨用这个自查清单快速扫描:有没有模糊词?场景是否完整?多任务是否拆分?代词是否明确?输出格式是否指定?常见误解是否设防?花两分钟检查,可能省下半小时返工。