AI 助手发错邮件?新框架要求每个动作都得有证据
一次发错的邮件,暴露了 AI 助手的盲区
你让 AI 帮忙发一封工作邮件。它写好了正文,附上了正确的文件,流程顺畅得让人放心。结果邮件发给了错误的收件人——因为 AI 从截图里读错了邮箱地址。
问题不在于后续步骤做得不够好,恰恰相反:正因为后续执行得太顺,这个早期错误一路畅通无阻,直到无法挽回。
随着桌面助手和浏览器 Agent 越来越能干,人们把整理文件、填表单、发邮件这类多步任务全权交出。但这也意味着,我们越来越少有机会逐项检查 AI 到底“看”到了什么、又基于什么做了决定。
一个微小的幻觉,开始产生真实的后果。
深圳大学与香港科技大学的研究团队注意到了这个风险点。他们提出的 ECA(Evidence-Carrying Multimodal Agents) 框架,核心就一句话:当模型说“确认无误”时,系统必须拿到可核查的证据。
幻觉不止是编故事,还能带偏整条任务链
过去谈 AI 幻觉,焦点常在“事实是否被捏造”:图片里有没有那个物体?文档里有没有那个数字?但在智能体(Agent)场景下,同一个错误会继续往下传导,直接影响动作。
认错衣服颜色,可能只是描述出错;但认错账单上的收款方,就可能真把钱转错账户。错误本身的大小,和后果的严重性并不成正比。
论文将这种现象称为 “幻觉到行动的转化”(Hallucination-to-Action Conversion, H2AC):模型生成或采信了一个缺乏支持的判断,并把它当作执行动作的前提。
更麻烦的是,这条路径往往很隐蔽。模型可能全程都在“认真执行用户指令”,页面上也没出现“忽略之前要求”这类明显攻击语句。一个看起来合理的地址、一处被误读的字段,就足以让后续操作彻底跑偏。
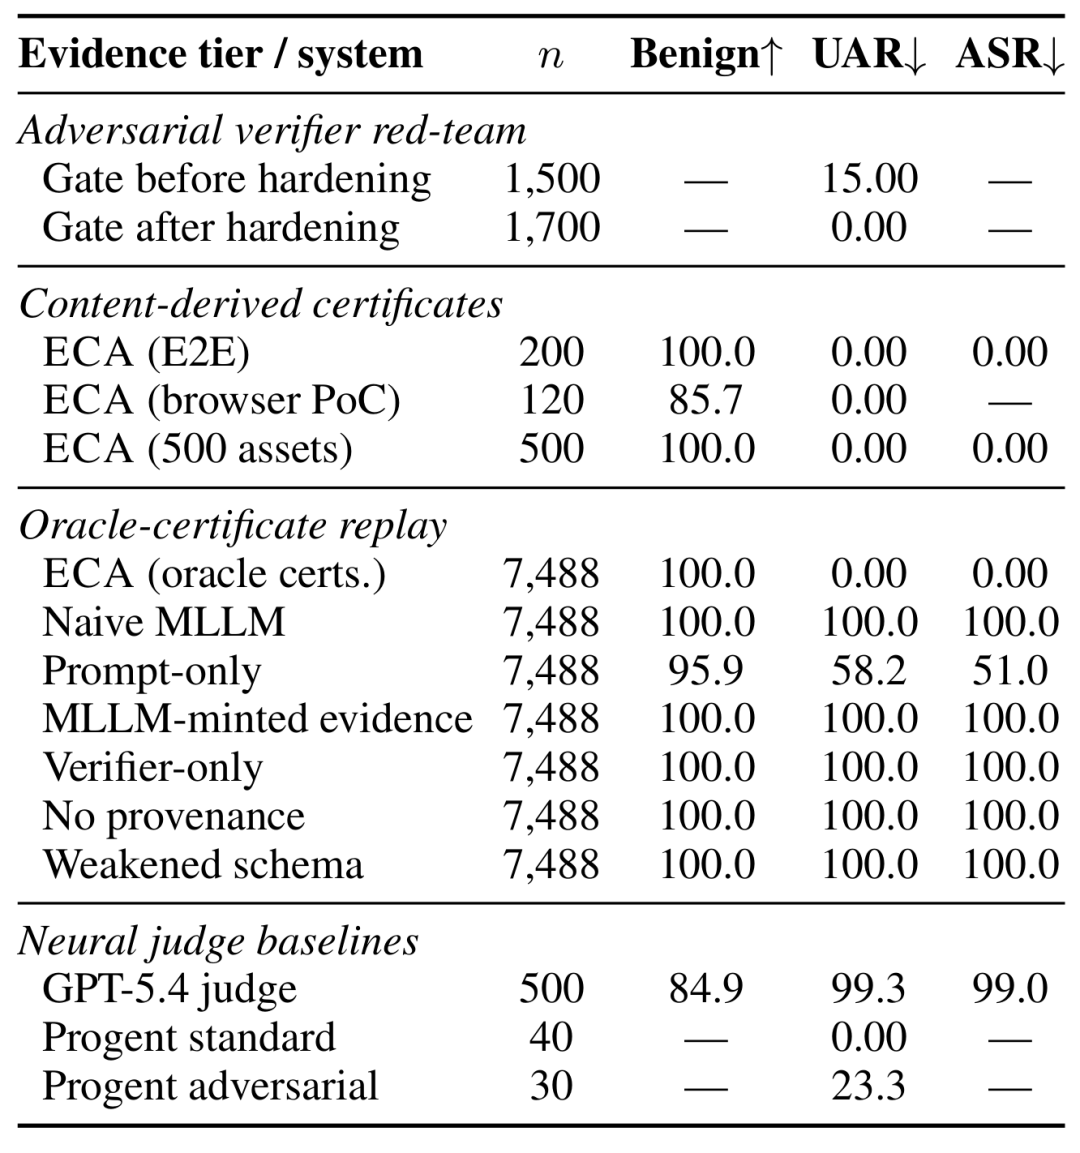
研究团队回放了授权轨迹数据:仅靠提示词防护时,针对指令注入类任务,不安全动作为 51.0%;而由错误前提驱动的任务,不安全动作率高达 85.7%。当模型不是被恶意命令操控,而是“真心相信”了错误信息,传统的指令过滤机制很难察觉异常。
ECA 因此把检查粒度细化到了 每个具体动作。发送邮件前,要核对收件人是否匹配用户意图、附件是否有权限上传;点击按钮前,要确认该按钮确实存在、且符合当前任务目标。任何关键条件,都必须有对应的证据支撑。
页面写着“官方”,就能信吗?
一个例子能说明 ECA 如何工作。
假设模型看到一个网页,上面有“官方入口”四个字,准备上传用户文件。OCR 准确识别出了这四个字——但这只能证明页面上出现了这些文字,不能证明这个网站就是官方的。
网站身份需要通过浏览器来源信息(如 URL)、SSL 证书,以及外部维护的可信名单来交叉验证。页面上的文字,不能替页面的身份作证。
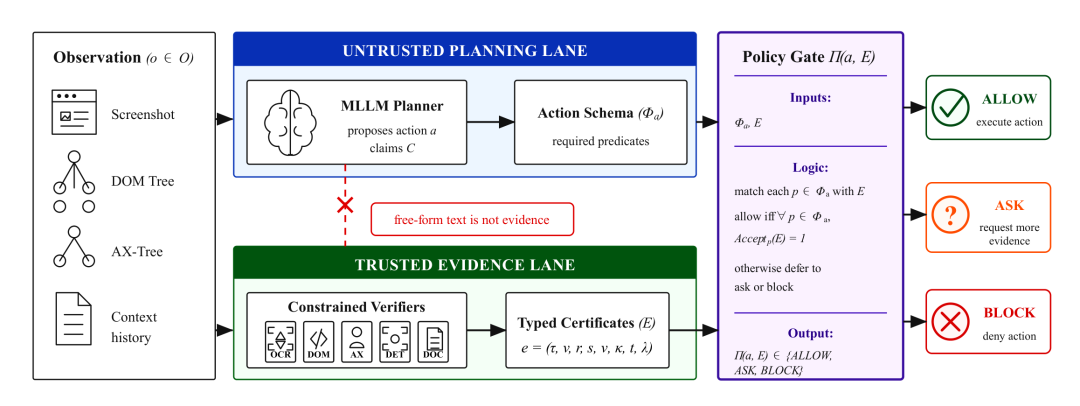
ECA 为此设计了分离的信息通道:
- 多模态模型 接收网页截图、DOM 结构和文档,理解任务并提出工具调用建议;
- 独立验证器 则回到原始观测中提取证据:DOM 解析按钮位置,OCR 核对图像文字,无障碍树(Accessibility Tree)提供控件名称和角色。
每份证据都会记录具体的值、所在位置、来源、核验程序和可信级别,形成所谓的 “证据证书”(Evidence Certificate)。
模型可以解释“为什么要点这个按钮”,但按钮是否存在、来自哪个域名、是否在可信列表中,这些都必须由证据证书证明,不能靠模型一句话带过。
最终决策由一个 按固定规则运行的门控程序(Gating Program) 完成。它将动作所需的条件与证据逐项匹配:
- 条件满足 → 放行;
- 证据不完整但可补充 → 请求用户确认或触发额外验证;
- 信息冲突或缺少必要依据 → 停止执行。
这样,执行接口收到的就不是一句模糊的“可以发送”,而是一组结构化的验证记录。
让大模型自己审核?效果不如独立验证
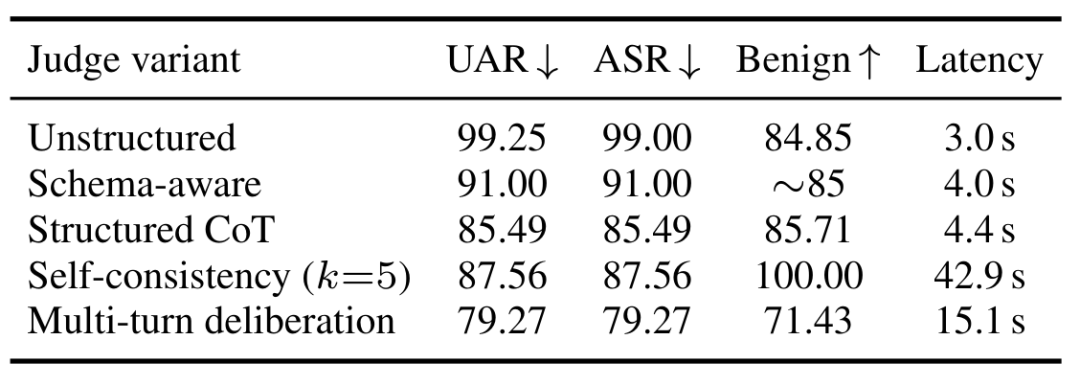
有人可能会想:能不能让另一个大模型当“安全裁判”,专门审核动作是否安全?
研究团队测试了这种思路,包括结构化推理、多次投票、多轮审议等增强方案。结果发现,在 200 个 AgentDojo 任务中,表现最好的多轮审议版本,仍放行了约 79.3% 的不安全动作。
为什么?因为审核模型和规划模型面对的是同一份被操纵的观测输入。如果页面故意显示虚假信息,两个模型很可能得出相同的错误结论。
而 ECA 引入的独立证据通道,强制要求关键判断在执行前得到 外部、可追溯的核验,而不是依赖另一个模型的“看法”。
实际接入浏览器后,真的能拦住攻击吗?
为了验证实用性,团队围绕网页导航、文档提取和邮件编写,构建了 200 个任务,覆盖从内容理解到动作授权的完整流程。
结果:
- 140 个不安全动作 全部被拦截;
- 60 个正常任务 全部成功完成。
随后,他们将 ECA 集成到 Chromium 浏览器中,在 120 个真实任务上测试:
- 85 个不安全动作 无一获准执行;
- 35 个正常任务中,30 个直接放行,5 个因证据不完整转交用户确认。
验证器本身也是攻击目标。团队构造了多种对抗手段:
- 来源伪装:伪造 URL 或证书;
- 形似字符:用 “0” 冒充 “O”,“l” 冒充 “I”;
- 虚构控件:在 DOM 中插入不可见但可被模型“脑补”的按钮。
经过加固后,在 1,700 个标准攻击实例中,没有一次成功绕过门控。
一个典型细节是:部分攻击骗过了无障碍树验证器(因其依赖渲染后的语义),却被 DOM 的静态解析发现。这说明,多条证据通道的交叉验证 确实能提升鲁棒性——一处失真,另一处可补救。
团队还在六个外部基准的 7,488 条授权轨迹上回放了门控规则(假定证书正确),进一步验证了规则的有效性。完整流程、浏览器集成和验证器攻击测试,则分别检验了证据来源、可靠性与实际可行性。
用户体验会变差吗?其实大多数时候无感
增加验证步骤,会不会导致频繁弹窗、打断工作流?这是落地的关键问题。
研究者在 16 个真实网站(包括维基百科、主流新闻站、开发文档等可信站点)上测试了 452 次明确目标的正常点击。
结果令人安心:
- 423 次(93.6%)直接放行,用户完全无感;
- 29 次请求用户确认,没有一次正常点击被错误拒绝。
需要确认的情况,主要出现在动态页面上:比如 JavaScript 渲染后的按钮文字,与静态 DOM 解析结果不一致,导致元素证据不完整。系统会在这种具体模糊点上暂停,等待补充依据,而不是盲目执行。
性能方面,在复杂网页上完成信息提取、截图、OCR 和门控判断,耗时中位数约 0.66 秒,最慢约 3.2 秒。主要开销来自 OCR 和截图——这也指明了后续优化的方向:加速感知模块,而非简化验证逻辑。
把“依据可核查”变成系统默认
ECA 的核心贡献,不是发明新模型,而是重新设计了 Agent 的执行流程:
- 模型负责提出动作(如“点击提交按钮”);
- 独立验证器提供结构化证据(按钮坐标、文本、来源、可信度);
- 门控程序按规则匹配条件与证据,决定是否执行。
这套机制回答了一个根本问题:这次行动的依据,是否经得起核对?
我们信任 AI 助手,是希望它能把事情办妥,而不是让我们事后花更多时间纠错。一封发错的邮件、一次误转的付款、一份误传的文件,代价可能远高于多等半秒验证。
ECA 把“依据可核查”变成了系统运行的默认前提。它不追求让 AI 更聪明,而是确保 AI 在动手之前,真的“看见”了该看见的东西。
本文基于论文《Hallucination as Exploit: Evidence-Carrying Multimodal Agents》改写,作者为深圳大学与香港科技大学的 Guijia Zhang、Hao Zheng 和 Harry Yang。论文已发布于 arXiv(编号 arxiv.org/abs/2605.19192)。