7名博士生用3个月从零训练7B大模型,全流程开源
七个人和一个暑假:从零训练7B模型
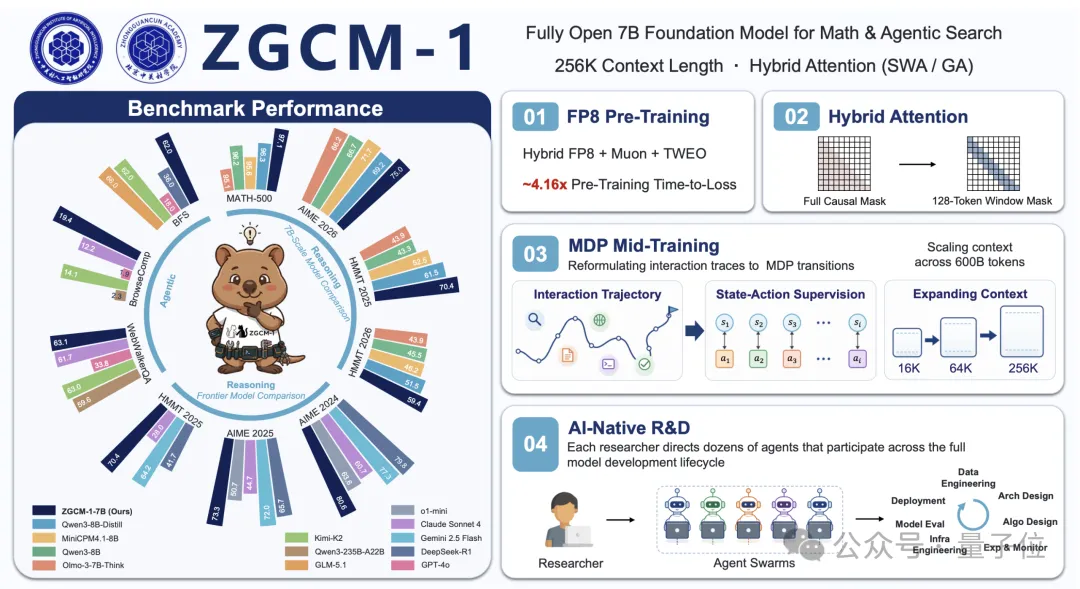
2026年夏天,北京中关村学院的七名博士生做了一件看起来不太可能的事:用三个月时间,从零开始训练出一个70亿参数的大语言模型——ZGCM-1。更特别的是,他们不仅发布了模型权重,还把整个训练过程中的代码、数据配方、中间检查点、日志和评测结果全部公开。
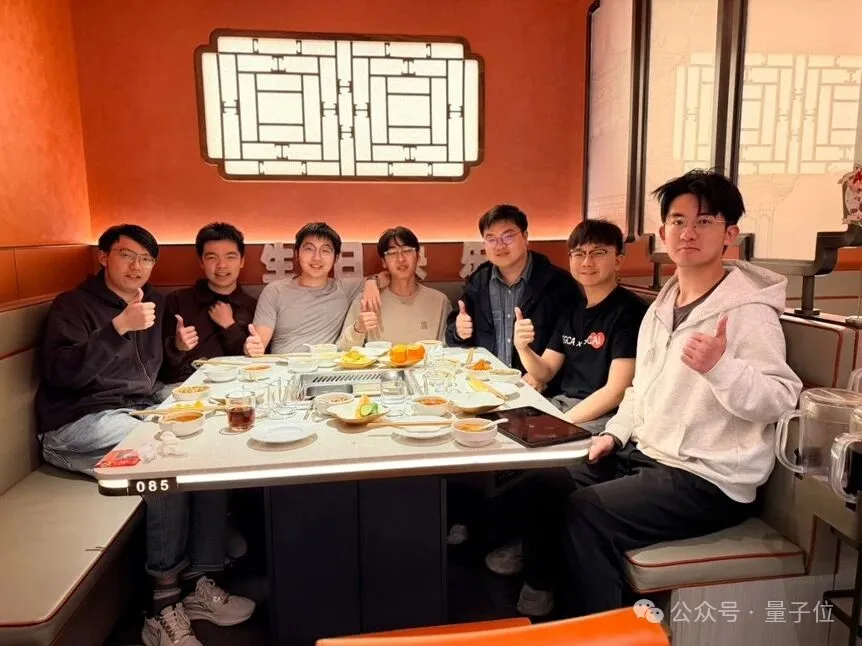
这支小团队背景多元:两人主攻人工智能,两人专注网络系统,另外三人分别来自化学、生物和网络安全方向。平时他们多在现有模型上做微调,但总有些问题光看技术报告解不开——比如“数据清洗”这四个字背后到底有多少工程细节?训练失败时,到底是数据问题、超参问题,还是框架bug?
一次火锅聚餐上,大家聊起这些困惑,干脆决定自己动手训一次。最初甚至想用7B模型挑战Sonnet这类闭源强模:参数不够,就让模型“多想一会儿”,学会主动搜索和调用工具。想法很朴素,没人知道能走多远,但他们想留下完整记录,给其他同样好奇的研究者提供参考。
几百个Agent组成的“虚拟团队”
真正开始后,他们很快意识到工作量远超预期。数据要清洗、去重、校验分布;训练要调参、监控、排查故障;评测要设计指标、跑对比、分析短板。每一项在大厂都对应一个专项团队,而他们只有七个人。
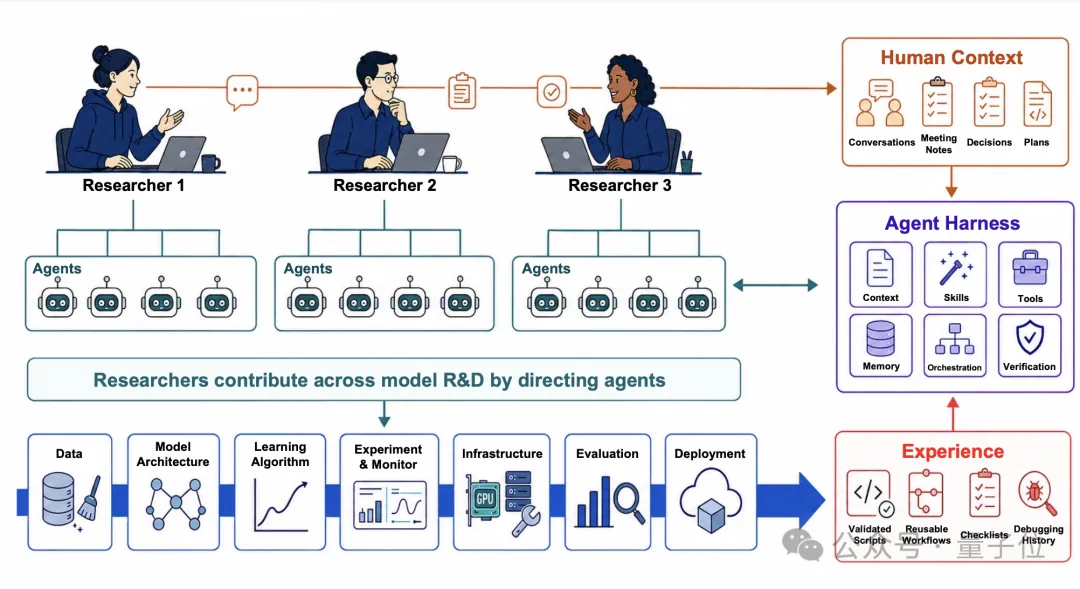
于是,他们给自己组建了一支由数百个AI Agent组成的“虚拟团队”。通过自研的ZGent平台,这些Agent被分成数据组、实验组和评测组,能自动接任务、汇报进展、沉淀经验。
在数据处理环节,Agent能根据人设定的质量标准编写清洗脚本,检查token分布是否符合预期,并动态调整规则。比如发现某类低质量网页文本占比异常升高,会自动收紧过滤阈值。在训练阶段,Agent不仅能提交任务、监控loss曲线,还能主动识别I/O瓶颈,优化数据加载流程,提升吞吐量。
研究者则聚焦更高层的工作:定义目标、设定约束、做关键决策。日常变成了“把问题讲清楚—分配任务—回来检查结果”的循环。这种人机协作模式,正是当下热议的“AI for AI”(AI4AI)研发范式。
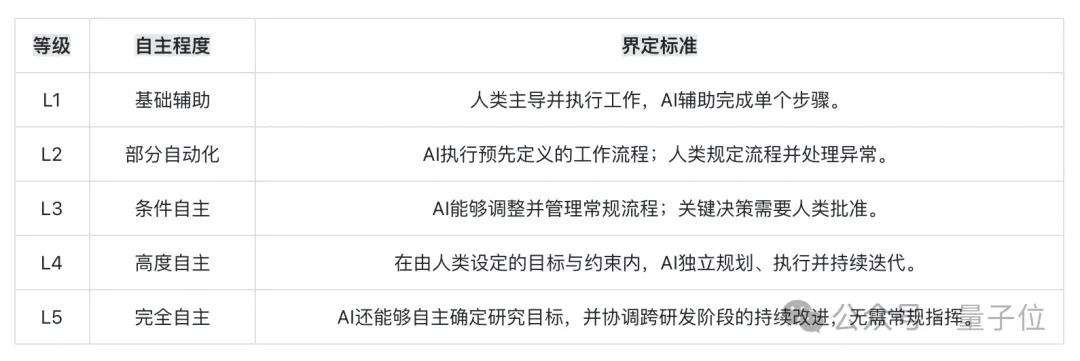
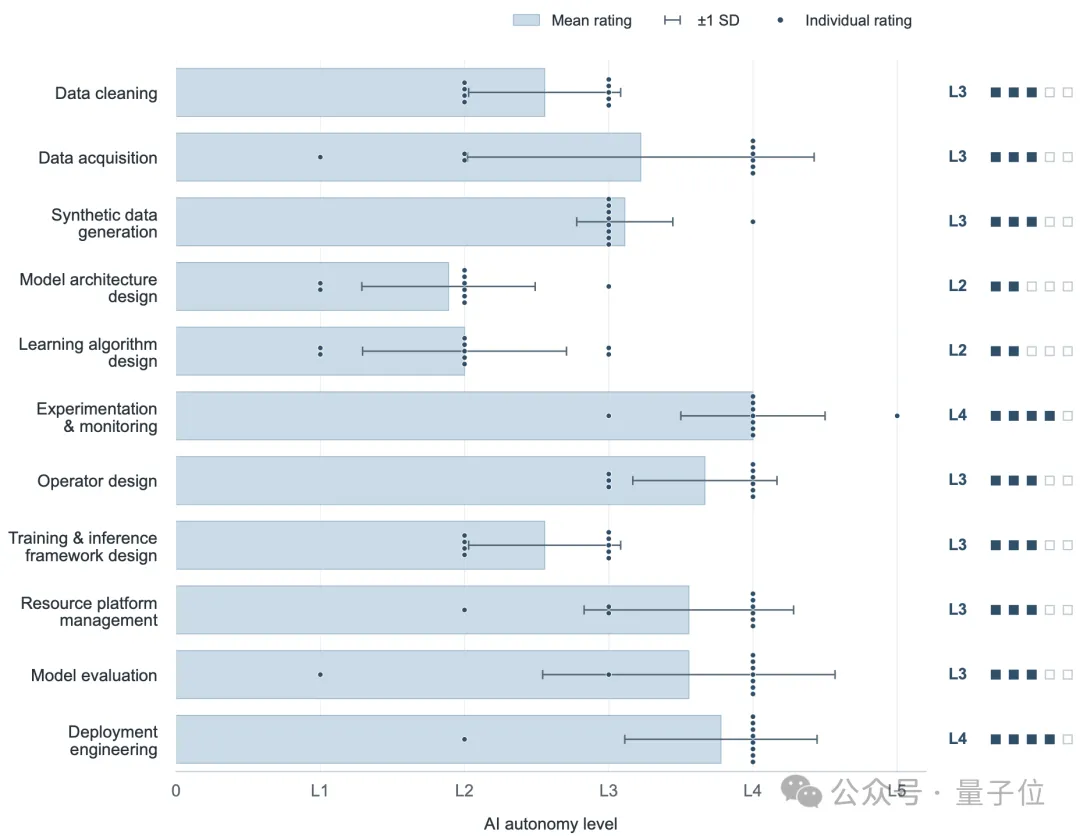
团队后来对11类研发任务做了自主性评级(L1-L5)。结果显示,实验监控和部署已达到L4(Agent可独立规划执行并迭代),但模型架构设计仍停留在L2(主要辅助实现已有方案)。核心判断和研究方向,依然需要人类主导。
loss下降,能力却退步了?
有了Agent帮忙,该踩的坑一个没少。有一次训练看似正常,loss持续下降,但模型在数学和代码任务上的表现却突然变差。团队花了几天排查,最终发现问题出在底层数据分片和shuffle逻辑:实际送入训练的数据比例发生了偏移,模型吃到的“配方”和预设不一致。
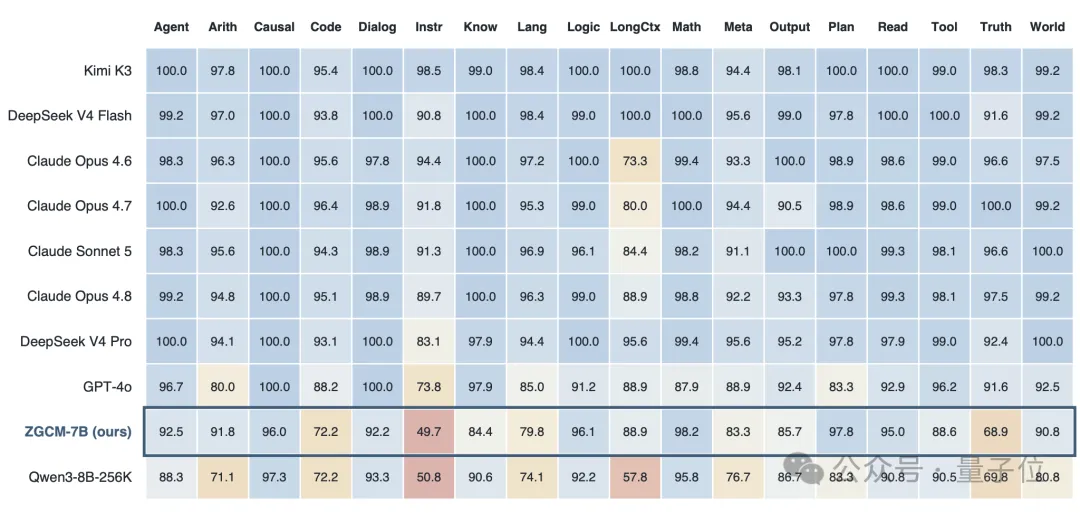
这次教训让他们不敢再只盯loss。他们开始高频保存checkpoint,并构建了ACE(Atomic Capability Evaluation)原子能力评测体系,将模型能力拆解为18大类、183项子能力,用2503个探针进行细粒度检测。在内部分布式评测系统中,一轮完整诊断只需两三分钟,能快速定位“哪里变好、哪里退步”,指导下一步是查数据还是调训练策略。
训练到中期,他们让模型写一首歌,它真的生成了一段押韵的歌词。虽然用现成模型也能做到,但看着自己从随机初始化开始训练的模型产出内容,感受完全不同。那天晚上,团队回到最初吃火锅的店,又庆祝了一次——那个不确定的想法,终于有了看得见的进展。
省下的算力,用来多试几个想法
整个项目让他们对“研究效率”有了新理解。过去做实验常盯着某个分数能否再提一点,现在每卡时都珍贵,必须问:同样的算力,怎样验证更多假设?
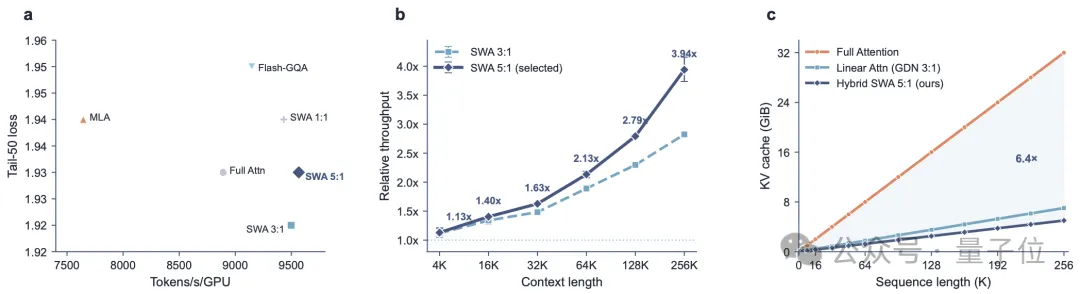
最初设想的“小模型多想一会儿”面临工程挑战:长推理、搜索和工具调用会不断累积上下文,既要容纳信息,又不能成本太高。团队采用局部注意力+全局注意力的混合架构,训练中逐步将上下文从16K扩展到256K。相比全注意力方案,在256K下吞吐提升3.94倍,KV Cache占用降至约六分之一。
他们还结合Muon优化器和FP8低精度训练,并引入延迟缩放(delayed scaling)与TWEO(Tail Weight Exponential Outlier suppression)抑制极端激活值,提升训练稳定性。整套方案在16K预训练中达到相同loss的效率,比标准BF16/AdamW基线高4.2倍。省下的时间和算力,直接投入了下一轮实验。
在SFT阶段,他们发现更严格的数据筛选(样本减少44.9%)反而提升了整体表现,尽管不是所有能力同步受益。长思维链数据比例过高会损害指令遵循能力,而纯Agent交互数据若脱离通用语料单独训练,效果也不理想。这些经验,都是反复实验修正后才得出的。
开源的不只是模型,更是建造过程
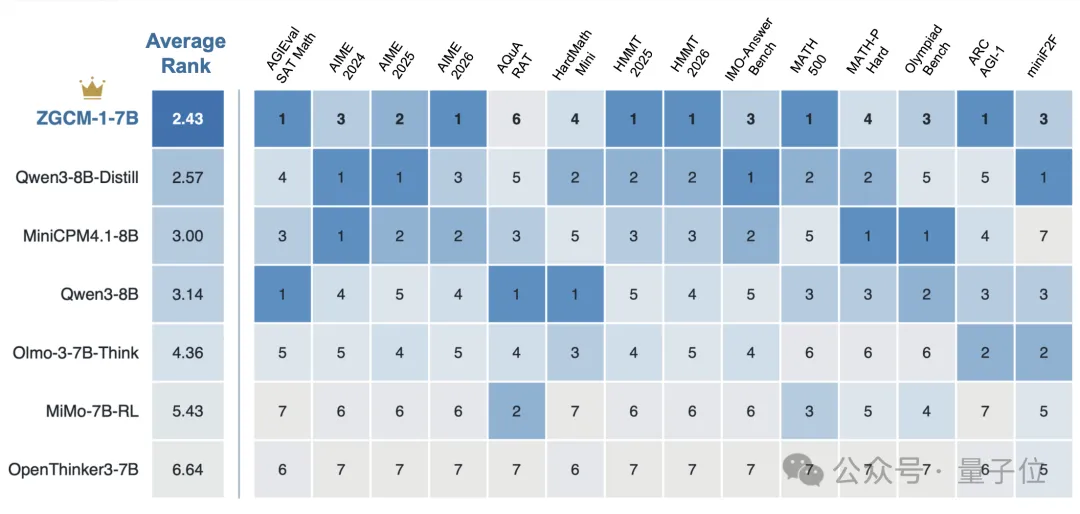
最终,ZGCM-1在14项推理评测中与Qwen3-8B等同规模模型表现相当,部分搜索和工具调用任务甚至接近Qwen3-235B-A22B、GLM-5.1等更大模型的水平。
但团队更在意的是过程的可追溯性。他们公开的不仅是最终权重,还有各阶段数据配比、训练代码、中间checkpoint和日志。这让其他研究者能复现整个流程,看清能力是如何一步步形成的——比如某个数据清洗规则调整后,数学能力为何提升而常识问答却下滑。
如今,他们已开始尝试400B、500B规模的模型。7B阶段验证的方法论能否平滑扩展?几百个Agent又能承接多少新增工作?这些问题,他们会继续在实验中寻找答案,并像这次一样,把过程记录下来。
最初那顿火锅上聊出的想法,还在往前走。