Meshy:用服务化架构解耦大模型强化学习训练流程
同步 RLHF 的时代与 Single-Controller 的兴起
早期的大模型强化学习(RLHF)训练高度依赖同步流水线。以 PPO 为例,一轮训练通常按固定顺序执行:先用当前策略生成一批回答(rollout),再由奖励模型打分,计算优势函数,最后更新策略参数。整个过程有三个鲜明特征:阶段间显式同步、控制流固定可预测、轨迹一次性生成无需跨轮维护状态。
这种“单一全局进度”的特性,恰好被 Single-Controller 架构完美契合。Google 的 Pathways 和后来的 verl 框架采用这一思路:用一个中央进程(controller)编写顺序程序,把 Rollout、Inference、Trainer 等分布式组件封装成可调用对象。每次函数调用背后,是 controller 向所有 worker 发起远程调用、收集结果并合并。函数返回即代表该阶段完成,循环计数器自然对应策略版本。
在中小规模同步训练中,这套设计几乎无额外开销——一次 rollout 动辄数秒,controller 的调度成本微不足道。更重要的是,它实现了算法与基础设施的解耦:改算法只需动 controller,换引擎只需改 worker;出问题时,顺着单个调用栈就能定位到具体阶段和 batch。配合 hybrid engine 实现训推共置,硬件利用率也更高。因此,它长期被视为同步 RLHF 的工程标杆。
Single-Controller 在异步时代的困境
但当 RL 负载走向异步生成、持续训练或多轮 Agent 交互时,“单一全局进度”假设就崩塌了。系统里可能同时存在多个策略版本的样本、停在工具调用上的轨迹、以及消费旧数据的训练任务。此时,Single-Controller 的结构性缺陷开始暴露:
首先,controller 成为数据通路的单点瓶颈。所有轨迹、log prob、advantage 都要流经中央进程,其带宽和内存限制了系统扩展能力。其次,每次调用都需全局 fan-out 并等待最慢 worker 返回,输出长度差异越大,算力浪费越严重。第三,原本寄存在程序结构里的状态(如策略版本、轨迹进度)无法表达复杂场景,若强行塞入 controller,顺序程序会退化成手写的状态机,背离初衷。最后,异步能力只能作为主流程外的并行分支接入,难以深度整合。
社区演进也印证了这一点。verl 引入 TransferQueue 让数据绕过 driver 直达消费者,slime 将推理端做成独立 HTTP 服务,controller 代码缩减到百行以内。这些框架自己就在一步步剥离数据传输、推理服务和异步驱动——这自然引出一个问题:如果这些职责都已独立,是否还需要保留中央控制器?
Meshy:一切皆服务
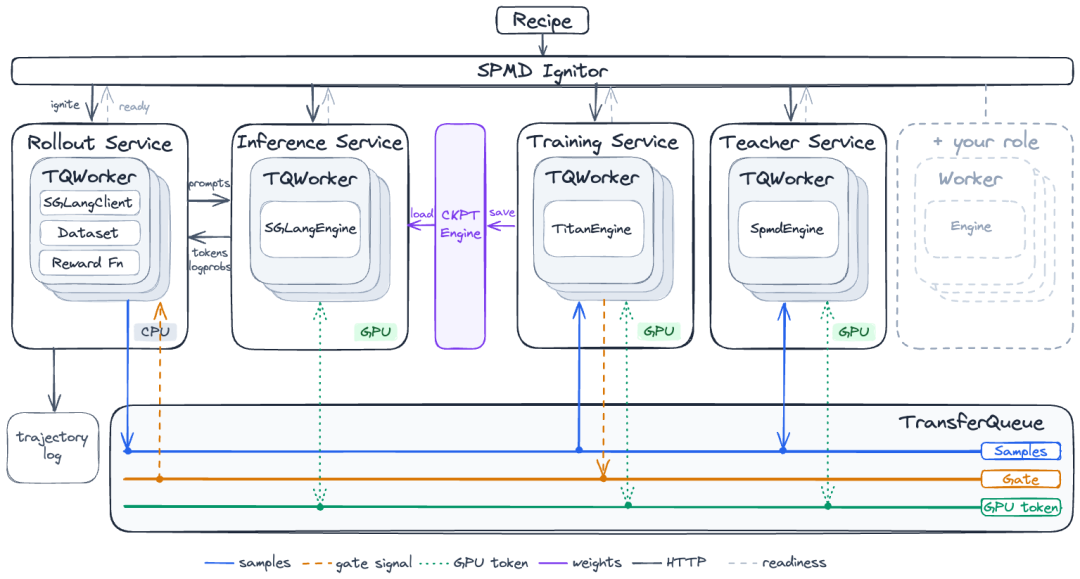
Meshy 给出的答案是彻底抛弃中央控制器,将系统建模为一组通过精简接口协作的独立服务。它基于 TorchTitan 和 SGLang 实现完整 RL 与蒸馏训练,不依赖 Ray,也没有中央调度器。服务间仅通过三种机制协作:统一数据队列 TransferQueue、控制生成节奏的 gate 信号、以及少量用于健康监测的 HTTP 管理端点。
其设计围绕两个目标:一是尽可能降低通信和调度开销,二是让开发者能自由组合不同组件。为此,Meshy 定义了 Service 和 ServiceGroup 抽象。每个角色(Inference、Training、Rollout、Teacher)都是一个 Service,在 recipe 中以 DataClass 声明。ServiceGroup 描述一组同类型服务实例的配置,包括 ID、副本数、GPU 数等;ColocationRing 则定义哪些 ServiceGroup 可共置在同一组 GPU 上。
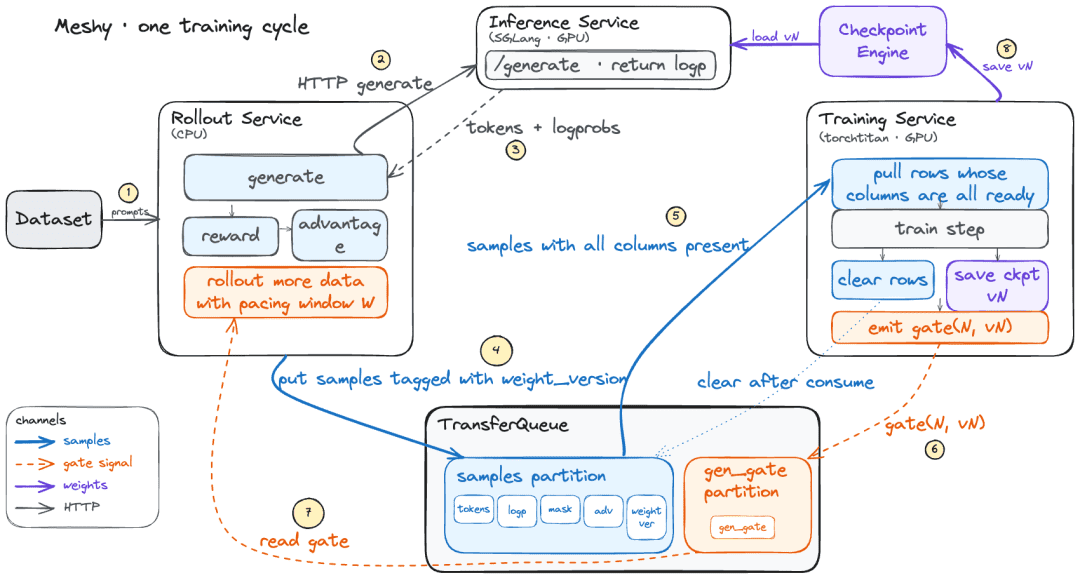
例如,一个 OPD(在线策略蒸馏)训练拓扑可能包含:一个 Rollout 服务生成候选回答,一个 Teacher 服务用大模型打分,一个 Trainer 服务更新学生模型。它们通过 TransferQueue 连接:Rollout 写入 token 和 logprob 列,Teacher 读取后写回 score 列,Trainer 声明需要 token、logprob 和 score 三列,只有当一行数据齐全时才会被拉取。数据本身驱动流程推进,无需显式握手。
确定性拓扑推导:无需注册中心
服务化架构通常需解决服务发现:每个服务在哪台机器、用哪个端口?常见方案依赖注册中心或配置文件,增加运维负担。Meshy 采用更简单的方法:用纯函数计算拓扑。
系统以 SPMD 方式启动:一条 torchrun 命令在每张 GPU 上运行一个 ignitor(启动进程)。ignitor 不参与计算,只负责推导拓扑并拉起本卡分配的服务。启动时,所有 ignitor 通过 all-gather 获取全局 GPU 列表(主机名和 rank),然后各自独立执行同一个确定性函数:输入是服务声明列表和 GPU 列表,输出是每个服务实例的部署信息(使用哪些 GPU、位于哪台主机、服务地址和端口)。
端口根据副本主卡 rank 按固定规则计算,只要输入相同,每个 ignitor 得到的拓扑就完全一致。因此,Meshy 无需注册中心,也无需进程间传递地址;没有运行时任务派发,ignitor 只启动分配到本卡的服务。这种方式不仅减少组件,还提升可复现性:同一 recipe 在相同 GPU 拓扑下部署结果一致;端口冲突、GPU 不足等错误也能在启动阶段暴露。
数据流与控制流:TransferQueue 的核心作用
Meshy 的协作机制建立在 TransferQueue(TQ)之上。TQ 是一个独立开源的后训练数据系统,可理解为若干固定容量的样本表。每张表是一个 partition,样本是表中的一行,行上是一组命名的数据列(如 token、logprob、advantage)。不同角色可向同一行补写不同列。
TQ 由两类进程组成:controller 只记录元数据(哪些列已生成、被谁消费过),storage 保存实际 tensor。消费者先向 controller 查询就绪行(仅传元数据),再直接从 storage 拉取数据。大块 tensor 不经过任何中间进程,避免了中心化瓶颈。
在数据面,Meshy 使用 TQ 分区在角色间传输数据。每个角色在 recipe 中声明消费的分区和列,启动后轮询 controller 获取就绪样本。计算完成后,将结果写回 TQ 供下游消费。末端消费者销毁样本,防止存储无限增长。
在控制面,同步信号也通过 TQ 传递。例如同步 RL 中,Trainer 每步结束后在 gen-gate 分区写入最新权重版本,Rollout 读取该信号决定生成节奏。这种设计遵循两项原则:tensor 不经过编排进程,同步只依赖简单控制信号。开发者可通过观测 TQ 信号掌握全局状态,判断事件是否丢失或乱序。
多角色共置:基于令牌环的动态资源调度
GPU 拓扑是 RL 训练的关键效率决策。Meshy 将其完全交给声明式配置:服务只需描述所需 GPU 能力及共置关系。分离部署时,角色用不同 GPU 并行运行;共置部署时,多个角色共享同一组 GPU,按需交替获得使用权。
为支持任意数量角色共置,Meshy 开发了基于令牌环的机制。每个服务将 GPU 代码放在上下文中,并提供显存释放/恢复接口。当服务运行到 GPU 上下文时,向令牌环提交请求。只有获得 GPU 令牌的角色才能继续执行:系统先调用其显存恢复接口加载状态,执行计算,完成后调用释放接口清理状态,并将令牌移交环中下一个等待者。
令牌请求与授予通过 TQ 实现:请求时新建一行,授予时在该行标记。若无请求者,令牌会传给 Inference 等 fallback 服务,保障样本产出。例如在 Inference-Teacher-Training OPD 场景中,Inference 作为 fallback 占用 GPU;当 Teacher 或 Training 请求时,暂停 Inference,释放其显存,移交令牌;任务完成后归还令牌,Inference 恢复状态重新接管。开发者只需实现统一接口并在 recipe 中定义共置环,无需为每种组合单独写切换逻辑。
组件组装:灵活实现新训练配方
服务架构的最大好处是可通过 recipe 灵活组合角色。Meshy 展示了同一组服务的多种组合:
- 同步 GRPO:锁步窗口基线配置,加共置环即可切换架构。
- JustRL:同一模型超参,窗口从 1(锁步)到 2(有界异步)再到不限(全异步),差异仅在配置字段。
- OPD:引入全新 Teacher 服务,验证架构完整性。
以 OPD 为例,Teacher 服务与 Trainer 并列,构建在同一 GPU 引擎基座上,但无 optimizer 和权重更新逻辑。数据上,蒸馏流程由列契约定义:Rollout 写入 Top-K 候选,Teacher 读取打分写回,Trainer 声明需要打分列后自动过滤未完成样本。资源上,三者通过令牌环管理显存交接。这些改动无需修改推理、训练或 ignitor 核心逻辑,仅需实现新服务、维护配置、更新下游数据要求。
相比之下,Single-Controller 框架引入新角色需写新 Worker 类、注册分发方式、插入中央循环、增加显存管理分支——每一步都需改框架主干。Meshy 将改动全部限制在实验代码内,大幅降低创新成本。
服务化的收益与代价
将 RL 系统拆分为自主服务,看似增加进程数,实则降低整体开销。Single-Controller 中,每个阶段都需 controller 切分任务、派发调用、回收结果、等待完成,角色越多,中间环节负担越重。Meshy 让服务按数据就绪自主推进,省去中央调度;样本由生产者直送消费者,新增角色只增加自身计算,不叠加调度开销。
排障体验也显著改善。Ray 架构中,故障常表现为 driver 卡在远程调用,异常被层层包装。Meshy 的每个服务是普通本地进程,异常直接落在自身日志,带完整调用栈;配合 TQ 队列观测,看样本堆积就能定位问题。
当然也有代价。调试需跨进程进行,无法靠单个断点查看全局状态,主要依赖日志和队列状态。为此,Meshy 保持协议极简(数据列、gate 信号、管理端点),并提供各层独立测试。此外,TQ 成为必需基础设施,每次启动需额外运行 controller 和 storage 进程,使用者需理解和维护这一组件。
结语
Single-Controller 的价值在于:当系统有单一全局进度时,它能用简单顺序程序表达复杂分布式计算。对小规模同步训练,它仍是优秀选择。但当 RL 的最小进度单位变成“一条轨迹、一个版本、一个服务”时,中央进程就不再适合作为系统边界。
Meshy 将系统拆分为独立服务,各进程本地推导拓扑,数据通过统一队列直达消费者。这从架构上减少了通信调度环节,用同一组组件实现了同步 RL、全异步 RL 与 OPD 等不同训练配方。它的出现,标志着大模型强化学习系统正从“集中编排”走向“数据驱动的松耦合协作”。