前 OpenAI 研究员推出「闭嘴」AI 模型:不生成文本,只做结构化判断
一个拒绝说话的 AI
你可能见过很多 AI 在努力学会说话——写邮件、编故事、解释数学题。但最近有个反其道而行之的模型火了:它干脆不说话。

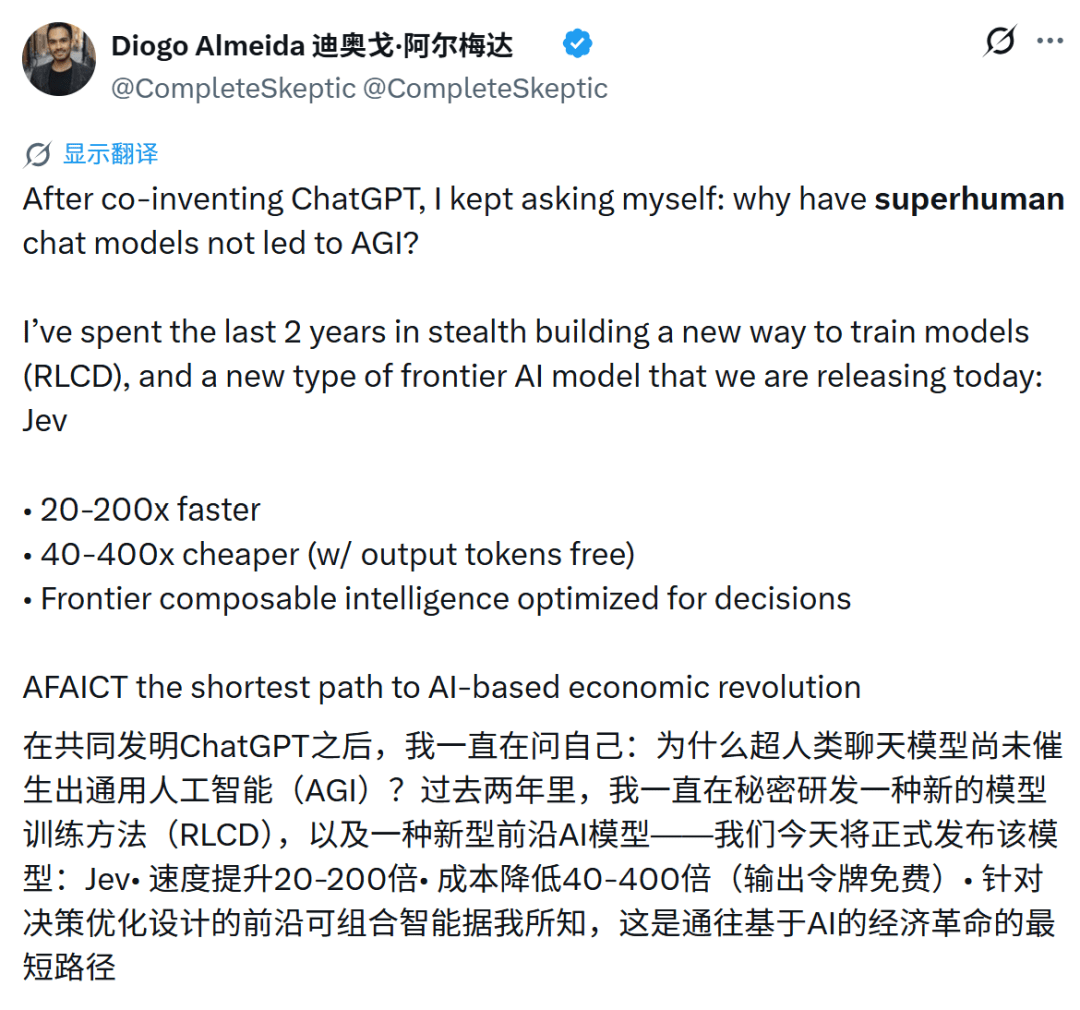
这个叫 Jev 的模型由前 OpenAI 研究员 Diogo Almeida 创立的公司 TypeSafe 推出。Almeida 是 2022 年 InstructGPT 论文的共同作者,也深度参与了早期 RLHF(基于人类反馈的强化学习)和 GPT-4 的研发。可以说,今天 ChatGPT 能听懂人话、会聊天的能力,他算是奠基者之一。
但离开 OpenAI 后,他开始怀疑这条路:“大模型现在非常擅长聊天,但聊天能力真的是软件自动化需要的核心能力吗?”
这个问题他想了四年。现在,他的答案很直接:也许 AI 根本不需要这么爱说话。
Jev 的设计原则简单到近乎粗暴——完全放弃自由文本生成。你不能让它写一段话、解释一个概念,甚至不能让它“说清楚为什么”。它只做一件事:读取非结构化输入(比如一封邮件、一段日志),然后直接输出预定义好的结构化判断,附带每个选项的概率和置信度。
举个例子:你想判断用户邮件是不是投诉、紧急程度如何、该转给哪个部门。传统大模型会先生成一段文字:“根据内容,这是一封关于退款的紧急投诉,建议转交客服部……”程序再从这段话里提取字段。
Jev 跳过中间所有废话。你提前定义好输出 schema(比如 type: [complaint, refund, inquiry], urgency: [low, medium, high]),它读完邮件后直接返回:
{
  "type": {"complaint": 0.92, "refund": 0.05, "inquiry": 0.03},
  "urgency": {"high": 0.88, "medium": 0.10, "low": 0.02}
}
没有自然语言,没有解释,只有类型确定的数值结果。TypeSafe 把这概括为:“非结构化状态进去,带类型的概率决策出来。”
速度和成本优势从哪来?
关键在于计算方式的改变。
传统 LLM 采用自回归生成:每个 token 都依赖前一个,必须顺序执行。哪怕你只需要一个分类结果,模型也得“写”完整句话。而 Jev 的目标不是生成文本,所以可以并行计算所有输出字段。
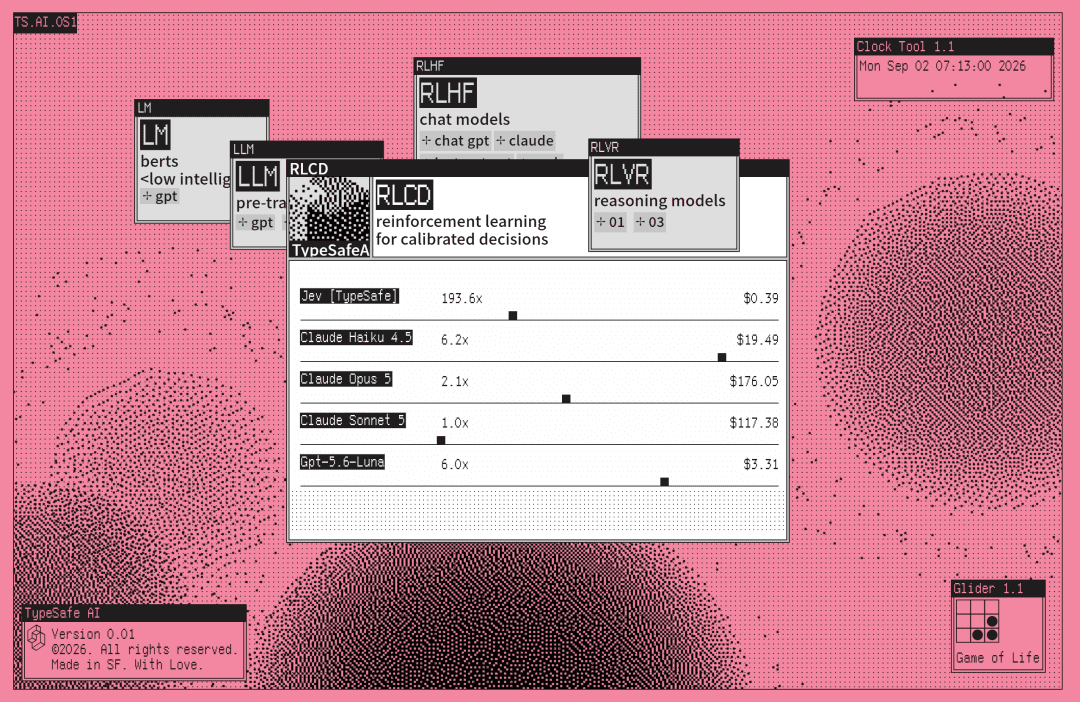
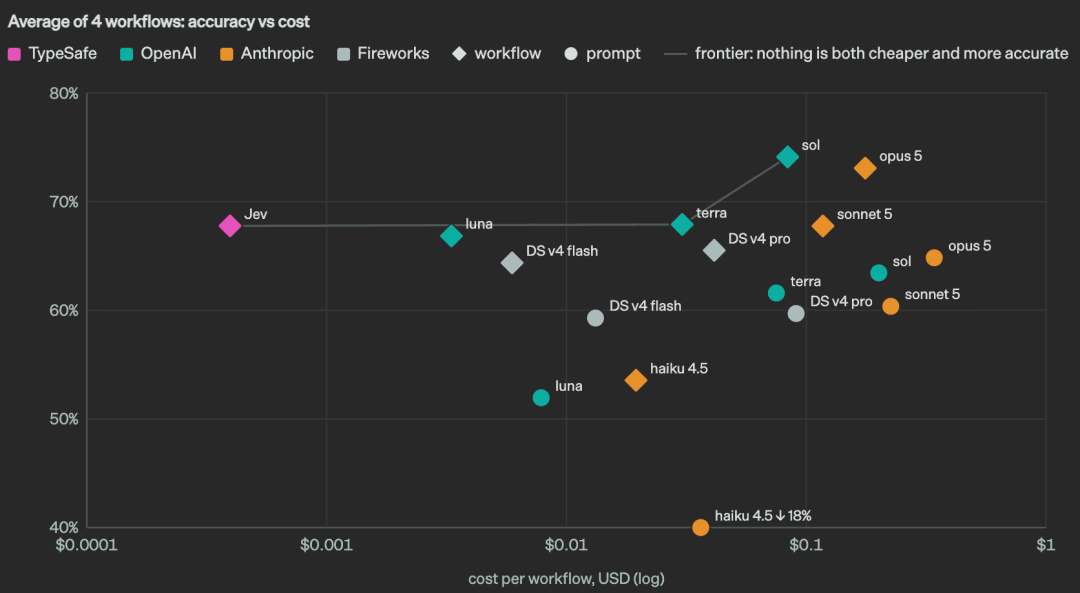
官方数据显示,Jev 的端到端响应时间在 70–500 毫秒之间,输入价格为每百万 token 0.042 美元,输出目前免费(因为它不生成 token)。在内部 workflow 测试中,最高测出 193.6 倍的速度优势和 444.6 倍的成本优势。
外部实测也支持这一趋势。评测机构 Every 的 Mike Taylor 用 Jev 对 37 篇文档做了 777 次独立判断,总耗时不到 0.7 秒。在一项写作质量评估任务中,Jev 用时 0.35 秒,而 Fable 5.1 需要 8.83 秒——前者快约 25 倍,成本低约 580 倍。
当然,这些数字有前提。TypeSafe 自己承认,测试 workflow 来自内部团队,可能存在设计偏差,且收益已接近现实工作流的上限。但即便打个对折,这类高度结构化任务的效率提升依然显著。
用 RLCD 替代 RLHF
更值得玩味的是训练方法。TypeSafe 给它起了个新名字:RLCD(Reinforcement Learning for Calibrated Decisions),直译是“面向校准决策的强化学习”。
这明显是在回应 RLHF。RLHF 的核心是让人给多个回答打分,训练模型生成“更受欢迎”的结果。这套方法让语言模型从单纯预测下一个词,进化成能遵循指令、解释问题的聊天助手。
但 Almeida 现在认为,当 AI 进入自动化系统,“人的偏好”未必是关键。一个每天执行百万次的工作流,真正需要的不是“听起来合理”的回答,而是两个信息:答案是什么?这个答案有多确定?
RLCD 把“校准(calibration)”放到核心。简单说,如果模型对某类判断长期给出 90% 的置信度,那这些判断最好真的有 90% 正确。这样,下游程序才能基于概率写逻辑:
- 置信度 >95%:自动执行
- 70% 左右:交给更强模型复核
- <40%:转人工
AI 由此变成一个可嵌入程序的“模糊 if 语句”。TypeSafe 称之为 “composable intelligence”(可组合智能)——智能不必每次都以整段自然语言出现,它可以成为软件内部随时调用的一项原子能力。
“不会幻觉”是文字游戏吗?
TypeSafe 宣称 Jev “不会幻觉”,但这需要打引号。
我们通常说的幻觉,是指模型一本正经地编造不存在的事实。但 TypeSafe 这里的“幻觉”指的是另一类问题:模型生成了程序无法处理的输出。
比如你让模型从“投诉/退款/咨询”三选一,普通大模型即使被要求按格式回答,仍可能突然冒出“严重投诉”或一大段解释。对人来说只是多读几行字,但对自动化系统,这就是灾难——下游程序根本不知道怎么处理这个新类别。
Jev 从源头杜绝了这种可能。所有输出类型和取值范围都提前定义好,它只能在预设选项中选择,不可能临时创造第四个答案。这就是所谓的 “type safety”(类型安全)。
官方甚至注明,Jev 的“0% hallucination”不是统计结果,而是由 schema matching 机制保证的——既然输出严格受限于 schema,那“超出 schema 的幻觉”自然为零。
不过,这并不等于 Jev 不会犯错。它仍然可能选错类别,只是不会“越界”。更重要的是,它把不确定性显式输出:不是简单说“这是投诉”,而是告诉你“投诉 92%、退款 5%、咨询 3%”。
这种“epistemically honest probabilities”(认知诚实的概率)才是对抗广义幻觉的关键。普通 LLM 内部也有概率分布,但最终输出的往往是斩钉截铁的句子,无论模型其实只有 51% 还是 99% 把握。
Jev 则保留了不确定性。这让系统知道何时该执行、何时该升级、何时该放弃。一个解决“程序能不能处理”,一个解决“程序要不要执行”。
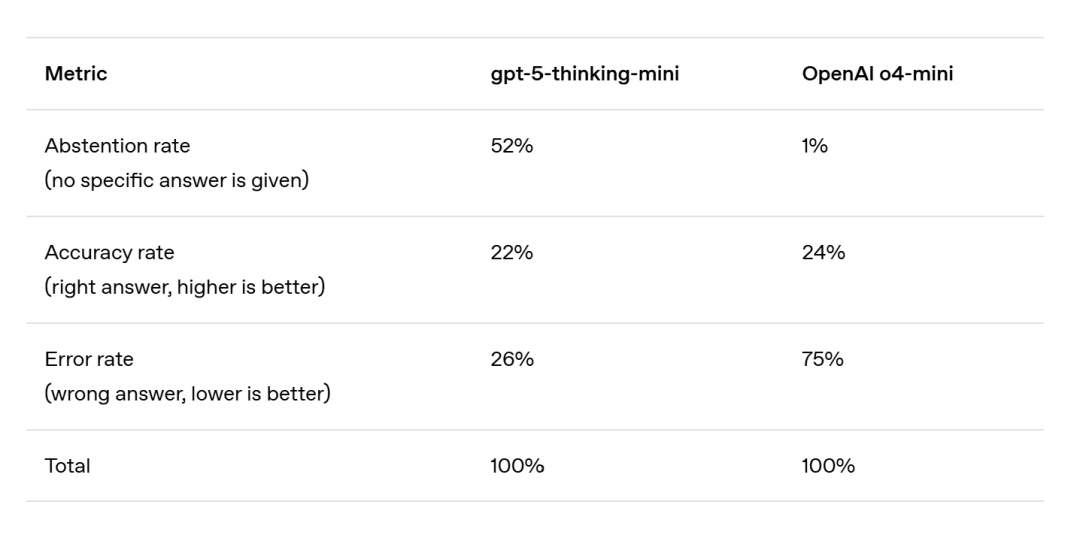
但要注意:校准不等于正确。OpenAI 的研究指出,一个模型完全可以每次都答错,但每次都诚实地报告“我只有 0% 把握”——它的概率很校准,答案照样全错。所以 calibration 并非幻觉率的直接指标。
社区质疑:不过是 JSON 分类器?
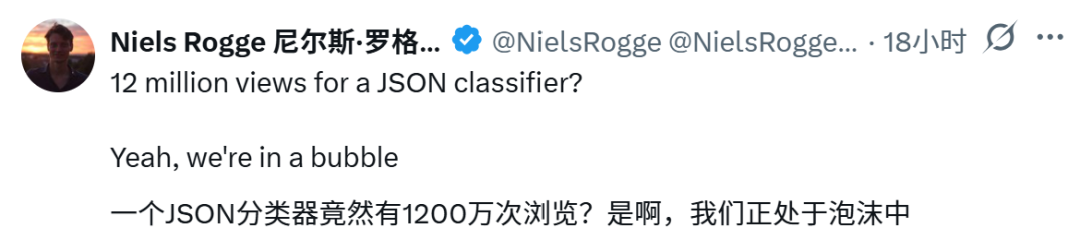
Jev 的爆火引来不少吐槽。Hugging Face 研究员 Niels Rogge 直接评论:“一个 JSON 分类器竟然有 1200 万次浏览?是啊,我们正处于泡沫中。”
这话不算全错。扒开“System One Model”“RLCD”“0% hallucination”这些新名词,Jev 做的事其实很常见:分类、打分、路由、结构化输出——本就是大模型工作流里的基础任务。
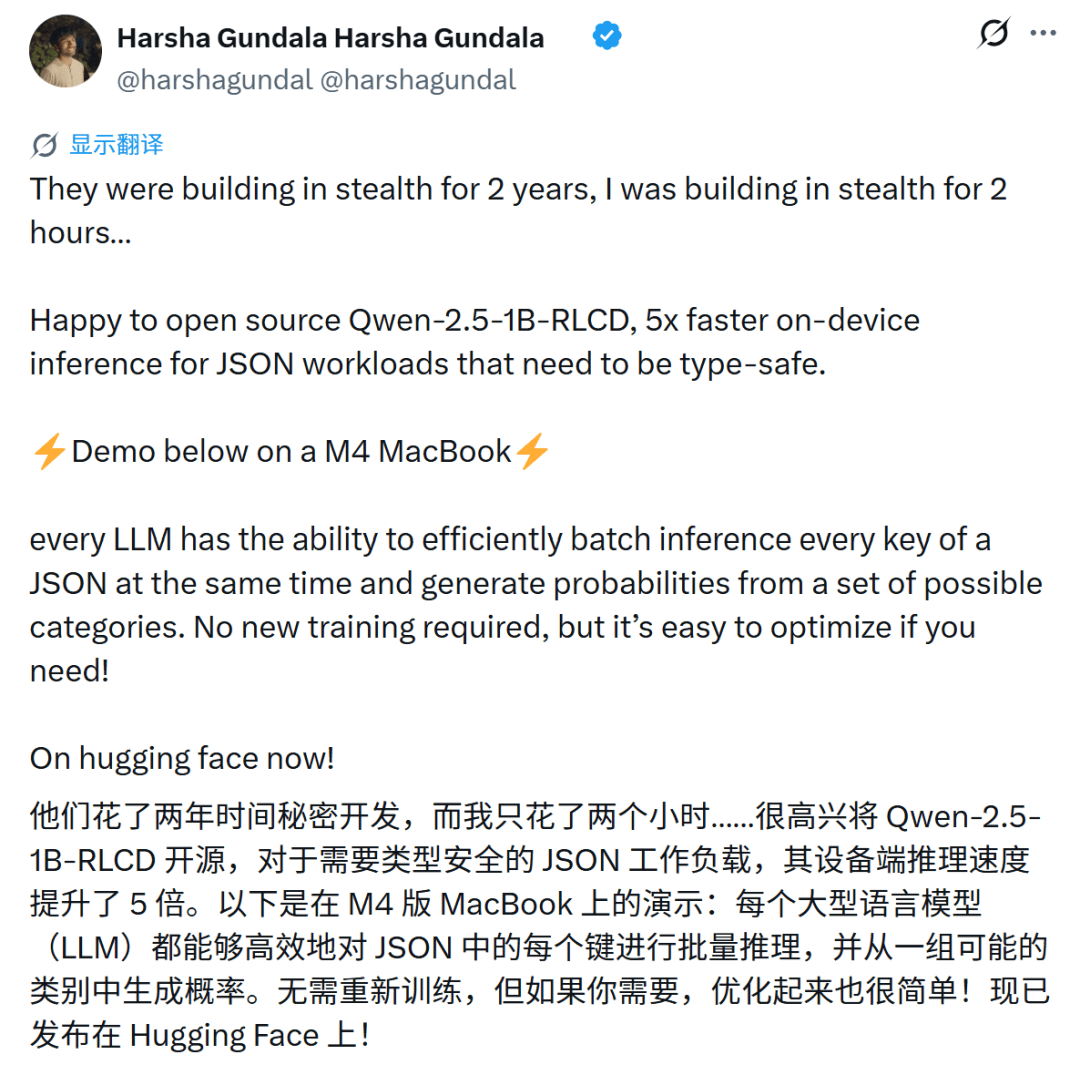
甚至发布不到一天,就有开发者用 Qwen2.5-1B 复现了类似功能。Harsha Gundala 的推文相当挑衅:“他们隐身开发了两年,我隐身开发了两个小时……”
他的开源版本同样支持 JSON 多字段并行判断,并直接从预设候选计算概率,且无需新训练。这说明:并行结构化输出本身并不需要全新模型架构。
而“零幻觉”的说法也被认为是偷换概念。真正的争议点落在 RLCD 的校准效果上。截至目前,TypeSafe 尚未公开 RLCD 的具体训练方法、reward function 或系统性校准指标。社区质疑:普通模型也能从 logits 提取概率,Jev 的校准到底强在哪?
为什么一个“普通”模型能火?
但这些质疑反而印证了 Jev 的价值。
如果一个开发者真能用两小时在 1B 小模型上实现类似功能,那说明:这类能力根本不需要昂贵、复杂的通用大模型。
过去几年,我们习惯把所有任务塞给通用大模型,但对大量重复、简单的判断任务来说,这简直是“杀鸡用牛刀”。Jev 的思路恰恰相反——它把最普通、数量最大、对延迟和成本最敏感的任务单独拎出来,主动放弃聊天、写作等“炫技”能力,只保留自动化真正需要的部分。
AI 产品常见的叙事是刷新 benchmark:更强推理、更高得分、更长上下文,用榜单证明能力上限。Jev 走的是另一条路:不追求“更强”,而是“刚好够用”。
它很难用传统指标衡量,但解决了真实工作流中的痛点:省下等待时间,省下 token 成本,避免下游解析错误。这种“贴地飞行”的产品,反而获得了远超预期的关注。
一个看起来不炫目的“JSON 分类器”能拿到 2400 万浏览,或许说明:证明模型“足够强”是一种吸引力,而证明它“恰好解决日常问题”是另一种。
未来,随着模型能力越来越强,产品可能不仅要展示上限,还要回答另一个问题:面对各类任务,如何提供最简单、最直接、最不绕弯子的处理方式?
Jev 的尝试或许给出了一个方向:有时候,让 AI 闭嘴,反而能让它更有用。