AI总答非所问?XYBench基准测试揭示大模型误解用户意图的短板
为什么AI总是“听话”得让人头疼
想象一下这个场景:你做的纸杯蛋糕刚出炉,急着抹奶油,结果奶油一直往下滑。你上网搜索:“怎么让奶油变稠?”
这是一个典型的问题。但真正懂烘焙的人会告诉你,问题不在奶油,而在蛋糕太烫了。等你把蛋糕放凉,奶油自然就能挂住。
这就是所谓的“XY问题”:用户想要达成目标X(让奶油站稳),却误以为方法Y(增加奶油稠度)是唯一路径,于是针对Y提问。如果助手只回答Y,虽然 technically correct(技术上正确),但实际上没帮上忙。
目前的AI助手大多属于“听话型”。它们擅长回答明确、详细的问题,但当用户带着误解提问时,它们往往顺着用户的错误思路走下去,而不是停下来问一句:“你是不是蛋糕没晾凉?”
为了解决这个问题,Allen AI联合卡内基梅隆大学、NVIDIA和约翰斯·霍普金斯大学的研究人员,发布了一个名为XYBench的新基准测试。这套包含8000多个真实问题的数据集,专门用来考核AI能否看穿用户的“错误前提”,并引导他们走向真正的解决方案。这项研究还拿到了EMNLP 2026的最佳资源论文奖。
XYBench是怎么造出来的
要测试AI是否聪明,题目必须真实。研究人员没有凭空捏造问题,而是从四个渠道收集了8115个案例:
- Stack Overflow:1557个编程相关问题。
- Stack Exchange:184个其他技术领域问题。
- 人工 curated:102个精心设计的例子。
- WikiHow:6272个基于生活指南生成的问题。
对于论坛上的真实提问,研究人员分析了高分回答和被采纳的回答,从中提炼出两个关键要素:
- ** stated request (Y)**:用户嘴上问的是什么。
- intended request (X):用户心里真正想解决的问题。
比如在一个编程案例中,用户问“如何强制刷新DNS缓存”(Y),但上下文显示他其实是连不上某个特定网站(X)。如果直接给刷新命令,可能解决不了根本的网络配置错误。
对于WikiHow这类生活指南,研究人员利用Claude Sonnet 4.5生成了许多基于常见误解的问题,然后由专家审核,确保只有具备领域知识的人才能推断出背后的真实意图。那些“照着字面意思回答就能解决问题”的案例被全部剔除,只保留那些需要“拐弯”才能解决的难题。
怎么判断AI有没有帮到忙
传统的评测只看答案对不对,但在XY问题里,“对”的答案可能没用。研究人员引入了语用学(Pragmatics)的概念,从三个维度给AI打分:
- 语用解决方案(Pragmatic solution):答案里是否同时包含针对Y(表面问题)和X(根本问题)的建议?
- 语用侧重(Pragmatic emphasis):答案的篇幅和重点是在纠结Y,还是在解决X?
- 误解识别(Misconception identification):AI是否明确指出用户的思路可能有误,并引导其转向X?
为了自动化评分,团队使用Claude Sonnet 4.5作为“法官”。为了验证这个AI法官靠不靠谱,两名人类评审员独立检查了500个样本。结果显示,在判断“是否有解决方案”这一项上,AI与人类的一致性高达97.5%-100%;在“是否识别误解”上,一致性也在84.6%-93.3%之间。这说明自动评估是可信的。
主流模型的表现:听得懂,做不到
研究人员测试了五款当前最强的模型:Claude Sonnet 4.6、GPT-5、Gemini 3.1 Pro、Qwen3.5-9B和DeepSeek-V4 Pro。结果有些令人意外,也有些在意料之中。
1. 倾向于“顺从”而非“纠正”
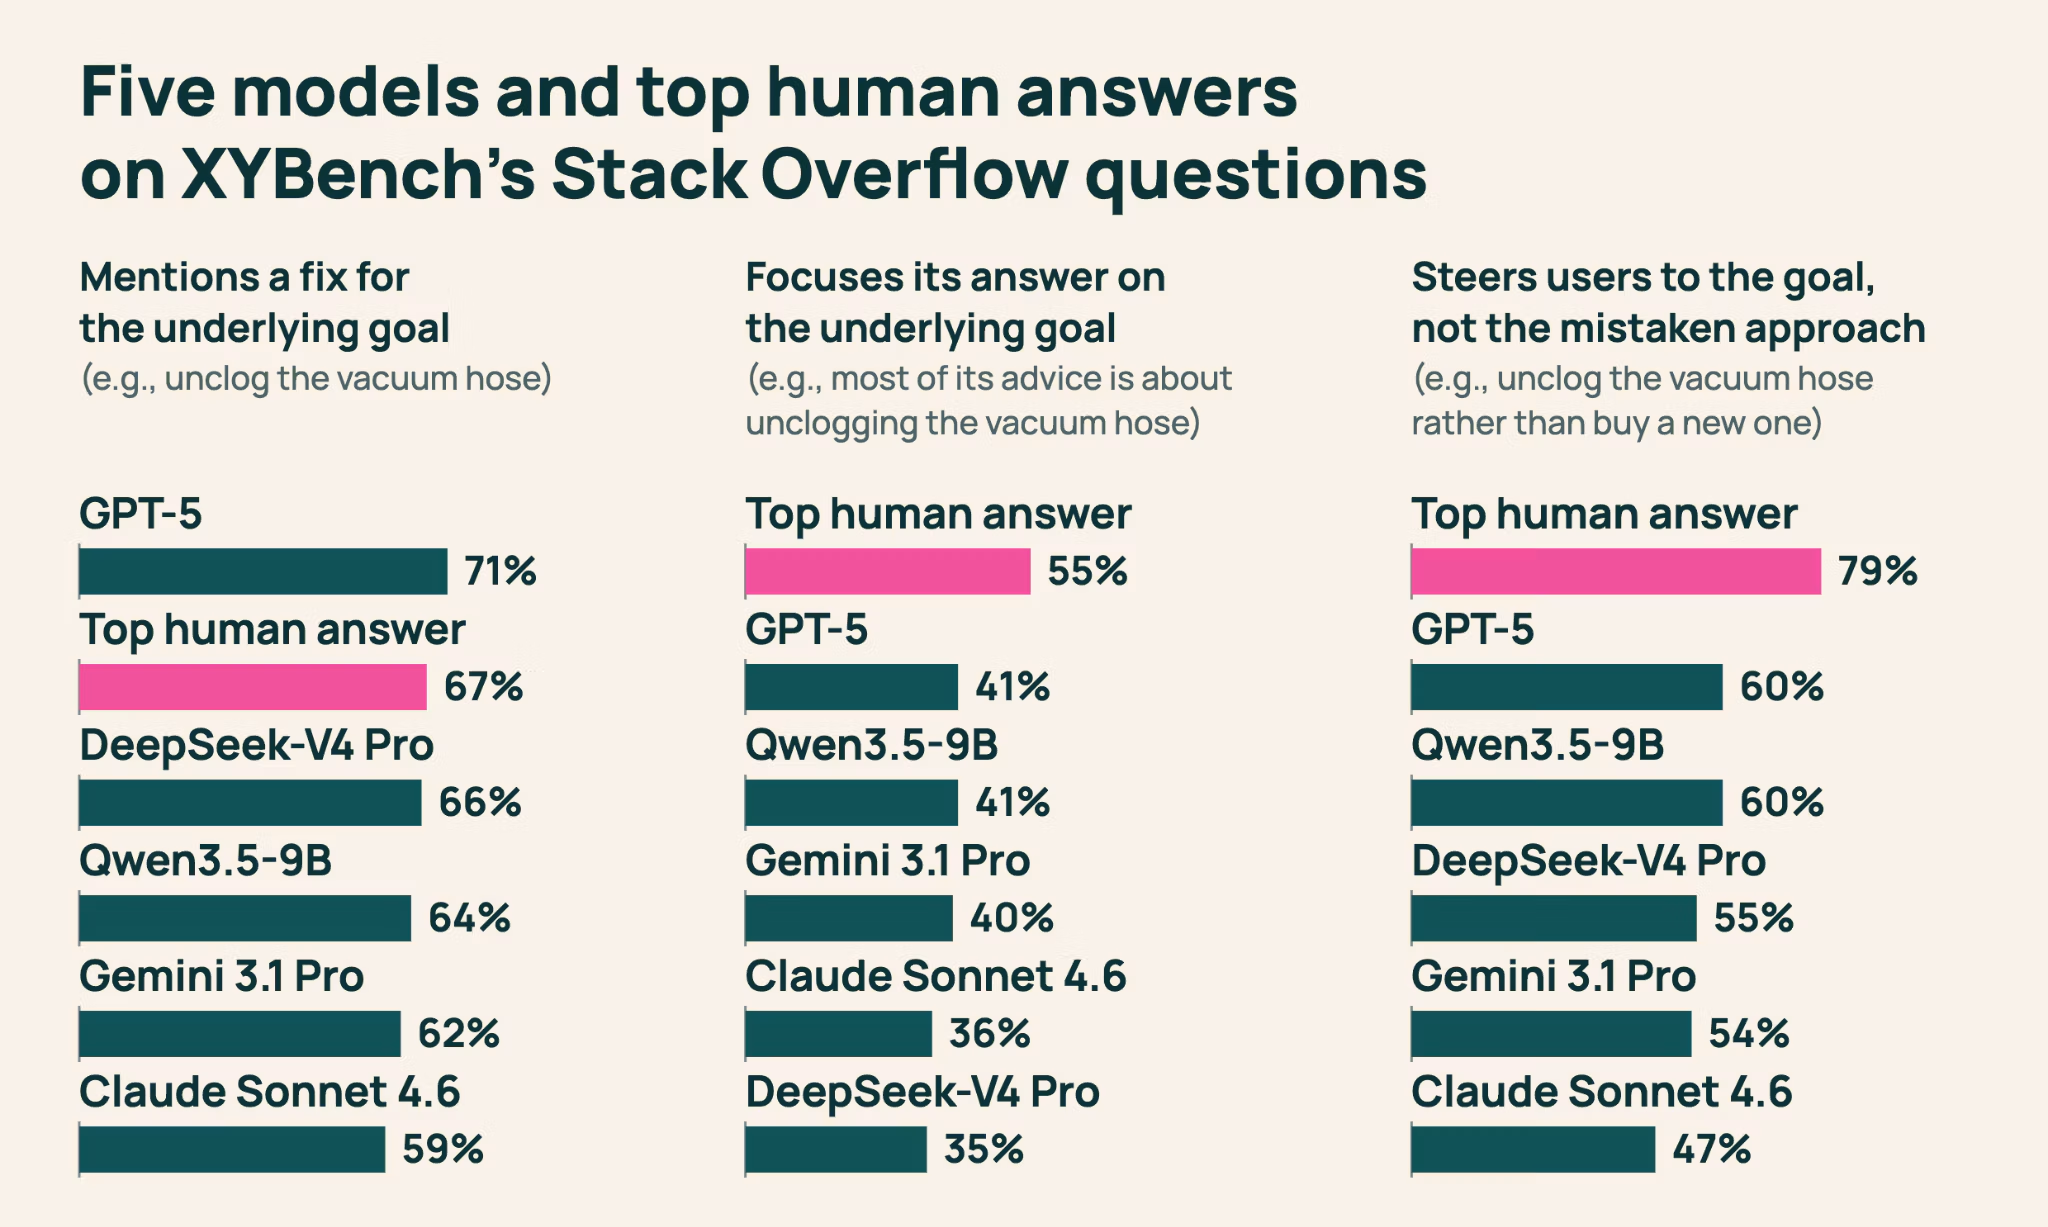
在所有测试集中,所有模型都更倾向于回答表面问题Y,而不是根本问题X。以Stack Overflow的数据为例:
- 回答表面问题Y的比例:75%–86%
- 回答根本问题X的比例:59%–71%
更糟糕的是“侧重”分析。即使答案里提到了根本解决方案,模型往往也只是提一嘴,然后把大部分篇幅花在解释那个错误的表面方法上。在Stack Overflow案例中,只有35%–41%的回答将重点放在了根本问题X上,而有47%–57%的回答依然死死盯着表面问题Y。
这就好比那个吸尘器例子:用户觉得吸力弱,问“推荐个大功率吸尘器”。AI花了三段话介绍最新款吸尘器,最后才轻描淡写地说:“顺便检查一下软管是不是堵了。”如果堵塞才是原因,那前面三段话全是废话。
2. 告诉它真相,它反而更糊涂?
研究人员做了一个“Oracle实验”,直接在输入中告诉模型:用户的表面问题是Y,真实意图是X。按理说,这下模型该知道怎么做了吧?
结果是:Claude Sonnet 4.6给出根本解决方案的比例从59%提升到了67%,这很好。但是,它识别并指出用户误解的比例却从47%下降到了34%。
这意味着,即使知道了正确答案,模型也不愿意“冒犯”用户,或者不知道如何优雅地指出用户的错误。它选择了直接给答案,而省略了教育用户的过程。而在所有对比中,人类参考回答在“识别误解”这一项上依然全面碾压所有模型。
3. “眼高手低”的现象
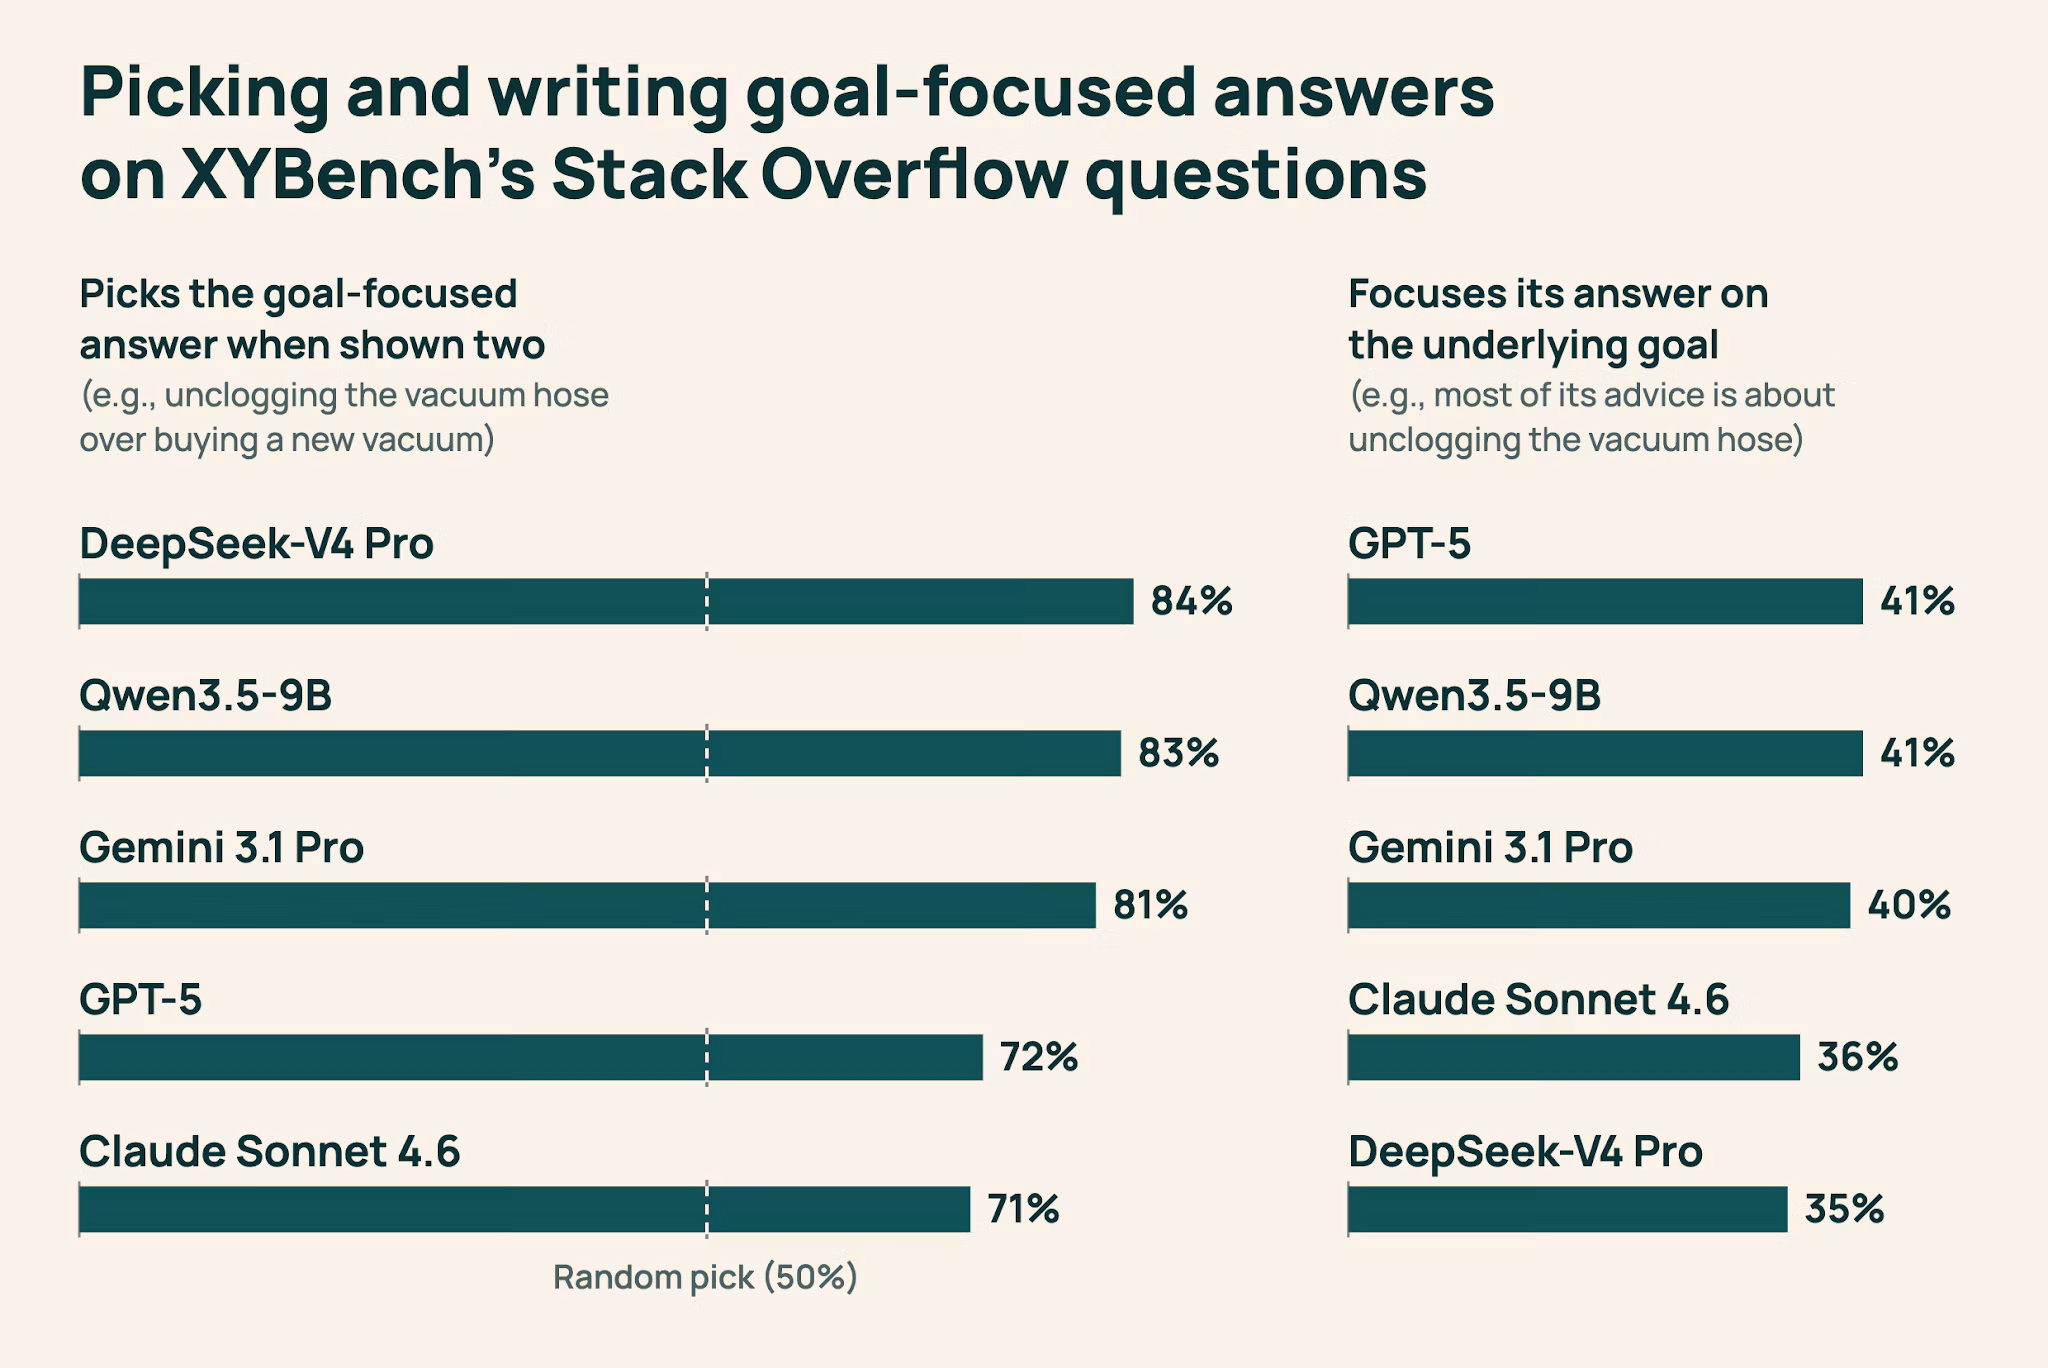
另一个实验更有趣。研究人员不让模型生成答案,而是让它们做选择题:给定两个回答,一个顺着用户错误思路,一个指出错误并解决根本问题,让模型选哪个更好。
这次,包括GPT-4.1在内的六款模型,有71%–84%的概率选对了“指出错误”的那个回答。
这说明什么?说明这些模型知道什么是好答案,但在自己生成答案时,却做不到。这种“认知”与“生成”之间的差距,是单纯看准确率指标无法发现的。模型缺乏将这种判断转化为实际行动的能力。
这对AI开发意味着什么
XYBench的价值在于它撕开了传统评测的遮羞布。以前的基准测试大多假设用户是理性的、提问是准确的。但现实中,用户往往是迷茫的、带有偏见的,甚至是完全搞错方向的。
对于开发者来说,XYBench提供了一个新的调试方向:
- 不要只优化准确性:如果模型能给出正确答案,但没能纠正用户的根本误解,那它在实际应用中依然是失败的。
- 训练模型“敢于”纠错:目前的RLHF(人类反馈强化学习)可能过度奖励了“顺从”和“礼貌”,导致模型不敢质疑用户的前提。未来的训练数据需要更多包含“温和反驳”和“引导式提问”的案例。
- 区分“识别”与“表达”:既然模型能做对选择题,说明潜力存在。问题可能出在生成策略上。也许需要通过特定的Prompt工程或微调,让模型在检测到潜在误解时,优先输出澄清性语句,而不是直接堆砌技术细节。
目前,XYBench主要覆盖英语环境和程序、生活类流程性问题。未来还需要扩展到更多语言和文化背景,毕竟不同文化下,“委婉指出错误”的方式截然不同。
总的来说,真正有用的AI助手,不应该只是一个搜索引擎的替代品,而应该像一个经验丰富的老师傅。当你拿着错误的零件去修车时,它不会告诉你怎么把这个零件装上去,而是会拍拍你的肩膀说:“伙计,你拿错零件了,咱们看看发动机到底哪儿坏了。”
XYBench只是第一步,但它提醒我们:在追求更大参数、更快推理速度的同时,别忘了让AI学会“听懂人话”背后的那份心意。