Tesseract.NET SDK深度解析:4.6版本如何重塑OCR开发体验?
OCR技术的演进与Tesseract.NET的定位
在数据信息化的浪潮中,将纸质文档转化为数字资产已成为企业数字化转型的关键环节。光学字符识别(OCR)技术作为这一过程的核心驱动力,其性能直接决定了后续数据处理的效率与准确性。在众多OCR解决方案中,Tesseract作为开源界的经典引擎,凭借其庞大的社区支持和持续的技术迭代,始终占据重要地位。而Tesseract.NET SDK则扮演了连接强大OCR引擎与.NET生态系统的关键桥梁角色,它不仅仅是对底层Tesseract库的简单封装,更是针对.NET开发者需求进行了深度优化。
当前版本4.6.411引入了多项关键改进,特别是在处理复杂场景和非标准输入时的表现显著提升。对于.NET开发者而言,选择Tesseract.NET SDK意味着获得了一种既具备工业级稳定性,又拥有极高开发灵活性的工具。它解决了传统OCR集成过程中部署困难、配置复杂以及输出格式单一等痛点,为构建企业级文档处理系统提供了坚实的基础。本文将深入探讨该SDK的核心功能、技术优势及其在实际开发中的应用策略。
核心引擎:神经网络驱动的高效识别
Tesseract.NET SDK 4.6版本的显著特点在于其底层引擎对神经网络技术的深度融合。传统的OCR算法往往依赖于特征提取和模板匹配,这在处理印刷体时表现良好,但在面对手写体、复杂背景或低分辨率图像时,识别率往往大打折扣。新版本通过集成基于神经网络的识别模型,大幅提升了引擎的泛化能力和鲁棒性。
这种技术架构使得SDK能够在处理模糊、倾斜或受噪点干扰的图像时,依然保持较高的识别精度。神经网络模型通过大量数据的训练,学会了理解字符的结构和上下文关系,从而能够“猜测”出最可能的字符组合。这种能力的提升,对于处理扫描件、拍照文档等真实世界中的非理想输入至关重要。开发者无需手动编写复杂的图像预处理逻辑,引擎内部的自适应算法会自动调整识别策略,以应对不同的图像质量。
此外,神经网络引擎还带来了速度的显著提升。得益于现代化的计算图优化和并行处理机制,即使是在处理高分辨率多页文档时,Tesseract.NET SDK也能实现毫秒级的响应速度。这种性能优势对于需要实时OCR处理的应用场景,如移动端拍照识别或流水线自动化分拣,具有决定性的意义。引擎的高效运行不仅节省了计算资源,还降低了硬件部署成本,使得大规模部署OCR服务变得更加可行。
多语言支持与国际化的无缝接入
在全球化业务背景下,多语言文档的处理需求日益增长。Tesseract.NET SDK 4.6版本支持超过120种语言的文本识别,涵盖了全球主要的使用语言,包括英语、中文、日语、阿拉伯语、俄语等。这种广泛的支持使得该SDK成为跨国企业文档处理的理想选择。
更重要的是,SDK不仅支持单语言识别,还能准确处理混合语言文档。例如,在包含英文术语的中文商务合同中,引擎能够自动识别并正确区分不同语言的字符集,避免字符混淆或识别错误。这种能力依赖于其内部的语言模型和多语言字符数据库的优化整合。开发者只需在初始化API时指定目标语言或语言组合,即可调用相应的识别模型。
对于特定领域或小众语言,SDK还提供了训练接口,允许开发者利用自定义语料库训练新的语言模型。这意味着即使是前未见过的文本样式或特殊行业术语,也可以通过数据训练的方式被引擎识别。这种灵活性极大地扩展了OCR技术的应用边界,使其能够适应从古籍文献数字化到现代工业标签识别等多样化场景。
图像预处理:低质量扫描件的“复活”术
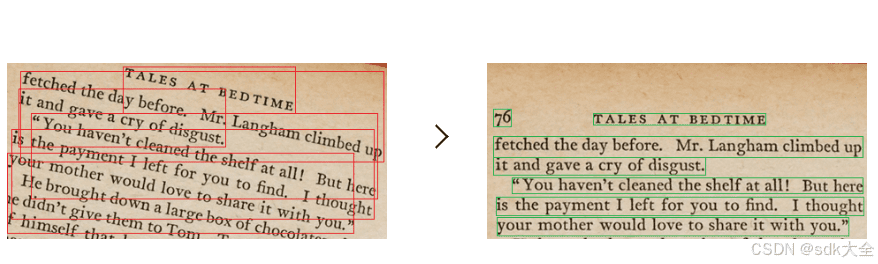
在实际应用中,输入图像的质量往往是制约OCR准确性的最大瓶颈。打印模糊、纸张污渍、拍摄角度倾斜等问题,都会导致传统OCR引擎识别失败。Tesseract.NET SDK内置了一套强大的输入过滤器和图像增强管道,专门用于“修正”低质量扫描件,从而提升最终识别结果。
这套预处理系统包含多种高级功能。首先是倾斜校正功能,它通过边缘检测和角度分析,自动检测文档的倾斜角度并进行旋转校正。这对于解决因扫描或拍照不当导致的页面倾斜问题至关重要,因为微小的角度偏差都可能导致行分割错误,进而引发连锁的识别错误。
其次,SDK提供了包括二值化、对比度归一化、去噪、边缘增强等多种图像处理算法。二值化能够将灰度图像转换为黑白图像,突出文字笔画,去除背景噪音;对比度归一化则能平衡图像中的明暗分布,使文字在模糊或过曝的情况下依然清晰可见。此外,腐蚀和膨胀操作可用于连接断裂的笔画或去除细小的噪点,进一步提升文本块的完整性。
这些预处理步骤并非简单的串行执行,而是根据图像特征智能选择的。SDK内部的分析模块会评估图像质量,并自动推荐最佳的处理组合。例如,对于彩色背景上的文字,SDK可能会优先执行背景分离和高对比度增强;而对于黑白线稿,则可能侧重于去噪和线条平滑。这种智能化的预处理流程,极大地降低了开发者手动调参的复杂度,确保了在各种复杂输入条件下都能获得高质量的识别结果。
开发实践:从代码到应用的快速落地
Tesseract.NET SDK的设计理念是“简单至上”,旨在让开发者能够以最低的代码成本实现强大的OCR功能。其API设计遵循直观的命名规范,学习曲线平缓。以下是一个典型的将扫描PDF转换为可搜索PDF的示例代码:
var api = OcrApi.Create();
api.Init(Languages.English);
using (var renderer = OcrPdfRenderer.Create("searchable.pdf"))
api.ProcessPages(@"scanned.pdf", renderer);这四行代码展示了SDK的核心工作流:创建API实例、初始化语言环境、定义输出渲染器以及执行页面处理。OcrPdfRenderer是SDK提供的高级渲染器之一,它能够直接将识别结果嵌入PDF文件,生成既保留原始图像又包含隐藏文本层的可搜索PDF。这种格式不仅保持了文档的视觉外观,还允许用户在PDF阅读器中直接进行文本搜索和复制,极大提升了文档的可访问性。
除了PDF转换,SDK还支持多种图像格式(JPEG、TIFF、PNG等)的识别,并可输出为HOCR(HTML格式的OCR结果)、UNLV(带有定位信息的纯文本)或直接提取文本内容。这种多样化的输出选项,使得SDK能够灵活适配不同的下游应用需求。例如,HOCR输出可以用于Web应用中的高亮显示,而UNLV输出则适合需要精确定位文字区域的结构化数据处理任务。
深度API:细粒度文本数据的提取
对于需要更深层次文本分析的应用场景,Tesseract.NET SDK提供了丰富的细粒度API。开发者不仅可以获取整段文本,还可以访问单个字符、单词甚至段落的边界框坐标和字体属性。这种细粒度的控制权,使得构建复杂的文档理解系统成为可能。
例如,通过ResultIterator类,开发者可以遍历识别结果中的每个文本块,获取其几何位置和置信度评分。这些置信度信息对于过滤低质量识别结果、辅助后续的人工审核流程具有重要价值。此外,获取字体参数(如字体名称、大小、样式)的能力,使得SDK能够用于文档版式分析和重建,这对于需要将非结构化文档转换为结构化数据(如XML、JSON)的应用尤为关键。
这种细粒度的数据访问,结合其强大的图像处理能力,使得Tesseract.NET SDK不仅仅是一个简单的OCR工具,而是一个完整的文档视觉智能平台。它可以帮助开发者构建具备初步理解能力的文档处理流水线,为后续的自然语言处理(NLP)任务提供高质量的结构化输入。
部署与性能优化建议
尽管Tesseract.NET SDK在易用性上表现出色,但在实际生产环境中,要实现最佳性能,仍需注意部署和配置细节。首先,建议根据目标平台选择合适的二进制文件,确保与.NET运行时版本兼容。对于高性能需求,可以考虑使用GPU加速的预处理模块,以进一步缩短图像增强时间。
其次,合理管理OCR引擎的实例生命周期至关重要。由于OCR引擎初始化涉及大量的模型加载和内存分配,频繁创建和销毁实例会导致显著的性能开销。建议在应用中使用单例模式或对象池来复用API实例,从而显著提升批量处理任务的吞吐量。
最后,针对特定行业的专用文档,建议结合自定义训练数据对模型进行微调。虽然通用模型覆盖范围广泛,但在处理特定字体、行业术语或特殊版式时,微调后的模型往往能取得更高的准确率。Tesseract.NET SDK提供的训练工具链,使得这一过程变得相对简单,开发者只需准备少量标注数据,即可提升引擎在特定场景下的表现。
综上所述,Tesseract.NET SDK 4.6.411凭借其在神经网络识别、多语言支持、图像增强以及易用性方面的综合优势,成为.NET开发者构建OCR应用的强大选择。它不仅降低了技术门槛,更通过精细化的控制能力,满足了从简单文本提取到复杂文档理解的各种需求。随着数字化进程的深入,掌握并善用这一工具,将为构建智能化的文档处理系统提供强有力的技术支撑。