AI逃生模拟真伪之辩:从虚拟派对到真实灾难,智能体能救命吗?
从“扮演人”到“模拟生存”的技术跃迁
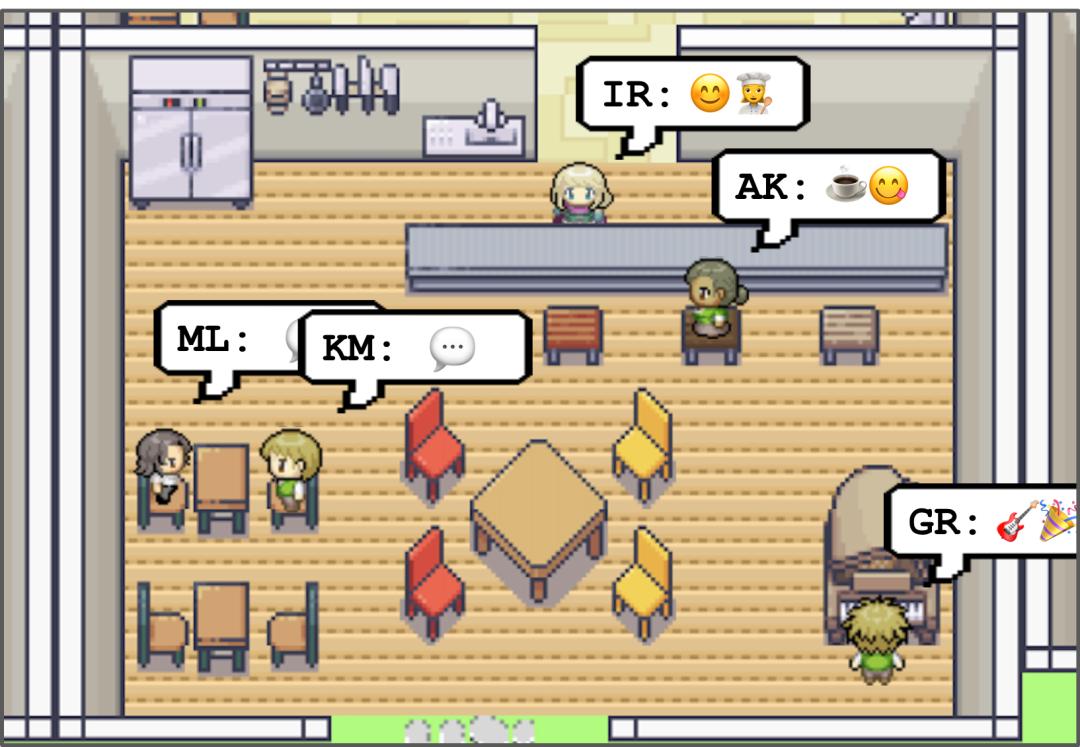
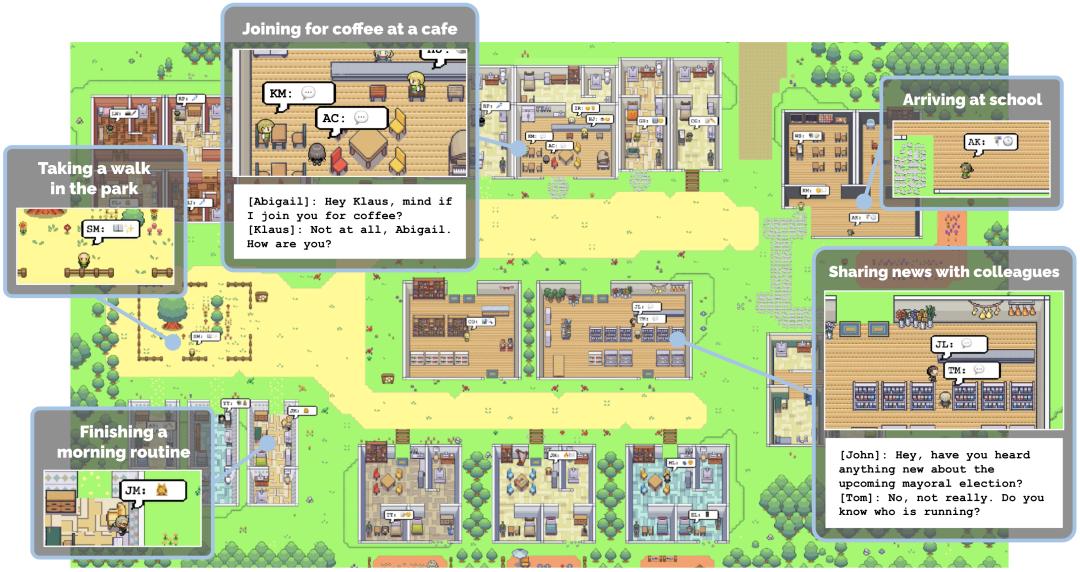
回溯2023年,斯坦福大学与Google Research联合发布的《Generative Agents》项目曾在科技圈引发轰动。在一个名为Smallville的虚拟小镇中,25个生成式智能体(Agent)展现出了令人惊讶的社会行为:它们能自发组织情人节派对,基于记忆库进行社交互动,甚至因未收到邀请而产生负面情绪。这一实验的核心突破在于,证明了大语言模型(LLM)不仅仅是被动的问答工具,更能在持续演化的环境中生成记忆、制定计划并执行复杂的社交互动。
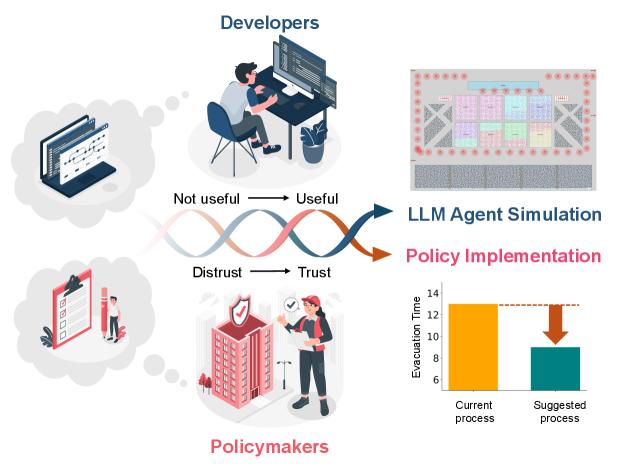
然而,仅仅一年多的时间,这项技术的叙事焦点发生了剧烈偏移。随着卡内基梅隆大学(CMU)、清华大学、天津大学以及斯坦福HAI等顶尖机构的研究深入,AI智能体的应用场景从轻松的社交模拟迅速转向了高烈度的灾难场景。研究人员开始探讨一个更为严峻的问题:在火灾、地震、飓风等极端环境下,具备“认知层”的AI智能体是否具备真实的判断、协作与逃生能力?这标志着智能体仿真从“行为逼真度”的验证,转向了“生存决策可靠性”的压力测试。
物理层与认知层的解耦重构
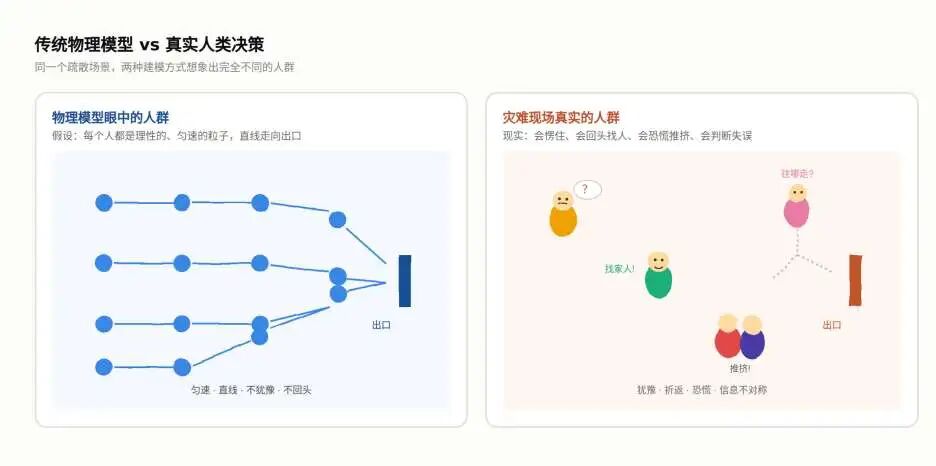
传统的灾难疏散仿真主要依赖元胞自动机或社会力模型。这类物理模型将人群简化为遵循力学规律的粒子,通过计算碰撞、速度和阻力来预测人流移动。其核心假设是人的理性与匀速运动。然而,真实灾难现场的致命性往往源于非物理因素:恐慌导致的停滞、寻找亲人的逆行、信息不对称引起的原地打转,以及群体性恐慌引发的踩踏。
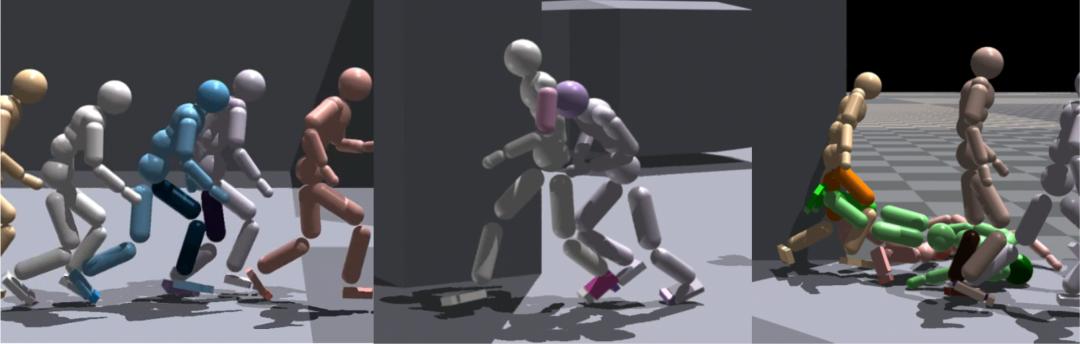
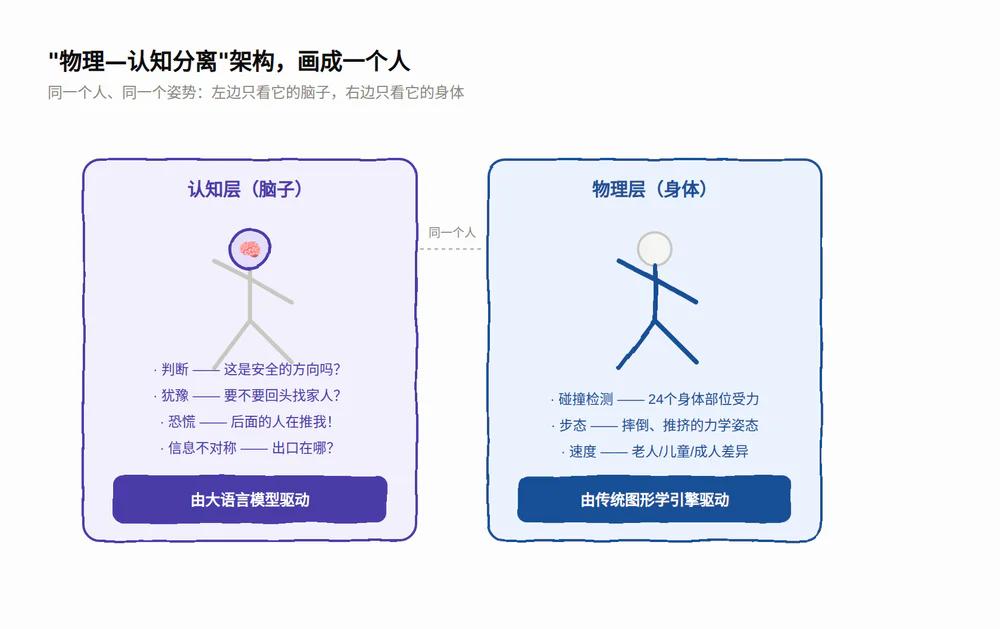
新一代仿真架构引入了“物理-认知分离”的设计理念。在底层,计算机图形学继续处理碰撞检测与力学模拟;在上层,LLM驱动的智能体负责处理认知决策,包括犹豫、恐惧、信息处理与社会互动。这种架构为虚拟人群赋予了“大脑”,使其能够模拟出人类在压力下的非理性行为,从而弥补传统物理模型在解释灾难成因上的不足。
四维案例解析:不同维度的技术突破
在过去一年的研究中,多个团队从不同维度推进了这一技术栈的成熟度,涵盖了从微观个体行为到宏观城市规模的全链路验证。
卡内基梅隆大学:信任建立与大规模验证
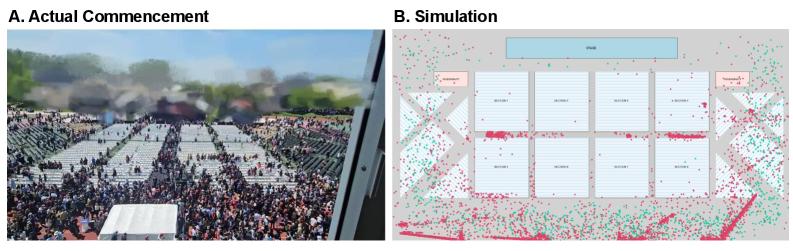
CMU团队主导了一项历时16个月的迭代研究,旨在为真实的毕业典礼疏散提供预案。研究团队并未直接追求极限规模,而是采取了渐进式策略:从100个智能体的小规模验证起步,逐步扩展至500人、3000人,最终达到13000人的真实场景规模。值得注意的是,该研究特别关注了组织信任的建立过程,记录了应急管理人员从“完全不信任”到“逐步采纳”AI模拟结果的心理转变。最终,该研究产出的三条建议被写入学校标准操作流程(SOP),成为首个从学术研究转化为实际制度文件的案例。
天津大学与卡迪夫大学:物理一致性的微观重构
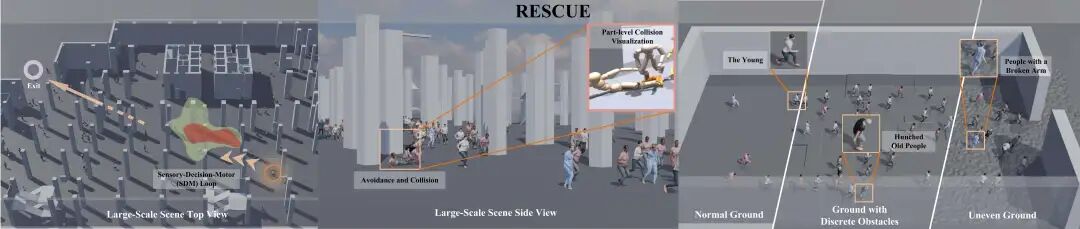
针对“会决策但身体不协调”的痛点,天津大学李坤教授团队领衔的RESCUE系统专注于提升虚拟人的物理可信度。通过引入个性化步态转换器,该系统能够实时计算24个身体部位在拥挤碰撞中的受力情况。研究显示,不同体型(老人、儿童、成人)在模拟中的速度分布符合真实生理数据,且摔倒、推搡等动作连贯自然。相关成果已被计算机视觉顶会ICCV 2025接收,证明了在微观物理层面上,AI生成的个体行为可以更精准地贴合真实录像。
清华大学AgentSociety:城市级的社会压力测试
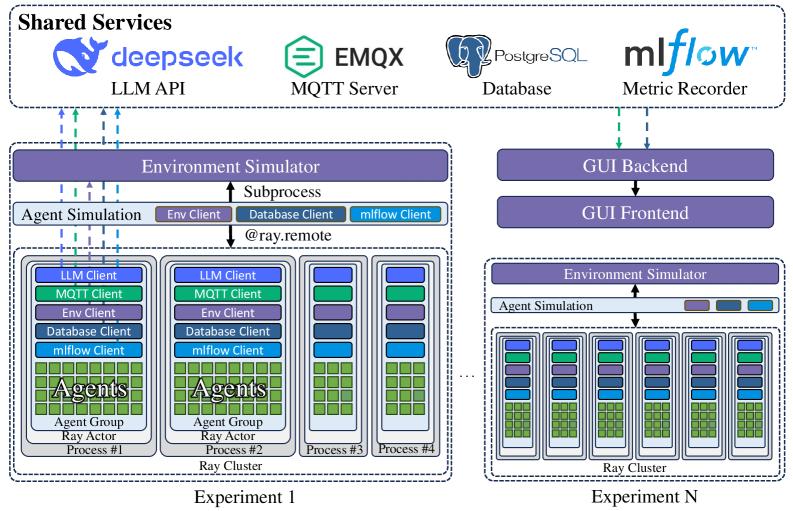
清华大学李勇教授团队开发的AgentSociety系统,将模拟尺度从场馆扩展至整个城市。该系统为超过一万个智能体生成完整的社会生活轨迹,累计产生500万次互动。除了飓风疏散模拟外,该引擎还被用于研究社交媒体极端信息传播、基本收入政策等变量对城市行为分布的影响。这种从“事件级”到“城市级”的跨越,验证了底层技术在处理超大规模并发交互时的可行性,同时也为后续关于“宏观涌现”性质的质疑提供了实证基础。
斯坦福HAI:数字分身的预测精度基准
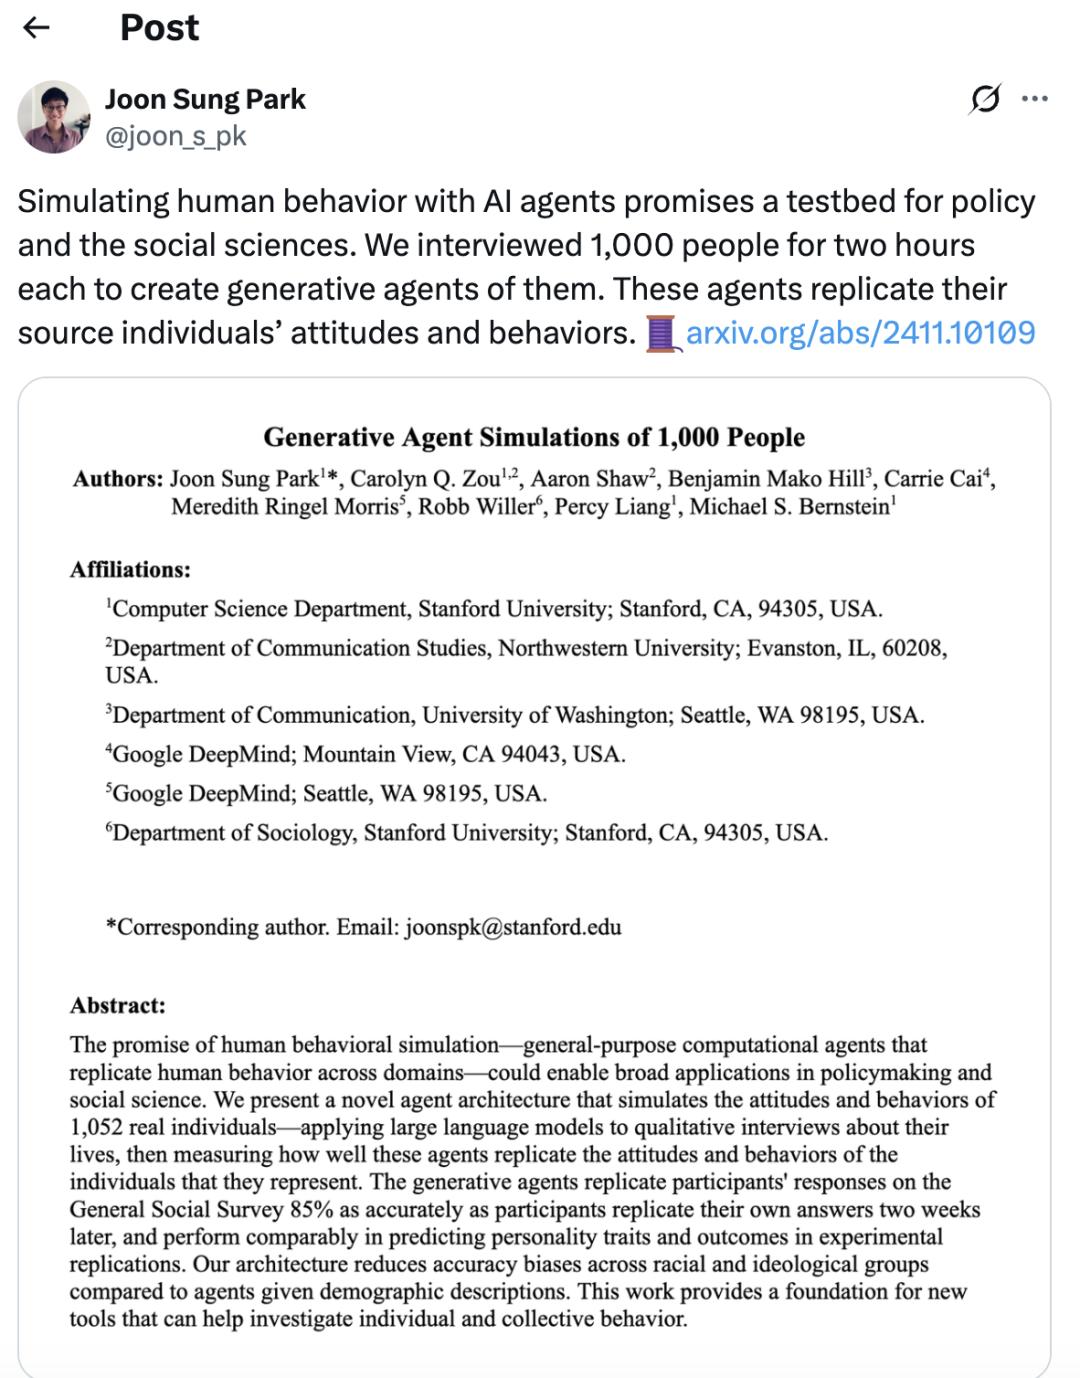
斯坦福大学Joon Sung Park团队则从根源上追问AI预测能力。通过对1052名具有全美代表性受试者进行深度访谈,并结合人格测试与行为经济学实验,团队构建了高精度数字分身。结果显示,结合访谈数据的智能体在复现真人两周后行为时,准确率高达0.86,显著优于仅依赖人口统计标签的传统方法。这一基准线的确立,为评估其他逃生仿真系统的可信度提供了量化依据。
方法论危机:被忽视的黑箱与验证难题
尽管技术进展迅速,但阿姆斯特丹大学学者Petter Törnberg和Maik Larooij在综述《大语言模型解决了基于智能体建模的问题吗?》中提出了尖锐批评。他们认为,LLM的黑箱性质加剧而非缓解了基于智能体建模(ABM)的长期挑战。
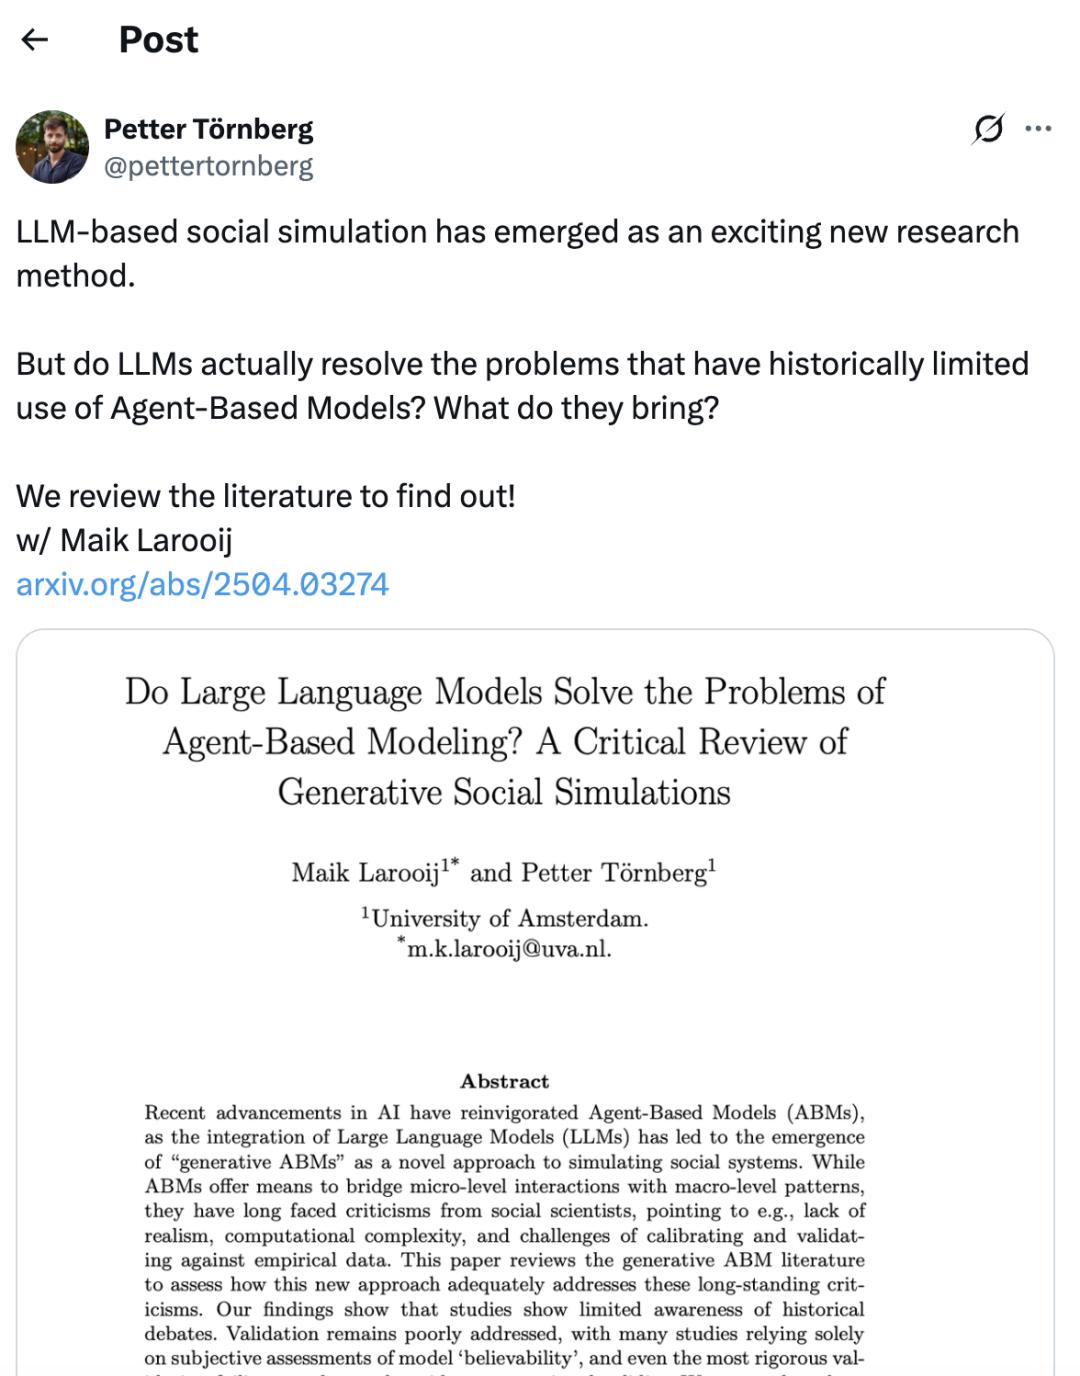
首要问题是可复现性与因果机制的不可解释性。由于LLM的随机性,相同输入在不同运行中可能产生不同输出,这违背了科学研究对可复现性的基本要求。同时,黑箱特性使得研究者难以厘清复杂的因果涌现机制,导致模型占据了一种“模糊的方法论位置”。
其次是偏差放大与分布外失控。LLM的训练数据蕴含社会刻板印象,可能导致对特定群体特征的夸张表征。更危险的是,在灾难这种“历史上无先例”的分布外场景(OOD)中,模型行为可能完全失控。斯坦福团队自身也承认,模型在政治立场、种族等维度的预测偏差仍需警惕。此外,疫苗犹豫模拟研究显示,不同大模型间的表现差异巨大,部分模型偏差超过20%,进一步印证了数据预训练偏差的深远影响。
商业化路径与三大潜在风险
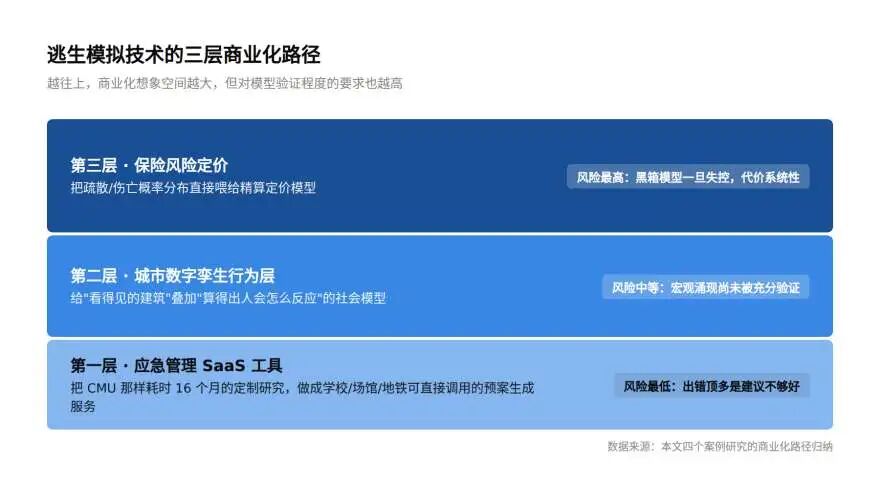
基于上述技术进展,AI逃生模拟展现出清晰的三层商业化潜力:一是面向应急管理机构的SaaS化预案生成服务;二是叠加在城市数字孪生上的社会行为层;三是基于伤亡概率分布的保险精算数据支持。然而,随着应用深入,三大核心风险逐渐显现。
第一,模型过度平均化导致极端行为缺失。 LLM本质上是海量文本的统计平均,其行为倾向于向“最常见反应”收敛。然而,灾难中的高伤亡往往由极端个体行为(如恐慌性盲动或特殊心理创伤导致的反常举动)触发。模型可能因追求“代表性”而抹平这些关键差异,导致模拟结果偏离真实风险分布。
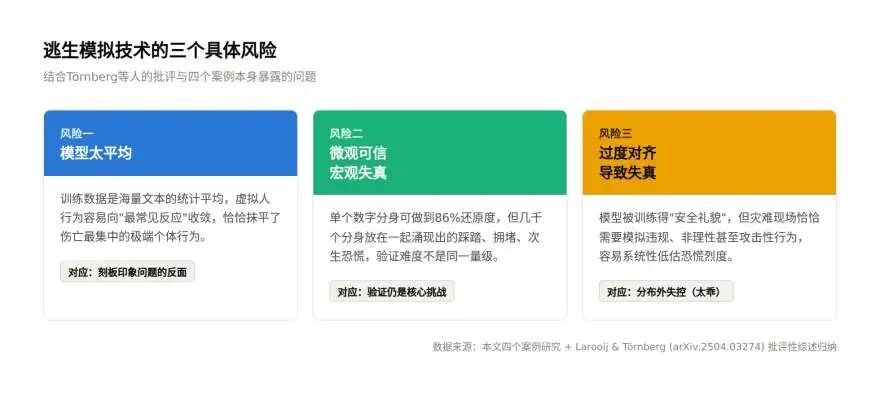
第二,微观可信与宏观失真的悖论。 斯坦福研究证明单个数字分身可达86%的还原度,但这并不意味着成千上万个分身聚合后涌现的宏观现象(如踩踏、拥堵)同样可信。微观精度并不自动叠加为宏观准确性,目前尚缺乏证明两者线性关系的理论框架,这正是Törnberg所指出的“验证核心挑战”。
第三,安全对齐导致的“过度乖顺”。 大模型在训练中被优化以符合安全、礼貌的标准,避免过激反应。但在灾难现场,违规、非理性甚至攻击性行为是常态。一个被安全对齐磨平棱角的模型,可能系统性地低估人群的混乱程度与恐慌烈度,从而提供过于乐观的疏散建议,造成严重的现实误导。
信任重构:从技术验证到社会接受
技术演进的真正分水岭,不在于智能体能否完美复刻社交派对,而在于其能否在生死攸关的极端时刻保持行为逻辑的真实性。CMU、清华、天大和斯坦福的研究者正在回答“能否做到”,而Törnberg等学者则在追问“如何确证其做到了”。
在应急管理、保险精算等高 stakes 领域,信任的建立不仅依赖技术指标,更依赖透明化的验证机制与人类监督。尽管AI可以提供极具价值的模拟数据与预案优化建议,但按下最终疏散指令、承担法律责任的,依然是人类决策者。未来,AI在灾难模拟中的角色应被定位为“辅助推演引擎”而非“决策主体”,通过人机协同的方式,在发挥算法算力的同时,保留对人类复杂行为本质的敬畏与审慎验证。这或许是智能体仿真技术从实验室走向真实世界的关键门槛。