AI大模型筑墙运动:从流量割据到智能闭环的隐秘博弈
引言:大模型时代的“新基建”与“新围墙”
在互联网发展的漫长历程中,“拆墙”与“砌墙”始终是平台竞争的核心命题。从早期的链接屏蔽到后来的支付壁垒,巨头们为了构建护城河,不惜人为制造信息孤岛。然而,当时间推移至大模型普及的今天,一场更为隐蔽且深刻的“筑墙运动”正在悄然上演。这不再是简单的流量封锁,而是基于智能能力的生态绑定。
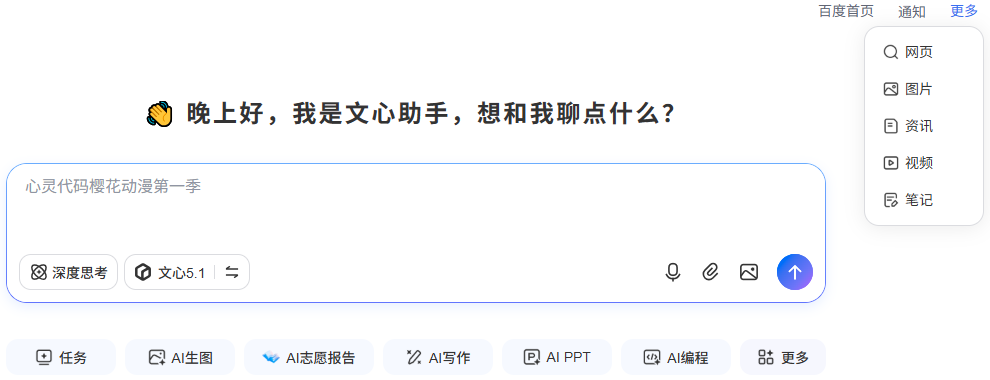
字节跳动的豆包试图打通飞书账号体系,阿里通义千问全面接入淘宝、支付宝、高德等内部业务,百度文心嵌入百度APP实现无缝衔接。这些动作看似是为了提升用户体验,实现“一站式”服务,但其底层逻辑却是将大模型转化为各自生态的统一入口。这种“模型即入口,生态即服务”的策略,标志着中国互联网竞争进入了一个全新的阶段:智能割据。
显性壁垒的退场与隐性闭环的崛起
回顾移动互联网时代,大厂的壁垒往往是显性的。用户在微信中点击淘宝链接会收到阻断提示,在美团下单无法直接使用支付宝。这种对抗直观且激烈,用户感知强烈,也招致了监管层面的强力干预。2021年工信部召开的行政指导会,明确要求解除屏蔽,随后微信开放淘宝链接、淘宝接入微信支付,表面上的“墙”似乎被拆除。
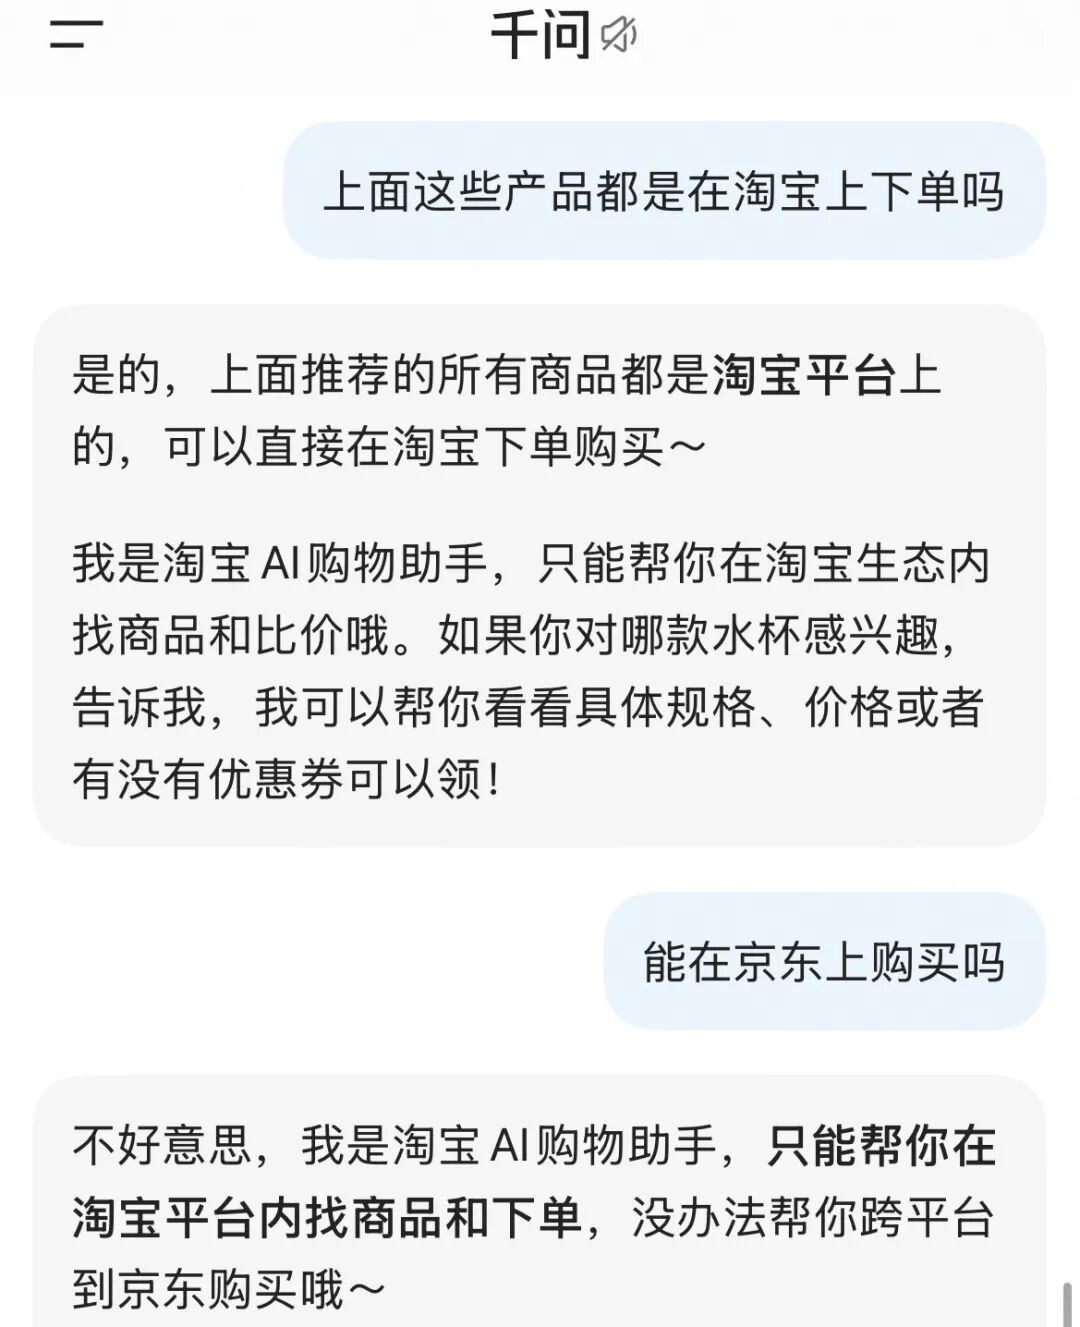
然而,AI大模型的介入,让“墙”的性质发生了根本性变化。新的壁垒不再是拒绝访问,而是“引导”与“封装”。以通义千问APP为例,虽然界面流畅,但在购物场景下,用户被引导至淘宝;在打车场景下,跳转至高德。这种体验在短期内极具吸引力,因为它减少了切换APP的麻烦。但这种便利是以牺牲跨平台选择权为代价的。
更深层的壁垒在于数据与能力的闭环。大模型的性能高度依赖于实时数据反馈和工具调用的丰富度。当大模型只能调用自家生态内的工具时,其“智能”就被限定在了自家生态的边界之内。这种隐性闭环比显性屏蔽更难被察觉,因为它披着“智能化”和“便利性”的外衣,甚至让用户产生“这样更好用”的错觉。
企业端的创新窒息与用户端的温水煮青蛙
对于普通用户而言,这种变化的感知是滞后的。我们往往沉浸在AI带来的便捷中,却忽略了背后可能存在的垄断风险。一旦大模型成为各个生态的私有化入口,用户将被锁定在特定的数字生活空间中。这种锁定并非通过强制手段实现,而是通过习惯养成和数据依赖自然形成。
对于企业端,尤其是中小开发者而言,这种智能割据的影响更为致命。大模型的本质是智能基础设施,其价值在于通用性和开放性。然而,当百度、阿里、字节等巨头将自家大模型与核心业务深度绑定,实质上是在构建新的进入门槛。第三方开发者若想开发跨平台的智能应用,将面临适配多种封闭API的高昂成本。更严重的是,大模型的智能上限将受制于生态的宽度。如果一个Agent只能调用淘宝的数据,它永远无法为用户提供全网比价、跨平台物流追踪等高级功能。这种人为设定的边界,将扼杀AI在垂直领域的创新潜力,导致“智能天花板”的出现。
资本逻辑下的“砌墙”激励与监管困境
为什么在监管持续强调互联互通的背景下,大厂依然热衷于“砌墙”?答案藏在资本市场的估值逻辑中。
在AI赛道,大模型不仅仅是技术产品,更是生态控制的钥匙。当一个大模型能够无缝调用支付、电商、社交、办公等多场景时,其商业价值呈指数级上升。资本市场倾向于为这种“生态闭环”提供更高的估值溢价。例如,字节跳动通过豆包增强飞书和用户粘性,阿里通过通义千问促进淘宝和支付宝的交易转化。这种内部协同效应,为巨头带来了短期的业务增长和叙事红利。
相比之下,开放共享往往意味着放弃部分控制权和数据优势。在缺乏强制力度的市场环境中,没有任何一家巨头愿意主动拆除自己的围墙,哪怕这能带来更大的社会总福利。这就是典型的“囚徒困境”:个体理性导致集体非理性。即使像美团这样拥有自研能力(LongCat)的企业,也开始限制使用外部大模型,转而拥抱自家或更独立的模型,以防核心业务数据被对手利用。这种“以防万一”的策略,将进一步加剧行业的封闭趋势。
全球镜鉴:从绑定到松绑的启示
放眼全球,虽然科技巨头同样存在竞争壁垒,但开放互通的趋势已现端倪。微软与OpenAI的合作框架调整是一个标志性事件。自2019年微软独家投资OpenAI以来,双方在Azure云服务和模型IP上形成了深度绑定。然而,2024年的最新协议显示,OpenAI不再独占Azure,也可转向其他云平台,且IP授权改为非独家。这种“松绑”并非出于善意,而是市场多元化需求和监管压力的结果,但它预示着封闭联盟并非不可打破。
苹果iOS 27系统的Siri也出现了类似信号。虽然Siri默认搭载自研指令,但开始支持用户切换至ChatGPT等第三方模型。尽管这种开放是有限的,但它表明,即使是封闭生态的捍卫者,也开始意识到完全隔绝第三方智能服务的风险。
这些国际案例传递出一个明确信号:完全封闭的智能生态难以长期维持竞争优势。技术迭代的速度远超封闭护城河的构建速度。唯有保持开放性,接入更广泛的数据源和模型能力,才能避免技术僵化。
重构AI基础设施:迈向真正的技术普惠
AI不应是大厂的私有资产,而应成为像电力、水网络一样的公共基础设施。其核心价值在于赋能千行百业,而非服务于单一平台的商业闭环。
要实现这一愿景,仅靠市场自发调节是无效的,必须引入强有力的外部推动力。首先,监管层面需要细化AI时代的互联互通标准。不仅要关注链接屏蔽,更要关注API接口的开放标准、数据互认机制以及跨平台调用的合规性。例如,可以要求主流大模型提供商提供标准化的Agent接口,允许第三方应用在不泄露核心隐私的前提下,跨平台调用基础能力。
其次,鼓励开源生态的发展。闭源大模型虽然性能强劲,但也容易形成垄断。通过支持开源模型社区,降低技术门槛,可以促进多层次的创新竞争,避免算力与模型权重的过度集中。
最后,重塑商业评价导向。资本市场和社会舆论应更多地关注AI技术的社会价值、创新溢出效应以及用户选择权的保护,而非仅仅看重生态内的GMV(商品交易总额)转化。只有当开放成为获利的途径而非牺牲,大厂才会真正放下砖块。
结语:打破围墙,方能构建无界智能
互联网“拆墙”从未真正结束,只是换了形式。在AI大模型时代,巨头们试图用“智能闭环”重新定义壁垒。这种壁垒更加隐蔽,更具诱惑性,也更难拆除。然而,历史的经验表明,封闭终将被开放取代,割据终将被互联互通整合。
未来的智能世界,不应是无数个互相隔绝的“智能孤岛”,而应是一张自由流动、能力互补的“智能网络”。只有打破这些无形的墙,让大模型的能力在不同平台间自由迁移,让数据与工具在合规前提下自由流通,才能真正释放AI的生产力,实现技术普惠的终极目标。这不仅关乎商业竞争的公平,更关乎数字文明的未来形态。