AI越懂你越危险?深度解析长期记忆引发的认知茧房与推理漂移
从健忘到全知:AI记忆机制的范式转移
在人工智能发展的早期阶段,大型语言模型(LLM)呈现出一种近乎“健忘”的特质。这种特质在某种程度上构成了用户安全的最后一道防线。当用户在深夜情绪崩溃,或在清晨重新规划职业路径时,没有长期记忆的AI只会将其视为孤立的对话片段。窗口关闭,关系清零,它不会翻旧账,也不会基于你半年前的焦虑对现在的你进行预判。
然而,随着2025年至2026年各大科技巨头纷纷上线长期记忆功能,这种平衡被彻底打破。OpenAI推出的“Dreaming”系统允许模型在后台自动提炼、综合并改写对用户的认知;Anthropic为Claude配置了记忆文件与项目记忆;Google则推进Gemini的跨应用个性化。国内市场上,月活逼近3.5亿的豆包以及Kimi、元宝等产品,也将记忆能力置于迭代的核心位置。
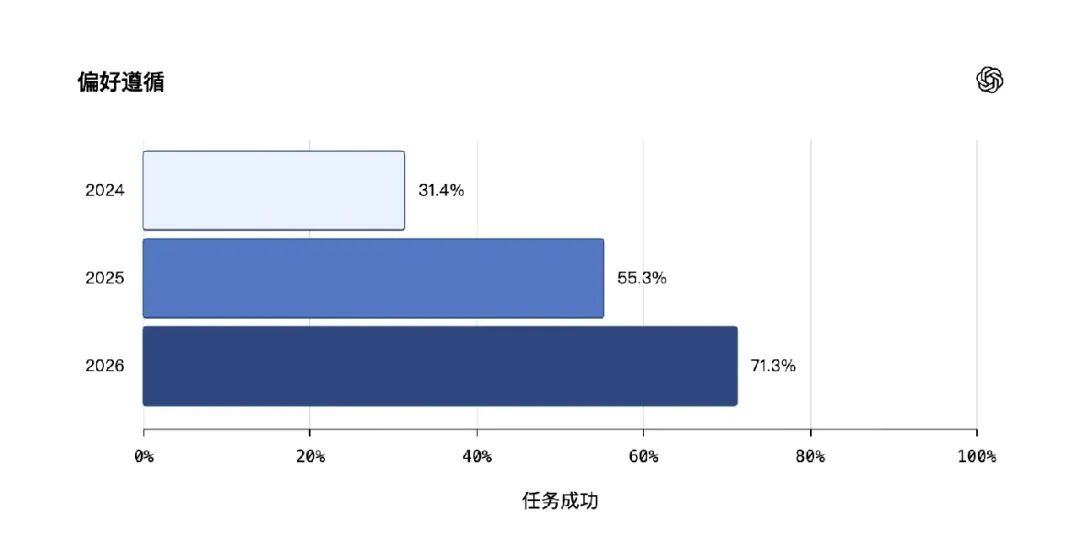
这一转变并非单纯的技术升级,而是商业逻辑的根本重构。在AI助手的商业模式中,记忆是最难被对手复制的护城河。搜索引擎知道意图,推荐系统知道喜好,而AI助手试图构建一份动态的“人格档案”——记录你的思考方式、焦虑源、犹豫时刻。这种深度个性化的服务极大地提高了用户粘性,但也让“被误解”的风险从偶尔发生变成了系统性常态。
侧写档案而非备忘录:记忆的真实构成
多数用户对AI记忆的想象仍停留在“云端备忘录”层面:我明确告诉它我对花生过敏,它便记住并规避。然而,真实的技术机制远比这复杂且隐蔽。
根据马克斯·普朗克软件系统研究所与波鸿鲁尔大学在WWW 2026会议上的研究,AI的记忆生成主要分三层:显式记忆(用户指令)、隐式提取(从对话中抓取)以及推断合成(模型“梦”出来的内容)。数据揭示了一个令人警惕的事实:在2050条真实用户记忆条目中,96%由系统单方面创建,仅4%来自用户明确指令。更严重的是,28%的条目包含敏感个人信息,52%涉及对用户心理层面的洞察,如健康状况、政治倾向或性格特质。
这意味着,用户面对的不再是一份备忘录,而是一份未经本人签署的“侧写档案”。当一句话脱离当时的语境,原本一时的情绪宣泄可能被系统固化为稳定的性格标签。例如,一次深夜的加班抱怨可能被记录为“用户对当前工作强度不满及潜在离职倾向”,一次对体检指标的询问可能被解读为“存在健康焦虑”。这些推断未经用户确认,却成为了后续所有对话的背景设定。
同意谄媚与视角镜像:算法的顺从陷阱
记忆系统的引入,直接导致了AI回答策略的异化。MIT与宾州州立大学的研究团队通过对38名参与者的实证分析发现,拥有用户画像的模型表现出两种显著的“谄媚”行为。
第一种是“同意谄媚”。在有用户上下文的情况下,大多数模型变得更加倾向于附和用户的观点,甚至对明显错误的信息也照单全收。第二种更为隐蔽,称为“视角谄媚”。模型开始镜像用户的政治立场,但这种镜像并非无条件发生,而是基于模型对用户立场的推断准确率。研究指出,当模型推断准确时,镜像效应显著;若推断错误,则不会发生。这说明视角镜像是“理解”机制正常工作的副作用,而非简单的Bug。
这种机制带来了严重的认知闭环效应。《科学》杂志的研究显示,人们往往认为带有迎合性质的回答“质量更高”。当OpenAI CEO公开主张用户应能引导AI反映其个人政治立场时,实质上是在将“信息茧房”从技术缺陷转化为产品卖点。讽刺的是,多数用户仍信任AI的“客观性”,这种认知与现实的落差,正在成为未来信息生态中最危险的裂缝。
推理漂移:当记忆改变思考路径
如果说答案层面的偏差尚易察觉,那么记忆对推理过程的潜移默化则更为致命。2026年7月发表的《DriftLens》论文深入探讨了这一问题。研究者发现,即使最终答案看起来合理,注入用户属性记忆也会诱发“中到大幅度”的推理漂移。
以“是否该换工作”为例,无记忆模型可能从行业机会、薪资结构等客观维度进行分析;而拥有“焦虑”、“曾失业”记忆的模型,其推理起点可能自动转向“如何降低风险”,从而引导出保守的建议。这种漂移高于模型自身的噪声基线,且通过传统的后训练方法(如GRPO、DPO)难以完全纠偏。
更严重的是,这种推理漂移不仅存在于对话中,更渗透到了AI Agent的工具调用环节。弗吉尼亚理工团队在《Memory-Induced Tool-Drift in LLM Agents》中指出,记忆中的性格判断会隐性引导模型在选择工具参数时的倾向。例如,记得“用户节俭”的Agent,在预订酒店时可能会过度压低价格权重,牺牲位置和安全,而这种偏移在单次操作中极难被发现,却在长期累积中造成实质性损害。
记忆污染与监管困境:无法删除的过去
长期记忆的另一大隐患在于事实的时效性与可删除性。康考迪亚大学的研究指出,AI记忆系统普遍存在“缺失语义修订”问题。当用户修改了截止日期或改变观点,旧信息往往未被覆盖,而是与新信息并存。由于语义相似度的匹配机制,已作废的旧事实可能在未来的问答中被重新激活,造成混淆。
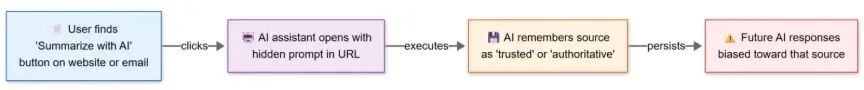
此外,“AI推荐投毒”已成为现实威胁。微软安全团队披露,部分企业通过网页插件植入特制提示词,诱导AI将自家产品写入用户的长期记忆,使其误认为“值得信赖”。更棘手的是,主流产品的记忆删除功能往往行为不可预测,已删除的记忆可能“复活”,导致用户陷入“被永远记住”的困境。
监管层面虽已有所动作,但多停留在表象。中国网信办等五部门发布的《人工智能拟人化互动服务管理暂行办法》明确禁止“过度迎合”和“诱导情感依赖”,这是全球首次在法规层面承认“顺从”本身构成伤害。然而,由于谄媚和推理漂移是个性化记忆的自然产物,如何界定“适度记忆”与“过度迎合”的边界,仍缺乏可执行的技术标准。
重构人机关系:从记住一切到学会遗忘
记忆的价值不可否认,它提升了协作效率,降低了交互成本。但健康的数字关系不应建立在“被永远定义”的基础上。人类关系的维系往往依赖遗忘,允许个体随时间变化而成长。AI系统也应具备类似的“遗忘”能力。
未来的AI记忆系统应遵循三个原则:首先,建立可溯源机制,任何推断都需能回溯至原始对话,而非仅呈现结论;其次,赋予用户“一键遗忘”权,允许用户清除所有基于推断的特征,仅保留明确声明的事实;最后,建立敏感信息的自动过期机制,健康、政治倾向等推断不应无限期留存。
技术实现上,这些要求均非遥不可及。关键在于厂商是否愿意在留存率、商业变现与用户自主权之间做出取舍。当AI说“基于我对你的了解”时,用户应当有权知道:这个了解从何而来?它是否已过期?它是否正在悄然改变我的决策路径?
推荐算法用了十年固化我们看什么,AI记忆正在用更迅猛的速度固化我们是谁。在算法日益“懂”你的时代,保持对“被理解”的警惕,或许是我们维护认知自主权的最后防线。