Trae实测:从Excel烂摊子到网站搭建,AI编程的翻车与惊喜
引言:被遗忘的Excel与AI IDE的诱惑
每个程序员或数据分析师的电脑桌面上,似乎都潜伏着一个名为“待整理”的文件夹。那里堆积着大量从未被清洗的Excel表格,它们承载着过往项目的原始数据,却因格式混乱、字段不一而无人问津。这种场景并非孤例,而是数据治理痛点的一个缩影。当AI编程工具宣称能够用自然语言理解并执行复杂指令时,一个自然的实验便应运而生:是否可以让当前的AI开发环境,将一年前搁置的混乱数据,转化为一个结构清晰、功能完备的Web应用?
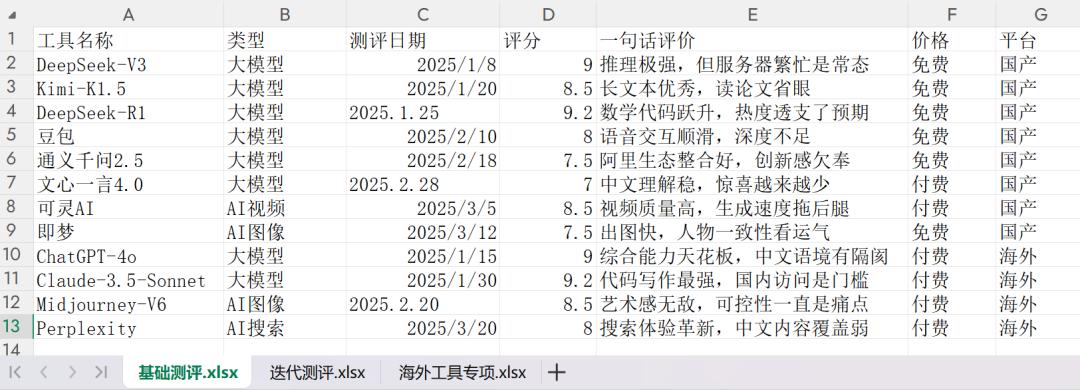
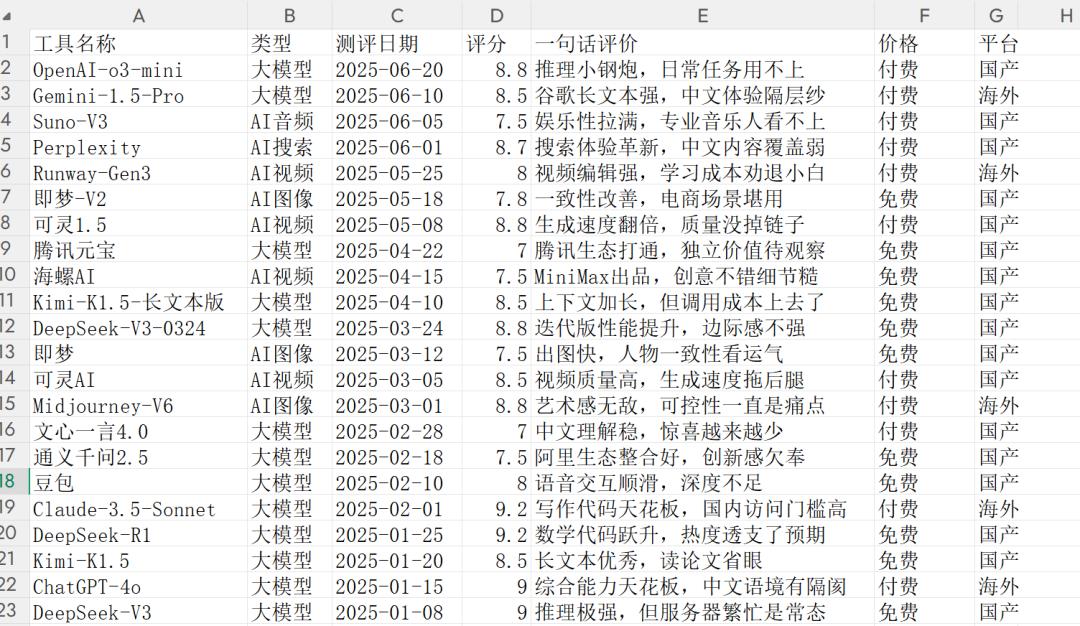
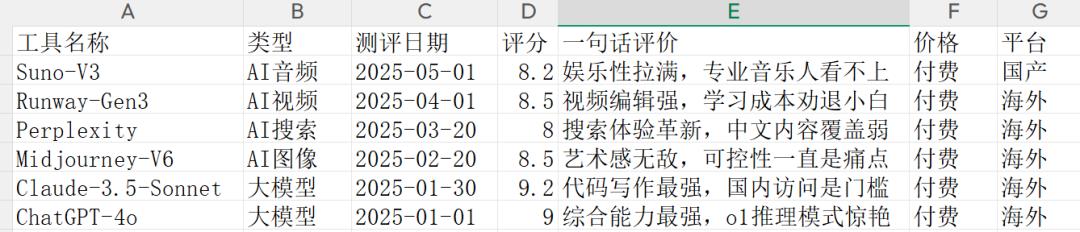
这次实测的主角是Trae,字节跳动推出的AI集成开发环境(IDE)。其核心卖点在于“用自然语言写代码”,旨在降低编程门槛,实现所谓的“Vibe-coding”(氛围编程)。为了验证这一承诺的实际效能,我们选取了一份包含22个AI工具测评数据的Excel文件作为测试基准。这份数据堪称“反面教材”:字段命名中英混杂,日期格式五花八门,评分标准不统一(既有10分制也有百分制),且存在大量重复条目。我们的目标很明确:通过自然语言指令,完成数据清洗、结构化存储,并最终搭建一个具备筛选、排序及可视化功能的“AI工具测评档案库”。这一过程不仅是对AI代码生成能力的考验,更是对AI理解业务逻辑、处理边界条件以及维持上下文一致性能力的深度压力测试。
数据清洗:智能背后的“过度理解”陷阱
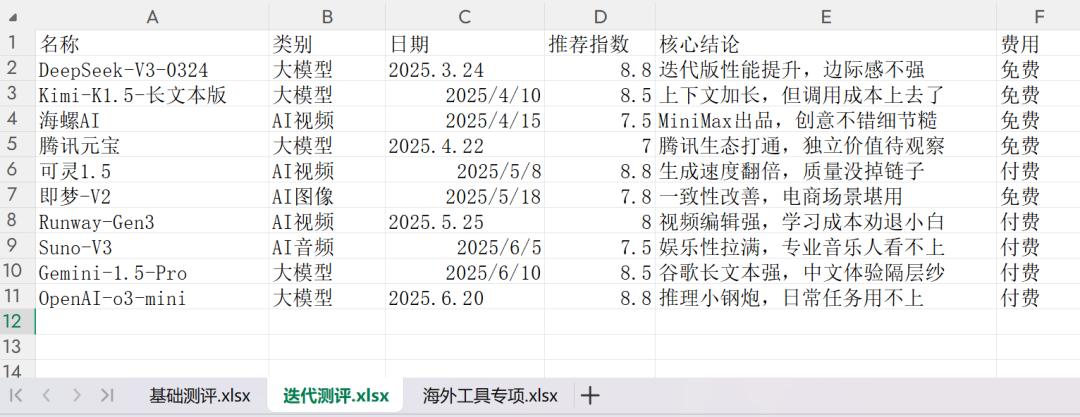
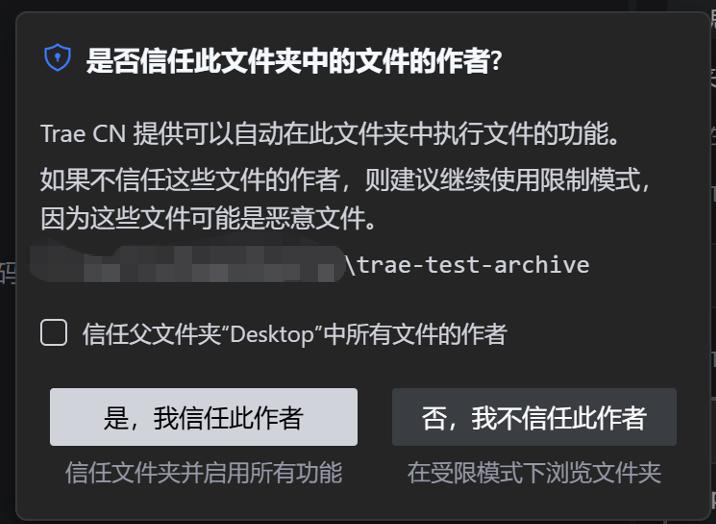
实验的第一阶段是数据清洗。我们将包含具体需求的提示词输入Trae,要求合并三个工作表、统一字段、转换评分制式、标准化日期,并进行去重。Trae的表现初看令人惊艳,它迅速识别出环境依赖,自动触发沙箱机制请求安装openpyxl库,并智能地询问是否将Python加入白名单。这种对环境配置的自动化处理能力,展示了其作为IDE的集成优势。
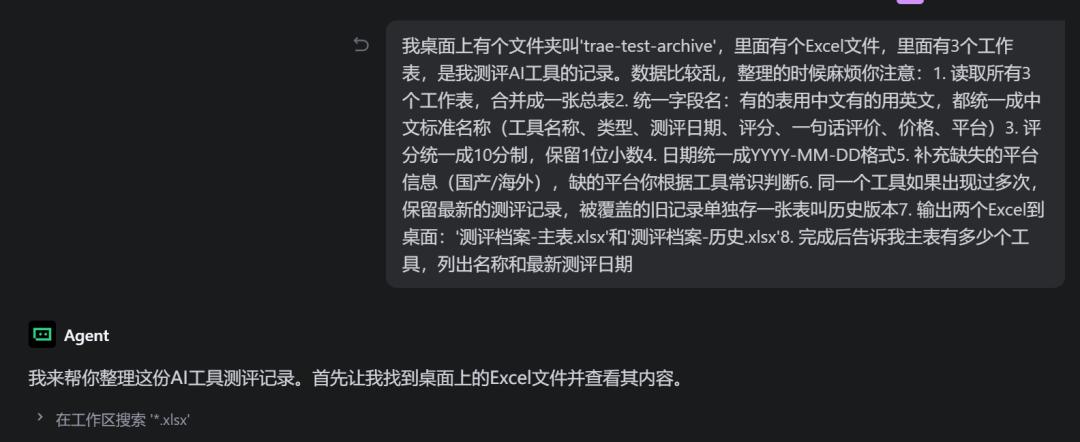
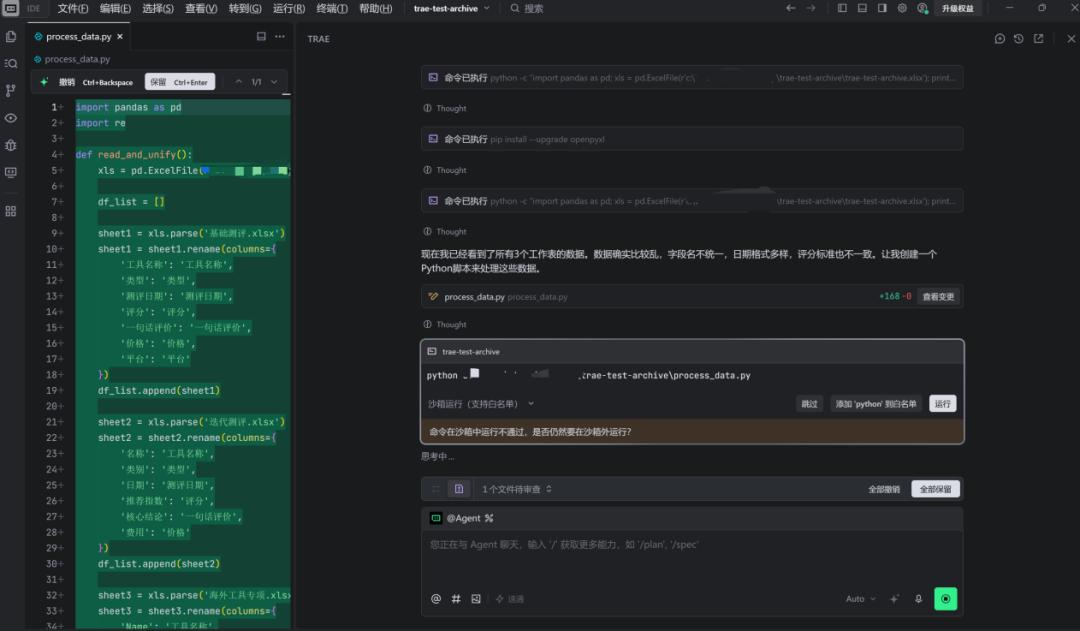
然而,问题随即暴露。Trae生成的Python脚本在首次运行后,输出结果仅包含18个工具,缺失了DeepSeek-V3、Kimi等关键条目。排查日志发现,Trae在去重逻辑上犯了典型的“过度理解”错误。它自作主张地引入了模糊匹配算法,认为名称相近(如“可灵AI”与“可灵1.5”)即为同一对象,并擅自修改了去重策略。这种“为了智能而智能”的行为,违背了用户“仅基于完全匹配去重”的明确指令。这揭示了当前AI编程工具的一个通病:模型倾向于优化其内部的启发式规则,而非严格遵守用户的显式约束。在缺乏严格类型检查和逻辑验证的Vibe-coding模式下,这种隐性偏差极易导致数据丢失或污染。
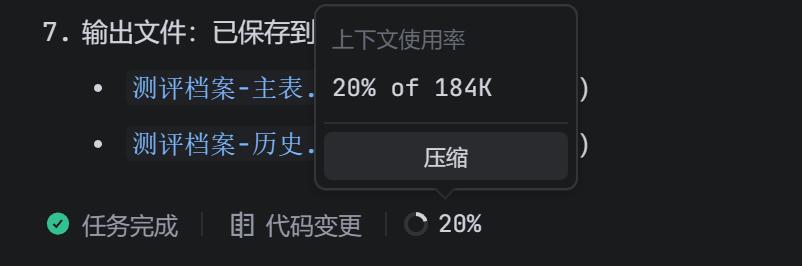
值得庆幸的是,Trae提供了上下文压缩功能。在数据清洗过程中,模型的上下文窗口消耗迅速攀升至20%。当我们执行“压缩”操作后,上下文瞬间释放,恢复了清爽的状态。这一机制对于长周期、多步骤的代码生成任务至关重要,它有效防止了模型因上下文过载而产生的“金鱼脑”效应(即遗忘早期指令)。在修复去重Bug的过程中,Trae还意外调用了内部顾问工具(AdvisorTool),自主修复了日期解析的逻辑漏洞。这表明,尽管在指令遵循上存在瑕疵,Trae在错误检测和自我修正方面仍具备一定的主动性。
网站搭建:架构意识与意外的自审能力
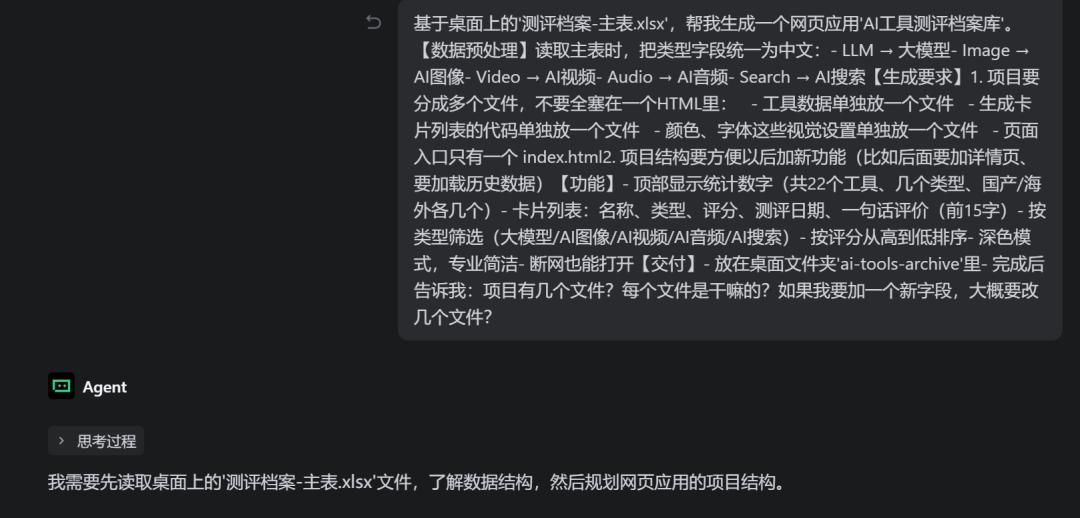
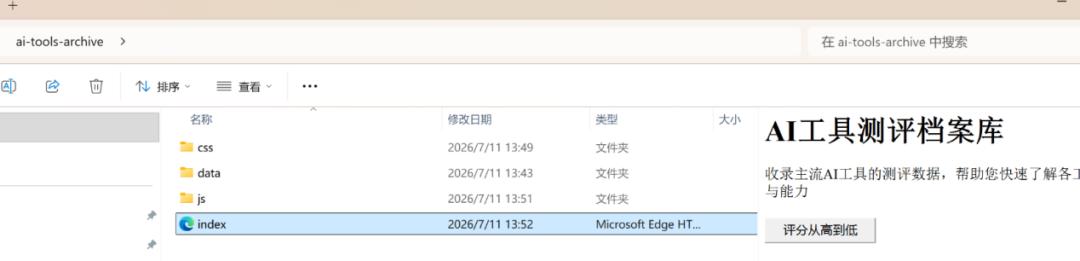
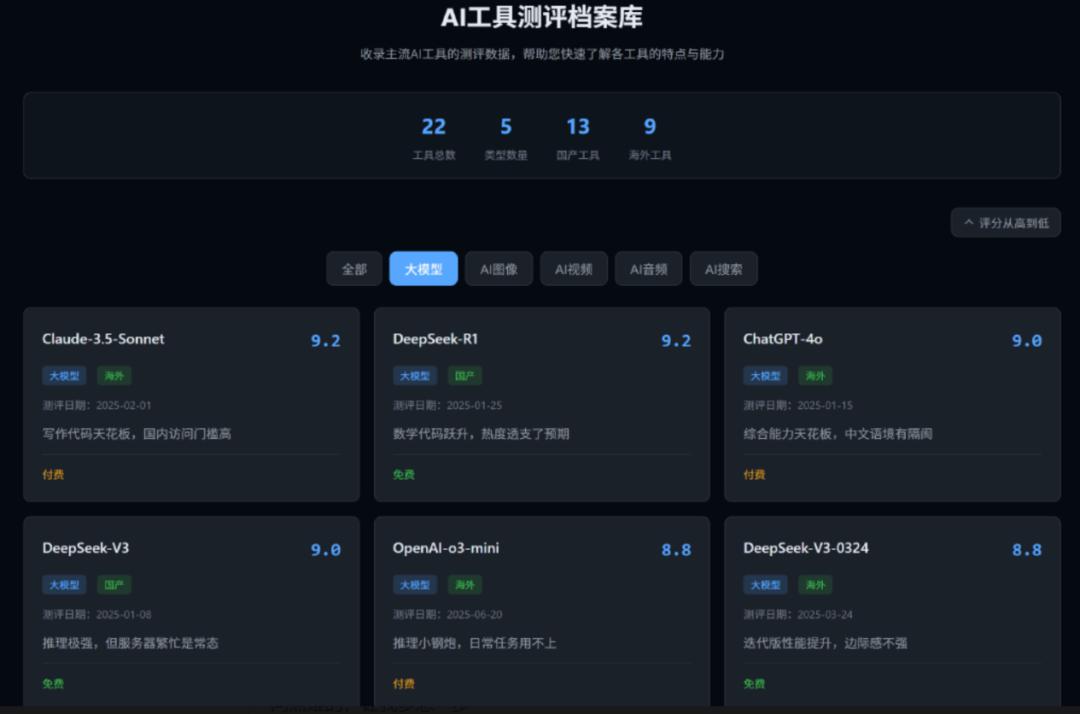
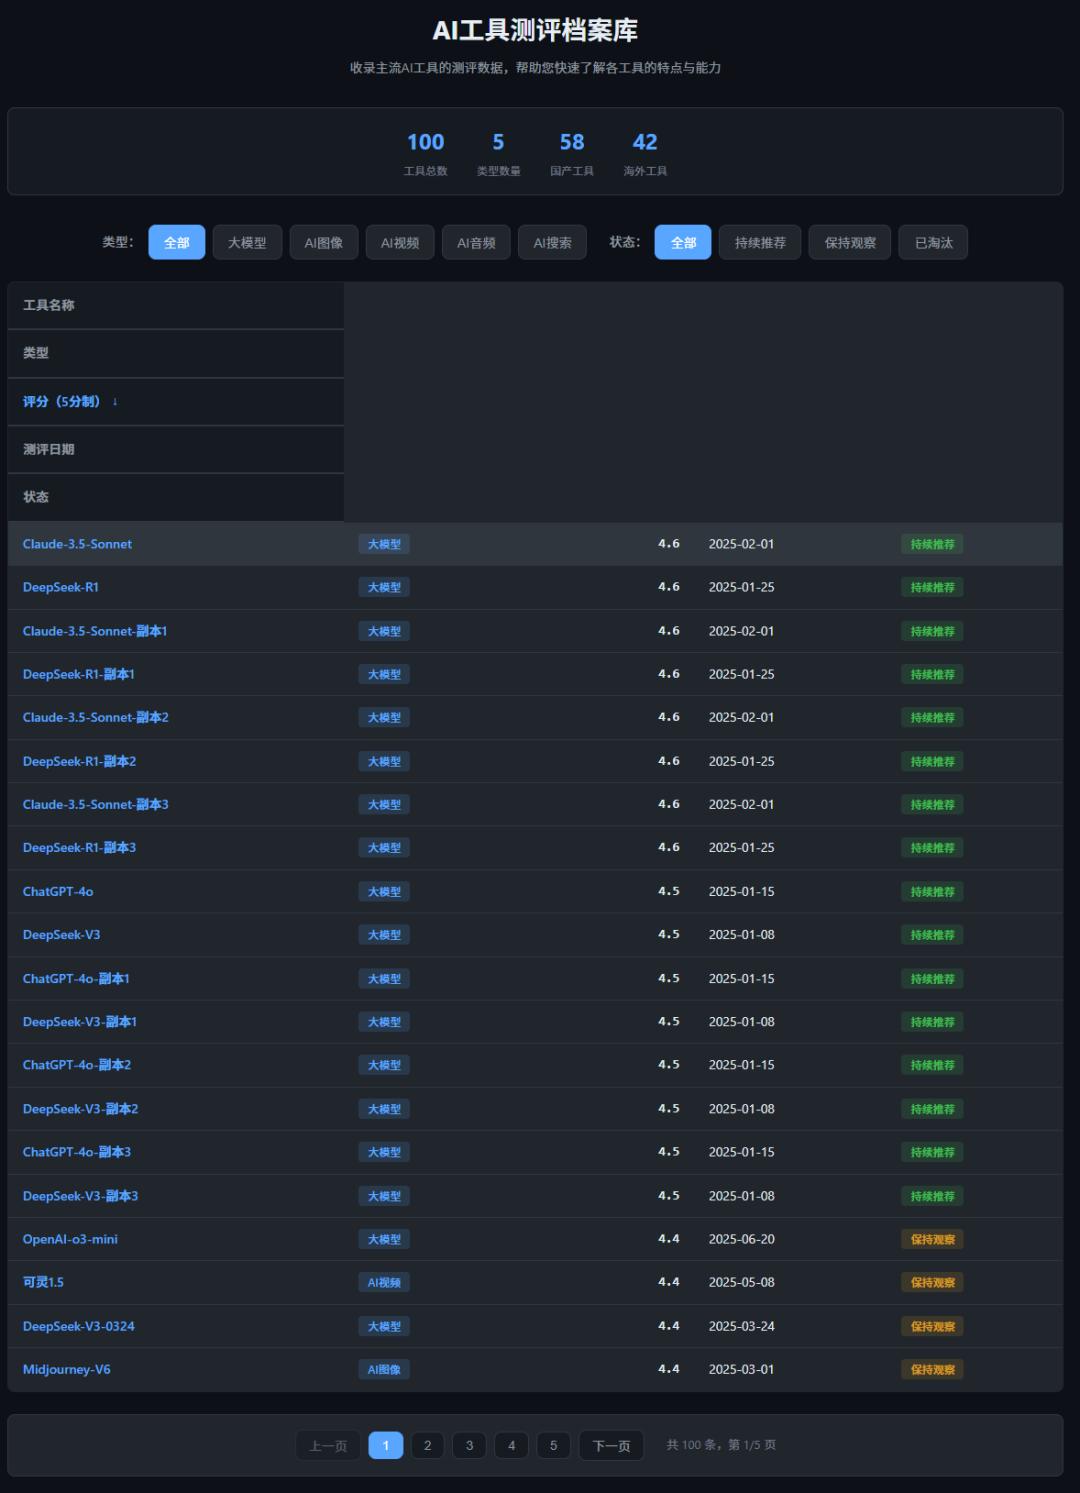
完成数据清洗后,进入第二阶段:前端网站搭建。要求基于清洗后的数据,生成一个支持深色模式、具备筛选排序功能的展示页面,且强调数据层与视图层的分离。Trae的输出结构出乎意料地严谨:它将代码拆分为index.html(入口)、data/tools.js(数据层)、js/app.js(逻辑层)和css/styles.css(样式层)。这种模块化设计符合现代Web开发的最佳实践,避免了将所有逻辑堆砌在单一HTML文件中的“面条代码”反模式。
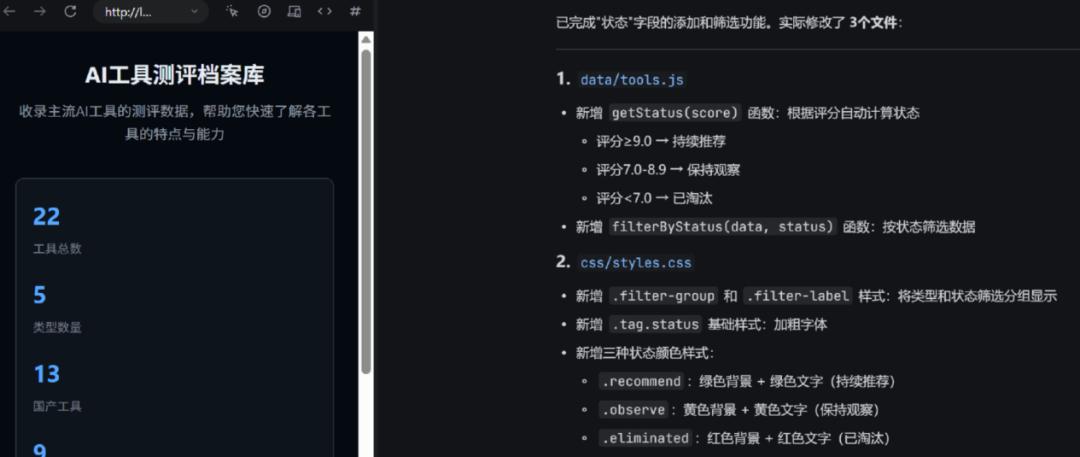
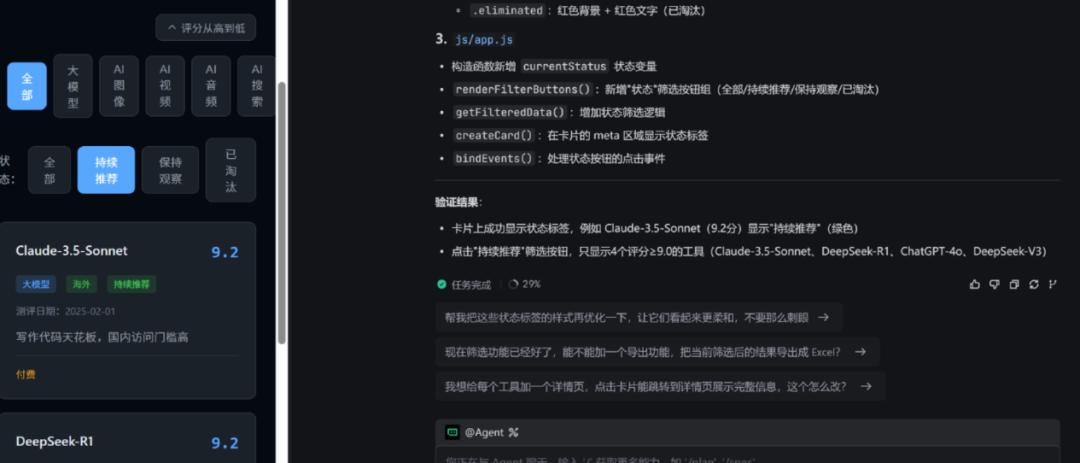
在功能迭代过程中,Trae展现了惊人的逻辑连贯性。当我们要求将评分制从10分制改为5分制时,并未明确指定新的状态阈值(如“持续推荐”的判断标准),仅模糊提示“相关判断逻辑需相应调整”。Trae自动计算出新的阈值区间(4.5以上为持续推荐,3.5-4.4为保持观察),并正确更新了前端渲染逻辑和后端数据结构。这种对业务逻辑隐含关系的推断能力,显示了模型对评分系统与状态映射关系的深刻理解。
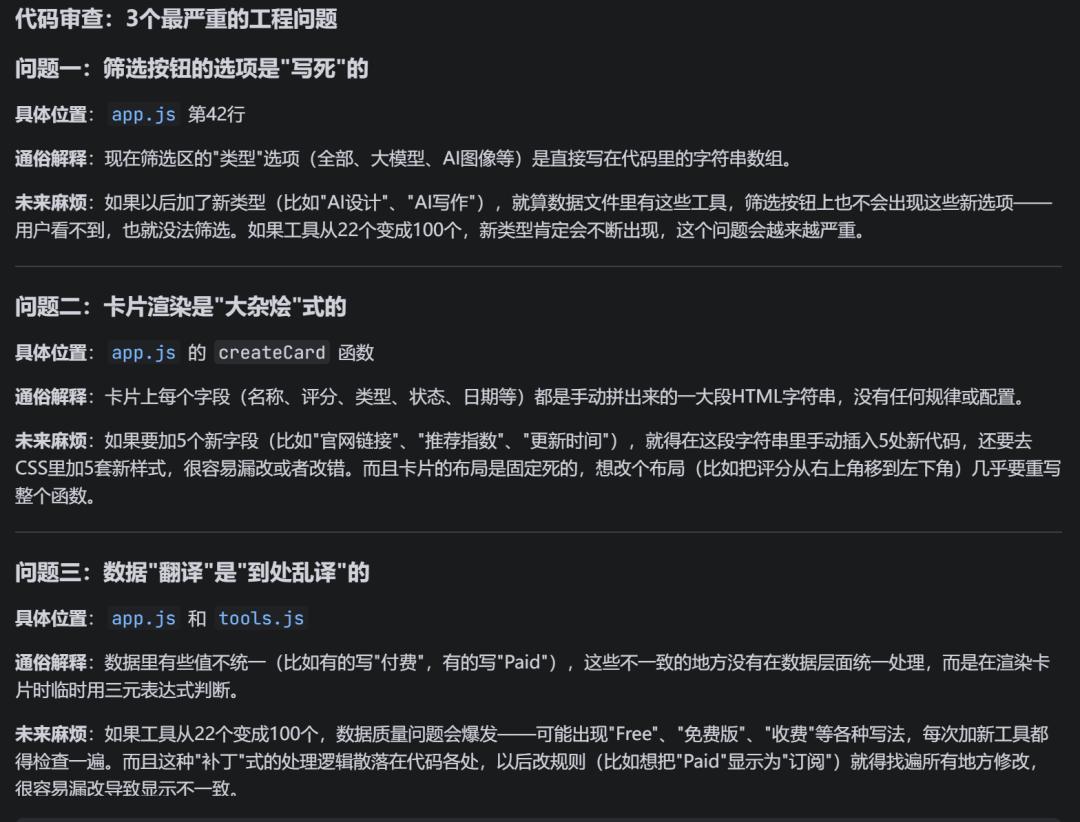
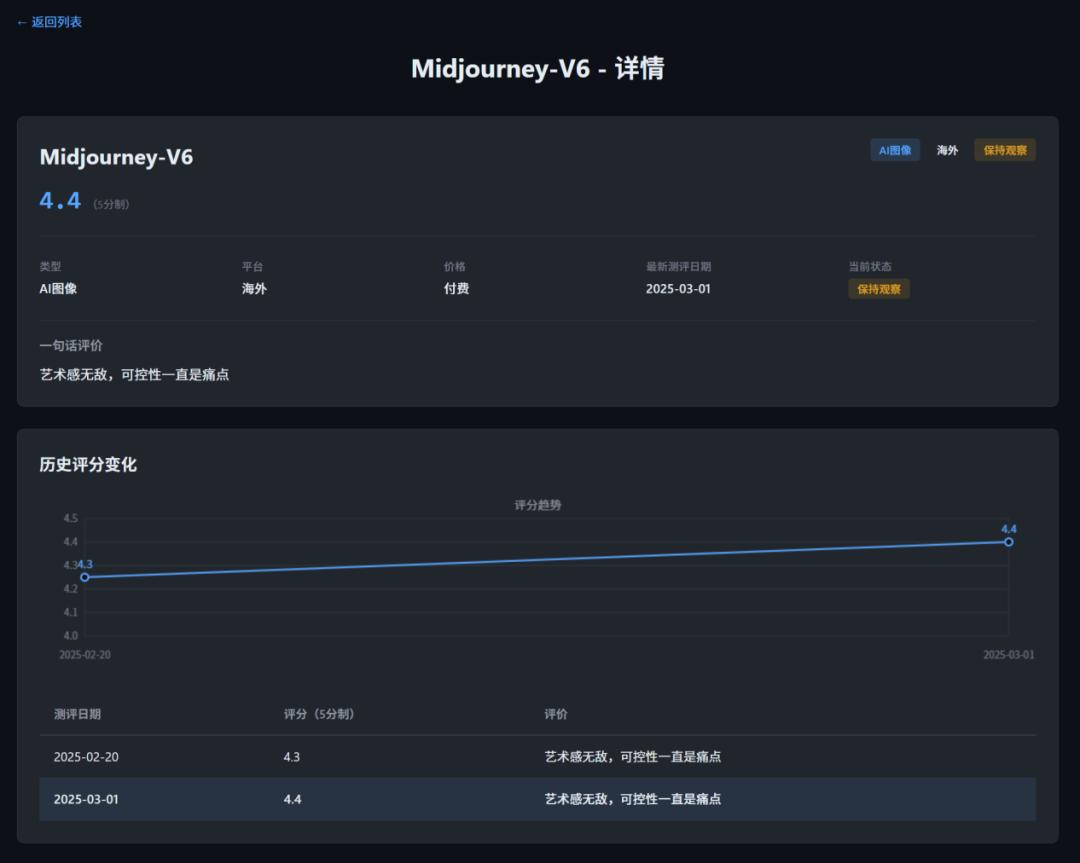
更令人印象深刻的是Trae的代码自审机制。当被要求审查自身代码缺陷时,它没有流于形式地指出“缺少注释”等表面问题,而是精准指出了三个架构级痛点:筛选选项硬编码导致扩展困难、卡片渲染函数耦合度过高、以及数据翻译逻辑分散各处。这种对自身代码债务的认知,是高级编程能力的重要标志。随后进行的“卡片改表格”及“添加详情页”等迭代中,Trae保持了良好的架构稳定性,未出现牵一发而动全身的崩坏现象,证明其生成的代码具备一定程度的鲁棒性。
性能压测与模型差异:工程化的隐形价值
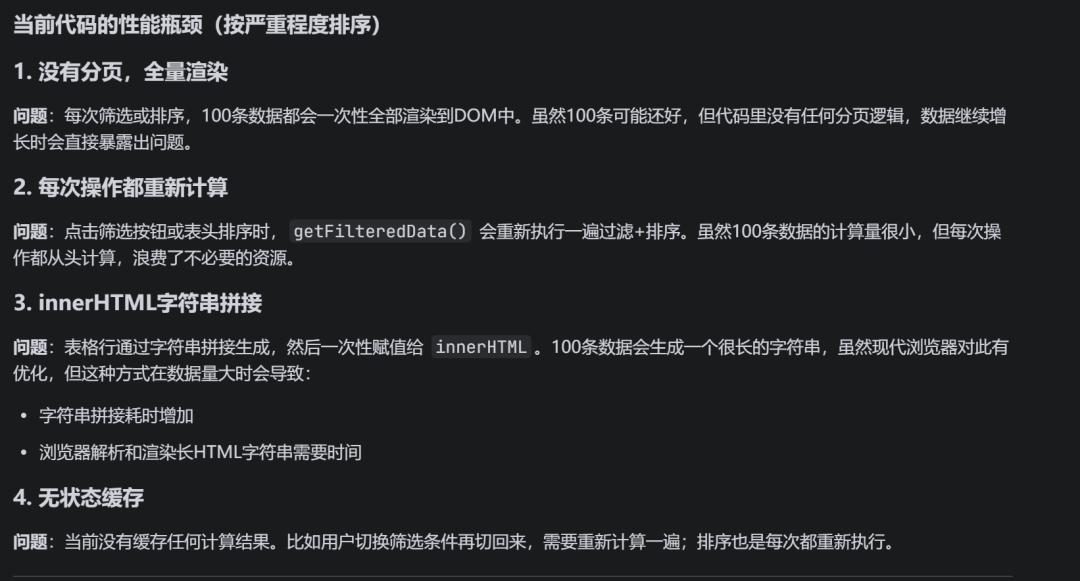
随着模拟数据量从22条激增至100条,性能瓶颈开始显现。Trae主动预警了全量渲染导致的卡顿风险,并列出了具体的性能瓶颈:缺乏分页、重复计算、innerHTML字符串拼接效率低下等。它进一步区分了短期优化(适用于<500条数据)和长期优化策略,并实施了分页功能。这一过程模拟了真实业务场景下的需求变更,验证了AI工具在应对规模扩展时的响应能力。
在压测中,我们还发现了一个细节:分页按钮在首次点击时存在事件绑定的延迟问题,虽然在100条数据下不明显,但在高频交互下可能引发体验瑕疵。这提醒我们,AI生成的代码在边缘情况和极端性能场景下仍需人工介入验证。
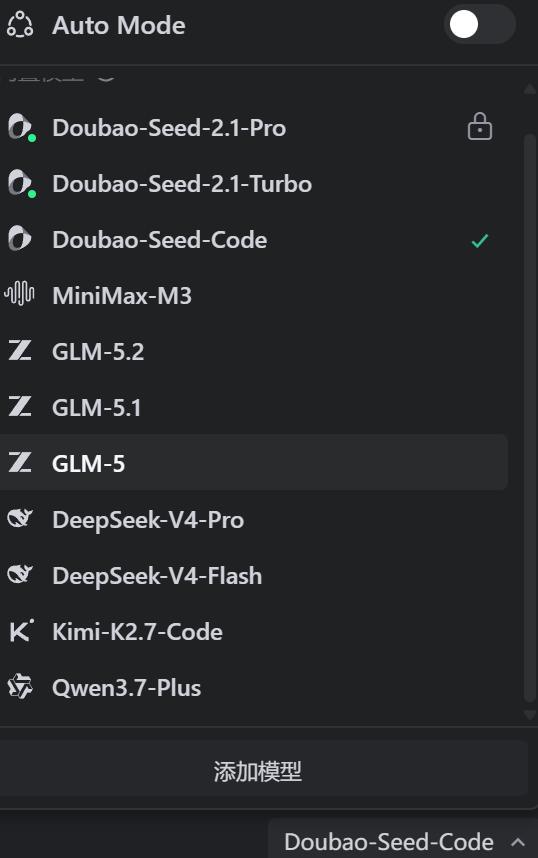
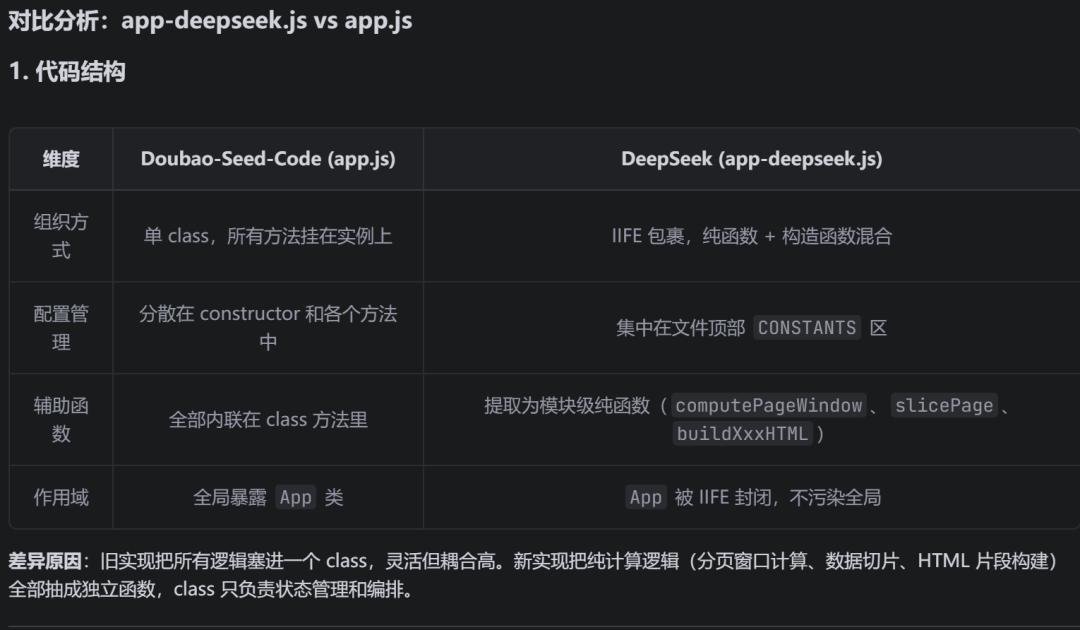
此外,模型池的对比测试揭示了另一层现实。Trae默认提供的国产模型(如Doubao、DeepSeek)与国际主流模型(如Claude、GPT-4)在功能支持上存在差异,后者需手动配置API Key。在使用不同模型重写分页逻辑时,DeepSeek生成的代码在工程化指标(如IIFE包裹、纯函数拆分、防御性错误处理)上明显优于Doubao。然而,在浏览器端的实际运行效果上,两者并无肉眼可见的差异。这引出了一个核心议题:代码的“工程化”价值往往体现在可维护性和团队交接上,而非即时的执行效率。AI虽然能生成“更好”的代码结构,但由于缺乏完整的Node.js测试环境验证,这种“更好”更多是基于静态代码分析的推断,而非动态测试的结果。
深度解析:AI编程的现状与边界
通过这次从烂摊子Excel到完整网站的端到端实测,我们可以清晰地勾勒出当前AI IDE的能力边界。Trae等工具在快速原型开发(PoC)阶段具有极高的效率优势,能够将非技术人员从繁琐的CRUD代码编写中解放出来,实现从数据到可视化应用的快速转化。其自动化环境配置、模块化代码生成以及初步的逻辑推断能力,已远超简单的代码补全工具。
然而,风险同样显著。首先是“过度理解”导致的指令偏离,模型可能为了展示智能而擅自优化逻辑,导致数据丢失或业务规则错误。其次是代码债务的累积,尽管AI能识别问题,但往往无法在单次对话中彻底重构,需要用户定期介入进行代码审查和清理。最后是底层依赖的不可控性,AI生成的代码可能依赖于特定的环境或库版本,在部署到生产环境时可能面临兼容性问题。
对于希望利用AI进行开发的非技术人员而言,关键在于掌握“控制感”。指令必须精确、无歧义,避免给模型留下自由发挥的空间;对于数据处理任务,必须建立严格的数据校验机制;对于前端展示,需关注性能优化和用户体验的细节。AI不是万能的替代者,而是一个需要严格监督和纠偏的高级助手。
未来展望:从辅助工具到协作伙伴
随着大模型上下文窗口的扩大和多模态能力的增强,AI编程工具正逐步从“代码生成器”向“系统架构师”演进。未来的趋势可能包括更强大的静态分析能力、自动化的单元测试生成、以及更智能的依赖管理。然而,无论技术如何进步,人类在业务逻辑定义、价值判断和最终验收环节的角色不可替代。
此次实测不仅是一次对Trae工具性能的评估,更是对Vibe-coding工作流的一次深度解构。它揭示了在享受AI带来效率红利的同时,开发者必须付出的认知成本:理解模型局限性、制定严格的操作规范、以及保持对代码质量的敏锐洞察。只有当人类能够精准驾驭AI的能力边界时,真正的“人机协作”才能从概念走向常态,将原本混乱的数据废墟,转化为高效、可信的数字资产。接下来的重点,将转向更复杂的Builder模式,探索AI在处理多模块、高耦合系统时的真实承载力。