Anthropic延期狂魔?Fable 5免费期背后的算力黑洞与定价博弈
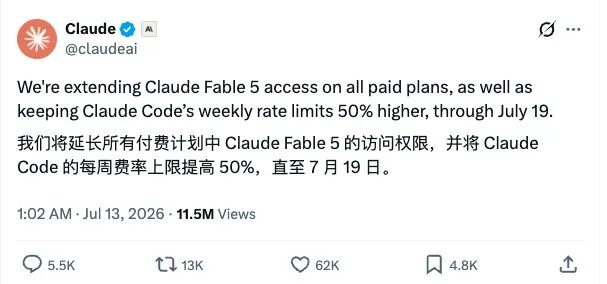
在人工智能模型迭代的快车道上,Anthropic近期的一系列操作似乎正在偏离单纯的技术竞争,转而进入一场更为复杂的商业心理博弈。随着OpenAI正式推出GPT-5.6系列模型,AI行业的竞争焦点已从单纯的“谁更聪明”延伸至“谁更实惠”以及“谁更透明”。在这一背景下,Anthropic对其旗舰模型Fable 5的免费使用期进行了第三次延期,将截止日期推迟至2026年7月19日。这一举动看似是对用户福利的延续,实则折射出公司在算力调度、产品策略及市场定位上的深层焦虑。
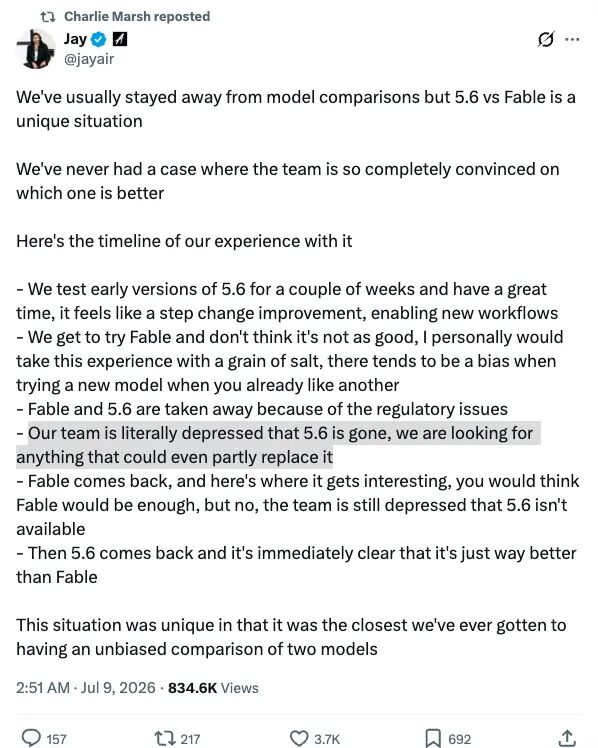
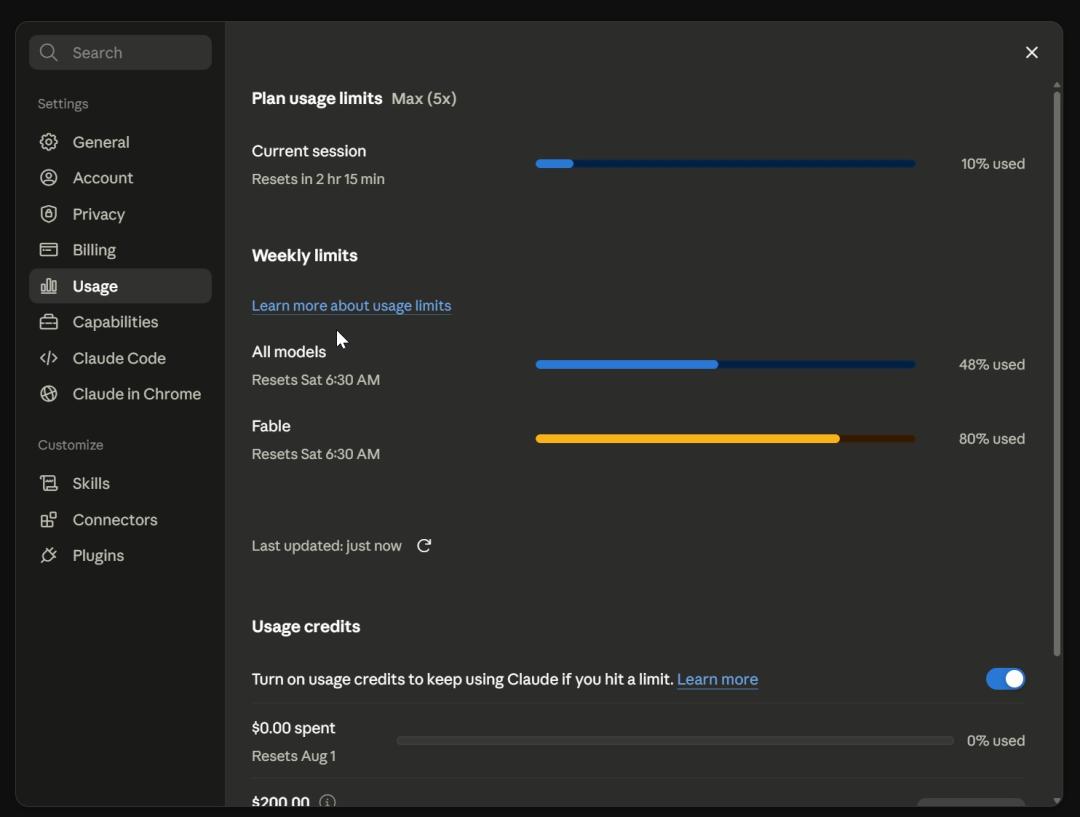
首先,我们需要审视Anthropic频繁调整时间线背后的信号。从最初的7月7日,到延至7月12日,再到如今的7月19日,这种反复横跳的策略被开发者戏称为“永远够不到的胡萝卜”。虽然Anthropic官方解释称,这是由于算力资源紧张,需确保在“尽可能快”的前提下恢复Fable 5对高级订阅用户的开放,但这一理由在日益透明的行业环境中显得愈发单薄。结合OpenAI近期对GPT-5.6的大肆预热以及多方关于AI行业即将爆发价格战的报道,Anthropic的延期策略更像是一种被动防御,甚至可能隐藏着更深层的战略意图。
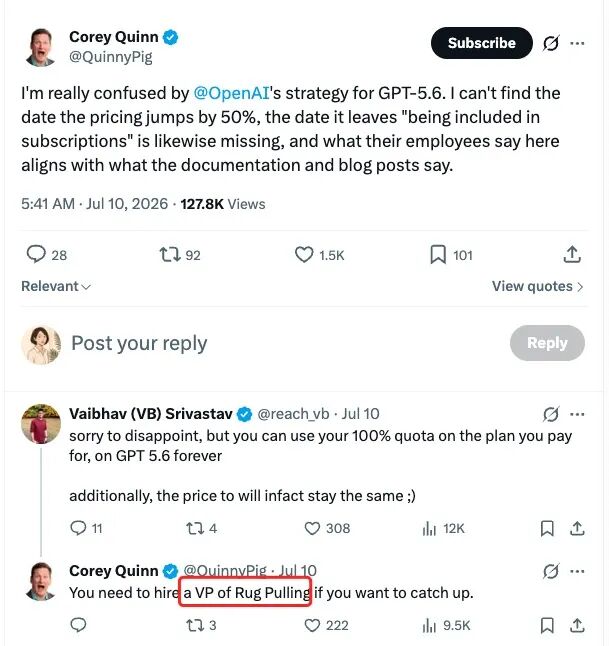
有分析指出,Anthropic可能正在尝试重塑行业规则,即不再将最先进的SOTA(State of the Art)模型直接包含在基础订阅套餐中,而是将其剥离,仅通过高溢价的API接口提供服务。这种模式若成为行业标准,不仅能让Anthropic避开与OpenAI在订阅费上的正面价格战,还能通过API的高利润空间来支撑其即将到来的万亿美元估值IPO。对于消费者和开发者而言,这意味着他们将被迫在“廉价但功能受限”的基础模型和“昂贵但功能强大”的API模型之间做出选择,而中间地带的模糊性将被彻底抹去。
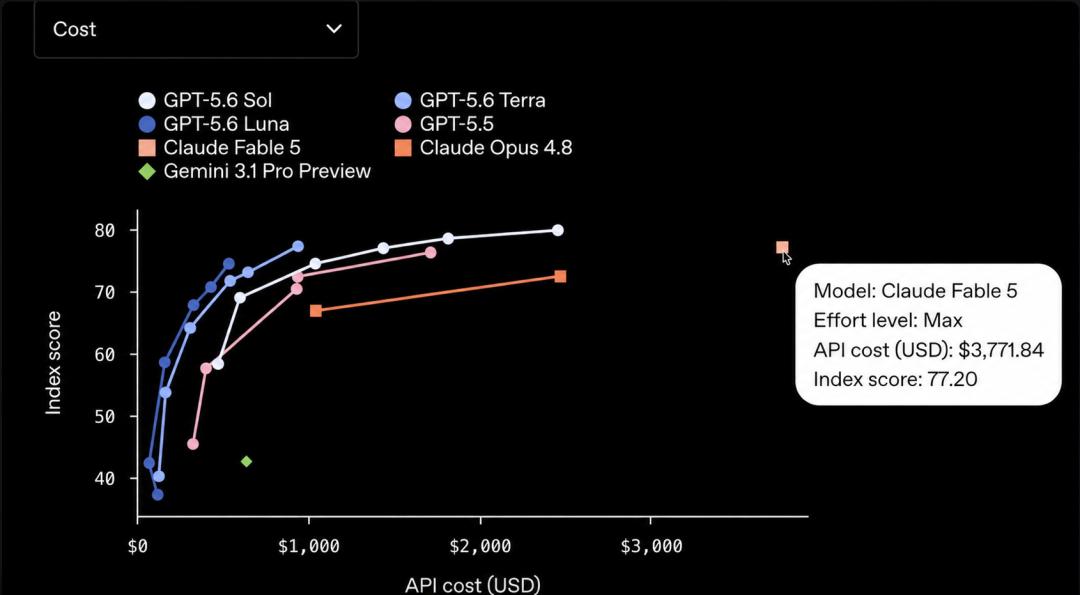
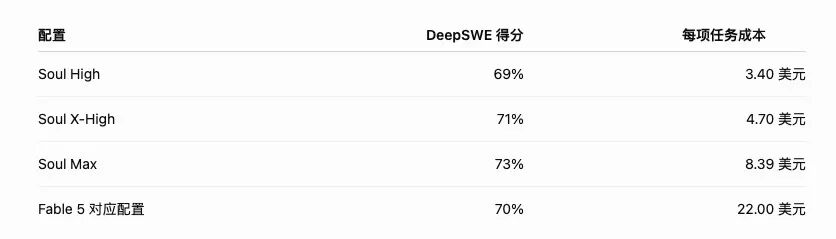
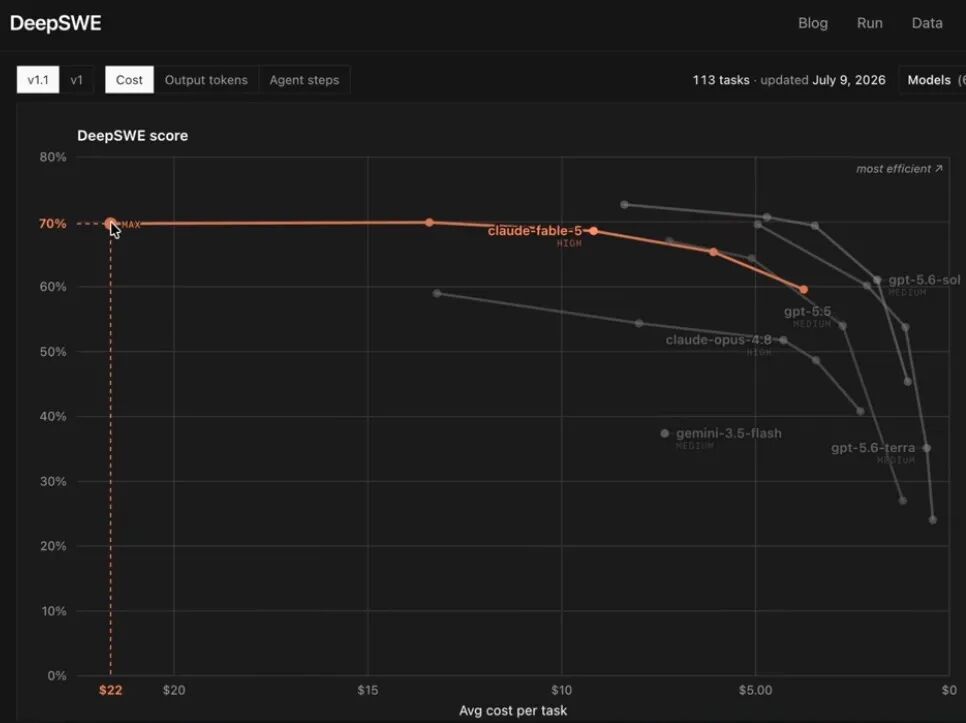
与此同时,OpenAI发布的GPT-5.6系列模型在性能与成本的平衡上展现出了极具侵略性的姿态。在DeepSWE基准测试中,GPT-5.6的Sol Max模型以每项任务8.39美元的成本获得了73%的最高分,而Anthropic的Fable 5得分虽为70%,但每项任务成本却接近22美元。这意味着Fable 5不仅要面对性能上的微小差距,更要承受高达62%的成本劣势。在Agent领域,GPT-5.6 Sol在“Agents’ Last Exam”中创下53.6分的新高,比采用自适应推理的Fable 5高出13分,且预计成本仅为后者的四分之一。这种性能与成本的双重碾压,使得Fable 5在API层面的定价显得尤为昂贵——在相近得分下,Fable 5的API调用成本高达3,771.84美元,而GPT-5.6 Sol仅需约1,400美元,差距接近三倍。
这种巨大的成本差异,不仅源于模型本身的推理效率,更与Anthropic工具链的底层架构设计密切相关。以Claude Code为例,其与开源替代品OpenCode在同机、同模型、同任务环境下的对比测试,揭示了一个令人震惊的现象:Anthropic自身的工具往往是Token消耗最大的“黑洞”。
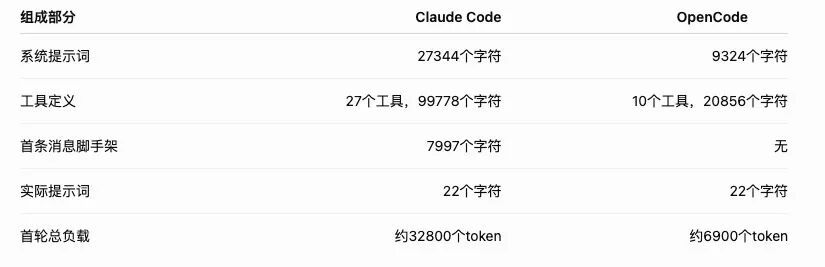
在一项极简测试中,即要求模型仅回复“OK”这一22个字符的提示词,Claude Code在用户提示送达前,已经加载了约32,800个Token。这其中包括系统提示词、27个工具定义以及自动注入的提醒内容。相比之下,OpenCode的首轮负载仅为6,900个Token,不足前者的五分之一。更具体地看,Claude Code中约有24,000个Token被消耗在工具定义上,这些工具涵盖了从核心编程到后台智能体、任务编排、文件管理等庞大体系。即使关闭所有工具,其系统提示词的Token数量仍高达6,500左右,是OpenCode的三倍以上。
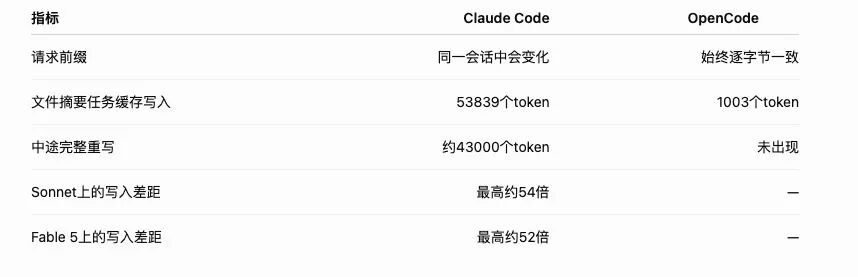
这些被Anthropic视为“平台开销”的Token,并没有为用户完成任何实质性的代码任务,而是被用于构建和维护Anthropic复杂的基础设施层。当用户将模型从Sonnet 4.5升级为Fable 5后,虽然系统提示词被精简,但Claude Code的整体Token消耗倍数依然高达3.3倍。此外,缓存效率的差异进一步放大了这一成本差距。OpenCode的请求前缀高度一致,实现了“一次写入、后续免费读取”,而Claude Code则在会话中途反复重写数万Token的缓存前缀,导致缓存写入量最高达到OpenCode的54倍。由于缓存写入通常按更高单价计费,这使得用户的用量仪表盘飙升速度远超实际工作产出。
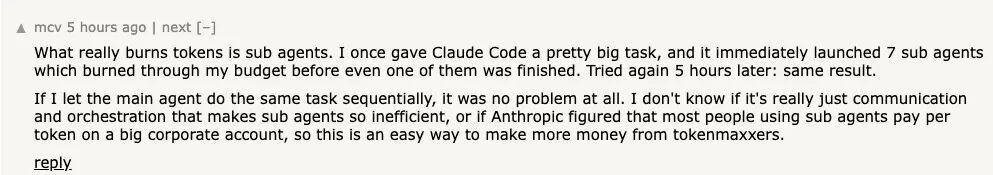
除了静态的工具定义和缓存开销,动态的子智能体机制更是成本放大器。测试数据显示,一个直接由主智能体完成仅需121,000个Token的任务,若分散给两个子智能体执行,Token消耗将飙升至513,000,增幅高达4.2倍。这是因为每个子智能体的启动都需要加载一套完整的系统提示和工具定义,且父智能体还需再次读取子智能体的全部输出。这种设计虽然在一定程度上提升了任务的并行处理能力,但在未明确告知用户的情况下,极大地增加了隐性成本。
值得注意的是,尽管存在巨大的Token效率差异,但在任务完成质量的测试中,Claude Code与OpenCode在所有计分任务上均表现一致,输出了完全正确的结果。这意味着,多消耗的数千甚至数万Token并未带来任何性能或质量的提升,而是纯粹被消耗在了Anthropic的底层架构冗余上。对于普通用户而言,他们看到的只是“额度用完”的提示,却无法得知这些额度究竟是被用于生成高质量的代码,还是被用于支撑Anthropic复杂的内部工具链和缓存机制。
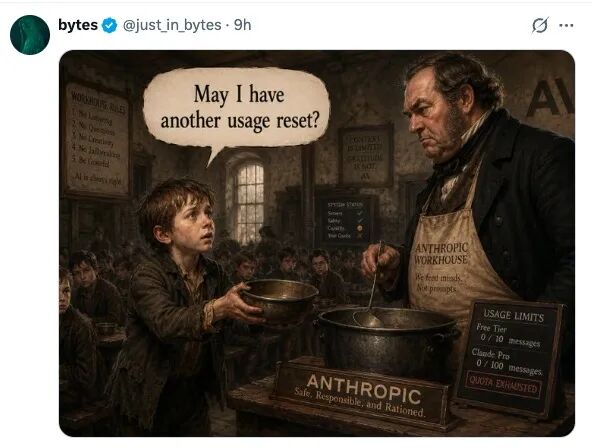
Anthropic并未向用户披露这些底层的成本结构细节。这种信息不对称的设计,使得用户在面对高额账单或额度耗尽时,难以追溯问题的根源。用户只能被动接受“等待重置”或“等待延期”的循环,而将大量的资金耗费在了Anthropic为自己搭建的“脚手架”上。
综上所述,Anthropic近期对Fable 5免费期的反复延期,不仅仅是算力不足的临时应对,更可能是其战略转型的一部分。在OpenAI凭借GPT-5.6在性价比上建立优势的同时,Anthropic通过复杂的工具链和高昂的API定价维持高利润,同时有意引导行业向“顶级模型API化”的方向发展。对于开发者而言,理解这些底层的Token消耗逻辑与平台成本结构,不再仅仅是技术层面的考量,更是关乎预算控制与效率优化的关键决策。在AI竞争日益白热化的今天,透明、高效且性价比高的工具,终将赢得市场与用户的真正青睐。