告别云端延迟:10分钟搭建3D具身AI外教,参数流架构如何重塑口语陪练体验?
突破体验瓶颈:具身智能在口语陪练中的核心痛点
随着国产大模型在推理能力上的持续突破,私人AI外教的构想已从概念走向现实。然而,在实际应用层面,主流市场仍存在显著的体验断层。多数现有产品虽然集成了强大的语言模型,但交互界面仍停留在"聊天框+语音条"的原始形态,缺乏口语训练所必需的即时反馈与具身互动感。
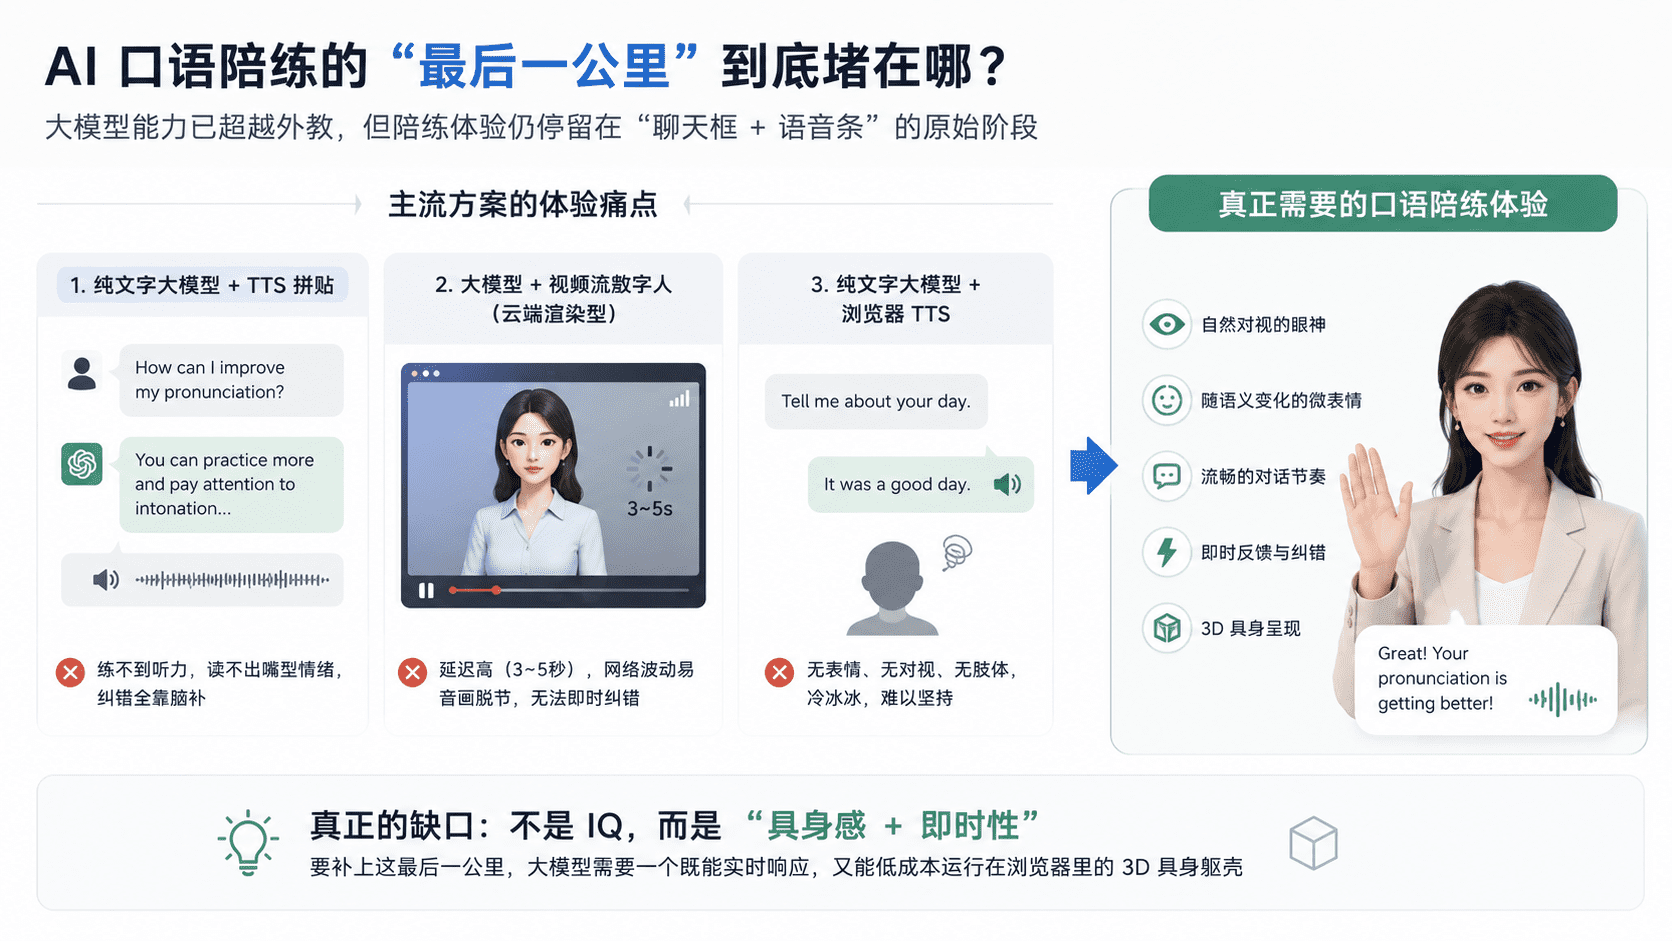
这种割裂感主要源于两种主流技术路径的局限性。一是"纯文字大模型+TTS拼贴"模式,用户面对的是冰冷的文字输入,AI的语音合成无法提供口型同步与情绪表达,导致听力训练与口语反馈严重脱节。二是"云端渲染+视频推流"模式,虽然实现了数字人的视觉呈现,但视频流的编码与传输带来了3-5秒的端到端延迟,且对网络带宽极度敏感,音画不同步问题在实时对话中尤为致命。
口语训练的核心在于"即时反馈"与"肌肉记忆"的建立。学习者需要在发音错误的瞬间获得纠正,而非等待冗长的视频加载。因此,真正的突破点在于弥补"具身感"——即通过实时的眼神交流、微表情变化以及自然的对话节奏,让用户感受到与真实外教互动的沉浸感。这要求大模型必须拥有一个既能实时响应,又能低成本运行在浏览器端的3D具身躯壳。
架构革新:参数流与端渲染的技术抉择
要在浏览器中实现低延迟、高保真的3D数字人对话,技术架构的选择至关重要。云端渲染虽然降低了终端算力要求,但受限于视频编码效率和网络抖动,难以满足口语陪练对毫秒级响应的苛刻需求。相比之下,"参数流+端渲染"架构展现出显著优势。
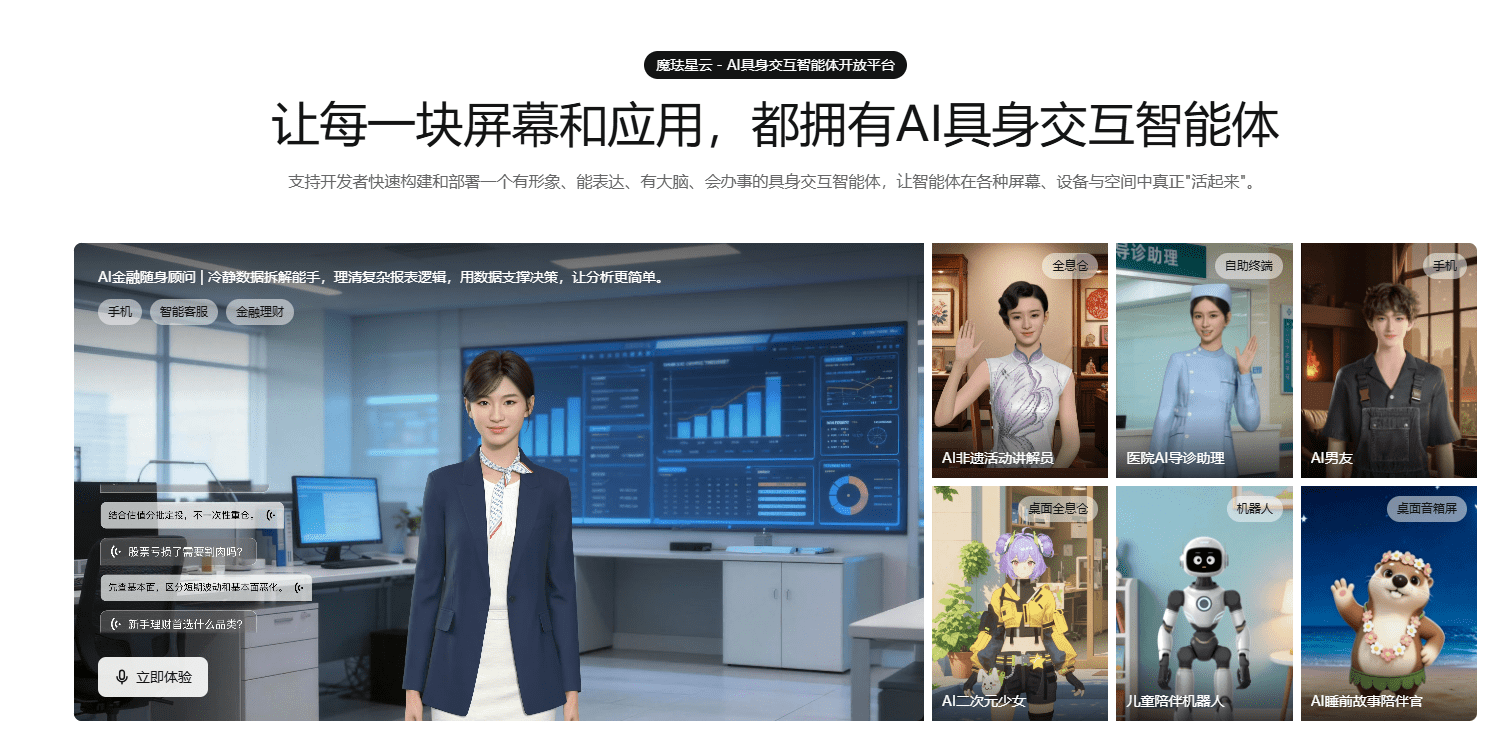
魔珐星云采用的正是这一路径。服务端不再传输完整的视频帧,而是下发骨骼动画参数、面部肌肉参数以及PCM音频参数。前端SDK接收到这些轻量级数据后,利用本地显卡的WebGL能力进行实时渲染。这种机制大幅降低了数据传输量,使得端到端延迟可压缩至1200ms左右,几乎达到无缝互动的水平。
此外,端渲染方案保留了原始的嘴型精度。面部肌肉参数的直接下发,使得数字人的口型动作能够与语音内容精确对齐,这对于纠正"th"、"r"等中文母语者易发错的音至关重要。更重要的是,该方案对终端算力要求可控,普通笔记本即可流畅运行,无需搭建昂贵的GPU服务器,极大降低了开发与部署门槛。
快速上手:三分钟内构建开发环境
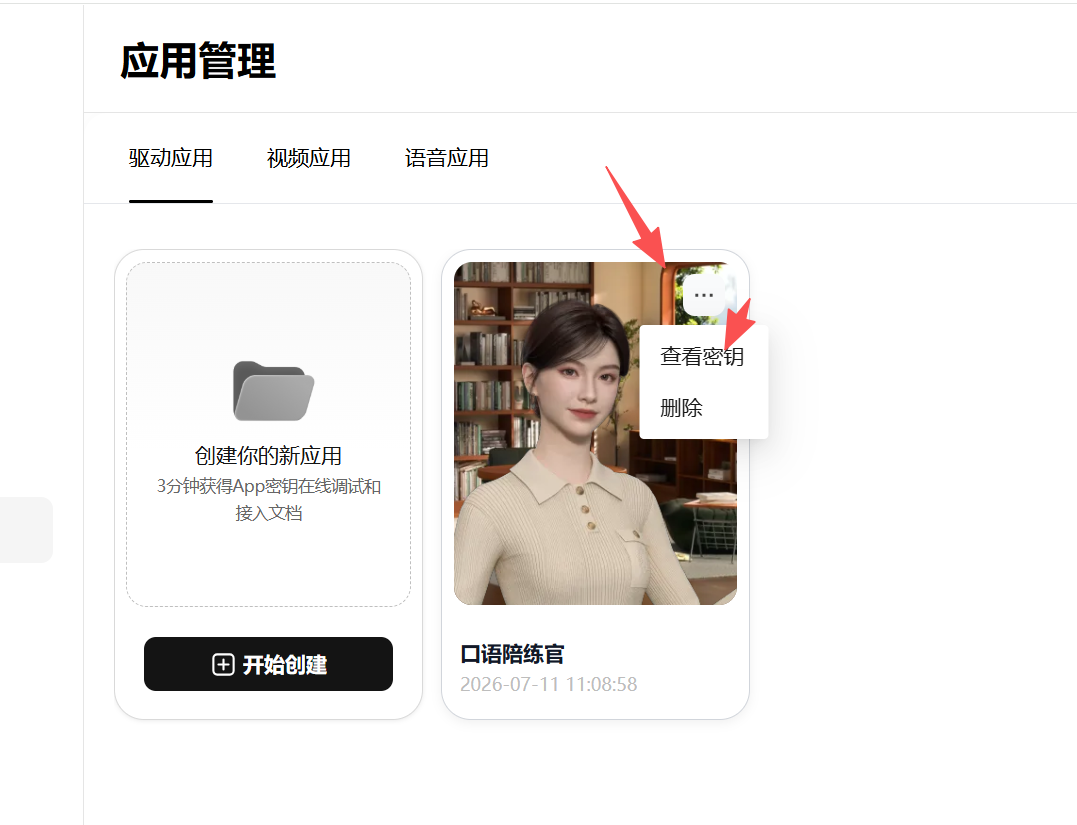
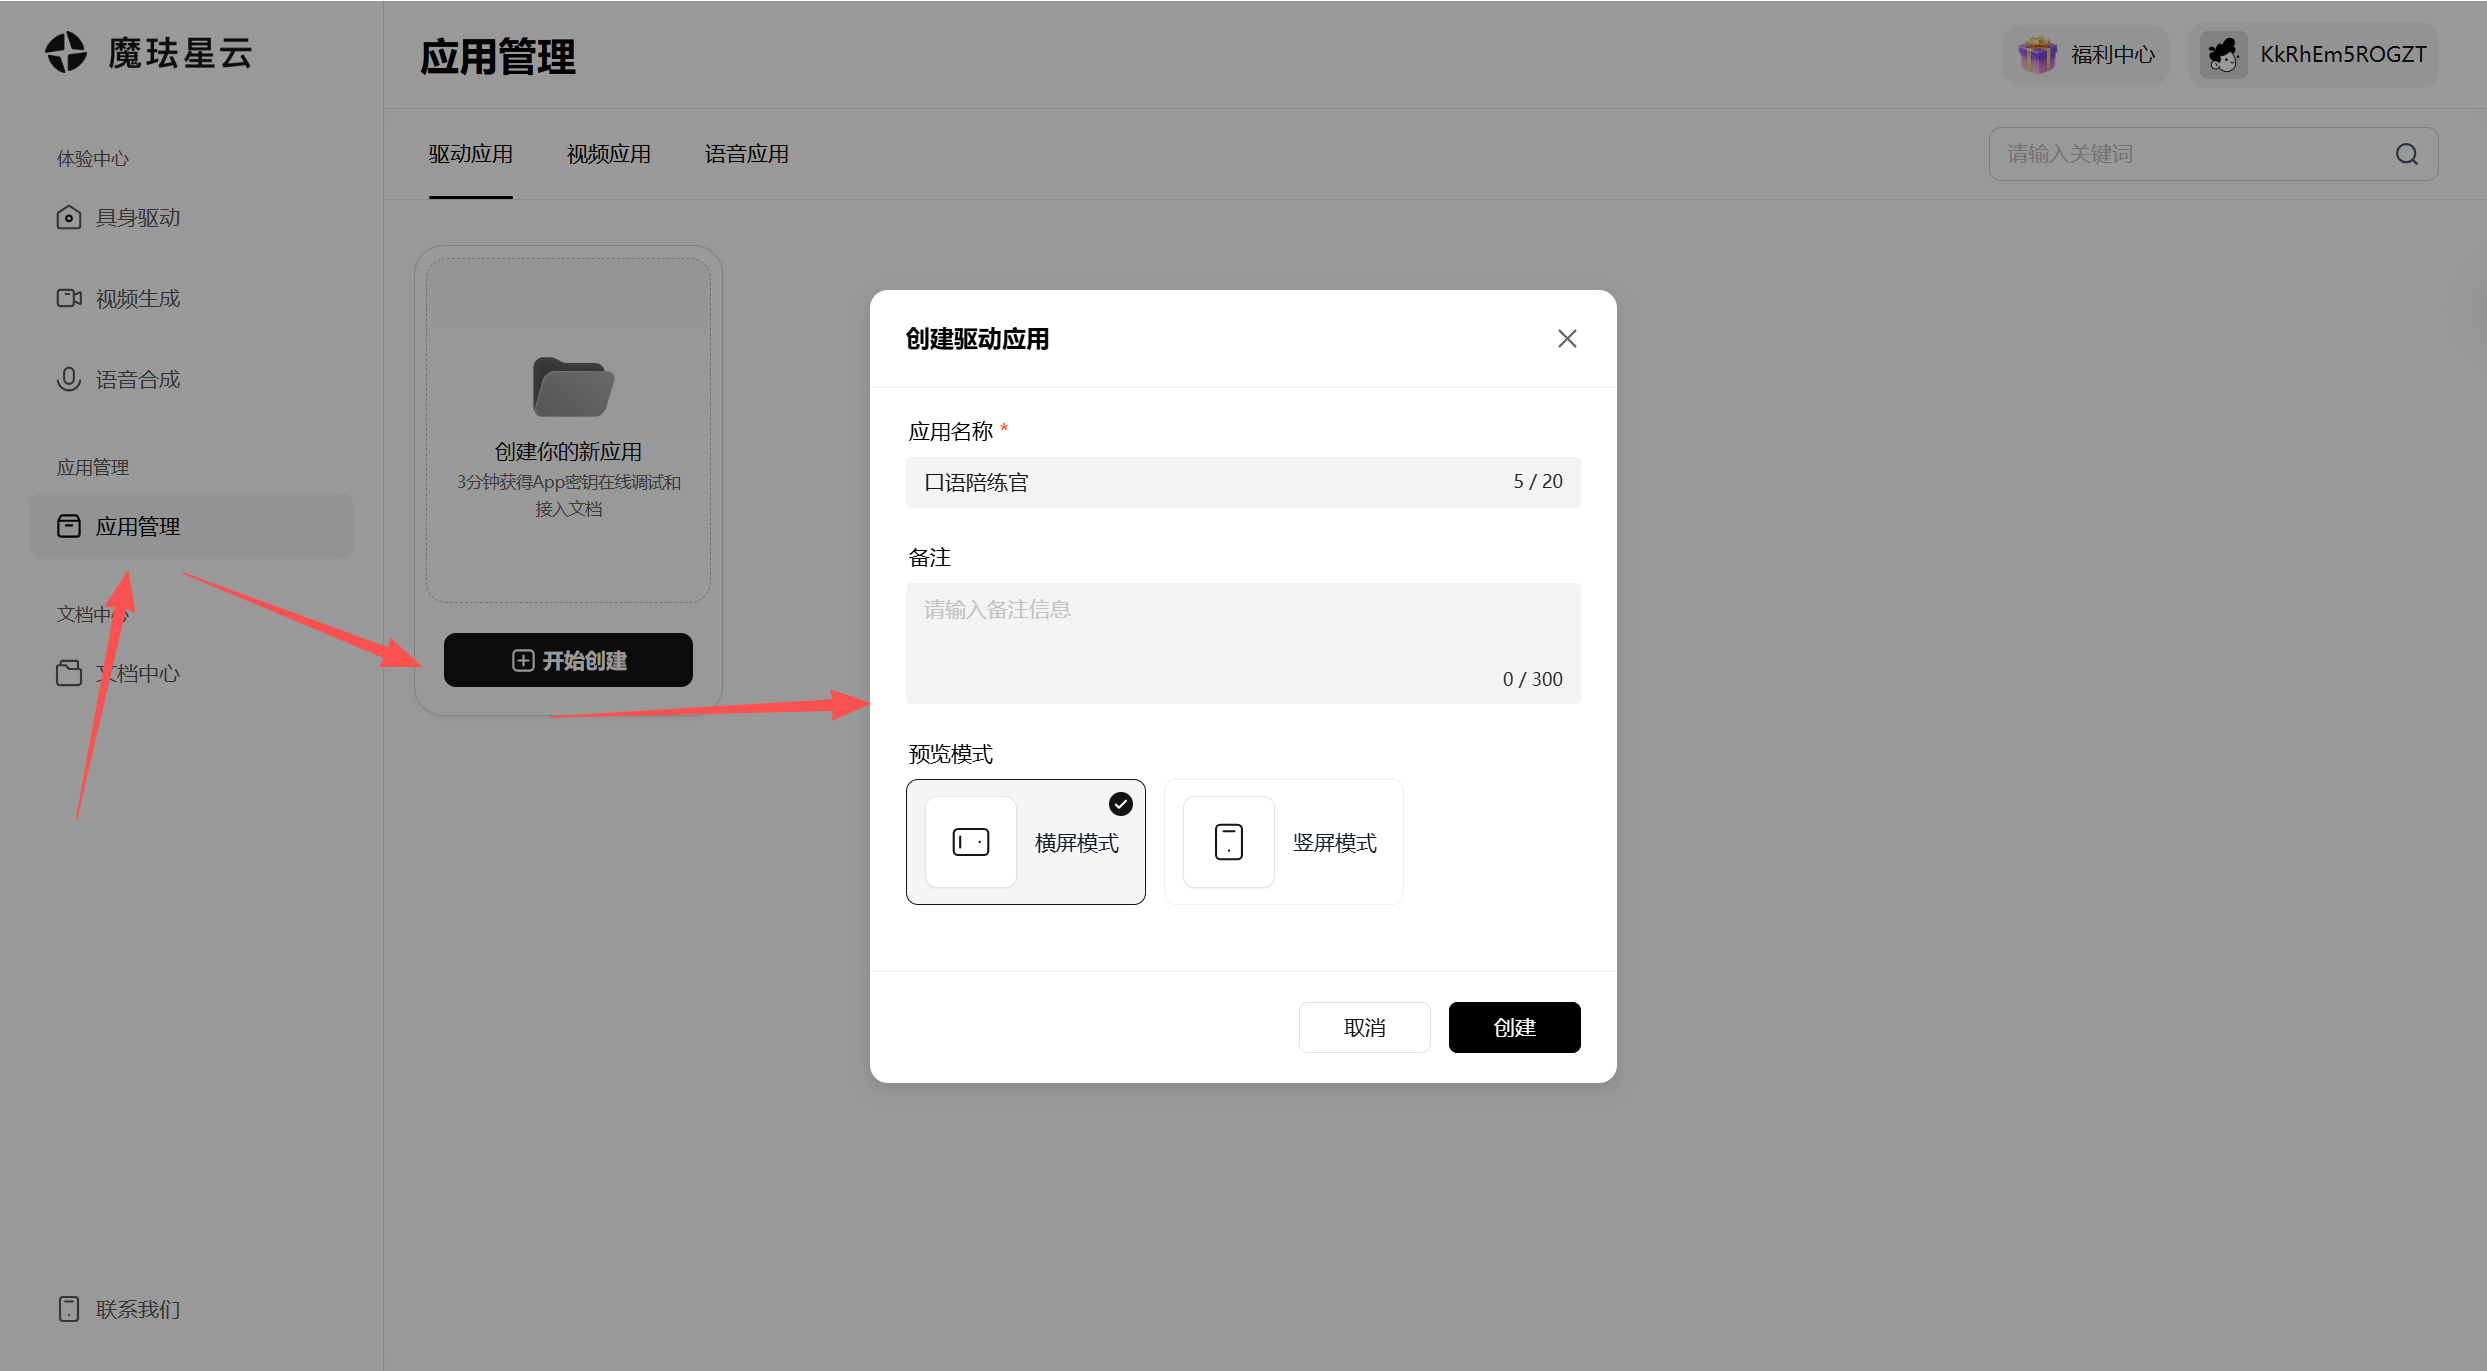
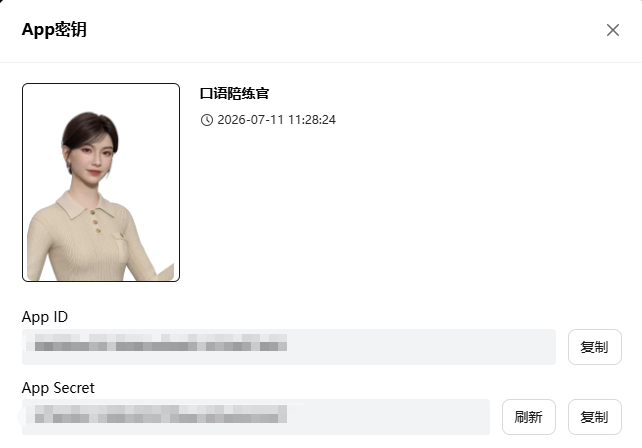
搭建3D口语陪练官的第一步是获取必要的开发凭证。用户需访问魔珐星云平台官网,注册账号并创建具身智能应用。
在应用创建环节,形象选择对体验影响显著。建议选用具有"职业女性"或"白领"气质的数字人形象,以增强"外教"角色的代入感。场景背景宜选择教室、办公室等简约环境,避免过于花哨的视觉干扰。
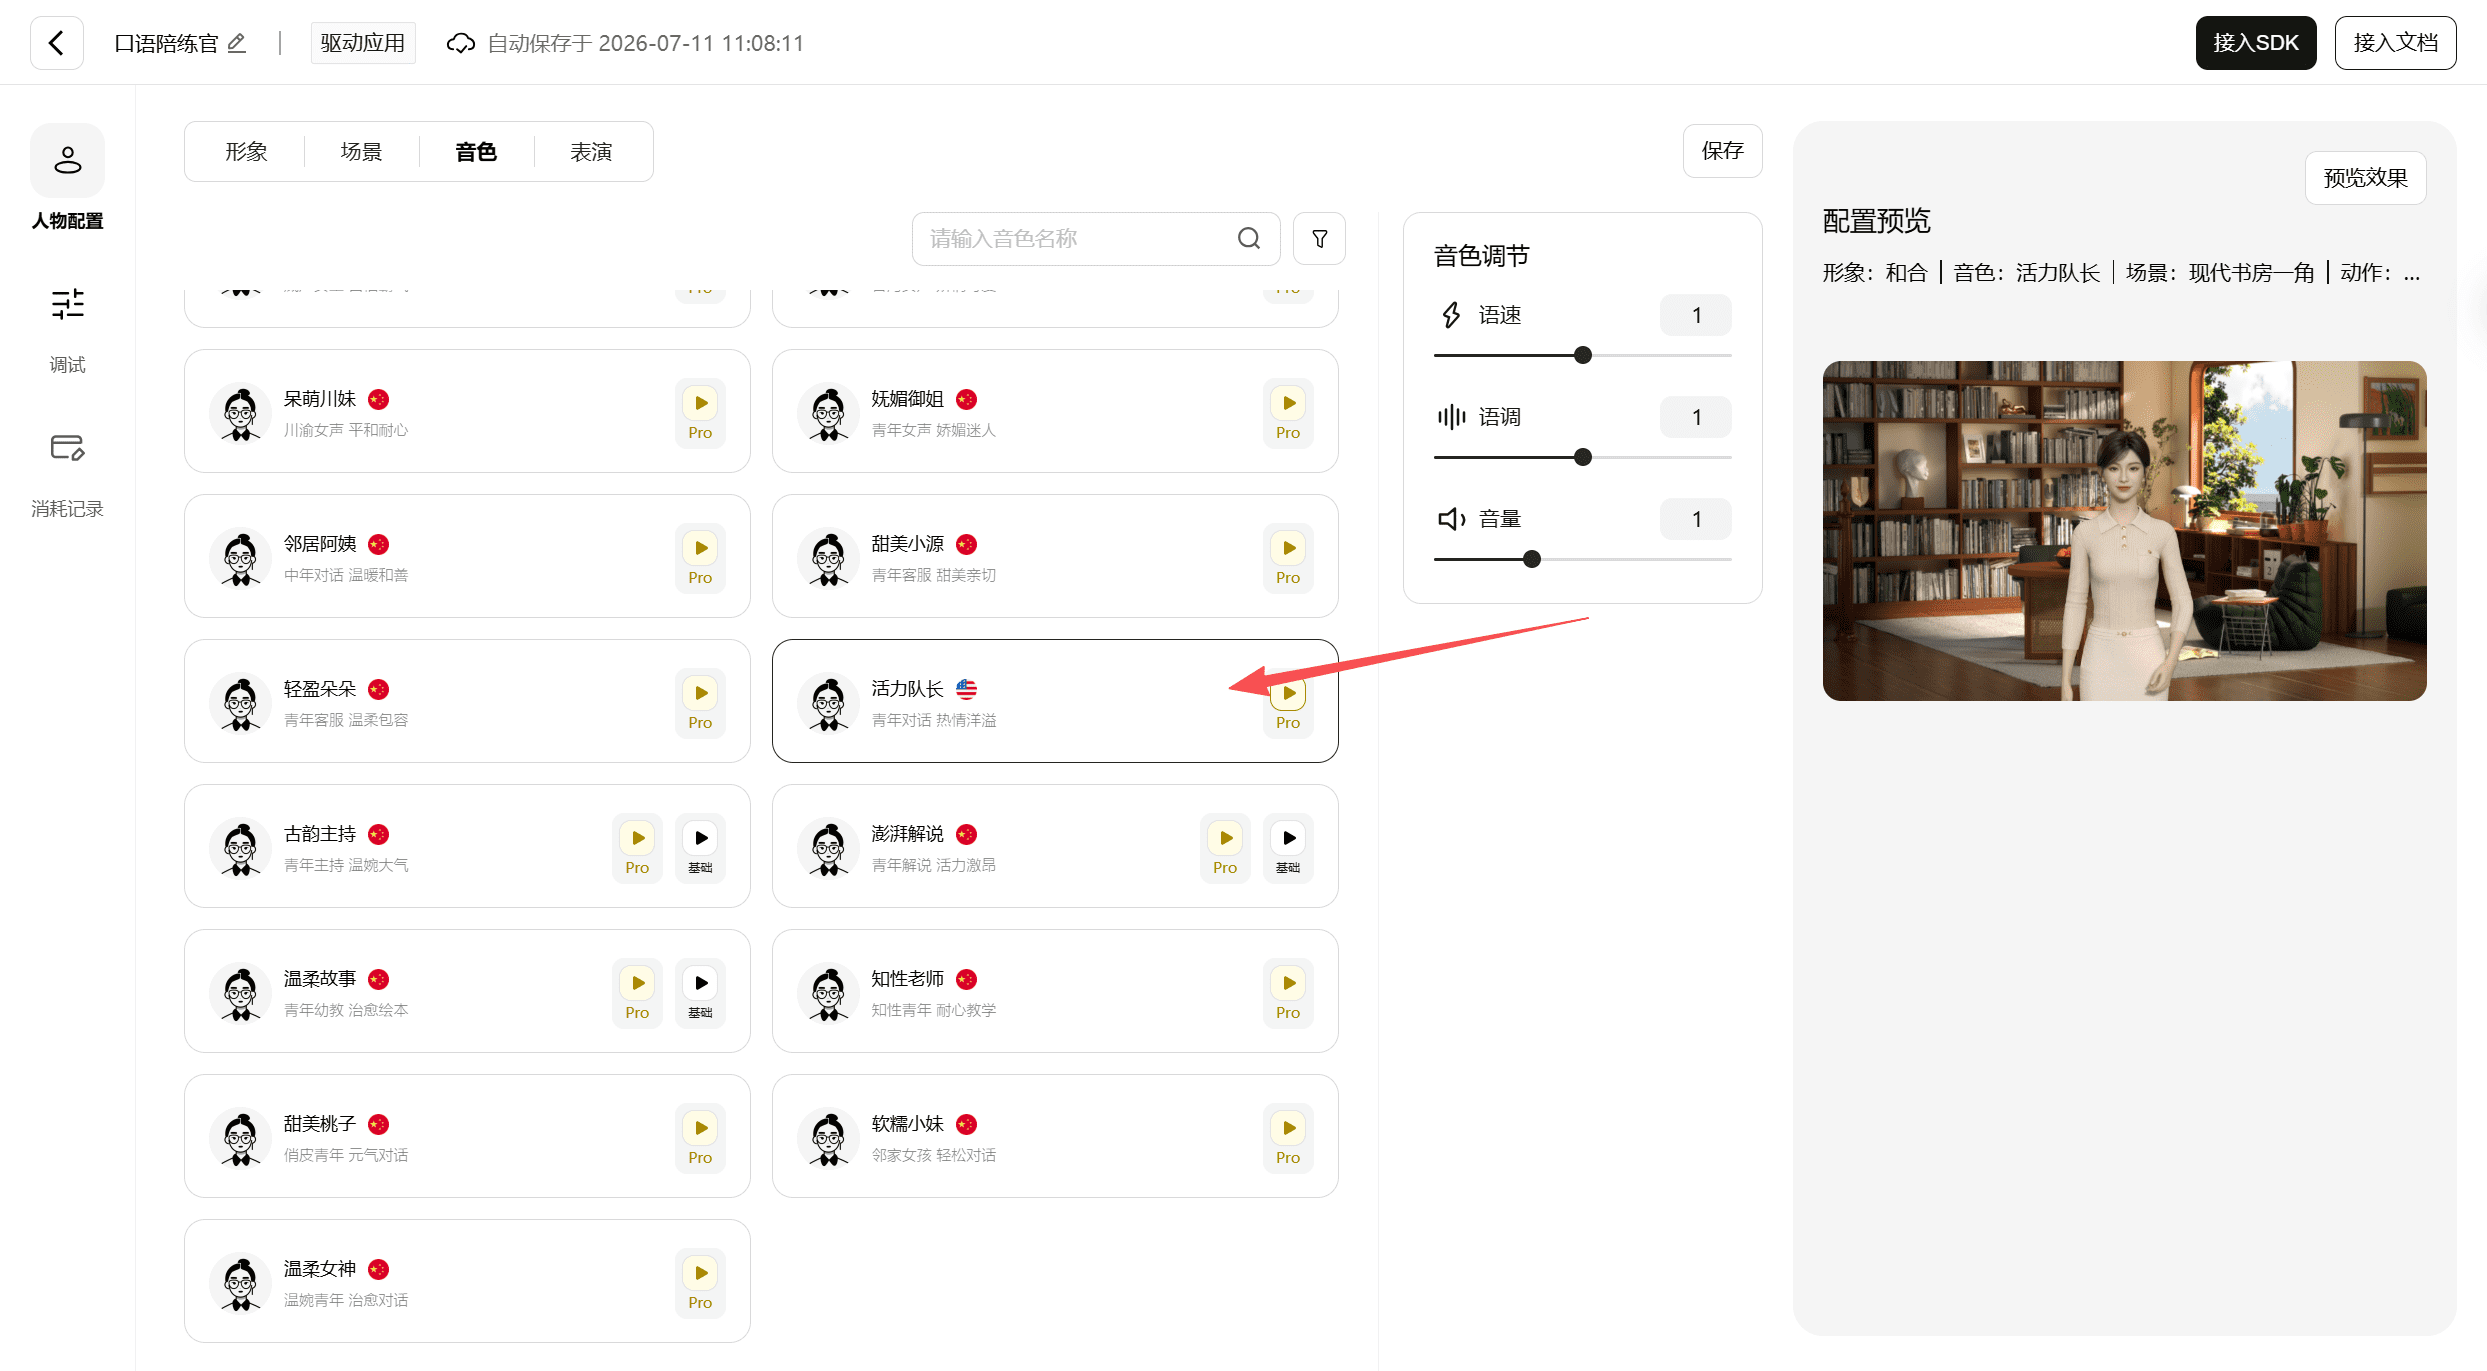
音色选择是本项目的关键约束点。由于平台机制限制,一个应用仅能绑定一种音色,且音色将决定所有语言的朗读口音。因此,若目标是英语陪练,务必选择标注为"美式英语"或"英式英语"的原生音色,避免使用中文音色导致英语朗读失真。
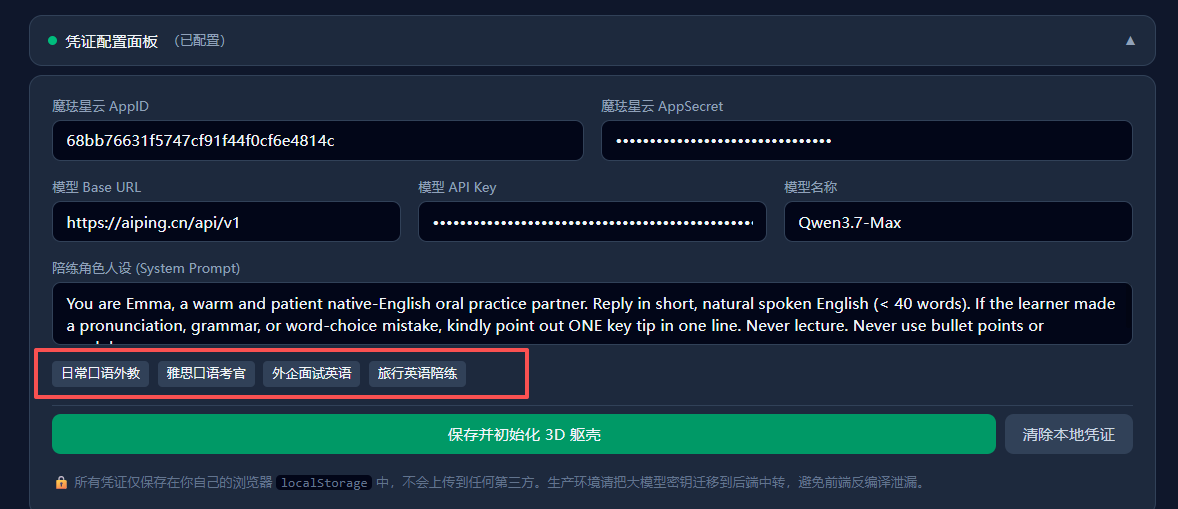
同时,需准备一个兼容OpenAI协议的大模型API服务,如DeepSeek、通义千问或Kimi等。仅需获取Base URL、API Key及模型名称三个关键信息。大模型与3D SDK的解耦设计,赋予了开发者极高的灵活性,可根据需求自由切换不同的大模型服务,以优化对话质量与成本控制。
实战部署:单HTML文件实现3D互动
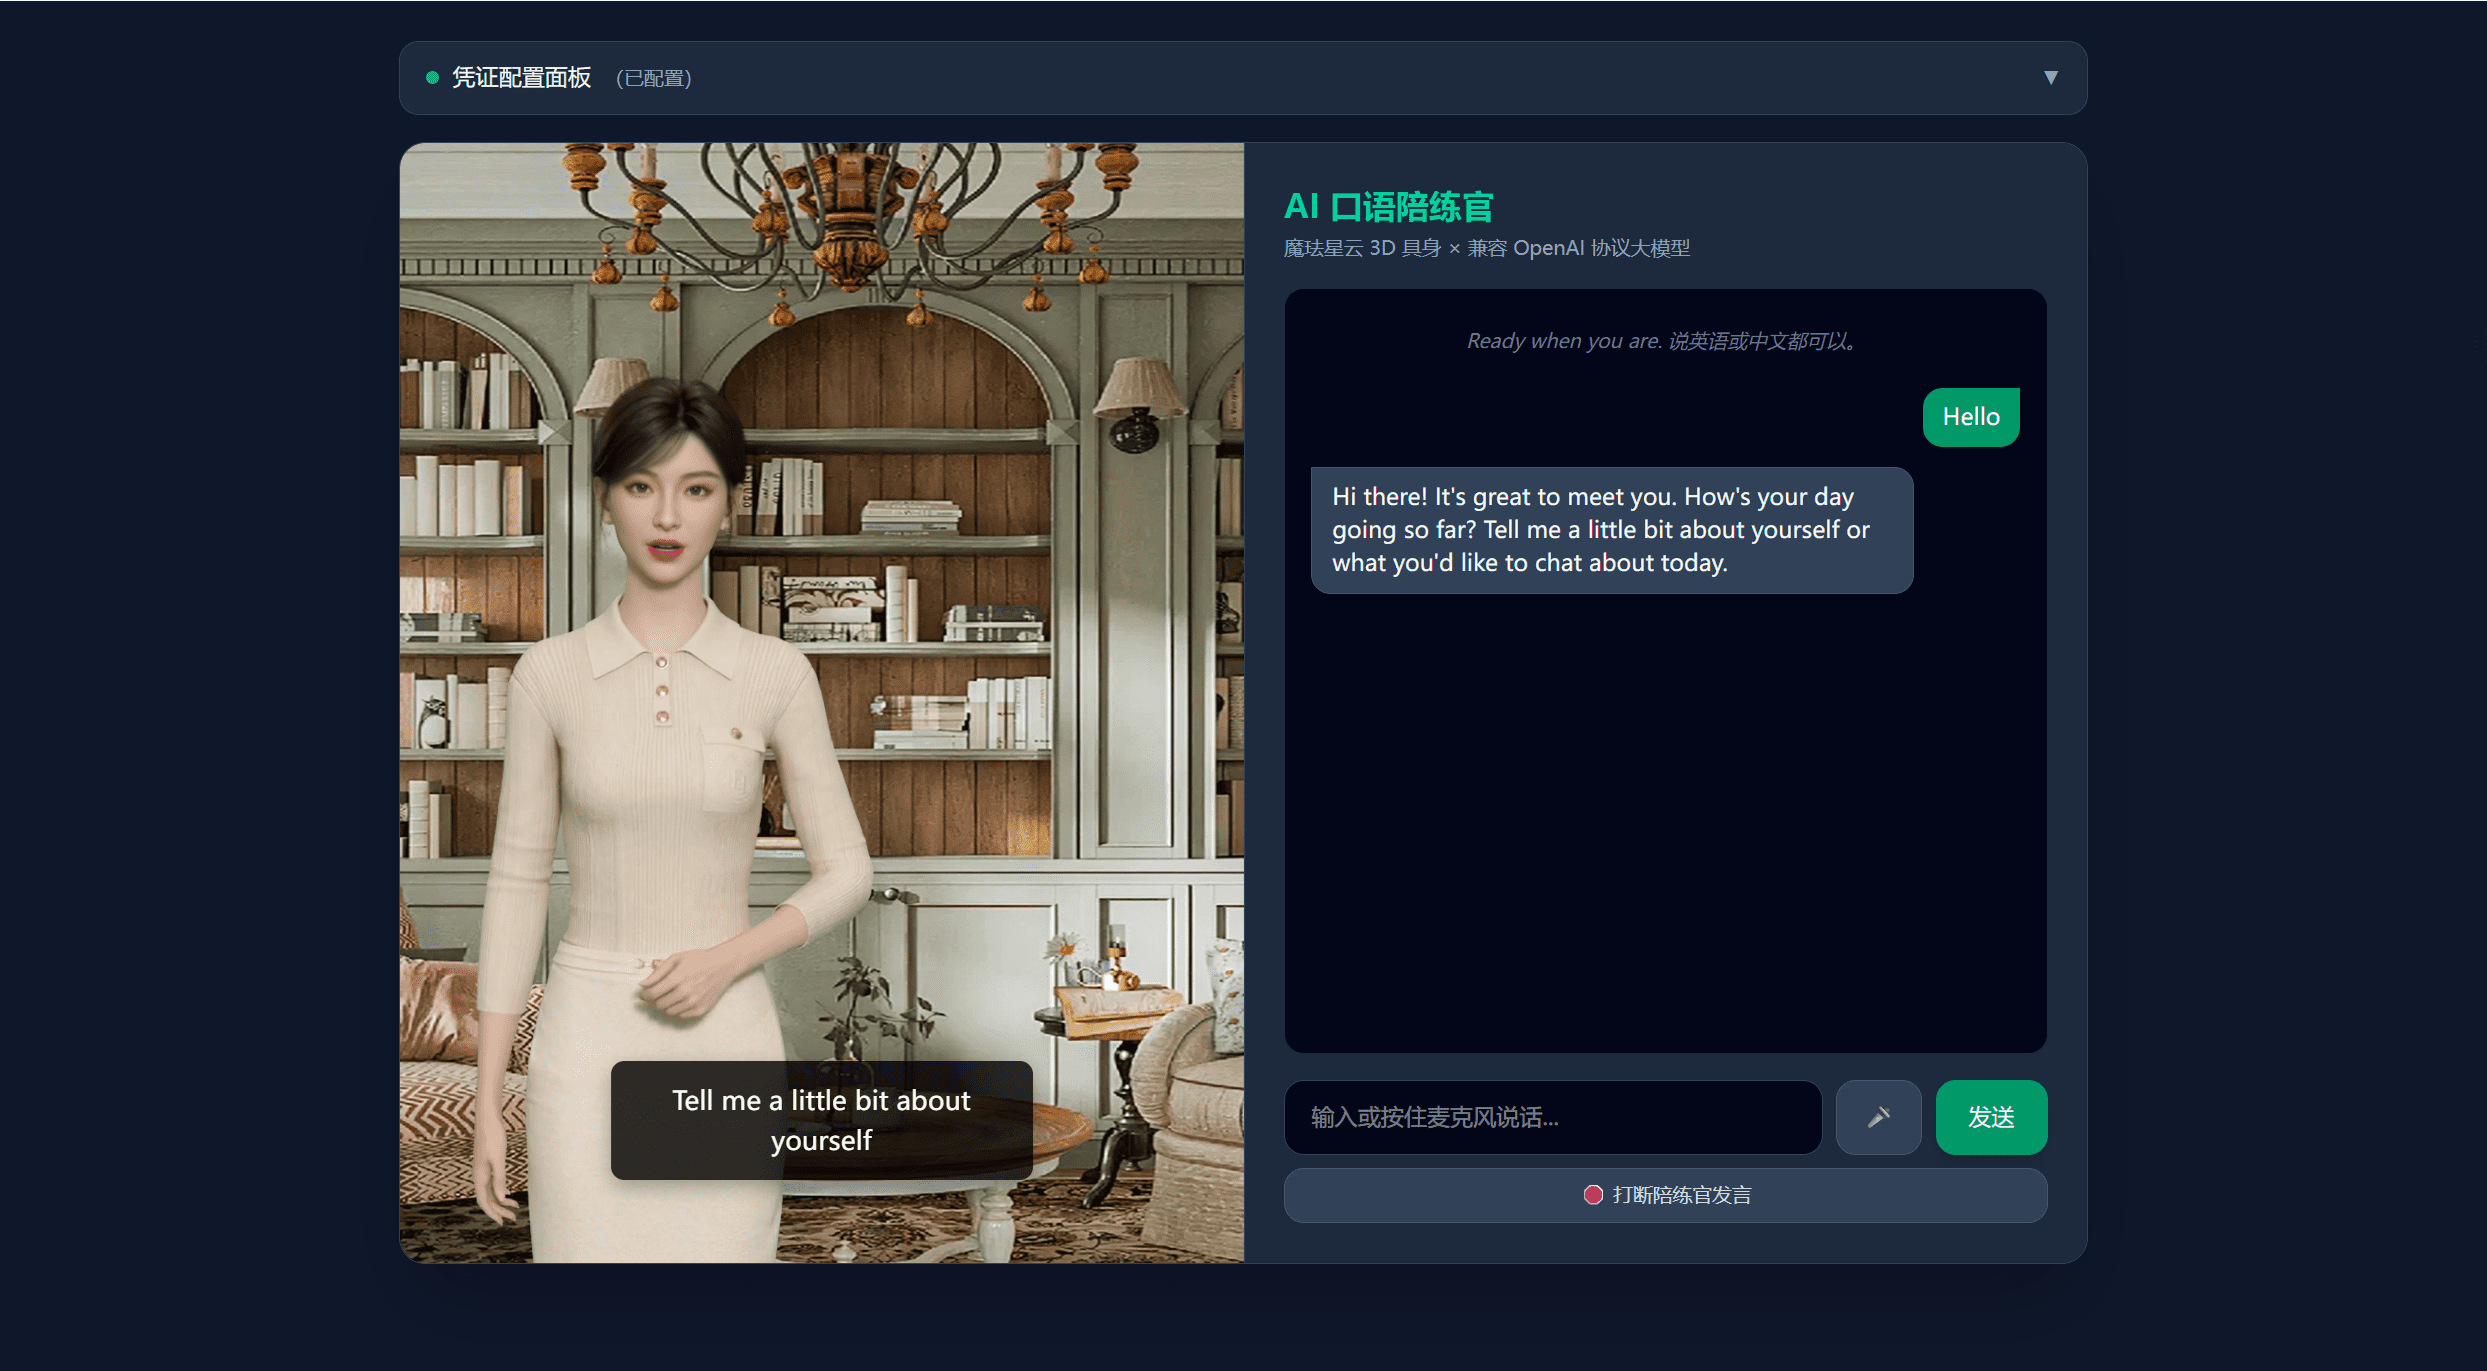
为了验证技术可行性,我们将构建一个包含所有功能的单HTML文件应用。该应用采用Tailwind CSS进行样式设计,集成魔珐星云SDK与浏览器原生Web Speech API。
核心代码结构如下:
<!DOCTYPE html>
<html lang="zh-CN">
<head>
<meta charset="UTF-8">
<meta name="viewport" content="width=device-width, initial-scale=1.0">
<title>AI 口语陪练官 · 魔珐星云 3D 具身智能</title>
<script src="https://cdn.jsdelivr.net/npm/@tailwindcss/browser@4"></script>
<script src="https://media.xingyun3d.com/xingyun3d/general/litesdk/xmovAvatar@latest.js"></script>
<!-- 样式定义略 -->
</head>
<body class="bg-slate-900 text-slate-100 min-h-screen p-4 md:p-6">
<!-- 配置面板 -->
<div class="max-w-5xl mx-auto mb-4">
<!-- 凭证输入框略 -->
</div>
<!-- 主交互区 -->
<div class="max-w-5xl mx-auto bg-slate-800 rounded-2xl shadow-2xl border border-slate-700 overflow-hidden flex flex-col md:flex-row h-[680px]">
<!-- 3D渲染容器 -->
<div class="w-full md:w-1/2 relative flex flex-col" id="avatar-container">
<div id="sdk_canvas" class="w-full h-full"></div>
</div>
<!-- 聊天与控制区 -->
<div class="w-full md:w-1/2 flex flex-col p-6 bg-slate-800">
<!-- 交互组件略 -->
</div>
</div>
<!-- 脚本逻辑略 -->
</body>
</html>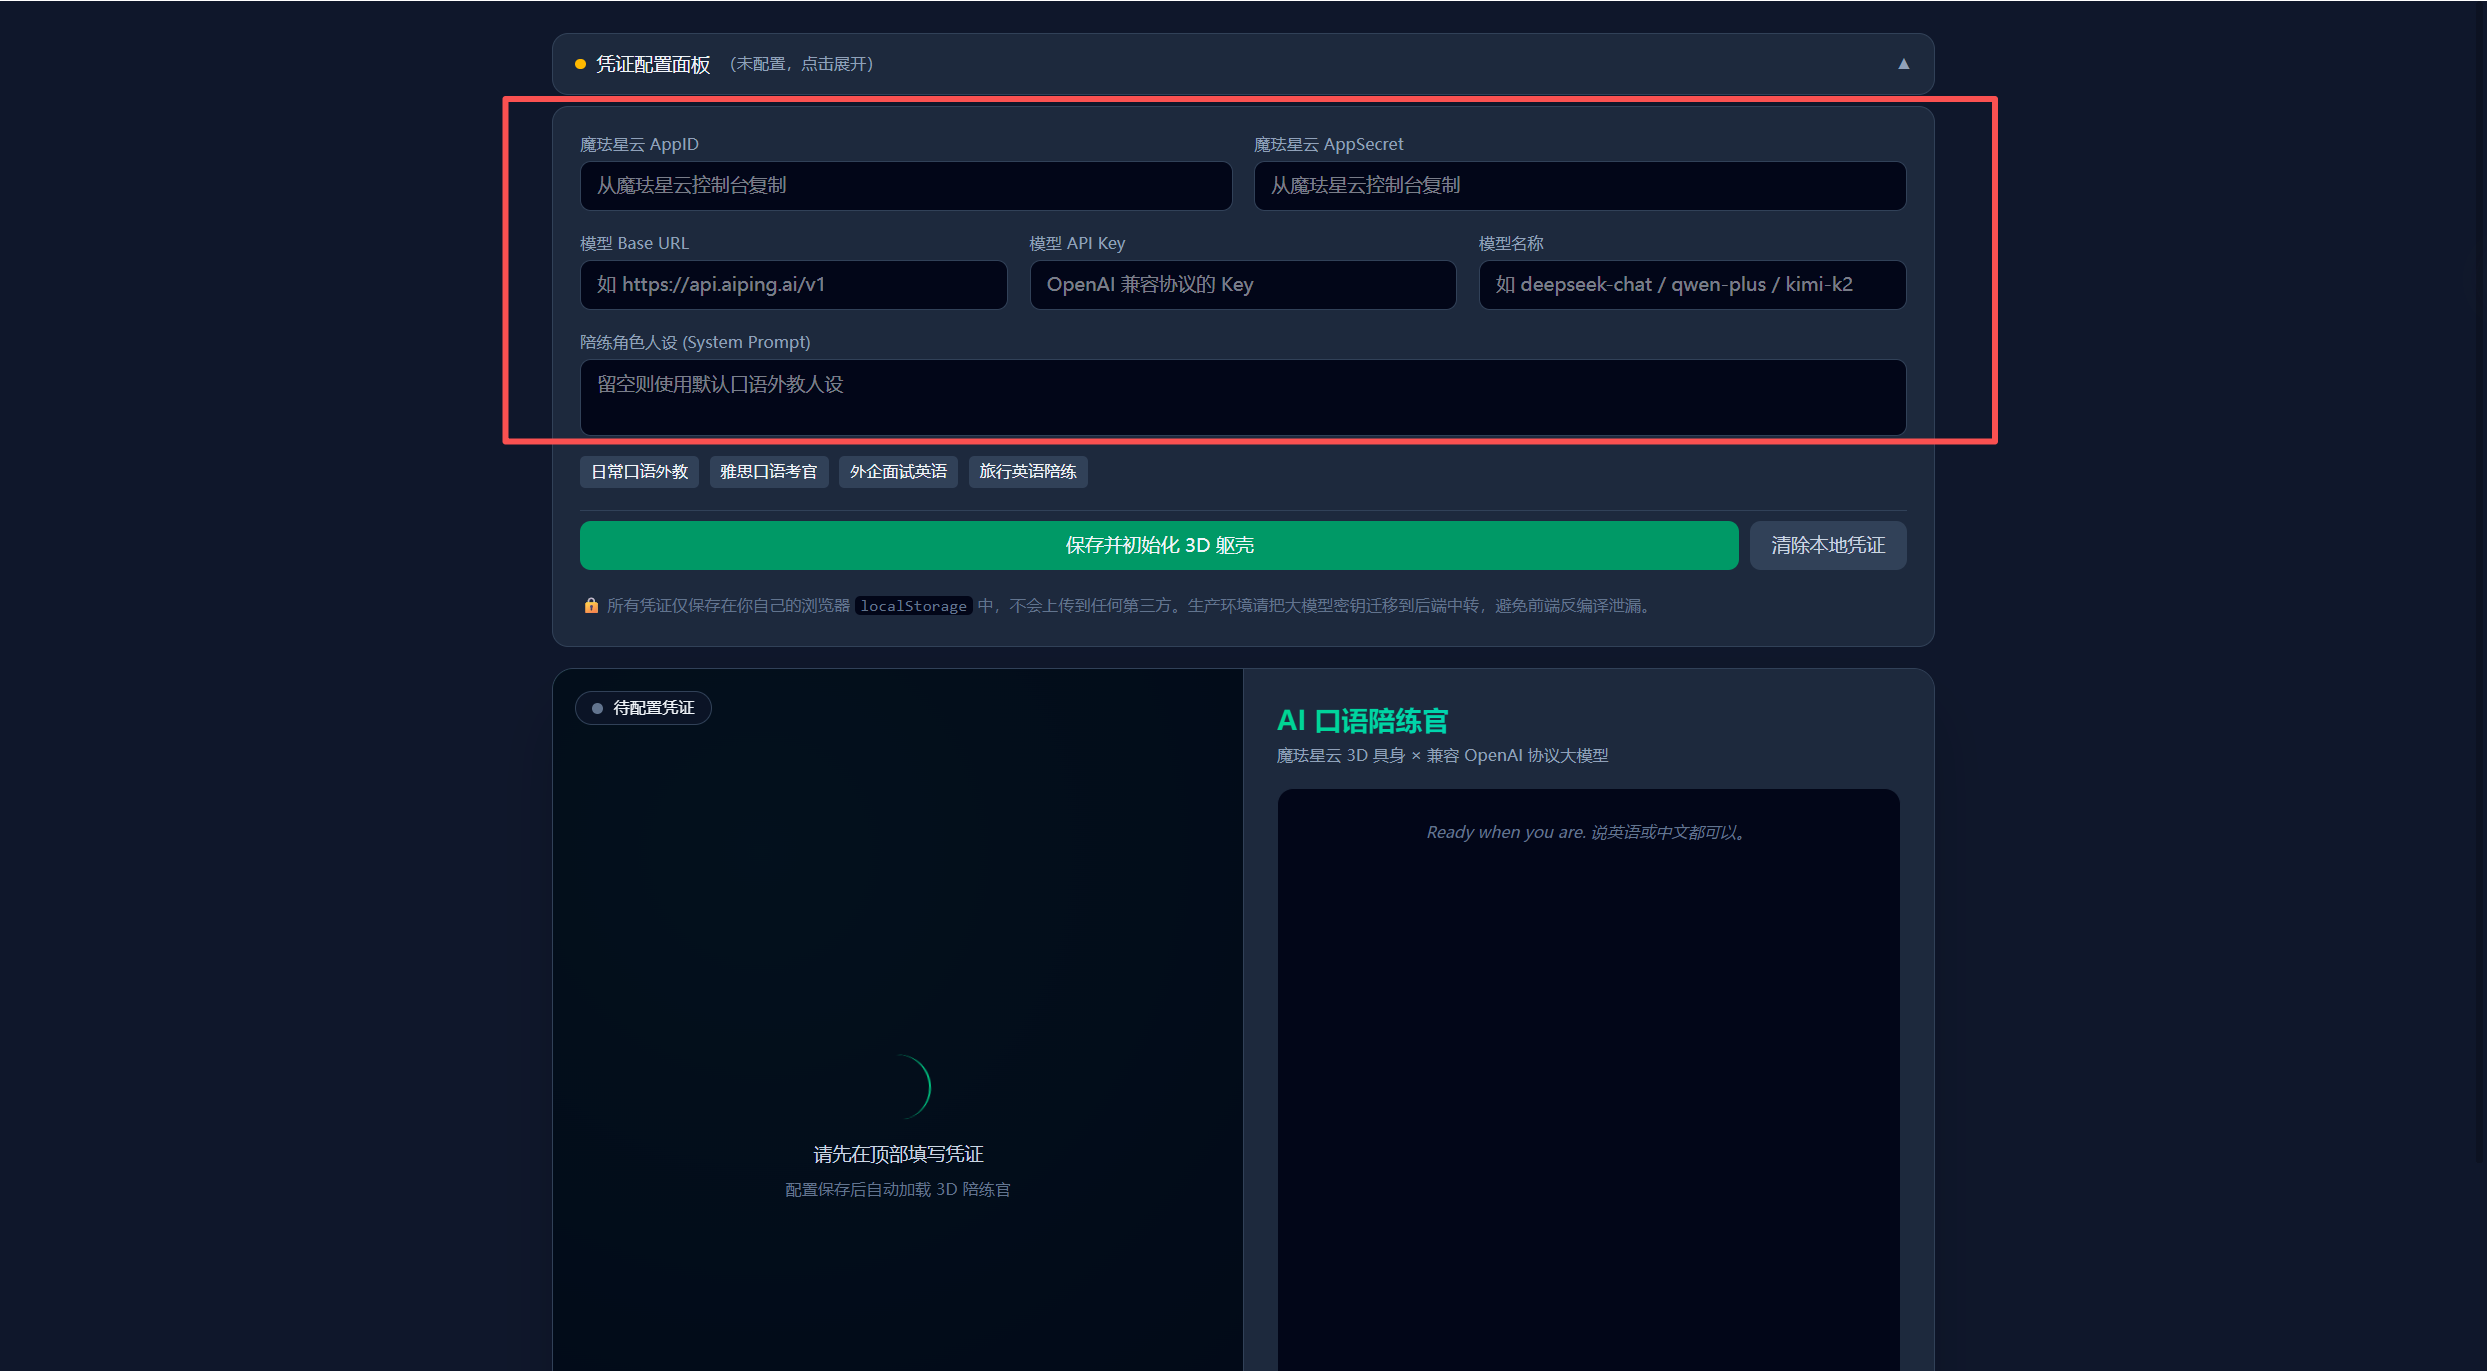
运行该应用需通过本地服务器启动,如使用python -m http.server 8000,并通过Chrome或Edge访问localhost:8000。直接双击HTML文件无法调用麦克风及SDK资源。
深度解析:SDK核心方法的调用范式
实现流畅的口语陪练,不仅在于连接成功,更在于对SDK核心方法的精准调用。
实例化与初始化
new XmovAvatar()仅负责登记参数,不发起网络请求。真正的鉴权与资源下载发生在init()方法的Promise中。这种异步设计允许在运行时动态切换凭证。在切换应用前,需显式调用destroy()销毁旧实例并清空DOM,以确保新配置生效。
流式断句策略
speak(text, isStart, isEnd)方法是驱动数字人说话的核心。针对口语陪练场景,采用"流式断句"而非"整段发送"更具优势。大模型每输出一个完整句子(以句号、问号等标点为界),前端即刻调用speak发送。这种方法的优势在于:
- 降低首帧延迟:学生说完后立即得到回应,避免长时间等待。
- 符合对话节奏:第一句多为回应(如"Right"),第二句为纠错或追问。流式发送让数字人先回应后纠错,更贴近真实外教。
- 状态机管理:需注意
speak方法的三个参数构成严格的状态机。首句传isStart=true,中间句传false,末尾句传isEnd=true。即使文本缓冲为空,也需显式调用speak(\'\', true)以通知云端结束会话,否则会导致动作过渡卡顿。
主动打断机制
口语互动中,"打断"是常见的学习行为。interactiveIdle()方法用于处理中断场景,它清空端侧未播放的参数帧缓冲,并通知云端终止当前TTSA生成。调用后,必须重置前端的textBuffer和isFirstSentence状态,防止下一轮对话出现会话接续异常。
场景拓展:一套代码覆盖多元学习目标
由于System Prompt独立于代码之外,开发者可通过修改人设指令,快速切换陪练场景。
预设场景包括:
- 日常口语:自由聊天,即时纠正发音与语法错误。
- 雅思口语:模拟Part 2/3面试,按流利度、词汇、语法、发音四维评分。
- 商务面试:模拟外企面试,点评职业化表达与商务词汇。
- 旅行英语:角色扮演点餐、问路等应急场景。
对于特定需求,如TOEFL口语训练,可直接定制Prompt:"给出一个Task 1话题,用户回答后,总结其结构(观点/理由/例子),并给出一条表达技巧建议。"
需注意,若需多语言陪练,应创建独立应用并绑定相应音色,因为单一应用无法支持多口音切换。通过保存不同的AppID/Secret组合,可实现配置的无缝切换。
避坑指南与优化建议
在实际部署中,需注意以下技术细节:
- 安全上下文要求:Web Speech API仅在HTTPS或localhost环境下可用,开发时务必使用本地服务器。
- 浏览器兼容性:Chrome和Edge对Web Speech API支持最佳,Firefox和Safari可能存在兼容性问题。
- 权限管理:首次使用需授予麦克风权限,若误拒,需在浏览器设置中手动放行。
- CORS跨域问题:部分大模型API可能拦截浏览器请求,必要时需通过后端中转。
- 密钥安全:生产环境中,应将AppSecret和API Key移至后端,前端仅获取短期Token,防止密钥泄露。
未来,该架构还可进一步扩展,如引入云端高精度ASR、支持多角色配置保存、实现语音自动打断检测,甚至叠加发音评分算法。通过持续迭代,构建更加智能、拟真的具身智能陪练应用。