元数据死灰复燃:AI时代数据治理从辅助走向核心的范式反转
从附属品到中枢神经:元数据的范式反转
在人工智能技术浪潮席卷全球的今天,企业数据架构正经历着一场深刻的重构。曾经被视为“后台配角”的元数据,如今正在重新定义其核心价值。一家头部金融机构的真实案例极具代表性:其AI智能问答系统的准确率从上线初期的40%飙升至87%,技术团队仅做了一项关键调整——并未更换底层模型或增加算力,而是彻底重构了元数据体系。
此前,该系统依赖大模型将自然语言转化为SQL查询,但由于缺乏对业务术语、字段口径及表归属的精确理解,大模型面对同名表、模糊定义时往往迷失方向。引入结构化、机器可读的元数据后,Agent在生成查询前能先进行上下文检索,从而精准定位数据源。这一转变揭示了一个核心事实:在AI时代,元数据已不再是被动的文档,而是Agent理解企业数据的“语言”和“地图”。数据本身成为了元数据的副产品,元数据则成为了驱动智能决策的引擎。
元数据的沉寂与重生:三十年演变史
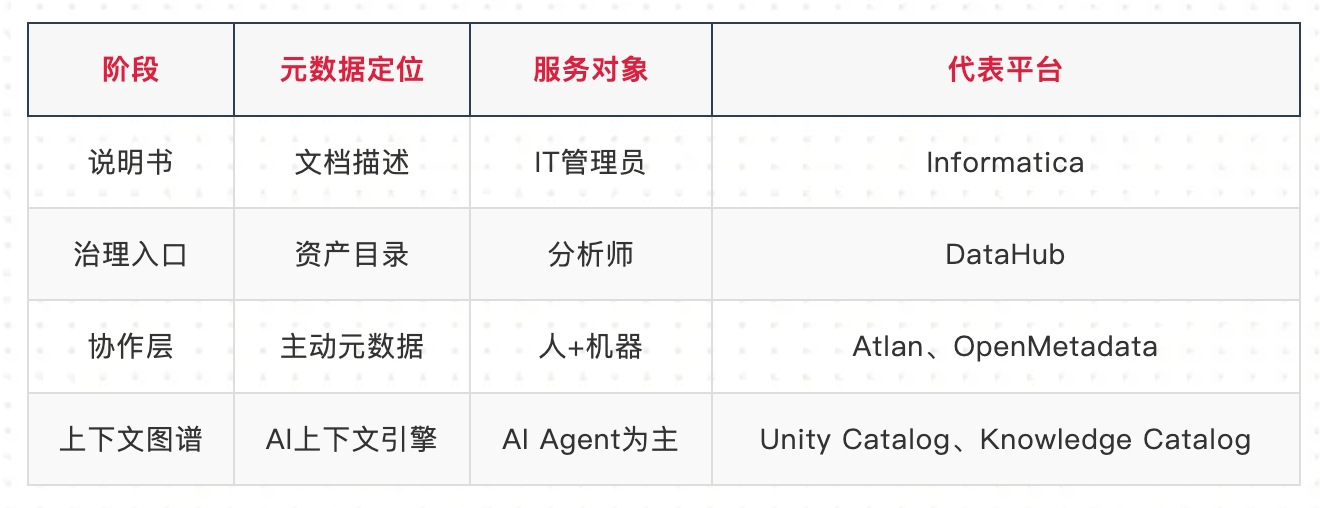
回顾过去三十年,元数据的发展经历了一个从被忽视到被迫重视,再到主动融合的曲折过程。
在90年代的“说明书时代”,元数据仅是数据库的结构文档,由IT人员手工录入,更新滞后且错误率高,本质上与数据运行解耦。进入大数据时代的2010年代,随着Hadoop和数据湖的兴起,LinkedIn DataHub等工具出现,元数据演变为“治理入口”,具备数据目录和血缘分析能力,但仍主要服务于人的搜索需求。
2020年代中期,“协作层时代”到来,Gartner提出“主动元数据”概念,元数据开始通过事件流实时更新,成为数据基础设施的神经系统。而到了2026年,随着大模型和AI Agent的深度渗透,元数据正式进入“上下文图谱时代”。以OpenMetadata和Google Cloud Knowledge Catalog为代表的新一代平台,将表、字段、血缘、术语整合为可推理的知识网络。服务对象的根本转变——从“人”转向“AI Agent”,标志着元数据迎来了真正的第二春。
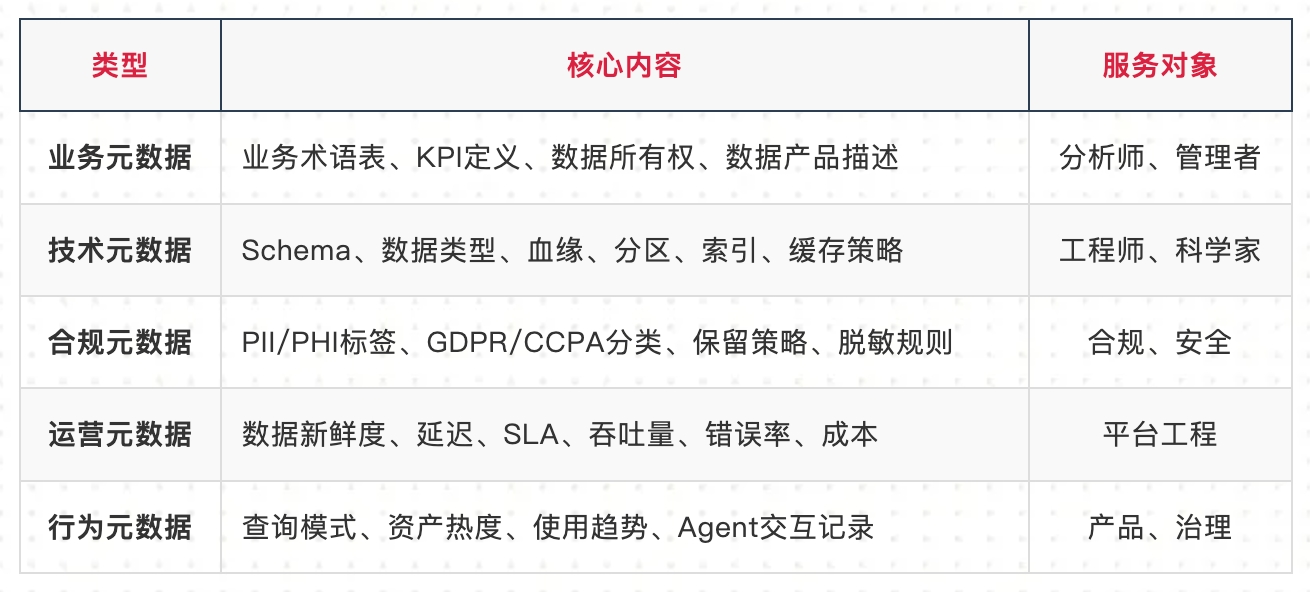
数据是燃料,元数据是导航
在传统的AI项目流程中,数据被视为核心资产,元数据往往作为流程的最后一步被补全,处于“数据优先,元数据其次”的地位。然而,在AI Agent落地的场景中,逻辑发生了倒置。
Agent能否有效执行任务,不取决于数据是否存在,而取决于元数据是否完备到能让Agent正确理解和使用数据。如果说数据是燃料,元数据则是导航系统、仪表盘和副驾驶的集合。没有高质量的元数据,海量的数据对Agent而言只是无法消费的“暗物质”。
Meta在2026年的实践提供了有力佐证。为了让AI Agent正确修改大规模数据管道,Meta专门组建了由50多个AI Agent构成的预计算引擎,其唯一任务是将工程师头脑中的“部落知识”转化为AI可读的结构化上下文。这一举措使工具调用次数减少40%,覆盖率从5%提升至100%。在顶尖科技公司,生产元数据已从数据团队的副业转变为AI项目的主线工作。
从“主动”到“自主”:Agentic Metadata的崛起
第四代元数据的核心特征正从“Active(主动/实时)”向“Agentic(自主/可推理)”演进。这一趋势体现在三个关键信号上:
首先,模型上下文协议(MCP)正在成为元数据系统的标准接口。DataHub和Atlan等主流平台已集成MCP Server,使得任何AI Agent框架都能通过标准化API直接查询企业元数据,元数据系统正演变为“企业数据的USB-C接口”。
其次,元数据系统本身开始嵌入Agent能力。DataHub和Atlan利用内置Agent自动进行Schema推断、异常血缘检测和敏感数据打标。元数据系统不再被动响应查询,而是主动生产和维护自身元数据,实现了自我演进。
最后,“Context Engineer(上下文工程师)”成为一个独立且高价值的工种。这一角色专注于设计Agent所需的上下文结构、动态裁剪机制及维护策略。值得注意的是,最具竞争力的候选人并非来自纯AI领域,而是拥有深厚数据工程背景的专业人士,因为他们更理解企业数据的业务含义和质量陷阱。
市场趋势与基础设施重构
市场数据印证了元数据战略地位的提升。全球元数据管理工具市场规模在2024年已达116.9亿美元,预计到2030年将以20.9%的年复合增长率增长至364.4亿美元。Gartner在最新魔力象限报告中明确将元数据定位为“AI就绪的基础”。
与此同时,行业并购整合加速,ServiceNow收购data.world,Salesforce收购Informatica,表明元数据正成为科技巨头的战略必选项。Gartner预测,到2027年,采用主动元数据实践的组织能将新数据资产交付时间缩短70%。
在架构层面,企业数据栈正经历新一轮分层。继数据仓库、数据湖、湖仓之后,“上下文层”正在成为面向AI Agent的新型基础设施。它不替代底层存储,而是建立在湖仓之上,专门提供语义理解、治理策略和上下文供给。未来三年,设立“首席上下文架构师”或类似角色将成为头部企业的标配。
血缘革命的扩展与新挑战
元数据的价值不仅体现在目录查询,更在于血缘关系的革命性扩展。传统的数据血缘仅追踪数据的物理流转,而在AI时代,血缘链条大幅延长,涵盖机器学习血缘、RAG知识血缘、Prompt血缘及Agent行为血缘。
Databricks Unity Catalog等前沿平台已开始支持列级运行时血缘捕获,涵盖Notebook、Job及Dashboard等多种上下文。企业需要管理的血缘类型从单一的“数据血缘”扩展至至少六种,元数据平台也因此被推向更广泛的企业上下文图谱角色。这种全链路的可追溯性,是确保AI决策可解释、可审计、可优化的关键。
战略判断与行动建议
展望未来三年,元数据的发展将呈现三个关键判断:
第一,预算主体将从首席数据官(CDO)转移至首席AI官(CAIO)。AI项目的成功前置条件在于元数据的完备性,元数据投资将被重新定义为AI投资。
第二,元数据的消费者结构将发生反转。当前95%的查询由人发起,未来三年这一比例将倒置,95%的查询将由AI Agent发起。这将推动元数据系统从“UI优先”向“API优先”转型。
第三,传统数据工程师向Context Engineering转型的窗口期仅剩18个月。随着AI原生人才的涌入,理解业务语义和数据治理的专业壁垒将成为传统工程师的核心竞争力。
基于此,提出以下行动建议:
对于数据工程师,应将“AI Agent友好”作为元数据建设的默认标准。详细注释表结构、明确字段口径、完善业务定义,这些曾是“加分项”,如今已是“准入门槛”。
对于AI应用开发者,应停止在Prompt中硬编码业务上下文。将所有业务知识沉淀至元数据系统,让Agent在运行时动态查询。这不仅能缩短Prompt长度,还能显著降低维护成本,实现知识复用。
对于技术决策者,应合并“数据治理”与“AI项目”的预算线。二者并非平行关系,而是互为因果。AI项目的成败本质上取决于数据治理的成熟度,必须将元数据建设提升至企业AI战略的核心位置。
连接过去与未来三十年数据基础设施的关键,在于元数据。它已从仓库角落的目录卡片,演变为企业AI战略的中枢神经,并将最终成为整个数字世界的语义底层。所谓的“死灰复燃”,不过是烈火终于找到了它真正该燃烧的地方。