供应链金融信用风控难题破解:BO-XGBoost与Bagging集成的深度重构
供应链金融信用评价的范式转移
在当前的宏观经济环境中,中小企业作为国民经济的重要基石,其融资难、融资贵的问题长期制约着产业活力的释放。供应链金融模式通过核心企业信用穿透,试图解决这一痛点,但其本质依然面临信用风险评估的严峻挑战。传统的风控手段多依赖财务指标和专家打分,不仅效率低下,且难以应对复杂多变的商业环境。随着大数据和人工智能技术的兴起,机器学习算法逐渐渗透至金融风控领域,但如何在高噪声、非线性的金融数据中构建稳健的预测模型,仍是学术界与业界共同关注的核心议题。
现有研究虽然引入了随机森林、支持向量机等算法,但在处理特定场景下的偏差-方差问题时仍显不足。例如,基于Boosting系列的算法虽能有效降低偏差,却容易过拟合,导致泛化能力受限。此外,超参数优化往往依赖人工经验或低效的网格搜索,难以在庞大的参数空间中快速定位全局最优解。这些局限性促使研究者探索更高级的集成策略,将不同算法的优势互补,从而构建更具鲁棒性的信用评价体系。
理论缺口与研究动机
深入梳理现有文献可以发现,当前供应链金融信用评价研究存在四个显著的研究缺口。首先,超参数优化研究相对匮乏,大多数模型直接调用默认参数或采用低效的搜索策略,导致模型性能未达极限。其次,单一集成学习方法往往难以兼顾偏差与方差的平衡,特别是对于存在噪声干扰的金融数据,单一XGBoost模型容易受到异常值的影响,导致预测波动较大。
第三,针对供应链金融特定场景的研究不足。多数信用评价模型侧重于个人信贷或通用企业信贷,忽视了供应链环境中特有的交易数据、物流信息及集中度风险,导致模型在实际应用场景中解释力和准确性下降。最后,特征选择方法有待完善,高维数据中的冗余特征不仅增加计算成本,还可能引入噪声,降低模型的稳定性。基于此,构建一种融合高效特征筛选、智能超参数优化及稳健集成策略的新模型显得尤为迫切。
BXB模型的理论架构
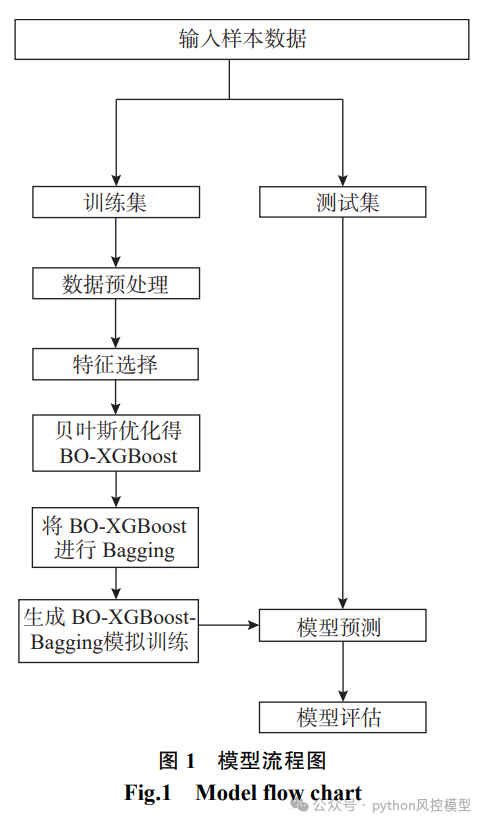
本研究提出了一种名为BO-XGBoost-Bagging(BXB)的集成学习模型,旨在通过算法融合解决上述理论缺口。该模型的设计逻辑严密,分为特征筛选、参数优化、集成训练和结果投票四个核心环节。首先,利用XGBoost算法内置的特征重要度度量,从候选指标中筛选出最具解释力的子集,这不仅降低了维度灾难的风险,还提升了模型的可解释性。
其次,引入贝叶斯优化(Bayesian Optimization, BO)技术进行超参数自动调优。与传统的网格搜索和随机搜索相比,贝叶斯优化通过构建代理模型(如高斯过程)和利用采集函数,能够以更少的迭代次数找到全局最优参数组合,极大地提升了调参效率。这一过程确保了基学习器在最优配置下运行,为后续集成奠定坚实基础。
集成策略的深层逻辑
BXB模型的核心创新在于将优化后的XGBoost纳入Bagging集成框架。Bagging(Bootstrap Aggregating)通过有放回抽样生成多个子数据集,并行训练多个基分类器,最后通过投票机制综合预测结果。这种并行集成策略能够有效降低模型的方差,弥补XGBoost作为Boosting算法在降低方差方面的不足。
从统计学角度来看,XGBoost通过串行拟合残差来降低偏差,但容易对训练数据中的噪声敏感;而Bagging通过平均多个基模型的预测结果,平滑了预测波动,显著提升了泛化能力。这种“降方差”与“降偏差”的组合,实现了偏差-方差权衡的最优化。此外,Bagging对基学习器的稳定性有较高要求,而经过贝叶斯优化调优的XGBoost具备较强的预测性能,作为基学习器时能产生高质量的投票,从而进一步放大集成优势。
特征工程与指标体系构建
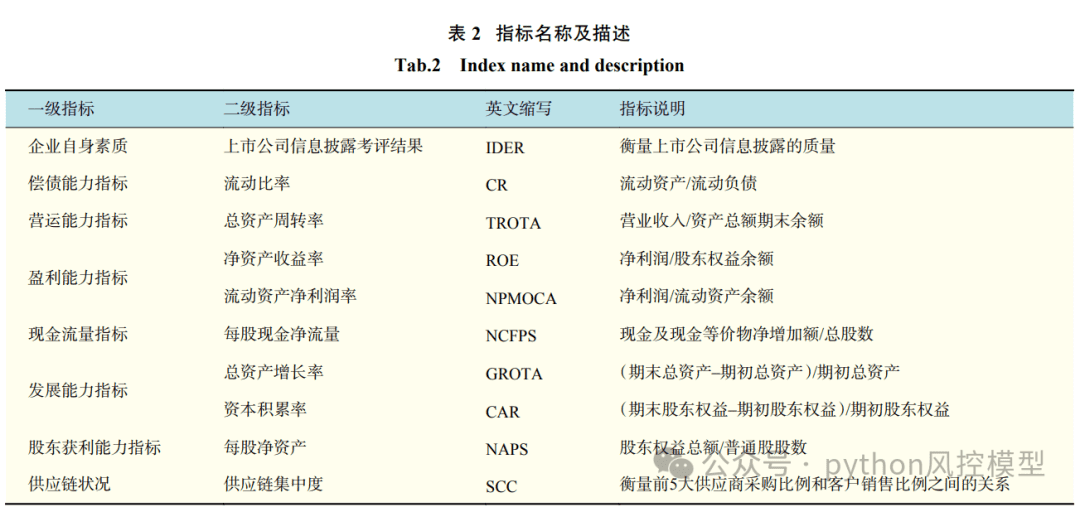
在特征选择阶段,本研究并未简单套用传统的5C原则,而是结合供应链金融特性,构建了包含25个候选指标的评价体系。这些指标涵盖了财务基本面(如流动比率、净资产收益率)、成长能力(如总资产增长率)、现金流状况(如每股现金净流量)以及供应链特有指标(如供应链集中度SCC)。
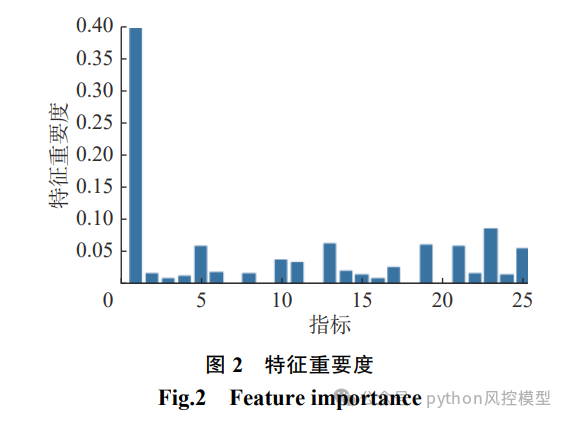
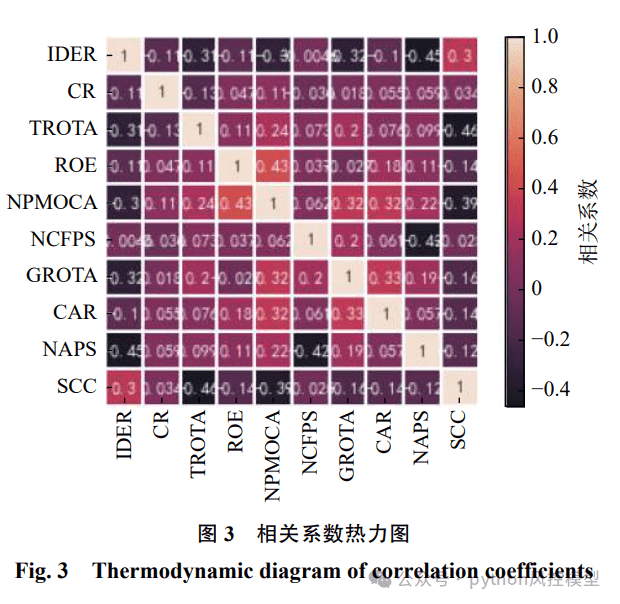
通过XGBoost的特征重要度排序,研究筛选出前10个关键特征。结果显示,上市公司信息披露考评结果(IDER)的重要性最高,这凸显了信息透明度在信用评价中的核心地位。同时,供应链集中度(SCC)入选表明,企业在供应链中的议价能力和依赖程度直接影响其违约风险。相关性分析显示,筛选后的特征间相关系数均小于0.5,有效避免了多重共线性问题,确保了模型输入的独立性。
实证结果与模型对比
本研究使用210家中小企业的数据集进行实证验证,其中正常企业137家,风险企业73家,存在明显的类别不平衡。实验设置了多组对比模型,包括基于不同优化算法的单一模型(BO-LR, BO-RF, BO-SVM, BO-KNN, BO-XGBoost)以及不同集成策略模型(BXA-AdaBoost, BXS-Stacking)。
实验结果显示,BXB模型在准确率、AUC值和F1值三个核心指标上均表现最佳。具体而言,BXB模型的准确率达到0.9206,相比单一BO-XGBoost模型提升了1.75%;AUC值为0.9623,F1值为0.8889。相比之下,基于AdaBoost的BXA模型表现极差,几乎无法区分风险类别,这可能与AdaBoost对噪声数据敏感且在本小样本场景中过拟合有关。Stacking模型虽然表现尚可,但不如Bagging稳定。
这一结果有力地证明了Bagging集成策略在降低XGBoost方差方面的有效性。BXB模型通过并行训练多个优化后的基模型,有效地平滑了预测结果,提升了对中小企业的风险识别能力,特别是在处理类别不平衡数据时表现出更强的鲁棒性。
局限性与未来展望
尽管BXB模型在学术验证中表现优异,但在实际商业落地中仍面临挑战。首先,计算成本高昂。Bagging需要训练数十个BO-XGBoost模型,每个模型本身就需要复杂的贝叶斯优化过程,这在实时性要求极高的银行风控系统中可能难以满足。其次,模型的可解释性进一步降低。多层集成属于典型的黑盒模型,风控人员难以追踪具体的违约判定依据,这在与监管合规和客户沟通时存在障碍。
此外,样本量的限制也是本研究的一个短板。210家企业的数据集对于深度学习或复杂集成模型而言偏小,虽然通过了交叉验证,但外部有效性仍需更大规模数据的检验。未来研究可探索轻量化集成策略,如使用更高效的代理模型进行超参数搜索,或结合SHAP值等解释性工具提升模型透明度。同时,引入更多维度的非结构化数据(如文本、图像)和多源异构数据,将是提升供应链金融信用评价精度的重要方向。
综上所述,BO-XGBoost-Bagging模型为供应链金融信用评价提供了一套行之有效的技术路径。它不仅解决了单一算法在偏差-方差权衡上的局限,还通过智能调参和特征筛选提升了模型的精度与稳定性。对于金融机构而言,理解这种算法融合背后的逻辑,比单纯调用API更为重要。在数字化浪潮下,唯有深入理解数据与算法的交互机制,才能构建出既高效又合规的智能风控体系,真正赋能中小企业的健康发展。