AI云原生治理突破:自适应熔断与流量调度新范式
传统治理机制在AI推理场景下的失效分析
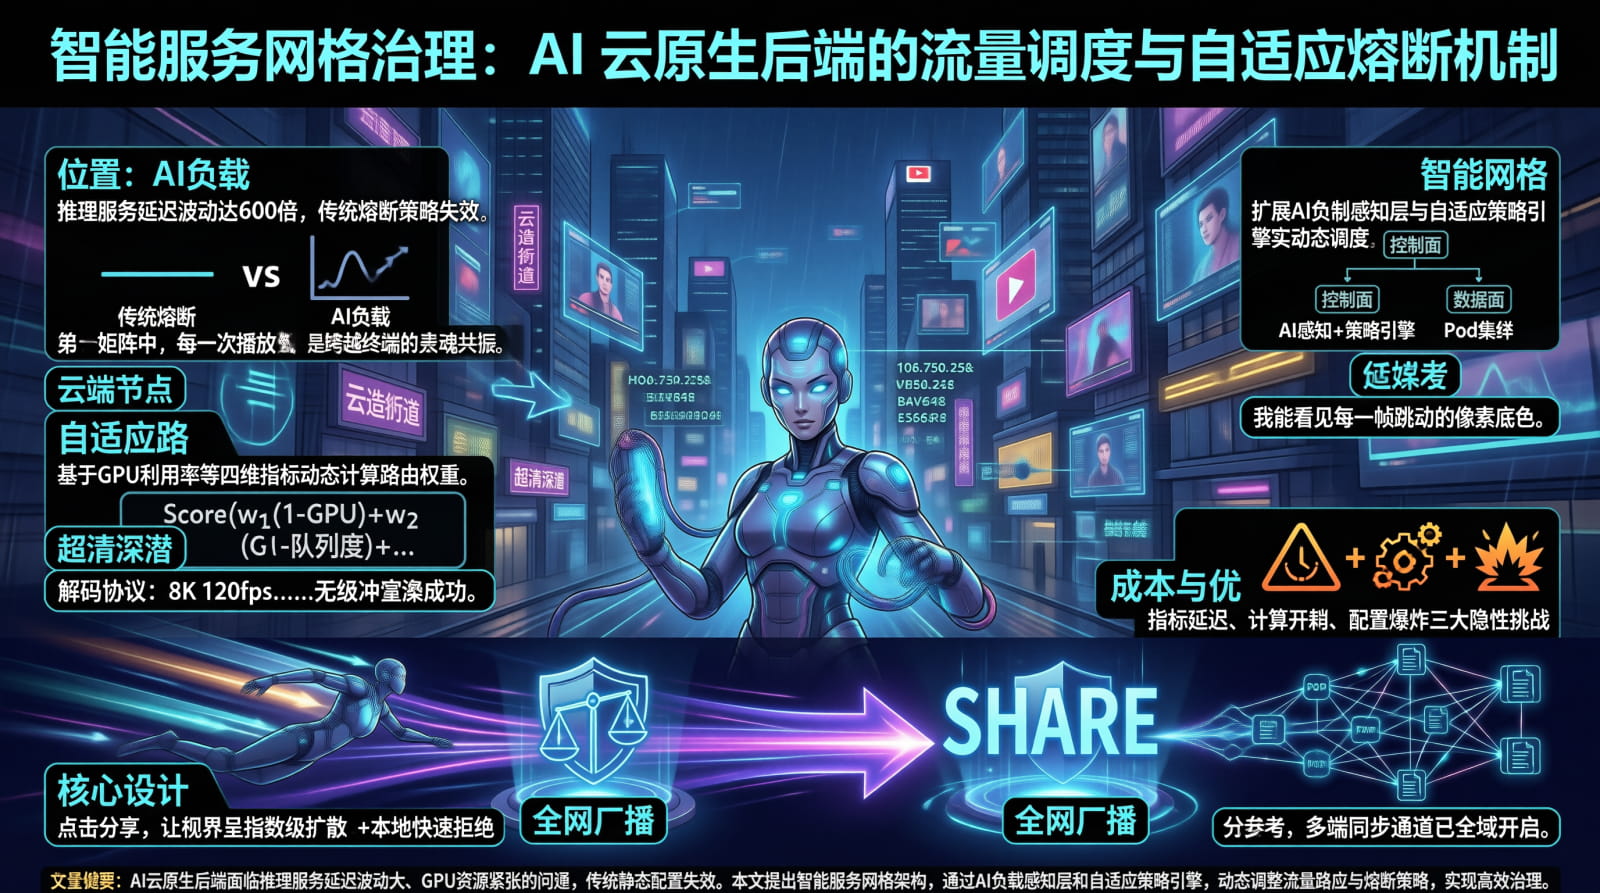
在云原生架构向AI领域深度渗透的过程中,后端服务治理面临着前所未有的复杂性。传统微服务架构通常假设请求处理时间相对稳定,延迟多集中在毫秒级且分布较为紧凑。然而,AI推理服务展现出截然不同的负载特征,其延迟呈现显著的长尾分布。这种差异并非细微的技术波动,而是底层计算逻辑与资源调度机制的根本性变革。同一个模型在不同输入token长度下的处理耗时,可能从50毫秒飙升至30秒,这种数百倍的波动使得基于固定阈值或固定时间窗口的传统熔断策略完全失效。
更为棘手的是,AI推理服务高度依赖GPU这一稀缺且具备有状态特性的计算资源。当某个推理请求占满GPU显存时,后续请求被迫进入排队等待状态,从而引发严重的"头阻塞"效应。在实际生产环境中,这种效应往往导致级联故障。例如,在某大型智能客服平台的线上事故中,一批长文本推理请求瞬间占用了集群内所有A100 GPU资源,导致原本响应迅速的短文本推理请求P99延迟从200毫秒激增至12秒,最终触发上游服务的全局超时崩溃。
服务网格作为云原生流量治理的基础设施,虽然具备动态路由、可观测性和细粒度流量控制的能力,但标准的Istio等开源方案缺乏对AI推理负载特征的深层感知。它们无法实时解析GPU利用率、推理队列深度等关键业务指标,从而难以进行精准的自适应调度。因此,构建智能服务网格治理体系的关键,在于将AI负载感知能力深度注入网格控制面,实现从"静态规则匹配"向"自适应策略优化"的架构升级。
智能服务网格的核心架构设计
智能服务网格在保留传统Istio架构稳定性的基础上,进行了关键性的扩展。核心创新在于引入了"AI负载感知层"与"自适应策略引擎"两大组件,使网格控制面能够根据推理服务的实时运行状态,动态调整流量分配与熔断策略。这一架构设计旨在解决静态配置与动态负载之间的矛盾,实现流量的精准滴灌与过载保护。
在数据平面,Envoy Sidecar作为流量入口,接收来自控制面的动态路由规则。在控制平面,AI负载感知层持续从各个推理Pod采集关键指标,包括GPU利用率、推理队列深度、P99延迟以及显存占用率。这些指标经过归一化处理后,被送入自适应策略引擎。引擎根据预设的权重模型计算每个Pod的健康分数,并据此动态调整Envoy的路由权重。
具体而言,GPU利用率较低、队列深度较小且延迟正常的Pod将获得更高的健康分数,从而被分配更多的流量;反之,处于高负载状态的Pod将被降权,甚至在触发硬性阈值时被熔断。这种基于实时状态的动态权重调整,确保了流量始终向最健康的节点倾斜,避免了资源浪费与服务雪崩。
自适应路由权重的算法实现逻辑
智能调度算法的核心在于如何量化Pod的健康状态。系统采用多维指标加权求和的方式计算健康分数,公式如下:
Score = w1 * (1 - GPU利用率) + w2 * (1 - 队列深度/最大深度) + w3 * (1 - P99/超时阈值) + w4 * (1 - 显存占用率)
在该公式中,各项指标的权重配置至关重要。默认配置通常侧重于GPU利用率,即w1=0.35,其次是队列深度和P99延迟,各占0.25,显存占用率权重相对较低,为0.15。这种权重分配反映了AI推理场景中GPU计算资源是最主要的瓶颈,而队列堆积和延迟波动是直接的恶化指标。
路由权重的分配则遵循比例原则。系统计算所有Pod的健康分数总和,各Pod的路由权重等于其分数占总分的比例,并映射为0-100的整数权重值。若总分归零,即所有Pod均处于不可用状态,系统将采用兜底策略,均匀分配权重,以尝试恢复部分服务能力。
在代码实现层面,Go语言编写的策略引擎负责高效计算这些权重。它通过多线程锁机制保证计算的原子性,并在每次计算周期(如每5秒)内遍历所有Pod指标,生成最新的路由配置并推送到Envoy。Python实现的Sidecar采集器则负责在推理Pod内部高效采集GPU状态与延迟数据,通过NVML接口避免命令调用的开销,确保指标的实时性与准确性。
生产环境中的隐性成本与挑战
尽管智能服务网格提供了强大的治理能力,但在实际落地过程中,开发者必须正视其引入的隐性成本与技术挑战。首要问题是指标采集延迟导致的路由滞后。GPU利用率等指标的采集周期通常为1-5秒,而突发流量可能在几秒内改变集群负载状态。这种时间差导致策略引擎的调整往往滞后于实际情况。在突发流量冲击下,过载节点可能在3-5秒内继续接收流量。为缓解此问题,建议在推理服务侧增加本地快速拒绝机制,当GPU利用率超过临界值(如90%)时,Pod直接返回503错误,形成第一道防线。
其次,策略计算本身带来的资源开销不容忽视。在大规模集群中,如包含数百个推理Pod,每次计算涉及数百个指标的归一化与加权求和。虽然单次计算耗时极短,但控制面需要将新的路由权重推送到所有Envoy实例。当集群规模超过500 Pod时,传统的XDS推送可能成为瓶颈。此时,必须启用增量XDS和Delta XDS技术,仅推送变更的配置,以降低网络与控制面的压力。
此外,配置维度的组合爆炸也是重大挑战。不同模型类型(如LLM、CV、语音)的负载特征差异巨大。LLM推理是显存密集型,CV推理是计算密集型,而流式语音推理对延迟极度敏感。为每种模型维护独立的权重配置将导致管理复杂度线性增长。建议采用"模型类型-权重模板-实例微调"的三级配置体系,将通用配置抽象为模板,仅在必要时进行局部调整,从而平衡灵活性与可维护性。
最后,需要明确智能服务网格的禁用场景。当推理集群规模较小(如少于3个Pod)时,动态调度的收益微乎其微,反而增加了系统的复杂度与延迟。此时,简单的轮询或最少连接数策略配合静态熔断阈值,往往是更高效、更稳定的选择。技术选型应始终服务于业务规模与需求,避免过度设计。
总结与展望
AI云原生后端的服务网格治理,本质上是应对AI推理服务长尾延迟特性与GPU资源稀缺性的系统性工程。智能服务网格通过注入负载感知能力与自适应策略引擎,实现了基于多维指标的智能路由与熔断。其成功落地依赖于三个关键设计:一是基于健康分数的动态权重分配,实现流量精准调度;二是硬性熔断阈值与本地快速拒绝机制相结合,构建双重保护屏障;三是采用分层配置体系,降低大规模集群的管理复杂度。
随着大模型应用的普及,AI推理服务的规模与复杂度将持续增长。未来的服务网格治理将更加注重对推理过程的细粒度感知,结合强化学习等AI技术,实现策略参数的自动调优。同时,硬件与软件协同优化也将成为趋势,如通过RDMA网络降低推理延迟,通过异构计算资源池化提升利用率。对于架构师而言,理解这些底层机制与技术权衡,是构建高可用、高性能AI基础设施的必备能力。在追求智能化的道路上,理性的工程实践与对技术边界的清醒认知,同样不可或缺。