鸿蒙为何力挺3D大模型?极顶数创V2Fun打破创作壁垒深度解析
从二维幻象到三维实体:3D生成为何成为AI新 frontier
在过去很长一段时间里,构建一个高质量的3D模型是一道极高的专业壁垒。从基础建模、拓扑重构,到UV展开、贴图绘制及材质调节,这一整套复杂的专业软件操作流程,将绝大多数非专业创作者挡在了门外。然而,随着人工智能技术的指数级进步,3D创作正迎来历史性的转折点——它正逐渐从少数专家的专利,转变为普通人也能轻松驾驭的工具,其普及速度之快,甚至足以媲美数码照片取代胶卷的过程。
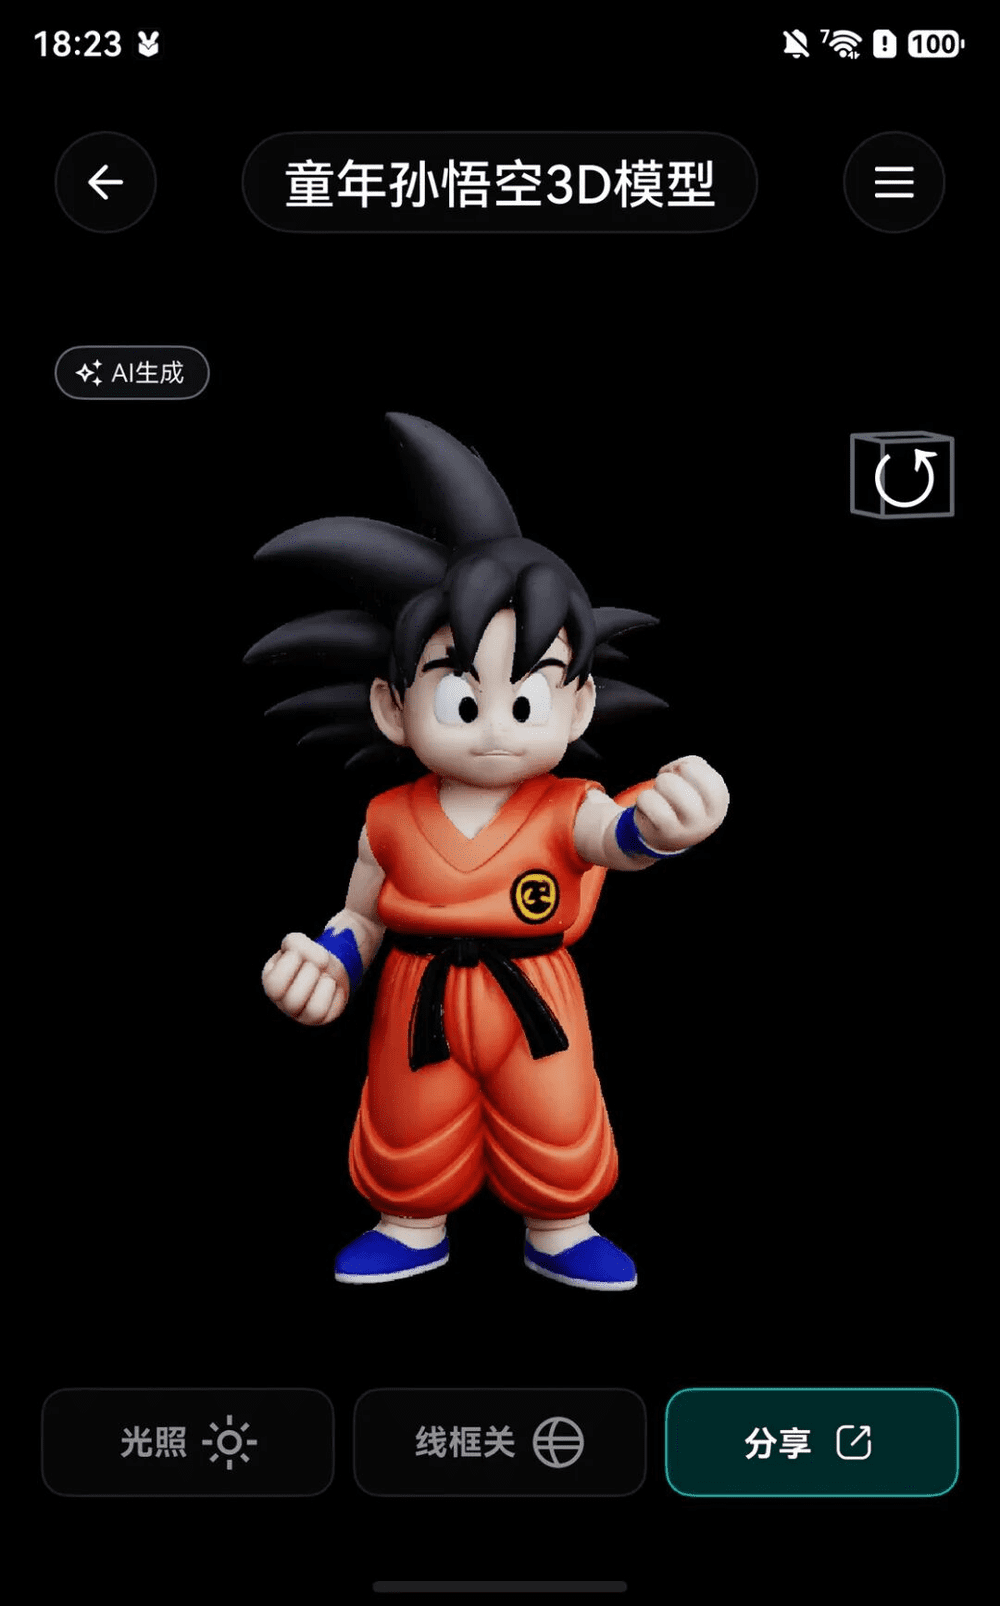
在这一变革浪潮中,极顶数创(Vertex Lab)及其核心产品V2Fun的崛起,并非偶然。作为一家由顶尖科研团队主导的3D大模型公司,极顶数创选择了一条更为艰难但前景广阔的道路:专注于3D内容生成。这与当前主流的文本、图像和视频生成赛道形成了鲜明对比。为什么是3D?为什么是鸿蒙?一支研究型团队如何在商业与科研之间找到平衡?这些问题构成了理解这家公司的核心钥匙。
技术内核重构:从“猜”到“懂”的模型迭代
3D生成之所以被视为AI从“二维内容生成”迈向“三维世界生成”的关键基础设施,是因为其底层逻辑的复杂性远超2D。真正的空间智能和世界模型,必须建立在对三维结构的深刻理解之上。3D生成不仅要解决几何结构的准确性,还要兼顾纹理细节、多视角一致性以及资产的可用性。这种多重约束使得技术攻关极具挑战性,但也正因为其难度,使得成功突破者能够构建起深厚的技术护城河。
极顶数创的技术演进路径清晰地展示了这一攻坚过程。早期的“2D升3D”技术,类似于让AI根据几张图片去推测物体的立体结构。这种方法虽然速度快、上手门槛低,但在处理复杂造型时往往力不从心,且在不同视角下容易出现结构错位。为了解决这一问题,极顶数创引入了VAE(变分自编码器)结合Diffusion(扩散模型)的方案。VAE将庞杂的3D数据压缩为紧凑的潜在表示,再由扩散模型在此基础进行生成,显著提升了细节和复杂纹理的表现力。
然而,技术的脚步并未停止。目前,V2Fun已迭代至VAE+DiT(Diffusion Transformer)架构。这一架构的引入是革命性的,它将模型的核心骨架替换为与大语言模型同源的Transformer。这种转变使得模型能够同时处理形状、质感、多视角语义等高维数据,从而在保证生成结果稳定性的同时,实现了对复杂场景的精准控制。这种从“猜测”到“理解”的技术跃迁,正是极顶数创区别于其他竞争对手的核心竞争力所在。
几何与纹理的联袂优化:破解精度与效率的博弈
在3D生成的质量评估中,几何结构的保存方式与纹理贴图的生成效果是两个决定性因素。传统方法往往面临精度均一性的问题,即无论物体表面是平滑还是复杂,都采用相同密度的数据进行记录,导致数据冗余且计算负担沉重。
极顶数创通过创新的几何算法解决了这一痛点。系统仅在形状复杂或细节丰富的区域使用更密集的数据点进行记录,而在平滑区域则减少数据密度。这种“按需分配”的策略,在保持高精度的同时,大幅降低了数据量和计算成本,实现了精度与效率的完美平衡。
在纹理贴图方面,主流做法通常是将AI生成的多张不同角度图片强行“贴”在模型表面,这不仅难以补全被遮挡的细节,还容易导致多视角间的视觉冲突。V2Fun采用的方案则更为精细:它将纹理分为“全局”和“局部”两个层级。全局部分确立整体结构和色调,局部部分则利用高清小图块补充表面微观细节。所有视角和图块通过统一的三维表面表达进行信息交换,这种设计不仅轻量高效,且与角度数量和分辨率彻底解耦,能够在推理阶段轻松支持8K甚至12K的高清纹理渲染。
鸿蒙生态的必然选择:技术互补与场景契合
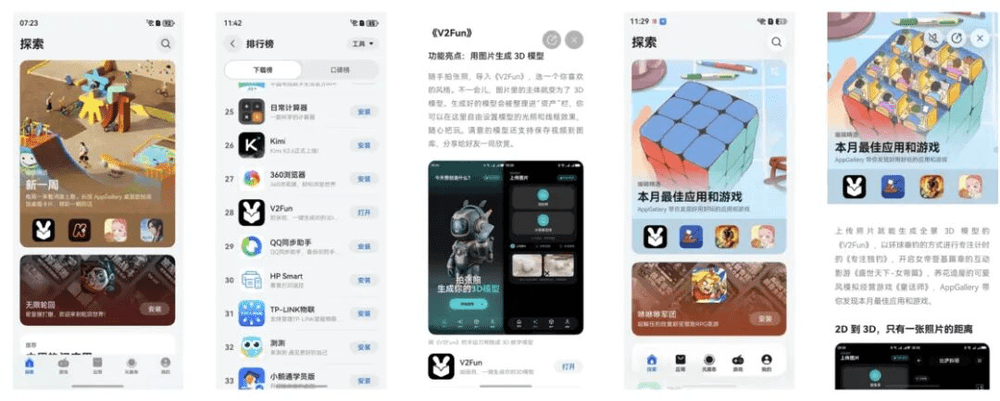
选择鸿蒙平台作为V2Fun的移动应用首发阵地,是极顶数创基于技术和生态双重考量的战略决策。在技术层面,鸿蒙系统的分布式能力和原生智能特性,为3D大模型的移动端部署提供了良好的运行环境。在生态层面,鸿蒙拥有庞大的用户基础和对空间计算、XR体验的开放态度,这与3D生成内容的展示和应用场景高度契合。
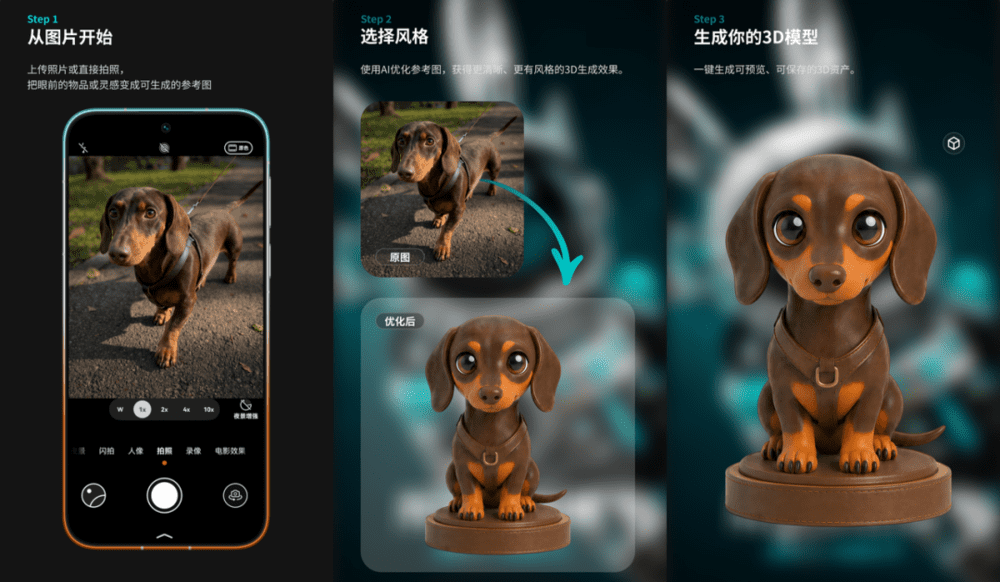
对于移动端的大众用户而言,V2Fun极大地降低了3D创作门槛。无需任何建模基础,用户只需上传照片,即可生成高质量的3D模型。根据后台数据反馈,用户生成频率最高的类别是人像和宠物。这一现象印证了一个深刻的情感洞察:人们最渴望留住的,是与自身有强烈情感连接的实体形象。自拍、证件照、合影以及宠物的3D化,不仅满足了用户的娱乐需求,更成为一种新的情感数字化表达方式。
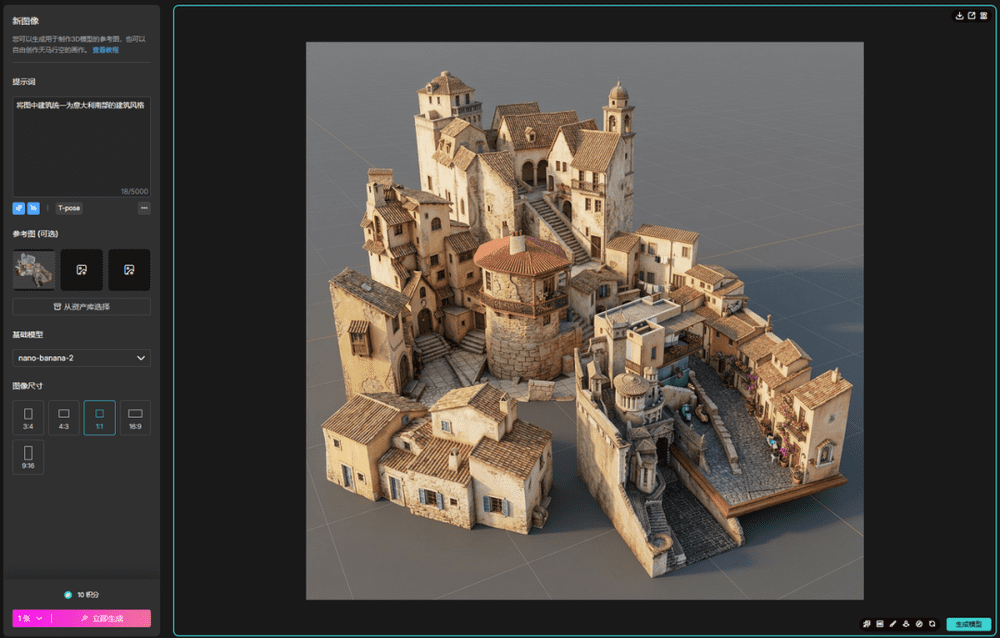
相比之下,V2Fun的网页版则服务于更具专业需求的群体。例如,资深游戏原画师喵不灵,在尝试独立创作大型童话小镇项目时,因建筑细节和空间搭建的工作量过大而屡屡受挫。V2Fun的Web端提供了更强大的算力和更精细的控制选项,使得专业用户能够利用AI辅助完成繁琐的资产制作,从而将精力集中在创意构思和核心设计上。这种双端并行的策略,既覆盖了大众市场的流量需求,又满足了专业市场的深度生产力需求。
从资产到世界:3D原生资产进化的长期主义
在3D生成赛道中,大厂与其他创业公司竞争激烈,但极顶数创的差异化路径在于其长期主义的视野:从“3D原生资产”进化到“3D世界模型”。这一路径并非简单的功能堆砌,而是对3D内容生成本质的重新定义。
首先,V2Fun致力于生成带有精准几何、材质和骨骼的高精度实体,确保资产的结构性确定性。这是构建虚拟世界的基础砖石。其次,未来的规划是赋予这些静态资产以动作和骨骼,使其具备动态表现力。最终,通过动作控制与动态记忆机制,实现主体与环境之间的物理交互和因果推演,从而收敛为一个全功能的世界模型。
这一愿景的核心在于打破纯2D视频与纯3D路线的局限。纯2D路线缺乏三维结构,在高频交互下容易出现画面变形;而纯3D路线虽能生成精美场景,却往往缺失时间维度和动态交互能力。极顶数创提出的解决方案是:以带实体模型、动画和骨骼的“真3D”为主体,借助面向交互的“动作控制视频生成技术”为环境引入时间与因果。
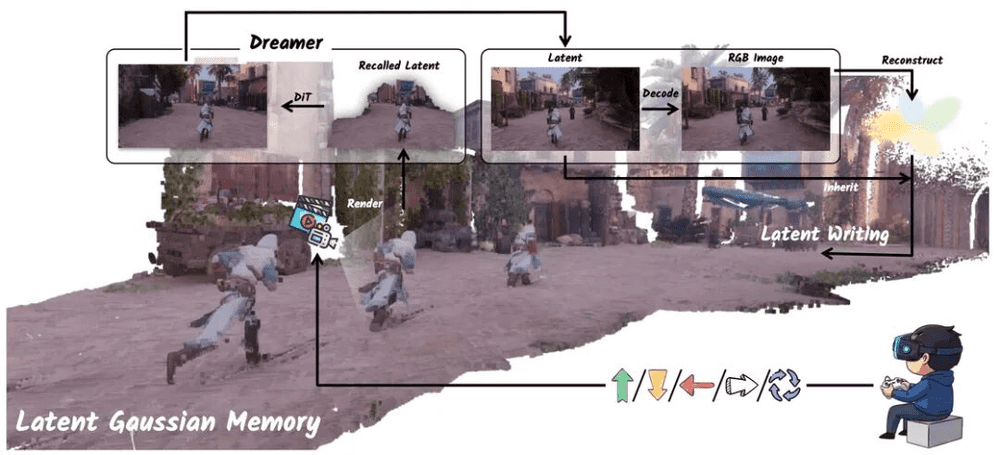
在具体技术实现上,极顶数创正在研究“隐空间高斯记忆体”和“动态偏差归档机制”。前者将实时的动作和视角切换转化为3D记忆颗粒,确保AI在长程漫游中仍能精准召回空间记忆;后者则在交互推理过程中自动修正长程误差,保证场景、颜色和结构的一致性。这些前沿研究不仅体现了极顶数创作为“研究型团队”的技术底色,也为其在下一代世界模型竞争中奠定了先发优势。
情感与理性的交汇:AI创作的终极意义
尽管极顶数创的技术蓝图宏大且充满理性色彩,但其产品逻辑的起点和终点,却始终回归于人的情感体验。创始人嵇盼博士分享了一个看似平常却极具触动性的故事:他用V2Fun为自己一岁半的孩子生成了一个3D模型。
那天,孩子刚睡醒,头发凌乱,坐在爬爬垫上啃咬积木,神情专注。嵇盼随手拍下一张照片,输入模型,很快一个圆滚滚的小人形象跃然屏上。不仅形态逼真,连孩子嘟起的小嘴和翘起的头发等细微表情都被完美还原。当爱人看到这一成果时,惊叹于其真实度。这一刻,技术不再是冷冰冰的参数,而是承载家庭记忆和情感连接的载体。
这一案例揭示了AI内容生成的另一重意义:它不仅是生产力的工具,更是情感的延伸。对于极顶数创而言,虽然其目标受众包括专业的动画师和游戏公司,但真正让团队感到欣慰和坚持的,是技术能够以最自然的方式,融入普通人的生活,留住那些稍纵即逝的美好瞬间。这种从“服务专业”到“温暖日常”的转变,或许正是3D大模型未来最广阔的想象空间所在。
综上所述,极顶数创通过深厚的技术积累和对用户需求的敏锐洞察,正在重塑3D内容的生产方式。从鸿蒙平台的生态协同,到VAE+DiT的技术迭代,再到从资产到世界模型的长远规划,极顶数创展示了一种既具前瞻性又接地气的发展路径。在AI重塑内容创作的进程中,3D大模型不仅是技术的突破,更是人类想象力和情感表达的新维度。