BW2026见证:AMD联手联想首发锐龙AI Max旗舰,如何重塑端侧AI算力边界?
端侧AI算力重构:从云端向边缘的范式转移
在数字娱乐与人工智能深度融合的当下,个人计算设备的角色正在经历深刻的定义重构。7月10日,Bilibili World 2026在上海国家会展中心盛大开幕,AMD以「为热爱全力以赴」为主题首次正式参展,这不仅是一次品牌曝光,更标志着移动计算领域的一次重要技术宣言。AMD与联想携手,正式发布了基于最新锐龙AI Max系列处理器的两款旗舰新品——YOGA Pro 15锐龙AI创作本与联想AIPC 拯救者R9000X游戏本。这两款产品的问世,不仅仅是硬件规格的升级,更是对“端侧AI”这一概念的实质性落地,旨在解决用户在本地运行大模型时的算力瓶颈与隐私顾虑。
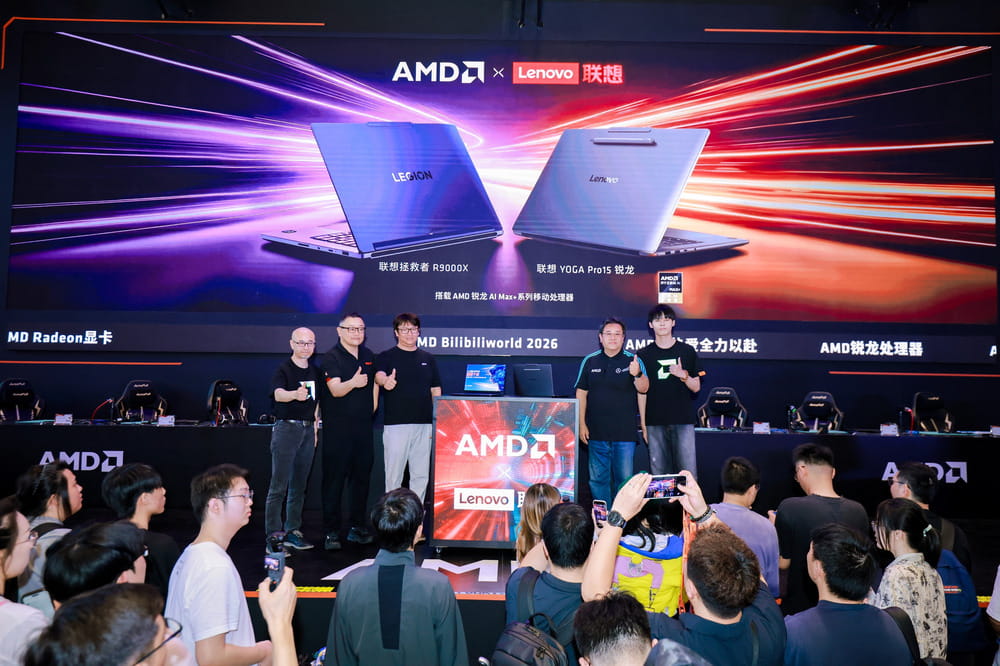
长期以来,人工智能的应用高度依赖云端算力,这带来了网络延迟、数据隐私泄露以及持续订阅成本高等痛点。随着XDNA 2架构NPU算力的大幅提升,将大语言模型部署在本地终端已成为可能。此次发布的锐龙AI Max+ 388与锐龙AI Max+ 392处理器,正是为了解决这一核心矛盾而生。它们通过极高的NPU算力与统一内存架构,实现了在轻薄机身内提供超越传统独显笔记本的AI处理性能,为专业创作者和硬核玩家开辟了一条全新的高性能路径。

YOGA Pro 15:定义专业创意工作的AI新标准

对于内容创作者而言,设备的便携性与性能释放的平衡往往是难以兼得的痛点。YOGA Pro 15锐龙AI创作本的诞生,正是为了打破这一僵局。作为联想首款搭载锐龙AI Max+ 388处理器的机型,它并没有盲目追求极致的硬件堆砌,而是聚焦于端侧AI算力的深度挖掘。
该机型最引人注目的特性在于其64GB超大容量统一内存。在传统的PC架构中,CPU与GPU各自拥有独立的显存,数据交换存在带宽瓶颈。而锐龙AI Max+ 388采用的统一内存架构,允许系统将最高48GB的内存动态分配为显存使用。这一设计极大地提升了数据处理效率,使得在本地流畅运行70B参数级别的大型语言模型成为现实。对于需要处理海量素材、进行复杂逻辑推演的AI创作者来说,这种本地化的AI推理能力意味着更低的延迟和更高的数据安全性。
除了核心的AI算力,YOGA Pro 15在交互体验上也进行了针对性升级。其搭载的全域压感触控板获得了Wacom官方认证,支持4096级压感,这意味着数字画家可以直接在笔记本上进行高精度的线条绘制,无需额外携带数位板。此外,1100尼特的峰值亮度屏幕与双PANTONE色彩认证,确保了在户外强光或专业修图场景下的色彩准确性。1.7kg的重量控制,更是让这台具备强大AI算力的“移动工作室”真正实现了随取随用。
拯救者R9000X:轻薄机身下的性能怪兽
游戏玩家群体对性能的需求同样苛刻,但他们更看重设备在便携性与性能释放之间的平衡。拯救者R9000X的推出,重新定义了高性能游戏本的形态。整机重量仅为1.55kg,厚度控制在15.9mm,使其成为当前市面上最轻薄的AMD锐龙AI Max+系列游戏本。
在内部配置上,拯救者R9000X搭载了锐龙AI Max+ 392处理器,配备12核心24线程,最高加速频率可达5.0GHz。更关键的是,其内置的Radeon 8060S集成显卡拥有40个计算单元,NPU算力高达50 TOPS。这种强大的集成算力使得设备无需依赖独立显卡,即可实现120W的性能释放。在测试场景中,无论是主流竞技网游还是部分对图形性能要求较高的3A大作,R9000X均能保持流畅运行。这种去独显化的设计,不仅降低了硬件成本,更提升了整机的能效比与稳定性。
屏幕方面,拯救者R9000X配备了一块2.5K分辨率、165Hz刷新率的OLED高刷屏。OLED面板带来的高对比度与快速响应时间,完美契合了电竞玩家对视觉流畅度的极致追求。同时,1.5mm键程与清晰段落感的键盘设计,以及高负载下出色的温控表现,确保了长时间游戏过程中的舒适度与稳定性。对于兼具游戏娱乐与内容创作需求的用户而言,这是一款真正意义上的全能型设备。
天禧AI 4.0:让本地大模型成为日常生产力
硬件是基础,软件生态才是激发硬件潜力的关键。两款新品均内置了联想自研的天禧AI 4.0系统,这是实现本地大模型“即用化”的核心驱动力。天禧AI 4.0并非简单的语音助手升级,而是深入系统底层的智能代理。
借助锐龙AI Max+系列的50 TOPS NPU算力,天禧AI 4.0能够在完全脱离网络连接的环境下,高效运行本地大模型。这意味着用户可以随时调用专属AI助手进行文案撰写、创意发散、素材处理以及复杂文档总结。对于注重数据隐私的企业用户或个人创作者而言,数据无需上传至云端,而是在本地完成推理,从根本上杜绝了敏感信息泄露的风险。此外,本地部署还避免了按量付费的模式,长期来看降低了用户的使用成本。
在应用场景上,天禧AI 4.0展现出了极高的适应性。在YOGA Pro 15上,它主要服务于效率提升,辅助创作者完成繁琐的前期准备工作;而在拯救者R9000X上,它则赋能游戏生态,通过AI辅助游戏技巧分析与渲染加速,提升了游戏内容的创作效率。这种双管齐下的策略,覆盖了从专业生产力到大众娱乐的广泛需求。
锐龙AI Max+系列:移动AI算力的新标杆
从技术架构来看,锐龙AI Max+系列处理器代表了AMD在移动平台上的最新技术成果。锐龙AI Max+ 392采用Zen 5架构,这是AMD在CPU指令集优化上的重大突破,带来了更高的IPC(每时钟周期指令数)提升。8核16线程的锐龙AI Max+ 388与12核24线程的锐龙AI Max+ 392,形成了完整的产品梯队,覆盖了从入门级AI创作到旗舰级高性能游戏的全场景需求。

两者的共同点在于都集成了40个计算单元的Radeon 8060S集成显卡与50 TOPS算力的XDNA 2 NPU。统一内存架构的引入,是这一系列处理器的另一大亮点。通过四通道256bit高带宽内存连接,CPU、GPU与NPU之间实现了数据的高速互通。这种架构设计特别适合于AI推理任务,因为大模型运行需要大量的数据在处理器单元间频繁交换,高带宽与低延迟的统一内存池,极大地消除了数据传输瓶颈。
未来展望:端侧AI的无限可能
AMD与联想在BW2026上的合作,展示了科技巨头在构建AI PC生态上的决心。随着端侧算力的持续提升,未来的个人计算设备将不再仅仅是信息的展示终端,而是具备独立思考与处理能力的智能体。

千帧电竞解决方案的亮相,也预示着AI在图形渲染与帧生成技术上的进一步突破。通过AI插帧技术,硬件可以以更低的功耗实现更高的视觉流畅度,这将彻底改变游戏体验。对于内容创作者而言,本地AI的普及意味着工作流的全面革新,从素材生成到后期处理,AI将深度介入每一个环节。
此次发布的新品,不仅是AMD锐龙AI Max系列产品的成功落地,更是整个PC行业向AI时代迈进的重要里程碑。在2026年7月的上海,我们见证的不仅是两款新品的首发,更是一种全新计算范式的确立。未来,随着更多开发者针对NPU优化软件,以及更大规模本地模型的轻量化突破,端侧AI将成为个人计算设备不可或缺的核心能力,真正实现对云服务的补充与超越。