Qwen2.5-7B微调实战:基于MS-Swift的高效落地指南
引言:大模型垂直化落地的关键路径
在生成式人工智能快速演进的当下,通用大模型虽然具备强大的基础能力,但在面对特定行业的专业术语、复杂逻辑推理或定制化交互需求时,往往显得力不从心。模型微调(Fine-tuning)成为了连接通用能力与垂直场景的关键桥梁。其中,参数高效微调技术如LoRA(Low-Rank Adaptation),因其在显存占用、训练成本及推理效率上的显著优势,已成为业界的主流选择。
本文将以国产开源大模型Qwen2.5-7B为对象,依托MS-Swift框架,详细拆解一套完整、高效且可落地的微调实践方案。我们将超越简单的代码堆砌,从底层硬件资源匹配、核心依赖配置,到训练策略的参数博弈,直至最终的模型合并与推理加速,提供一份具备工程指导意义的实战白皮书。
一、 基础设施与环境基座构建
微调工作的稳定性首先取决于底层环境的一致性。Qwen2.5-7B作为中等参数规模的模型,对算力资源有明确门槛。建议采用Ubuntu 22.04操作系统,搭配Python 3.10及PyTorch 2.1.2版本,以确保框架兼容性。硬件层面,单张NVIDIA GeForce RTX 4090(24GB显存)是性价比较高的起点,配合CUDA 11.8驱动,能够满足LoRA微调的基本显存需求。
核心依赖链部署
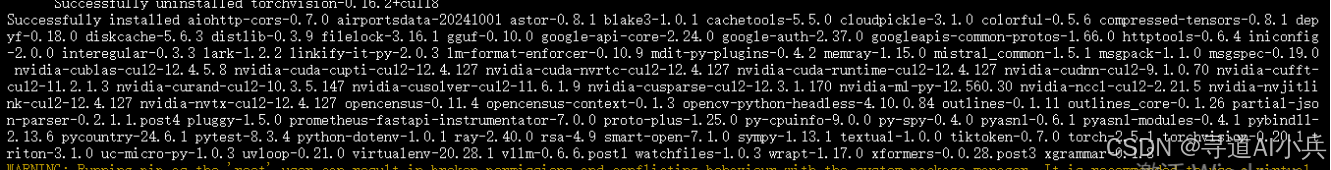
MS-Swift并非孤立存在,其背后依赖着一套完整的生态工具链。
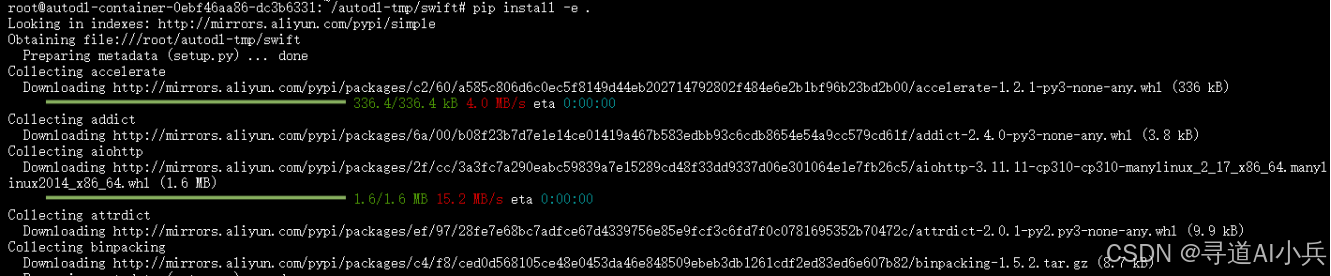
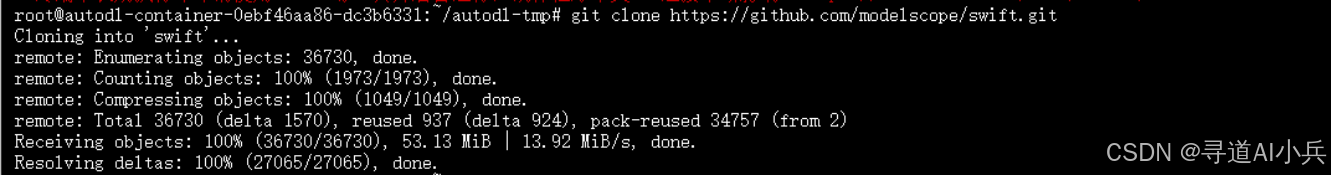
首先,获取MS-Swift源码。通过Git克隆官方仓库,并采用pip install -e .进行开发模式安装。这种安装方式不仅拉取运行时依赖,更允许开发者随时修改框架源码并即时生效,对于排查深层bug或适配特殊数据格式至关重要。
其次,推理加速引擎vLLM的安装不可忽略。尽管微调阶段主要使用PyTorch,但在后续推理及模型合并环节,vLLM提供的PagedAttention机制能大幅提升吞吐量。执行pip install vllm即可将其纳入环境,为后续性能优化预留接口。
模型权重的获取与管理
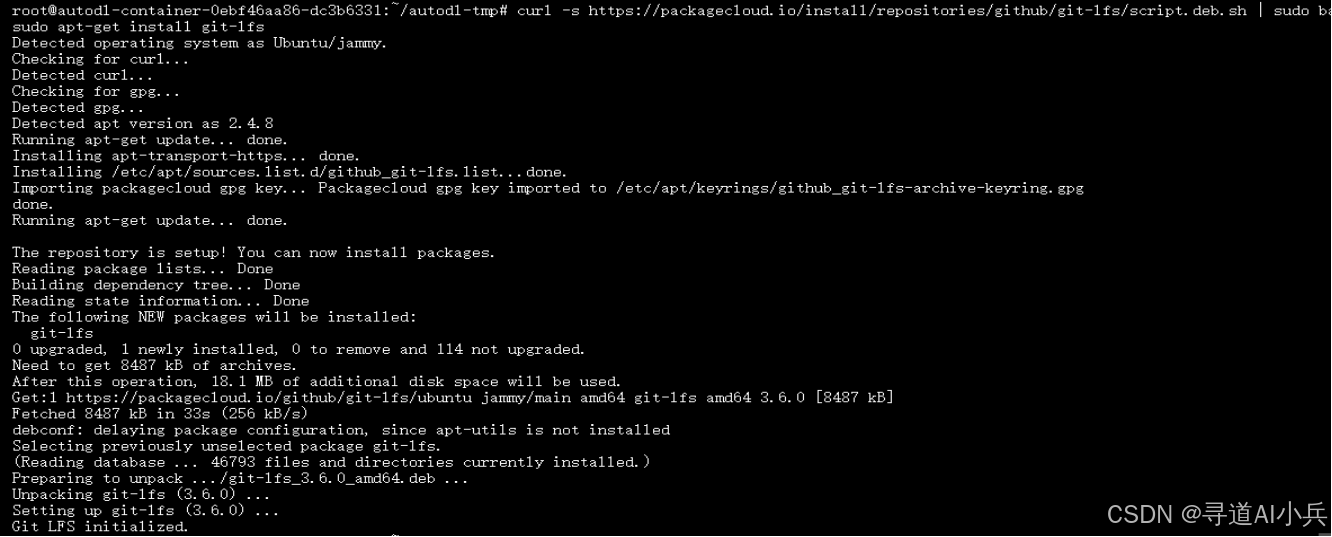
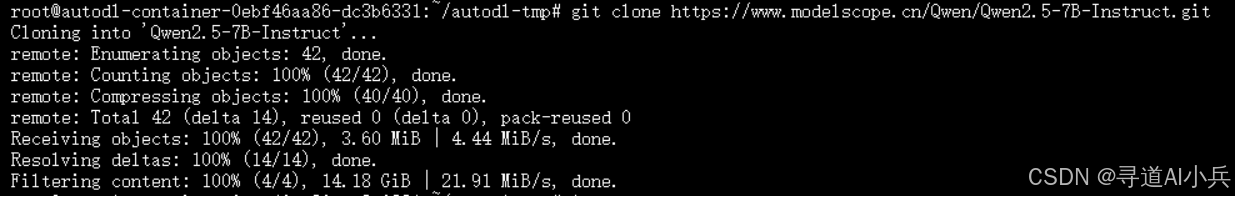
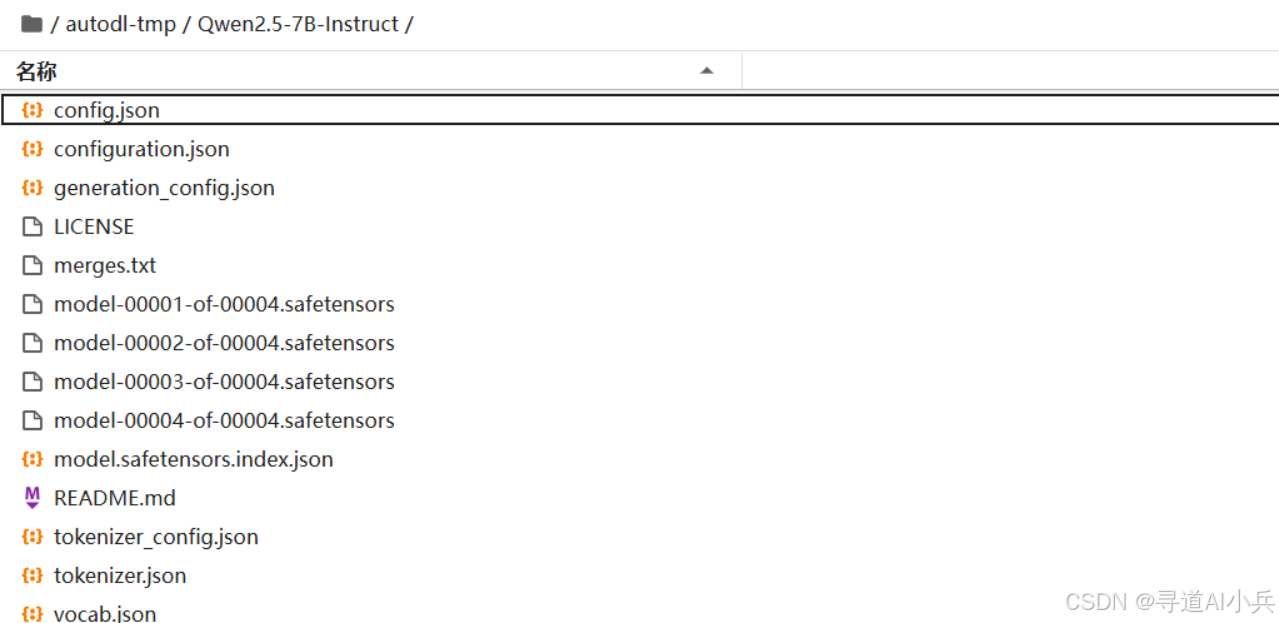
模型权重的下载是微调的前置步骤。推荐使用ModelScope(魔搭社区)进行下载,其针对国内网络环境进行了优化。执行git clone https://www.modelscope.cn/Qwen/Qwen2.5-7B-Instruct.git前,需确保已安装git-lfs。大语言模型的权重文件通常巨大,lfs工具能保障二进制文件的完整性与传输稳定性。下载完成后,需校验文件结构,确保config.json、tokenizer及bin文件完整无缺,这是避免训练中途崩溃的第一道防线。
二、 数据驱动:构建高质量微调语料
“Garbage in, garbage out”在深度学习领域依然适用。Qwen2.5-7B的指令遵循能力虽强,但通过高质量指令数据(Instruction Data)的微调,能显著增强其在特定领域的表现。
MS-Swift提供了便捷的数据集管理接口。本次实践组合了三类核心数据集:
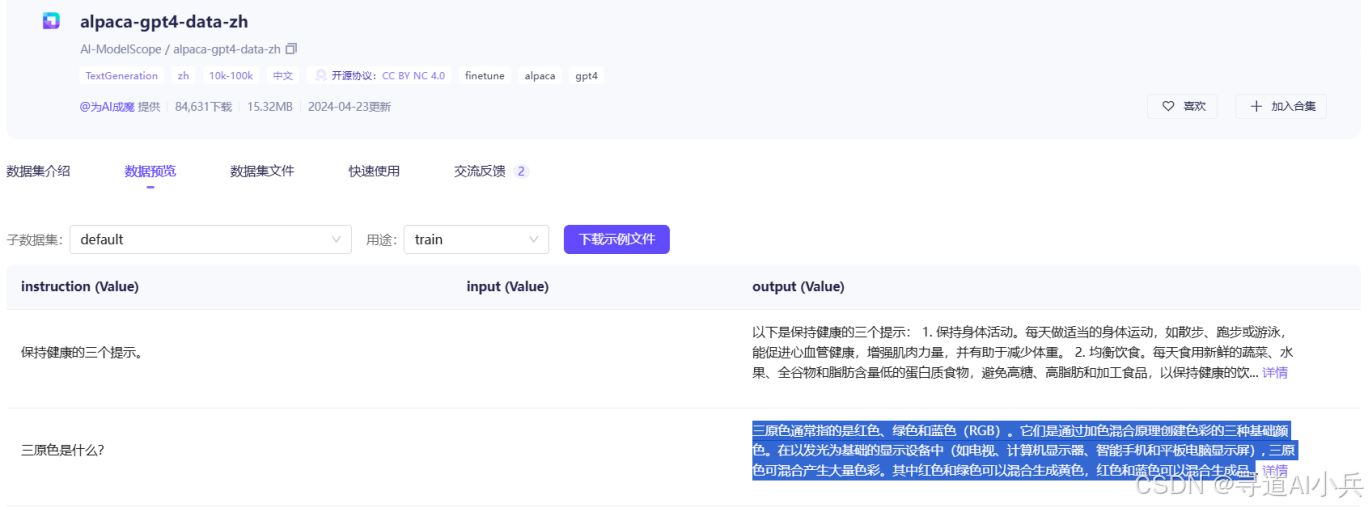
- 通用指令数据集:包括中文和英文的Alpaca-GPT4数据。这类数据由GPT-4生成,涵盖了广泛的指令类型、知识领域和语言风格,是提升模型通用指令遵循能力的基石。
- 自我认知数据集:针对模型身份识别进行专项训练,防止模型在对话中产生幻觉或身份混淆,增强交互的稳定性。
- 领域特定数据:在实际业务中,应替换为垂直领域的专业问答对。例如,金融领域的研报分析、医疗领域的症状咨询等。
数据格式需严格遵循JSON或JSONL规范,包含instruction、input和output字段。MS-Swift支持直接从HuggingFace或ModelScope加载数据集,例如AI-ModelScope/alpaca-gpt4-data-zh#500表示加载中文Alpaca数据集的前500条样本。这种按需加载机制,允许开发者在资源有限时进行小规模验证,快速迭代数据策略。
三、 核心实战:LoRA微调参数工程
微调的核心在于平衡模型性能与资源消耗。MS-Swift通过简洁的命令行参数,实现了复杂的训练流程控制。以下是对关键超参数的深度解析与配置建议。
训练策略与显存优化
- 混合精度训练:设置
--torch_dtype bfloat16。相比float32,bfloat16在保证数值稳定性的同时,大幅减少显存占用并加速矩阵运算,尤其适合Ampere架构及以上的NVIDIA GPU。 - 梯度累积:设置
--gradient_accumulation_steps 16。由于单卡显存限制,per_device_train_batch_size设为1。通过梯度累积,等效于较大的Batch Size,使模型在多次反向传播后更新参数,从而获得更稳定的梯度估计,缓解小Batch带来的噪声干扰。 - 学习率与预热:学习率设为
1e-4,预热比例0.05。预热机制在训练初期缓慢提升学习率,避免模型因初始步长过大而发散,有助于平稳进入优化器的高效搜索区域。
LoRA参数配置详解
LoRA通过冻结预训练权重,注入低秩矩阵进行训练。关键参数包括:
--target_modules all-linear:指定对所有线性层应用LoRA。线性层负责主要特征变换,覆盖所有线性层能最大化微调效果,但会略微增加显存开销。若显存紧张,可仅针对q_proj,v_proj等核心注意力层进行微调。--lora_rank 8与--lora_alpha 32:Rank控制低秩矩阵的维度,Rank=8是性能与效率的常见平衡点。Alpha值作为缩放因子,公式为LoRA_output = W0 * x + (alpha/rank) * B * A * x。Alpha设为32意味着放大LoRA贡献,以补偿低秩带来的信息损失,加速收敛。
训练流程监控
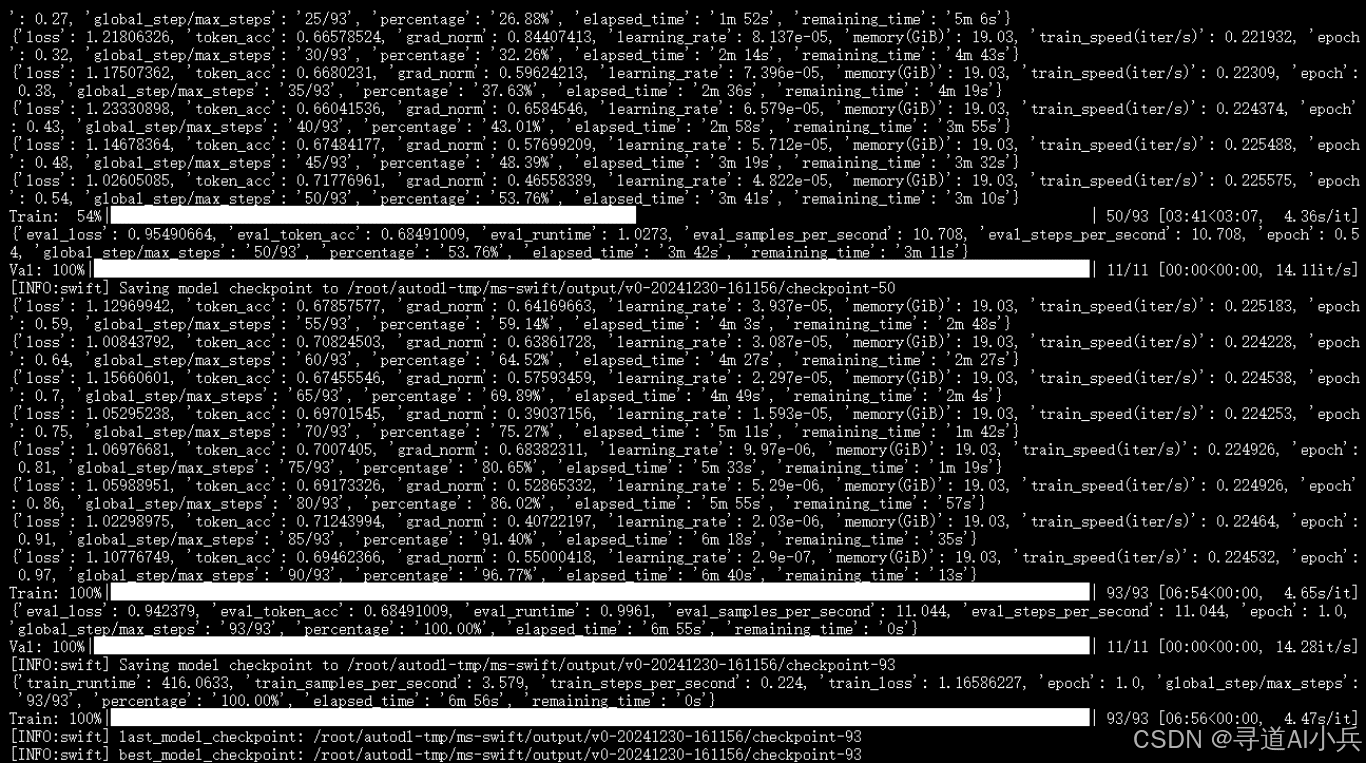
设置--num_train_epochs 1用于快速验证流程,实际生产中建议根据验证集Loss曲线逐步增加轮次。通过--eval_steps 50和--save_steps 50定期评估与保存检查点,配合--logging_steps 5的详细日志,开发者可实时监控Loss下降趋势。若发现Loss不降反升,需立即检查学习率或数据分布异常。
执行微调命令后,约10分钟即可完成小规模验证训练。输出目录将生成包含LoRA权重文件(adapter_model.bin)的检查点文件夹。这些文件极小(通常仅几十MB),却包含了模型在特定任务上的全部新知识,实现了“小文件撬动大模型”的效果。
四、 推理加速与模型部署优化
微调完成仅是第一步,如何高效部署并服务于生产环境同样关键。
直接推理与权重合并
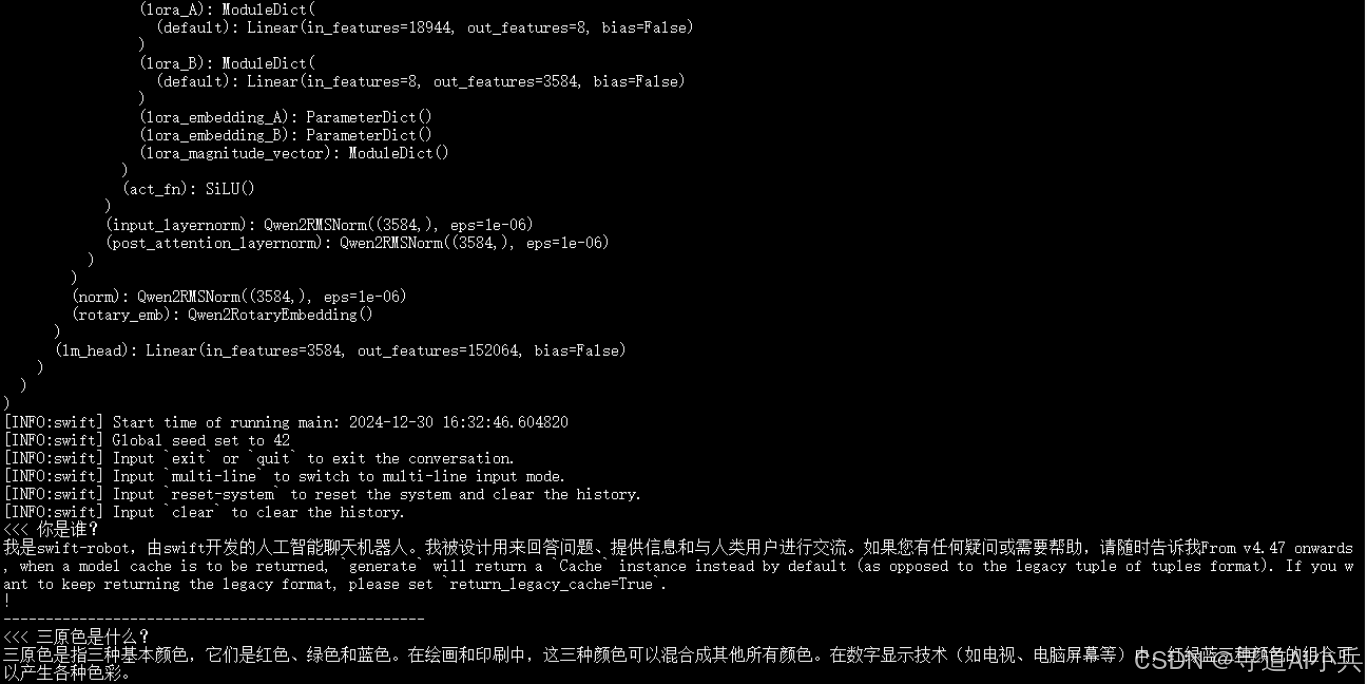
MS-Swift支持直接加载LoRA适配器进行推理,无需合并权重即可验证效果。使用swift infer命令,指定--adapters指向检查点路径。此时,模型在内存中动态加载基座权重与LoRA权重,推理速度受限于PyTorch原生的动态图执行效率。
然而,在生产环境中,动态加载会增加推理延迟。因此,通常需要将LoRA权重合并回基座模型。执行--merge_lora true,MS-Swift会将LoRA矩阵线性化并加回原始权重,生成一个新的、完整的模型文件。合并后的模型在推理时无需额外计算LoRA分支,显著降低延迟。
vLLM赋能的高吞吐推理
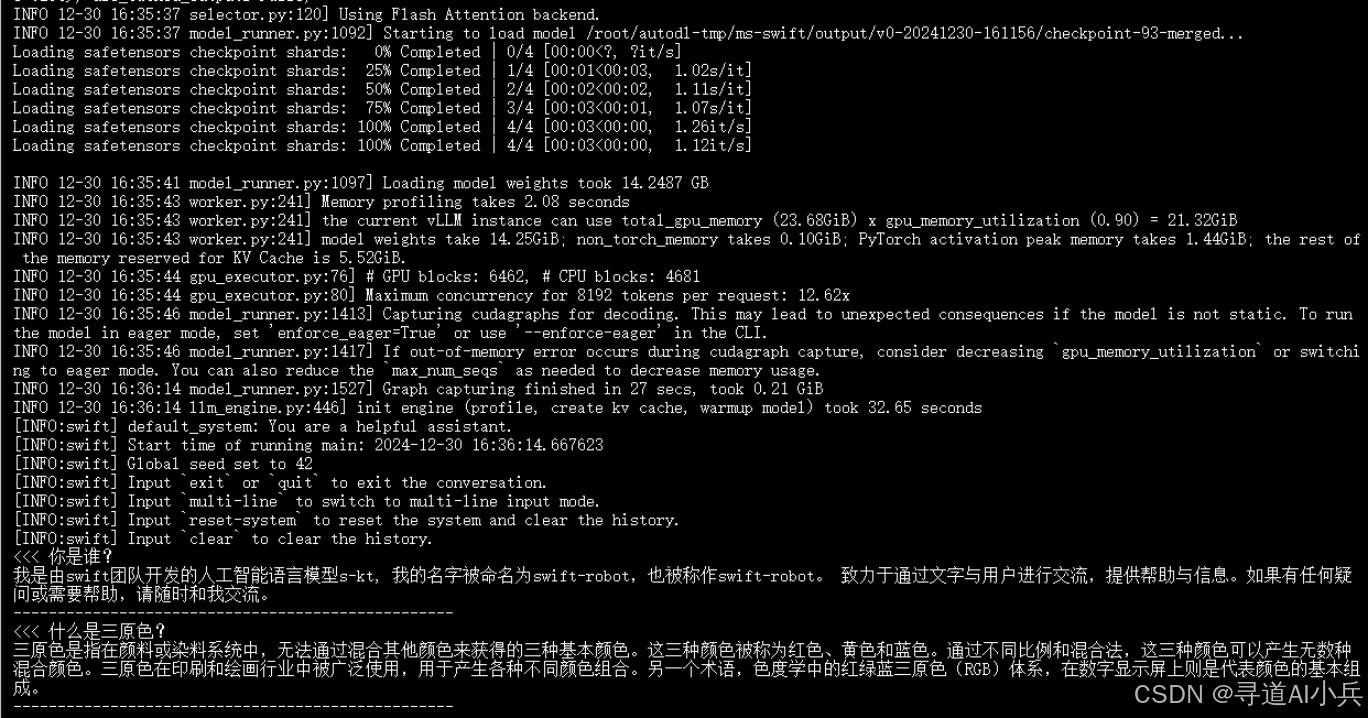
合并后的模型可接入vLLM引擎。设置--infer_backend vllm,vLLM利用其独创的PagedAttention算法,对KV Cache进行连续内存管理,有效解决显存碎片化问题。对于长上下文场景,vLLM能支持比传统PyTorch推理大得多的Batch Size和序列长度(如--max_model_len 8192)。实测表明,在相同硬件下,vLLM的推理吞吐量通常比原生推理高出数倍,显著降低单位Token的计算成本。
五、 可视化交互:降低开发门槛
对于非算法背景的开发者或需要进行快速原型验证的场景,命令行操作存在一定门槛。MS-Swift提供了内置的Web-UI界面。
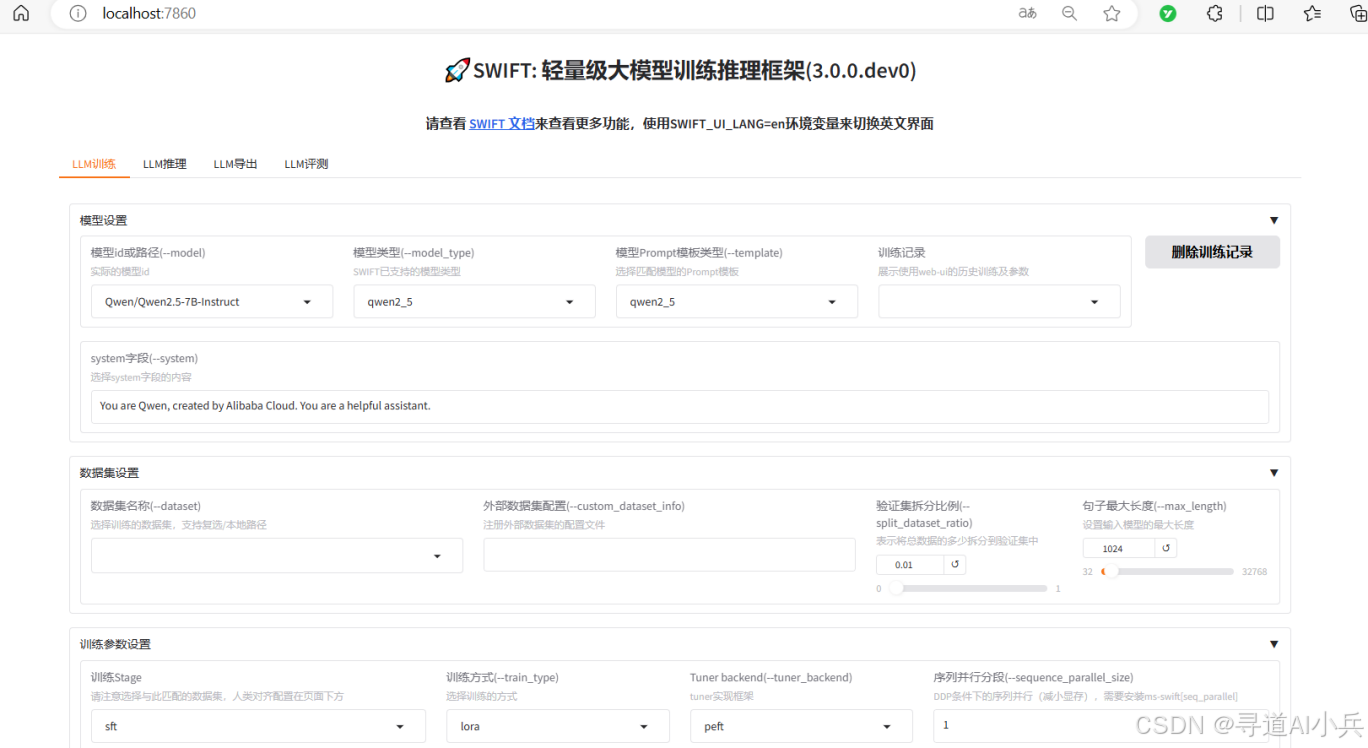
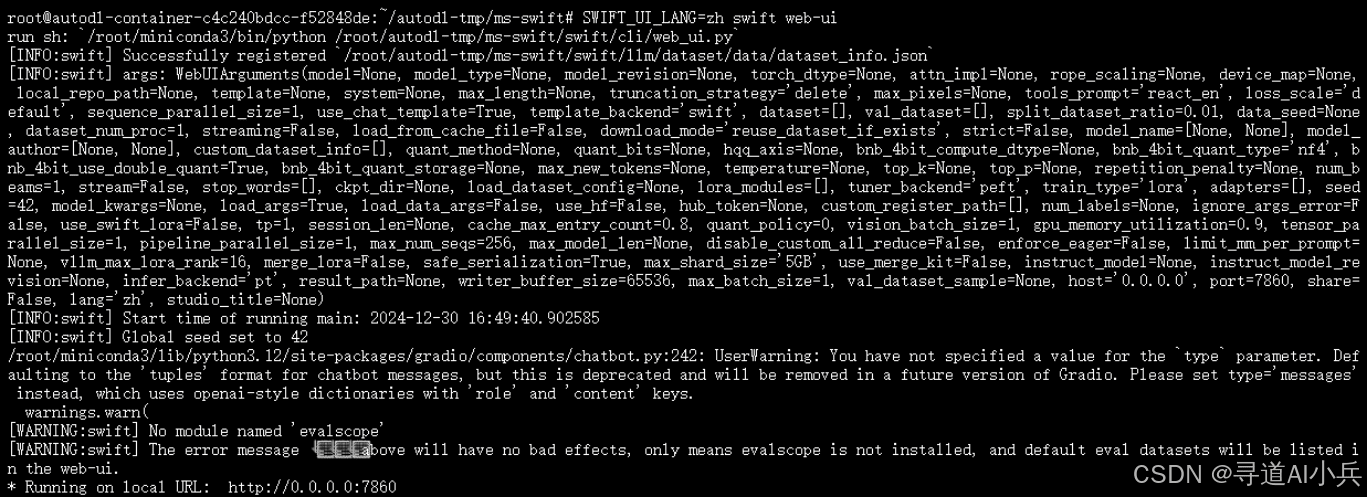
启动SWIFT_UI_LANG=zh swift web-ui,即可在本地启动一个可视化的操作面板。该界面集成了模型选择、数据集上传、超参数配置、训练启动及推理测试等全流程功能。用户无需记忆复杂的命令行参数,只需通过下拉菜单和输入框即可构建训练任务。
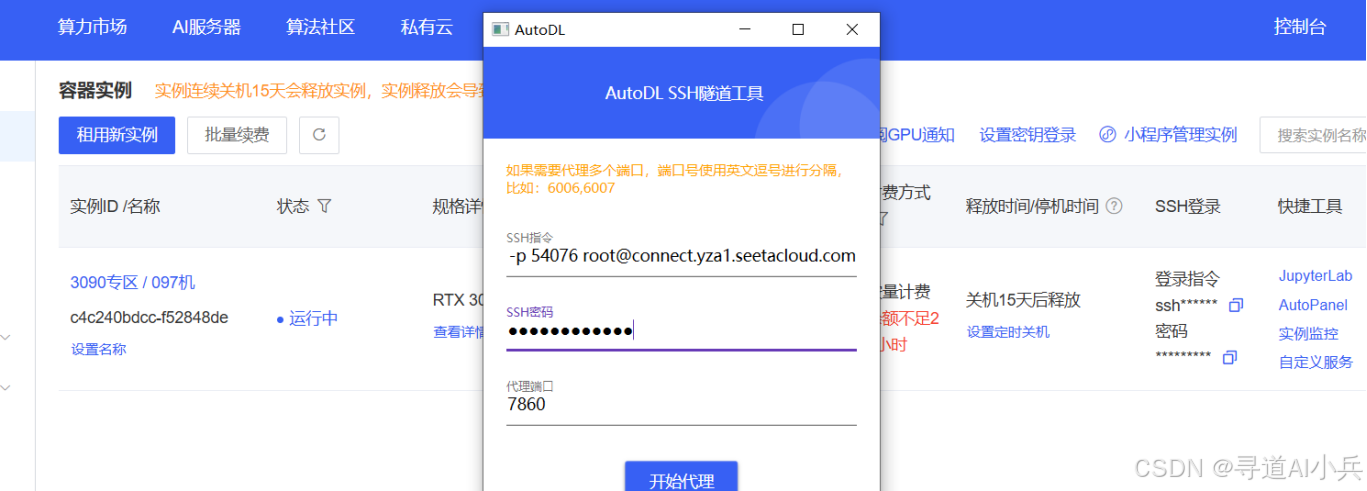
在AutoDL等云端环境中,需配置端口代理将本地7860端口映射至公网。通过浏览器访问,开发者可直观监控训练进度条、Loss曲线,并实时输入Prompt测试模型回复。这种可视化交互不仅提升了开发效率,也为团队协作和非技术人员参与模型调优提供了友好入口。
结语
通过本文对Qwen2.5-7B在MS-Swift框架下的微调实践梳理,我们构建了一个从环境准备、数据构建、参数调优到推理部署的闭环工作流。LoRA技术与高效框架的结合,使得单卡微调专业级模型成为可能。未来,随着模型架构的进一步轻量化与推理引擎的持续进化,大模型的垂直化落地将更加平民化与智能化。开发者应重点关注数据质量对模型表现的边际效应,以及在特定场景下对显存、延迟与吞吐量的精细化权衡,从而真正释放AI在垂直领域的巨大价值。