海光DCU性能调优实战:从hipprof分层剖析到气象Transformer瓶颈突破
在国产化算力基础设施加速普及的背景下,海光DCU(Deep Computing Unit)已成为许多高性能计算与AI训练场景的重要选择。然而,当模型在DCU上实现从“能跑通”到“跑得快”的跨越时,开发者往往容易陷入一个误区:过分关注设备利用率指标,却忽视了利用率背后的复杂成因。利用率低并不直接等同于矩阵计算未饱和,它可能是由频繁的短Kernel发射、数据搬运延迟、内存碎片化、CPU侧同步阻塞或不连续张量物化共同导致的。本文将以海光DCU为研究对象,结合hipprof工具,通过最小可控实验与真实气象Transformer案例,构建一套严谨的性能分析与优化方法论。
构建多维度的性能证据分层体系
在海光DCU生态中进行PyTorch程序的性能剖析,首要任务是建立清晰的证据分层逻辑。不同层级的数据揭示了不同维度的系统行为,且各自的统计口径截然不同,混用这些数据会导致错误的优化决策。
我们可以将性能证据划分为五个核心层级。首先是设备状态层,通过hy-smi工具获取GPU的核心频率、显存带宽占用及整体利用率,这是判断系统是否处于基本健康状态的第一步。其次是HIP API层,使用hipprof --hip-trace --stats采集主机侧花费在内存分配(hipMalloc)、数据拷贝(hipMemcpy)及Kernel发射(hipLaunchKernel)上的时间。这一层数据反映的是CPU-GPU交互的开销,而非GPU的实际计算时间。
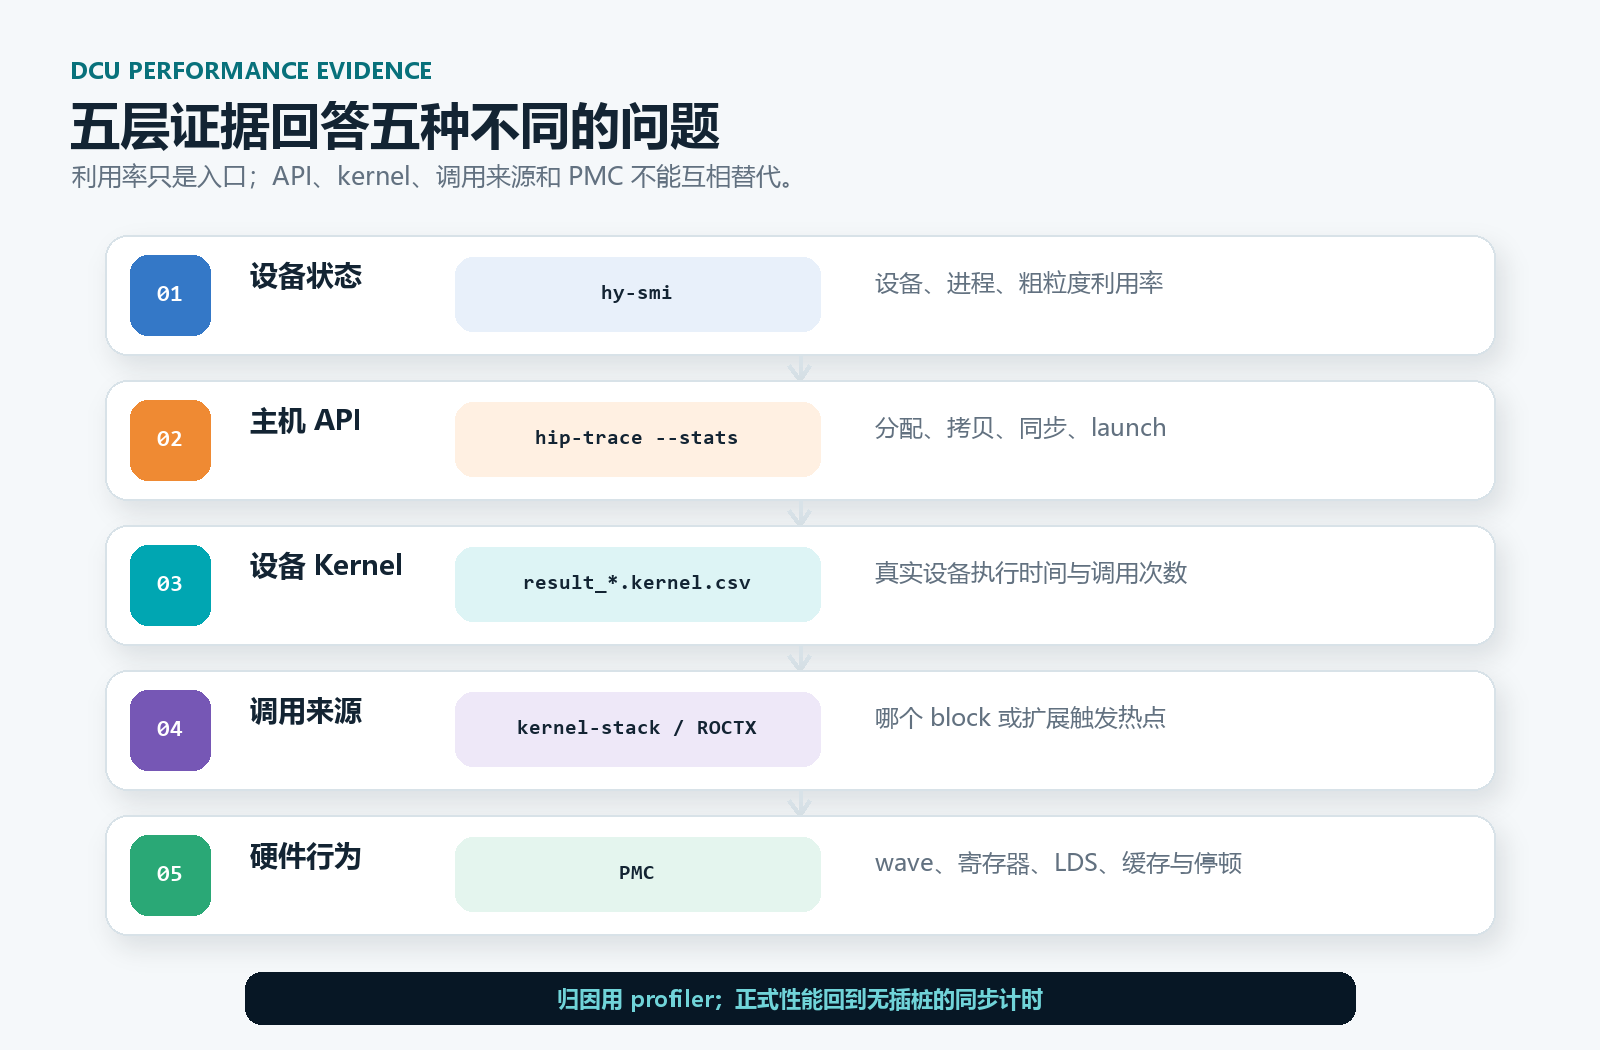
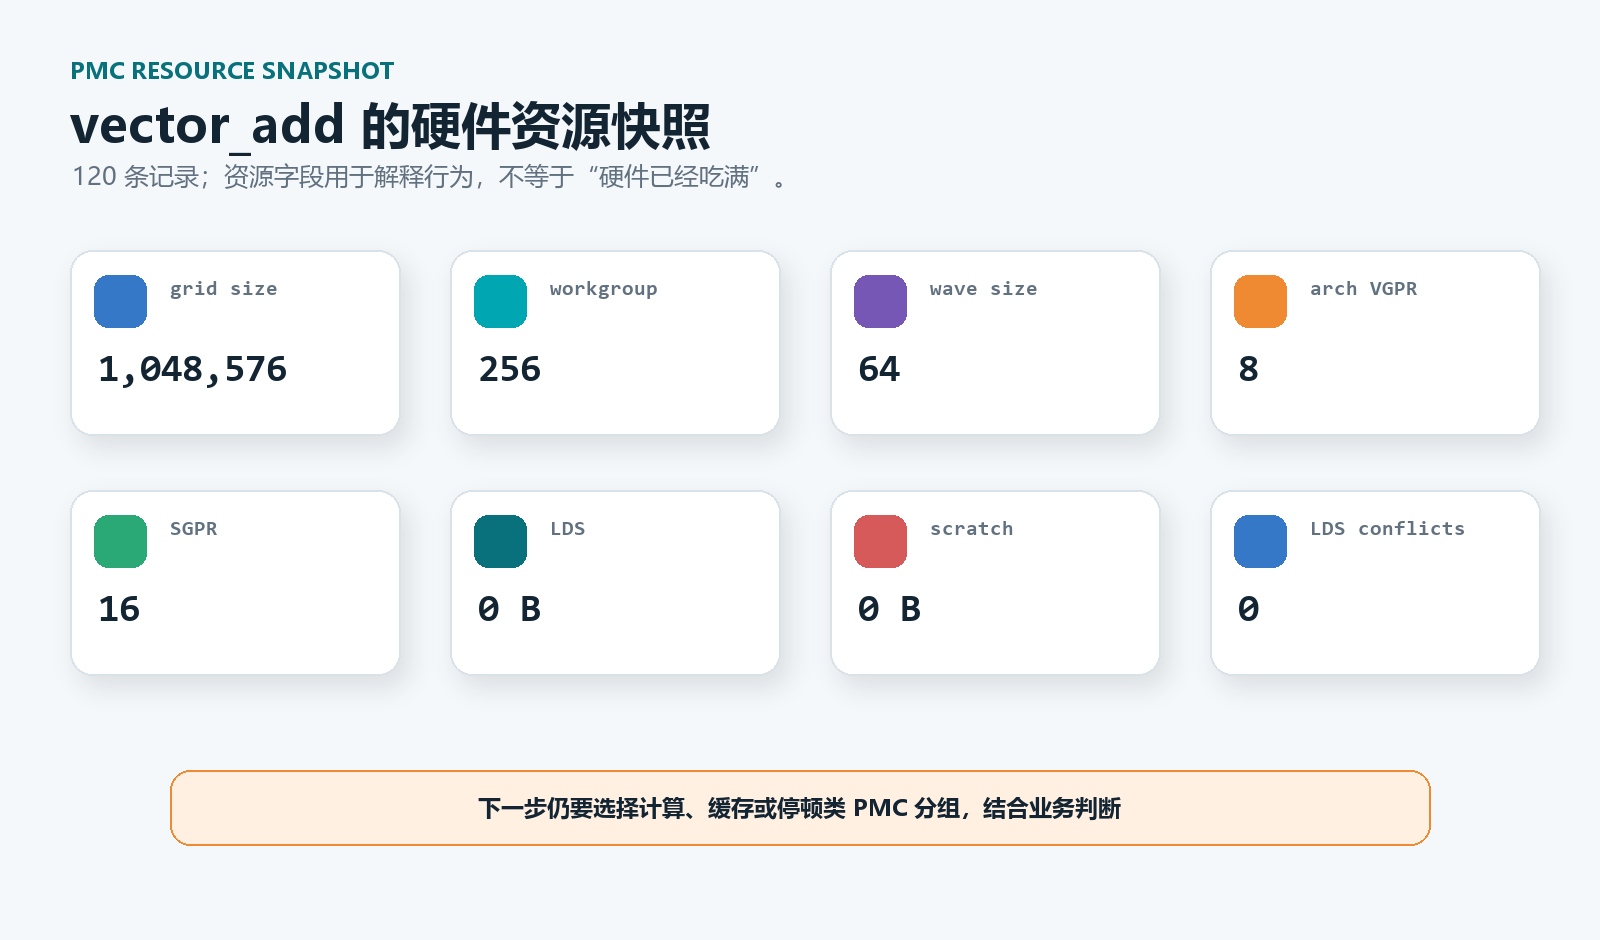
第三层是设备Kernel层,即hipprof生成的kernel.csv文件。这里记录的是GPU硬件真正执行各个算子(Kernel)所消耗的时间,是衡量计算密度的核心依据。第四层为调用来源层,通过--kernel-stack或--hiptx-trace参数,将底层的GPU Kernel映射回上层Python调用栈或C++函数路径,从而定位是哪个模块触发了特定的计算行为。最后一层是硬件行为层,利用PMC(Performance Monitoring Counters)采集Wavefront执行效率、寄存器占用、LDS(本地数据共享)访问冲突及缓存命中率等底层硬件指标,用于解释“为什么某个Kernel慢”。
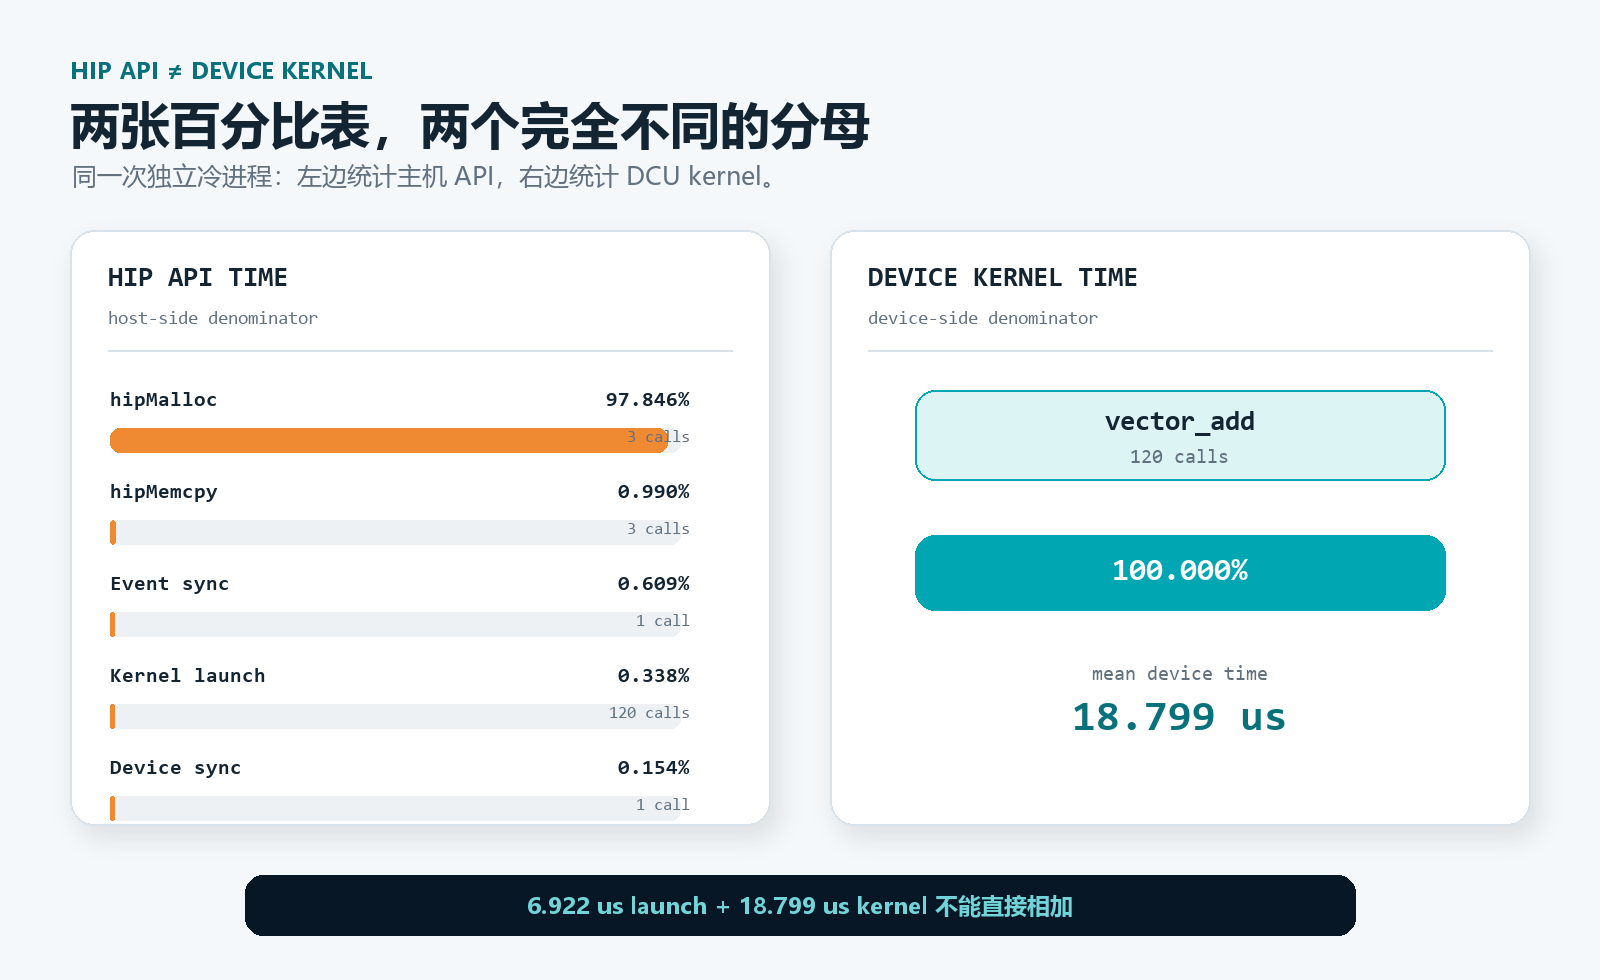
理解这些层级的差异至关重要。例如,hipLaunchKernel API时间的占比高,可能仅意味着主机侧提交开销大,而非计算瓶颈;而PMC数据虽然能揭示寄存器压力,但其插桩过程会严重干扰程序执行,导致测得的时间失真。因此,必须严格隔离不同工具的输出,避免将不同维度的指标进行简单加减。
实验环境与隔离采集策略
为了获得可复现且准确的分析结果,实验环境需保持一致性。本文基于Ubuntu 22.04 LTS系统,搭载海光DCU(架构标识gfx936),使用DTK 25.04.2工具链及PyTorch 2.5.1版本。在实际操作中,切忌一次性叠加--hip-trace、--kernel-stack、--pmc及--memory-usage等多个参数。不同采集模式对程序的扰动程度差异巨大,叠加使用不仅会导致数据解析复杂化,还可能引入新的性能瓶颈。
建议采用隔离采集策略,将正常运行、Stats统计、Kernel栈采集和PMC采集分别放入不同的执行进程与输出目录。例如,先运行一次无插桩的基准测试,记录由HIP Event同步得到的真实耗时;随后分别运行Stats和Stack模式,生成独立的CSV文件;最后针对特定热点Kernel运行PMC模式。这种目录隔离方式不仅便于区分不同PID产生的文件,更能确保在复查数据时,能够准确追溯到每一条数据对应的采集模式,避免混淆。
深度解析:从API开销到Kernel热点
在隔离采集后,首先分析--hip-trace --stats生成的数据。在一个简单的Vector Add实验中,我们观察到hipMalloc占据了API执行时间的近98%,但这主要是由于进程冷启动时的三次分配所致。对于长期运行的推理服务,冷启动开销可忽略不计;但对于批处理中每个样本都动态分配显存的场景,内存分配才可能是真正的瓶颈。此外,hipLaunchKernel的主机API平均耗时仅约6.9微秒,而设备Kernel平均耗时约18.8微秒。这揭示了异步流水中,主机提交与设备执行是并行的,不能简单相加得出单个Kernel的总耗时。--stats模式因数据量小、解析快,非常适合作为第一轮筛选,快速识别出占据主导地位的API类型或Kernel名称。
接下来,利用--kernel-stack寻找Kernel的上层调用者。在Vector Add中,栈回溯清晰指向了用户代码中的vector_add()函数。但在复杂的PyTorch模型中,栈信息往往只能追溯到libtorch_hip.so或librocblas.so等底层库。此时,单纯依赖栈信息难以精确定位,需结合Kernel的调用索引(Index)与CSV文件中的Launch ID进行关联,或通过缩小输入规模、在关键代码块插入ROCTX Range并配合--hiptx-trace来细化观测范围。Kernel名称本身仅告诉我们要优化什么,而调用栈才能告诉我们是谁触发了它,以及为何触发。
PMC的真实面目与性能干扰警示
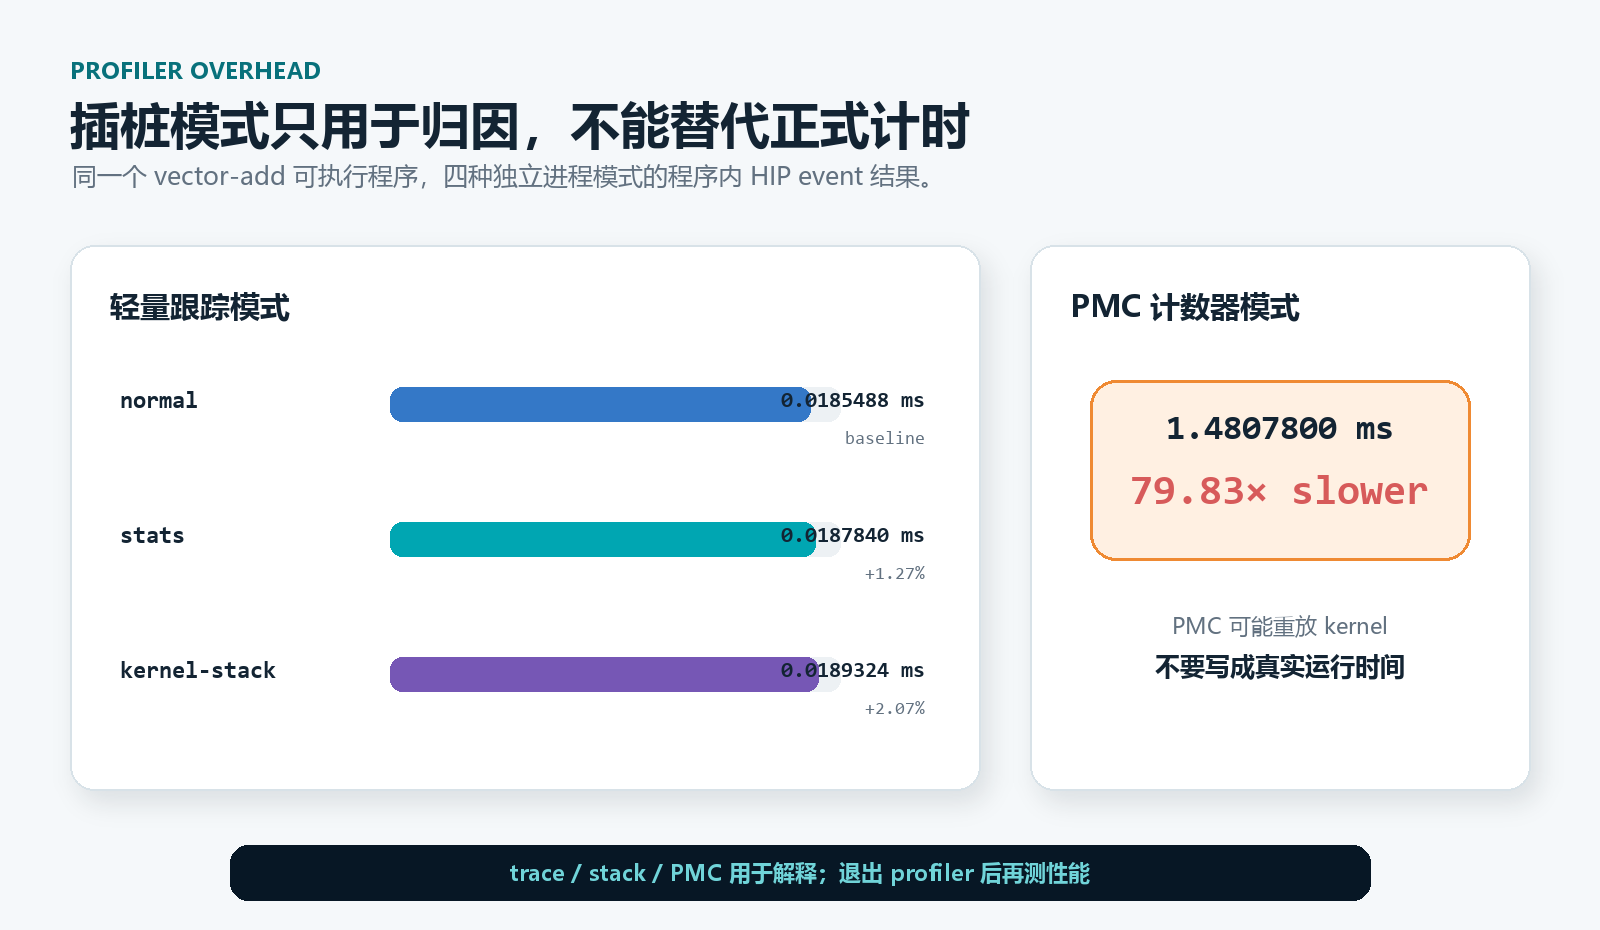
PMC(Performance Monitoring Counters)是深入硬件底层诊断的有力工具,但其最大的陷阱在于“干扰性”。在同一Vector Add程序中,正常运行的耗时约为0.0185毫秒;开启Stats模式后耗时微增至0.0187毫秒;而启用PMC采集后,耗时飙升至1.48毫秒,增幅近80倍。这种巨大的偏差源于PMC需要读取硬件计数器,某些模式甚至需要重复或重放Kernel执行以获取完整计数,从而彻底改变了程序的行为特性。
因此,必须确立一条铁律:PMC用于归因解释,而非性能测量。 任何基于插桩模式(尤其是PMC)得出的“真实性能”结论都是无效的。最终的优化收益,必须在退出Profiler、恢复原始代码并重新进行同步计时后,通过A/B测试验证。同样,--memory-usage报告的KB级残留内存也不应直接等同于代码泄漏,需结合释放记录与独立进程复测来综合判断,排除Runtime和Profiler自身的资源占用。
真实案例:气象Transformer的非GEMM瓶颈
为了验证上述方法论的有效性,我们将目光投向一个更具挑战性的场景:一个包含69个通道、保留完整空间分辨率的气象预测Transformer模型。初步直觉告诉我们,Transformer的核心瓶颈应在于大规模的矩阵乘法(GEMM)。然而,通过对该模型进行Stats和Stack分析,数据揭示了截然不同的图景。
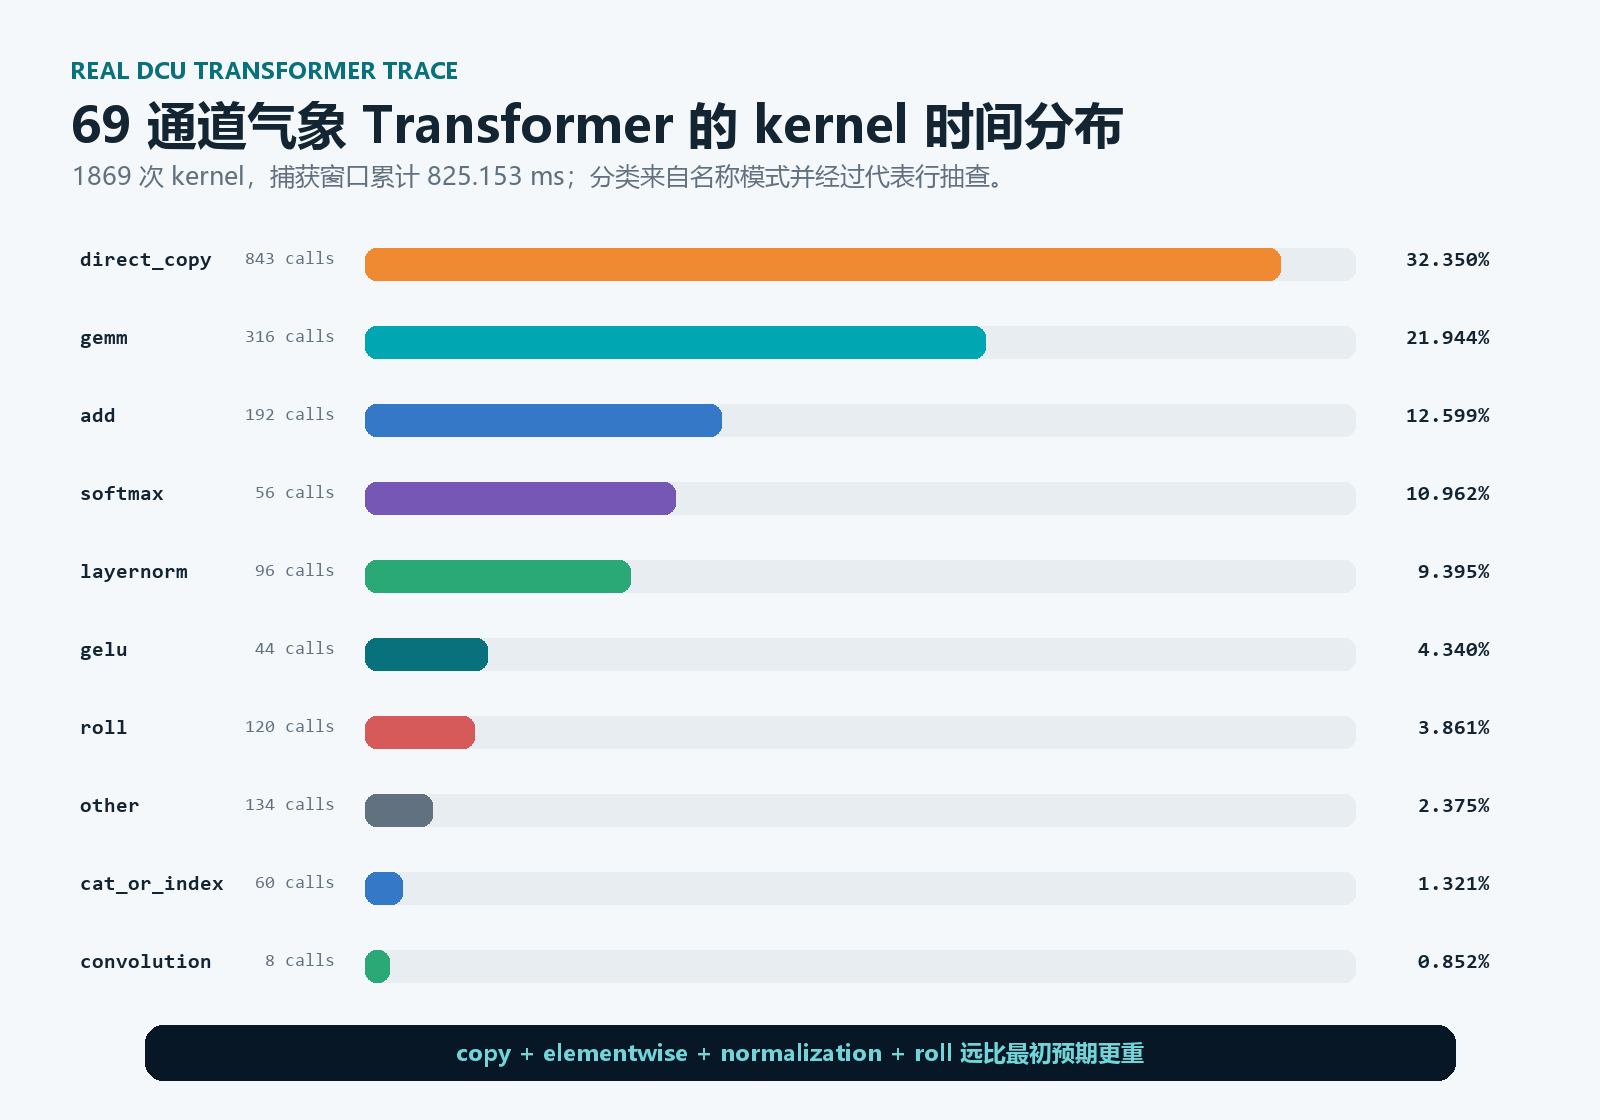
设备Kernel执行总时间约为825毫秒,其中GEMM类算子仅占21.94%。占比最高的是direct_copy(直接拷贝),占比高达32.35%,其次是Add、Softmax、LayerNorm等元素级或轻量级算子。非GEMM路径合计占比超过73%。这一发现彻底扭转了优化方向。如果仅优化GEMM,受限于Amdahl定律,整模加速上限将被剩余的28%时间锁死。
深入分析表明,QKV投影后的布局转换、Bias与激活函数的中间张量物化、以及LayerNorm前后的非连续数据重排,是造成大量数据拷贝和碎片化Launch的主因。此外,roll、cat和index等操作也贡献了显著的开销。这证明在国产算力平台上,内存带宽和数据布局的效率往往比纯粹的算力峰值更能制约整体性能。
从热点归因到数值止损的优化闭环
基于上述分析,优化策略转向减少不必要的张量拷贝与布局转换,并通过算子融合将多个小Kernel合并。我们实施了两项关键优化:
- QKV后处理融合:原路径中,QKV投影后经过复杂的Permute操作,导致数据非连续并触发额外的布局物化。融合Kernel直接读取交错排列的QKV,一次性写出紧凑布局并融合Q Scaling,消除了中间张量的创建与拷贝。
- Bias + Exact GELU融合:将原本的无偏置GEMM、BF16 Bias相加及Exact GELU激活操作合并为一个HIP Kernel,避免了完整中间张量的显存读写。
优化后的A/B测试结果显示,样本平均运行时间从0.189秒降至0.177秒,降幅约6.1%,同时采样显存占用减少了约18.5MB。更为关键的是,通过完整输出代理指标验证,数值误差仅在可接受范围内,证明了优化的安全性。值得注意的是,虽然单个Micro-benchmark显示显著加速,但整模提升有限,这是因为其他未优化部分构成了新的瓶颈。此外,另一项看似相似的fc2 Residual融合尝试,虽节省了少量时间,却导致数值指标异常下降,因此被果断舍弃。这再次强调:Profiler提供的是“哪里值得看”的线索,而数值正确性和业务指标才是最终的决定者。
标准化DCU性能优化工作流总结
综上所述,在海光DCU及类似架构上进行性能优化,应遵循一套标准化、可复用的流程:
首先,在无插桩环境下建立严格的性能基线,明确输入Shape、DType及同步位置。其次,使用--hip-trace --stats快速识别API与Kernel热点,排除冷启动干扰。接着,通过--kernel-stack或Range Trace定位热点的上层调用路径,缩小调试范围。随后,针对特定热点Kernel运行真实Shape的微基准测试,并仅在必要时使用PMC解释底层资源受限原因(如寄存器溢出、LDS冲突等)。最后,回归完整模型进行严格的A-B-B-A测试,同时验证运行时间、显存占用及数值正确性,并在冷启动环境下进行发布前验收,确保代码路径与缓存机制的一致性。
通过这种分层、隔离、验证严谨的分析方法,开发者能够跳出“唯算力论”的陷阱,精准定位影响性能的真正瓶颈,从而在国产算力平台上实现高效、可靠的模型性能调优。工具只是提供证据的手段,真正的优化智慧在于对数据口径的清醒认知和对系统行为的全局把握。