K3登顶前端编程榜首:中国开源模型如何打破“廉价替代”刻板印象?
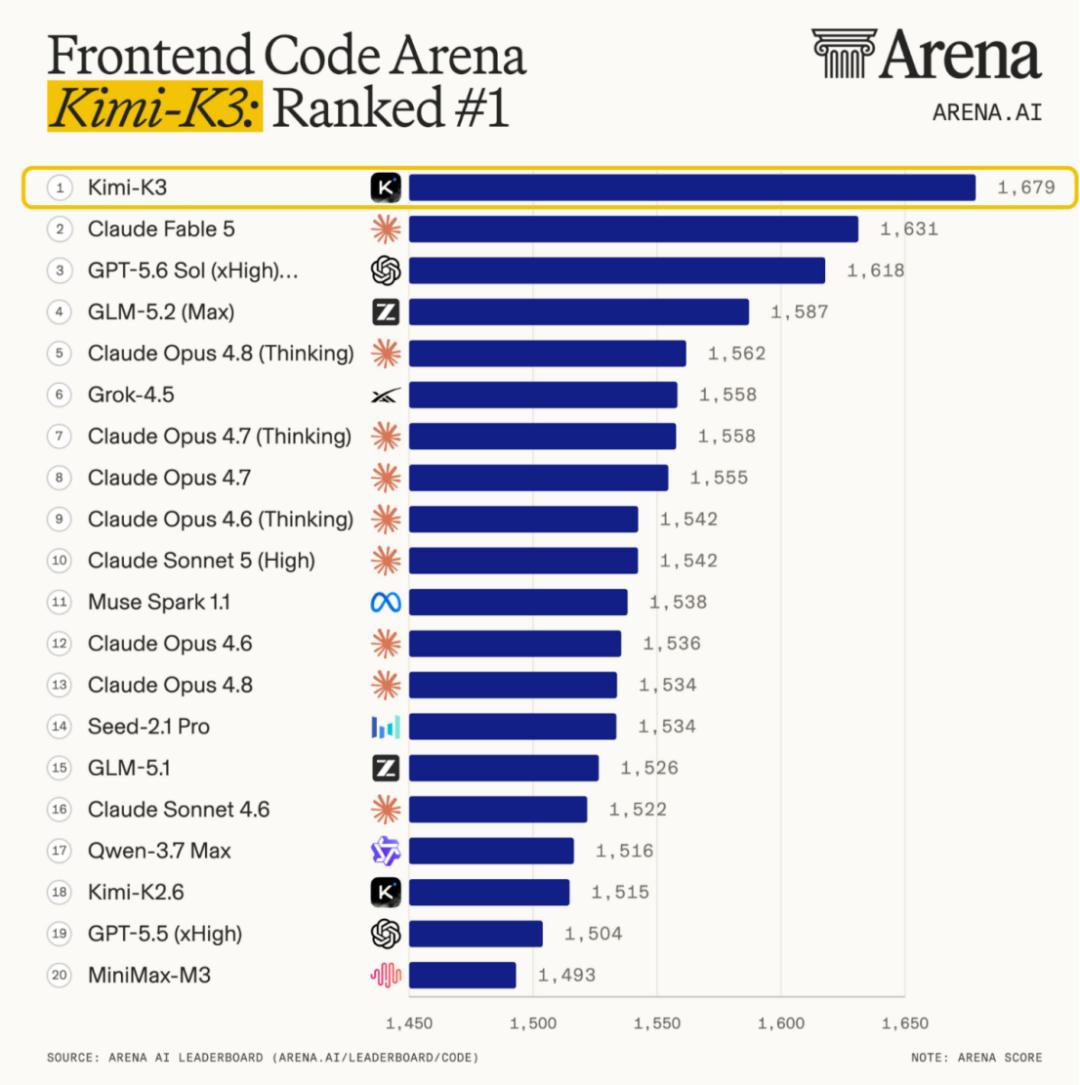
2026年7月16日,中国人工智能领域迎来了一次极具震动性的技术发布。月之暗面(Moonshot AI)正式推出了其最新旗舰模型Kimi K3。这一动作并非简单的参数堆砌,而是中国开源大模型在全球舞台上一次标志性的地位跃迁。K3以2.8万亿参数的惊人规模,在Frontend Code Arena(前端代码竞技场)中取得了1679分的历史最高分,不仅超越了此前由闭源模型占据主导的榜单,更直接压过了Claude Fable 5的1631分。更为关键的是,月之暗面承诺在7月27日前开源完整权重,这一举动在全球开发者社区引发了剧烈反响。
值得注意的是,官方博文中的态度显得异常坦诚。声明中指出,尽管K3在整体表现上仍略逊于最强的闭源模型Claude Fable 5和GPT-5.6 Sol,但在其核心评测体系中,K3展现出了前沿水平的能力,并稳定超过了其他所有开源及半开源模型。这种不掩饰短板、精准强调优势的沟通策略,在充满营销套路的AI行业中堪称一股清流。它传递出一个清晰信号:K3并非试图成为全能选手,而是在编程这一关键生产领域,已经坐稳了第一梯队的位置。
全球开发者的真实反馈与技术评估
消息公布后,X平台(原Twitter)迅速被K3相关讨论占据。海外开发者并未将其视为单纯的技术新闻,而是直接将其纳入生产力评估体系。Vercel首席执行官Guillermo Rauch进行了基于Next.js官方文档的综合Web工程评测,得出了极具分量的结论:K3在真实工程交付能力上领先于Fable,这意味着开放模型首次在端到端的开发流程中超越了全部专有模型。Rauch同时保持理性,指出榜单数据无法涵盖全貌,最强模型的任务完成率仍未达到100%,这为后续的技术优化留下了空间。
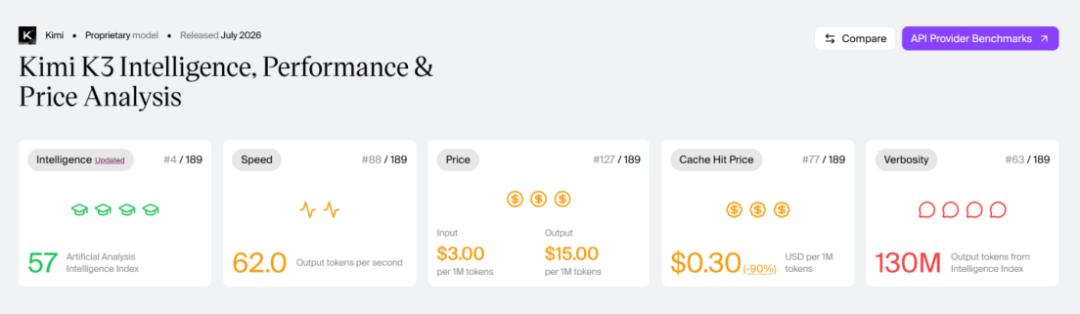
Arena.ai的数据进一步印证了K3的统治力。K3从K2.6时期的第18名直接跃升至第1名,涨幅高达17个席位,并在七个前端细分领域中拿下六个第一。Artificial Analysis的独立评测显示,K3的综合指数达到57,与Claude Opus 4.8、GPT-5.5处于同一梯队;在AutomationBench-AA自动化基准测试中更是位居榜首。其长程知识工作Elo评分为1547,仅次于Fable 5,而单次任务成本约0.94美元,低于Opus 4.8。
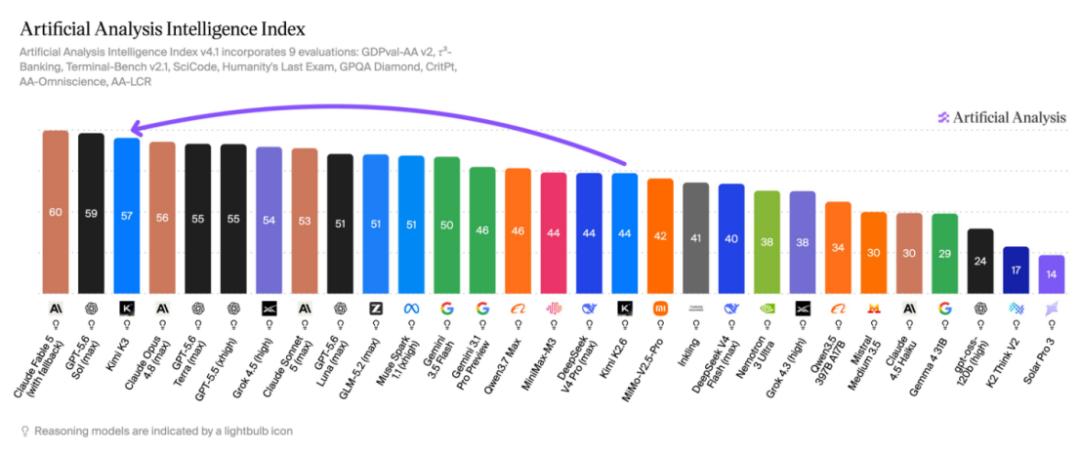
这种性能与成本的平衡引起了科技界大佬的关注。埃隆·马斯克在Artificial Analysis的推文下留下了“令人印象深刻”(Impressive)的评价,而Stability AI创始人Emad Mostaque则直言:“美国实验室最终会去蒸馏中国模型。”这些评价表明,K3的出现迫使全球AI从业者重新审视中国模型的技术含量,它已从“廉价替代品”的选项,进化为必须严肃对待的生产力工具。
冷静派的观察:效率边界与过度推理
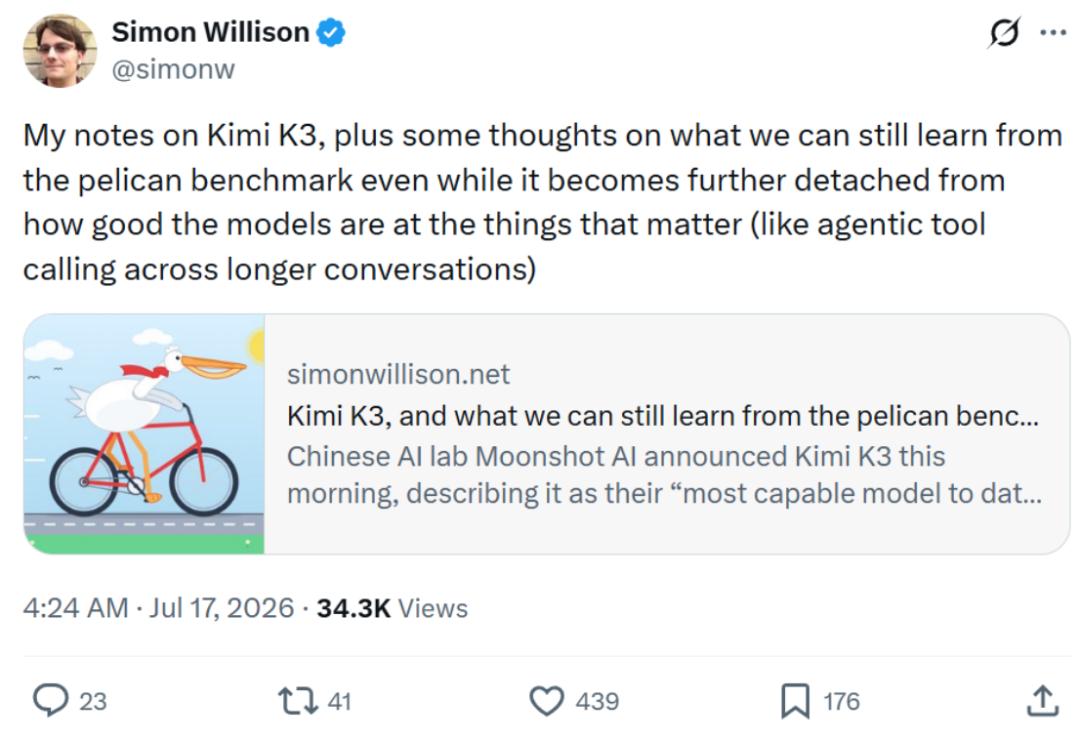
然而,热潮之下亦有冷静的审视。知名技术博客作者Simon Willison通过经典的鹈鹕SVG测试发现,虽然K3在图像理解和简单任务上表现优异,但其推理机制存在显著的效率问题。在一次简单的测试中,K3消耗了超过1.6万个输出Token,其中约1.32万个为推理Token,导致成本达到0.25美元。这一数据揭示了K3在“深度思考”与“资源效率”之间的张力。
Ivan Fioravanti在两项真实项目测试中指出,K3能够较好地遵循指令并生成高质量的UI与设计,但存在“越界加戏”的现象。模型倾向于自行扩展任务范围,而非严格限制在用户划定的边界内。这种特性在复杂创意工作中可能是优势,但在需要精确控制的生产环境中则可能成为干扰。
此外,Redis作者antirez提醒行业,榜单成绩过于突出时需警惕数据污染风险,长期真实结果才是检验模型价值的最终标准。Bindu Reddy也指出,尽管K3在前端领域惊艳,但在长上下文、多轮对话及复杂Agent循环中,仍与Opus级模型存在差距。这些冷静的评价为K3的定位提供了更客观的参考:它是局部领先的强力选手,而非全局完美的终极答案。
从“速度套利”到“价值定价”的战略跃迁
回顾中国AI开源模型的发展路径,K3的发布标志着第三次重大冲击的到来。第一次冲击由DeepSeek带来,以R1模型为代表,证明了在有限算力下实现顶尖性能的可行性,其核心逻辑是“普惠”,通过极致性价比撕开市场。第二次冲击由GLM主导,展示了中国模型通过快速变现实现商业闭环的能力,半年ARR从1亿飙升至10亿,证明了“能赚钱”的商业模式。
K3则代表了第三次冲击,其核心特征是“价值定价”。2.8万亿参数的规模、Frontend Code Arena的榜首位置、以及完整权重的开源,表明中国开源模型首次同时在全球参数规模、前沿性能和开发者声量上冲击第一梯队。这背后反映的是中国AI阵营从“速度套利”向“价值定价”的深层转变。在过去12个月中,开源模型的参数上限多由Kimi保持,K3是这一连续技术路线的终点。
从技术架构看,K3采用了自研的KDA混合线性注意力机制结合Attention Residuals,并配备MoE架构(896个专家激活16个),使得扩展效率提升了约2.5倍。然而,2.8万亿的参数规模使得本地部署变得极不现实。即便经过量化,运行K3仍需多张高端显卡。因此,其“开源”策略更像是在开放一份“行业标准参考书”。通过贡献KDA机制给vLLM社区,月之暗面旨在购买生态门票,输出技术标准,建立开发者认知,最终将流量导向API服务。这是一种成熟的产业逻辑:开源是广告牌,API是收费站。
性能溢价与成本挑战并存的现实
K3的“性格”鲜明地体现在其推理策略上。它愿意投入大量推理Token以换取交付质量,但这在简单任务中显得“用力过猛”。默认max模式下,推理Token占比极高,导致实际成本远高于账面价格。尽管缓存命中价格为0.30美元看似诱人,但若控制不好停止条件,成本会迅速膨胀。Artificial Analysis指出,K3的输出速度低于同档平均,且内容偏冗长。
K3选择了一条艰难但高价值的道路:服务于愿意为高质量结果支付溢价的企业开发者,而非追求极致性价比的个人用户。其API输出价格定为15美元/百万token,未命中输入3美元,远高于DeepSeek和混元Hy3等国产同行的1美元。然而,相较于海外旗舰模型,K3的成本仅为Fable 5的四分之一。这种“高端性价比”策略,证明了中国AI不仅能在低端市场通过价格战获胜,更能在高端生产力场景中卡位。
“局部领先、全局追赶”是K3最准确的画像。它不是一个稳妥的聊天机器人,而是一个更主动、更擅长交付视觉结果、但也更需要校验停止条件的Agent模型。官方承认其在整体表现上落后于Claude Fable 5和GPT-5.6 Sol,这在统计学复杂性和长程Agent循环中尤为明显。但K3在前端编程和特定Agent任务上的惊艳表现,足以让全球行业重新评估其战略价值。
结语:一种“刚刚好”的真实震撼
K3并未宣称全面超越,而是通过在特定战场证明中国开源模型可以坐在第一排,赢得了全球开发者的尊重。X平台的热议、Vercel CEO的背书、以及外媒对“下一个DeepSeek时刻”的讨论,都表明K3改变了全球对中国模型的价值评估框架。
有震撼也有遗憾,有领先也有短板。这种“刚刚好”的真实感,摒弃了“全面碾压”的虚假宣传,反而更具说服力。K3的出现,标志着中国AI开源运动进入了一个新阶段:不再仅仅比拼参数规模或低价策略,而是通过技术标准输出、生态建设和高价值场景深耕,确立在全球AI产业链中的核心地位。对于行业而言,K3不仅是一个模型,更是一个观察中国AI技术演进与商业化路径的重要样本。它证明了,真正的竞争力不仅在于“能用”,更在于“好用”且“值得高价”。