企业Agent落地困局:为何Demo完美却难上线?评估才是破局关键
在生成式人工智能(GenAI)的热潮中,一个被广泛引用的预测描绘了令人振奋的未来:亚马逊云科技CEO Matt Garman曾预测,未来将有数十亿个智能体(Agent)在各个行业中运行。然而,现实往往比预言更骨感。MIT Project NANDA的一项针对300多个AI项目的报告显示,尽管企业投入了数百亿美元,但仅有5%的组织成功实现了规模化部署并获得显著财务回报。这种现象被定义为“GenAI鸿沟”——绝大多数组织被困在“高采用率、低转化率”的试点阶段,难以跨越从技术演示到生产环境的最后一公里。
这种困境在Agent领域尤为显著。许多企业在Demo阶段看到的Agent表现优异,一旦接入真实业务场景,便出现性能骤降或行为失效。这并非因为底层模型能力不足,而是因为Agent的工程复杂性远超传统软件。传统软件工程方法在面对Agent时面临三大本质挑战:非确定性、提示词即源代码、以及隐式依赖。这些特性导致传统的测试评估体系全面失效,成为阻碍企业级Agent落地的核心瓶颈。
非确定性与隐式依赖:工程化的新盲区
传统软件的运行逻辑是确定性的,输入A必然产生输出B,有一套明确的对错标准。然而,基于大模型构建的Agent具有概率性特征。同样的输入在不同时间、不同版本下可能产生截然不同的输出。目前,没有任何主流模型提供商承诺提供完全确定性的输出,这意味着Agent的稳定性是一个动态变化的过程,而非静态的常量。
此外,“Prompt即源代码”的特性带来了版本控制与静态分析的难题。在传统开发中,代码变更留痕且可追踪,但在Agent开发中,提示词哪怕只有细微调整,也可能引发Agent行为的剧烈波动。行业目前缺乏成熟的工具来评估这种自然语言改动的影响范围,导致调试过程如同“黑盒”,难以定位问题根源。
更棘手的是隐式依赖问题。Agent严重依赖底层大模型,而模型提供商常在后台进行无声升级。即使企业端的代码未做一行修改,Agent的服务质量、响应速度甚至逻辑准确性也可能因底层模型的迭代而发生不可预知的变化。这种隐式依赖使得传统软件的生命周期管理方法在Agent开发中显得力不从心。
从SDLC到ADLC:评估成为核心引擎
面对上述挑战,亚马逊云科技发布的《企业生产级智能体开发部署指南》提出,企业必须转变思维,从传统的SDLC(软件开发生命周期)转向ADLC(Agent开发生命周期)。SDLC是一条线性流水线,而ADLC则是一个不断旋转的飞轮。
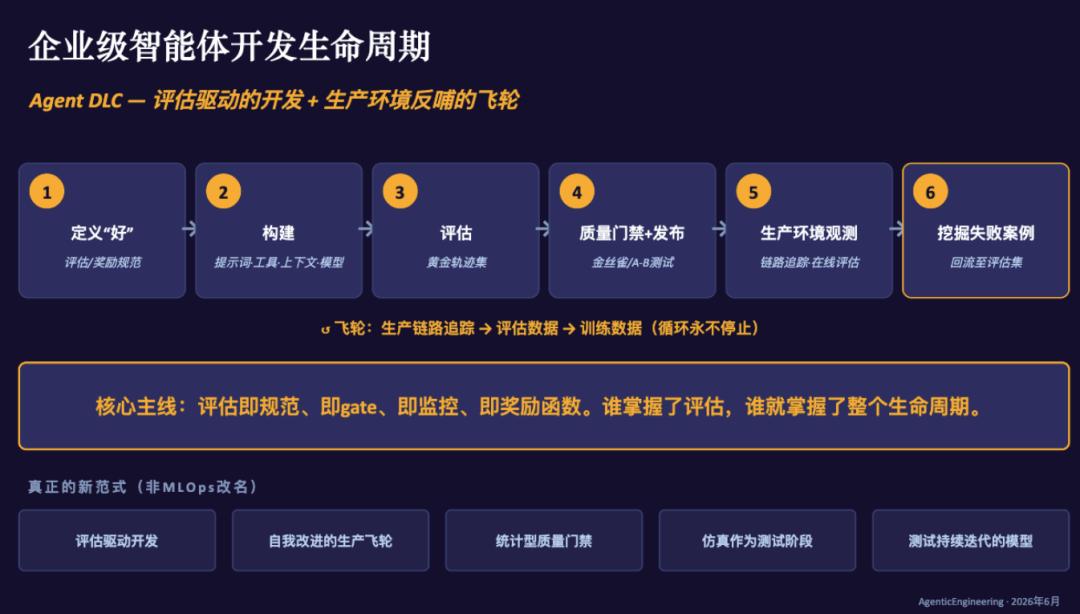
亚马逊全球副总裁储瑞松指出,底层技术平台可以通过采购获得,但评估标准必须由企业自主掌控。企业的核心竞争壁垒不在于模型本身,而在于其自有的黄金数据集和评估标准。ADLC包含六个环节:定标准、开发实现、效果评估、灰度上线、持续监控、改进循环。这六个环节并非单向流动,而是形成闭环。评估不仅是开发的起点,更是持续优化的终点。
在启动Agent项目前,企业首先需要定义“什么是好的Agent”。这包括明确智能体的定义与职责、语气与个性、工具与参数边界,以及建立基准数据集。基准数据集不仅是测试的依据,更是衡量Agent是否“做好了”的金标准。上线后,生产环境的数据必须通过完善的可观测性系统(如OpenTelemetry)持续回流到评估体系中。没有可观测性,就没有持续评估,ADLC的飞轮也就无法转动。
评估方法论:两根支柱构建全方位监控
如何判断一个Agent是否合格?这是最难回答的问题。Agent的能力(Capability)与一致性(Reliability/Consistency)是两个截然不同的维度。Agent能将多步推理、工具调用和外部状态写入耦合在一起,任何一环的随机性都会被链式放大,导致“间歇性失效”。因此,必须依靠成规模、反复的评估来逼近“每次都能做到”的目标。
评估方法论的核心由两根支柱构成:支柱一决定评估的粒度,支柱二决定每个分数的证据权重。
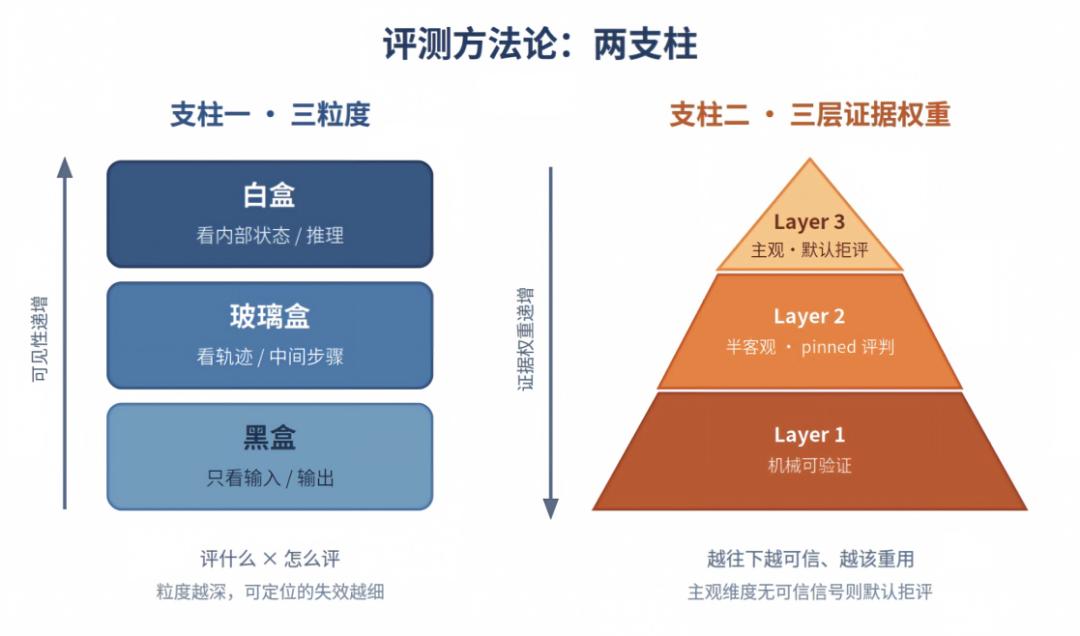
在粒度层面,评估分为黑盒、玻璃盒和白盒三种视角。黑盒评估仅关注最终输出,回答“结果对不对”;玻璃盒评估查看完整执行轨迹,包括决策过程、工具调用和推理步骤,回答“过程对不对”;白盒评估聚焦单步细节,验证每一个工具调用或推理片段是否成立,回答“每一步对不对”。日常开发中以玻璃盒评估为主,辅以黑盒和白盒,形成全方位监控。
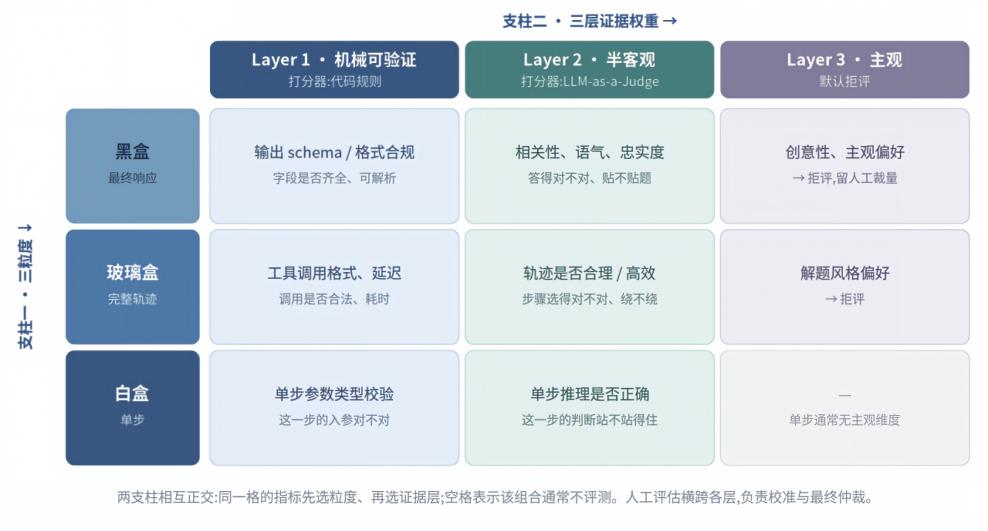
在证据权重层面,评估分为三层。第一层是机械验证,如格式检查、JSON解析等,完全自动化且零主观判断;第二层是半客观评判,使用固定的评估器和明确的评分标准,对特定维度打分;第三层是主观评判,依赖人工或LLM的判断力,没有固定标准。这三层证据权重分别对应代码规则、模型和人工打分器,通过正交组合,形成3x3的评估矩阵,确保评估结果的全面性与准确性。
构建企业级Agent的基础设施
除了方法论,企业还需要建立坚实的基础设施来支撑评估体系。指南推荐采用三层架构设计:认证层确认用户身份,授权层(Gateway)控制Agent的能力边界,会话隔离层确保不同用户之间的数据互不干扰。这种架构不仅保障了安全性,也为评估提供了清晰的边界和上下文。
高质量的数据集是评估的基石。由于评估过程中常使用模型自动评估,评估数据集的质量直接决定了评估结果的上限。企业需要建设经过人工标注、业务验证的高质量测试集。例如,AWS在开发客服Agent时,采用“真实数据+虚拟客户模拟”的双轨评估方法,低成本地扩展了测试范围,覆盖了边缘场景,既验证了意图识别的准确度,也测试了多轮对话的连贯性。
不同形态的Agent关注点各异。客服Agent侧重意图识别准确率和对话连贯性;工具使用Agent侧重工具选择正确率和参数准确性;多Agent协作系统则侧重任务拆分合理性和执行稳定性。企业应根据具体场景定制评估维度,避免“一刀切”。
结语:评估是交付业务价值的唯一路径
Agent作为生产力工具,其最终价值在于能否交付可衡量的业务结果。无论技术如何迭代,能否通过科学的评估体系证明Agent的有效性,是企业跨越“GenAI鸿沟”的关键。AWS提供的指南与方法论仅为参考,企业需根据自身业务特点,建立自主的评估标准与数据资产。
进入Agent时代,这是一场技术与商业的双重挑战。仅有良好的技术架构是不够的,企业必须具备坚定的决心与持续的投入,将评估融入Agent生命的每一个阶段。只有当评估成为核心引擎,Agent才能真正从Demo走向生产,从技术演示转化为真实的业务价值。未来,那些能够构建起严密评估体系的企业,将在智能化浪潮中占据制高点,实现从“做得出来”到“用得好”的质的飞跃。