端侧AI算力革命:后摩M50芯片如何撬动本地大模型商用落地?
端侧智能的算力悖论与破局
在2026年世界人工智能大会(WAIC)的张江科学会堂,一个看似寻常的桌面场景正在经历深刻的重构。过去,大模型的高性能运行几乎完全依赖于云端庞大的数据中心集群,用户通过API接口获取服务,这种模式虽然强大,却面临着网络延迟、数据隐私泄露以及高带宽成本的多重制约。随着AI PC、智能服务机器人和边缘智能终端的加速落地,行业普遍认为2026年是端侧AI爆发的元年。然而,物理定律给终端设备设下了严苛的边界:在有限的体积、电池容量和散热空间内,如何承载动辄千亿参数的大模型?
这构成了当前行业最大的痛点,也是“算力悖论”的核心。终端设备对低功耗、低延时和本地化部署有着刚性需求,而传统计算架构在应对大模型推理时,往往需要在内存与处理器之间频繁搬运数据,这种“存算分离”的模式导致了极高的能耗和延迟。针对这一行业瓶颈,后摩智能携M50 Inside技术创新方案亮相,其核心逻辑在于通过底层架构的创新,彻底打破终端算力的桎梏,让大模型从云端真正走向本地,实现触手可及的端侧智能。
存算一体架构:重塑能效比的技术基石
后摩智能M50芯片的核心竞争力,源于其采用的存算一体(Processing-in-Memory, PIM)架构。与传统CPU或GPU依赖冯·诺依曼架构不同,存算一体技术将计算单元直接集成在存储单元附近,极大地减少了数据搬运过程中的能量消耗。这一技术路线的选择,直接解决了端侧AI最致命的功耗问题。
数据显示,M50芯片在仅10W的超低功耗下,即可实现160 TOPS的单芯片算力。这一能效比在业界处于领先地位,使其能够在手持设备或小型终端中,流畅运行30B至120B参数量级的大模型。对于终端用户而言,这意味着无需依赖外部电源或大型散热系统,设备即可实现7x24小时在线的本地AI助理功能。无论是复杂的逻辑推演、智能检索,还是多轮对话中的上下文记忆,M50都能在高负载并发场景下保持低延迟和稳定性。
这种高算力与低功耗的完美平衡,并非仅仅停留在理论层面,而是已经转化为实际的商用产品力。通过突破物理空间的限制,M50让端侧设备具备了自主执行复杂AI任务的能力,为大模型在终端的规模化落地提供了坚实的硬件基础。
软件生态:降低适配门槛的关键一环
硬件算力的突破只是第一步,软件栈的兼容性决定了技术落地的速度。后摩智能同步推出了自主研发的“大道”软件栈,旨在解决大模型部署复杂、适配周期长的问题。在传统的端侧AI开发流程中,开发者需要手动进行算子优化、量化校准,这极大地提高了技术门槛,限制了中小开发者的参与度。
大道软件栈内置了针对主流深度学习框架的优化算子,支持一键部署,无需用户手动调参。这种全栈式的软件优化,大幅压缩了产品从开发到上市的周期。更重要的是,它实现了硬件算力与软件算法的高效协同,确保不同参数量级的模型都能在M50芯片上获得最优性能表现。这种“软硬结合”的策略,不仅提升了单点设备的性能,更为整个生态系统的繁荣奠定了基础,使得更多的行业应用能够快速接入端侧AI能力。
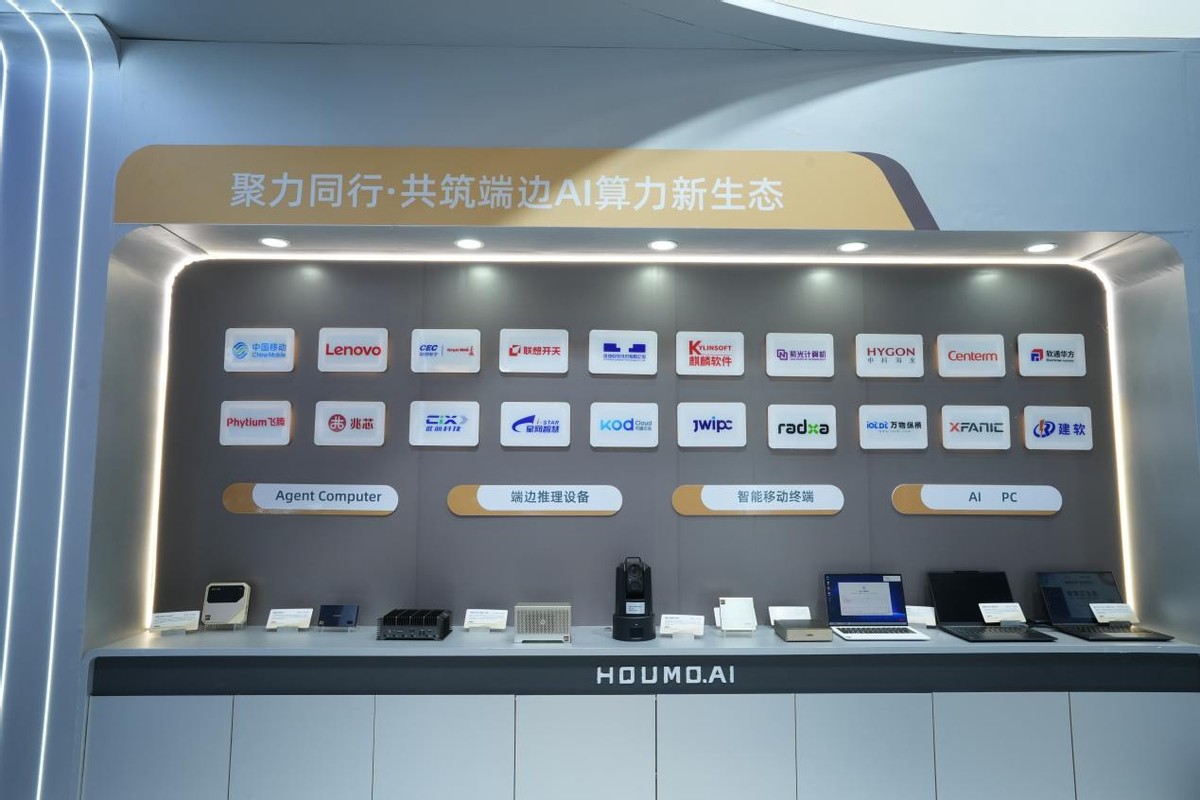
多元终端形态:从办公到具身智能的广泛渗透
在WAIC展会上,后摩智能展示了M50芯片在多种终端形态中的应用成果,涵盖了智能办公、教育、个人陪伴及边缘计算等多个热门领域,验证了其技术的通用性和 scalability(可扩展性)。
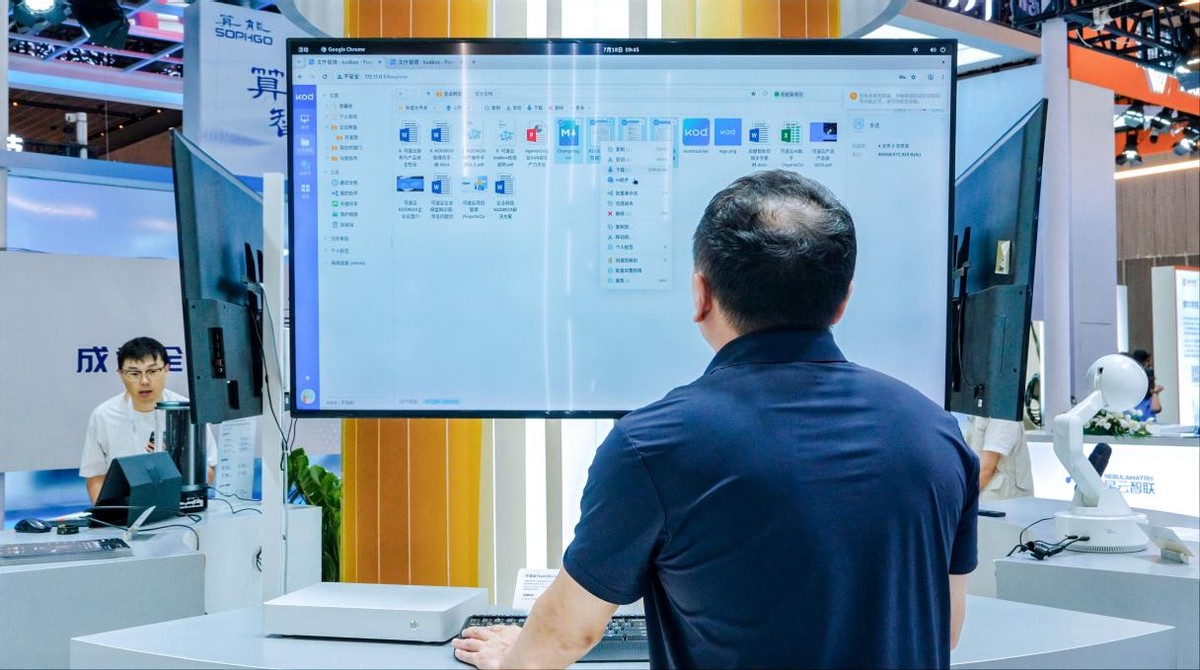
Agent Computer与全息交互
Agent Computer(智能体计算机)是此次展会的焦点之一。后摩智能联合聊趣智能推出的ClawHouse X1 Pro,是一款全息交互个人智算中心。搭载M50芯片后,该设备能够同时处理实时画面渲染、百亿级大模型本地推理和低延迟语音交互。这种多任务并行处理能力,使得设备在智慧办公和个人智算场景中,能够节省约80%的繁冗操作,为用户提供无缝的沉浸式体验。
联想AI主机P7则展示了另一条技术路径。这款手掌大小的设备综合算力达到190 TOPS,可在无网络环境下以50 Tokens/s的速度流畅运行1220亿参数的大模型。无论是多轮对话、专业知识问答,还是批量文档处理,P7都能提供即时响应。这种全本地部署方案,不仅保障了数据的绝对安全,更让用户体验到了“丝滑无感”的AI交互,重新定义了个人电脑的计算边界。
AI PC与数据隐私安全
随着全球AI PC出货量突破亿台大关,数据安全和离线办公能力成为区别于云端方案的核心优势。长城N90 Pro展示了35B本地大模型在M50芯片支持下的离线运行能力。在政务、金融、能源等对数据敏感度极高的行业,长城N90 Pro依托全栈国产自主软硬件,实现了智能文档写作、离线问答、会议记录等功能。这种本地化处理方式,彻底规避了数据上传云端的风险,为行业客户提供了更符合合规要求的AI办公解决方案。
具身智能与边缘推理
在具身智能领域,联想AI Workmate概念机以桌面机器人形态亮相。它不仅能通过语音和手势进行本地控制,还能在扫描文档后即时生成摘要或演示文稿,并通过投影形成共享看板。此外,可道云TeamSilo A10内置的LQ50 M.2卡,将企业云盘、知识库与本地大模型整合,支持企业级文件的知识检索和Agent应用搭建。这些案例表明,M50芯片的应用场景已从个人消费级产品,延伸至企业级边缘计算和具身智能机器人,展现出广阔的商业前景。
产业生态:从单点突破到规模商用
后摩智能的快速发展,离不开与头部企业的深度合作。目前,后摩智能已与联想、长城、中国移动等数十家终端巨头建立战略伙伴关系,推动M50芯片在AI PC、桌面机器人、AI NAS等多元终端中的规模化商用。这种生态共建模式,加速了技术从实验室到市场的转化进程,形成了硬件厂商、算法公司、芯片设计企业协同创新的良性循环。
行业分析指出,端侧AI的爆发不仅仅是算力的提升,更是交互范式和数据流动模式的重构。当AI算力像电力一样随处可及时,终端设备将从被动执行指令的工具,转变为具备自主感知、记忆和决策能力的智能伙伴。后摩智能通过M50 Inside技术,正在推动这一愿景成为现实。
技术演进背后的产业思考
回顾后摩智能的技术路径,可以看出其对底层创新的坚持。在存储墙(Memory Wall)问题日益突出的背景下,存算一体架构被视为打破摩尔定律限制的重要方向。M50芯片的成功,不仅证明了该技术在端侧场景的可行性,更为后续更高参数模型、更复杂算法的本地化运行提供了范式参考。
然而,端侧AI的普及仍面临挑战。除了算力与功耗的平衡,多模态融合、动态资源调度以及用户隐私保护的标准化,都是需要行业共同攻克的难题。后摩智能的“大道”软件栈和开放生态策略,正是为了降低这些非功能性需求的门槛,让开发者能够更专注于应用层的创新。
未来,随着模型技术的进一步轻量化和硬件架构的不断优化,端侧智能将不再局限于高性能计算设备,而是渗透到更广泛的IoT设备中。从智能家居到工业物联网,从可穿戴设备到自动驾驶汽车,端侧AI将成为连接物理世界与数字智能的关键纽带。后摩智能的M50系列芯片,作为这一变革中的关键组件,其后续的技术迭代和生态扩展,将持续影响整个AI终端产业的格局。
在这个过程中,中国智造的力量正通过底层技术的突破,逐渐在全球AI竞争中占据重要席位。后摩智能的实践表明,通过架构创新实现差异化竞争,是跨越技术封锁、实现自主可控的有效路径。这不仅关乎一家企业的商业成功,更关乎整个产业链在智能化浪潮中的话语权与核心竞争力。