Kimi K3开源震撼发布:2.8万亿参数超越Fable 5,重塑AI竞争格局
技术奇点的前奏:Kimi K3重新定义开源边界
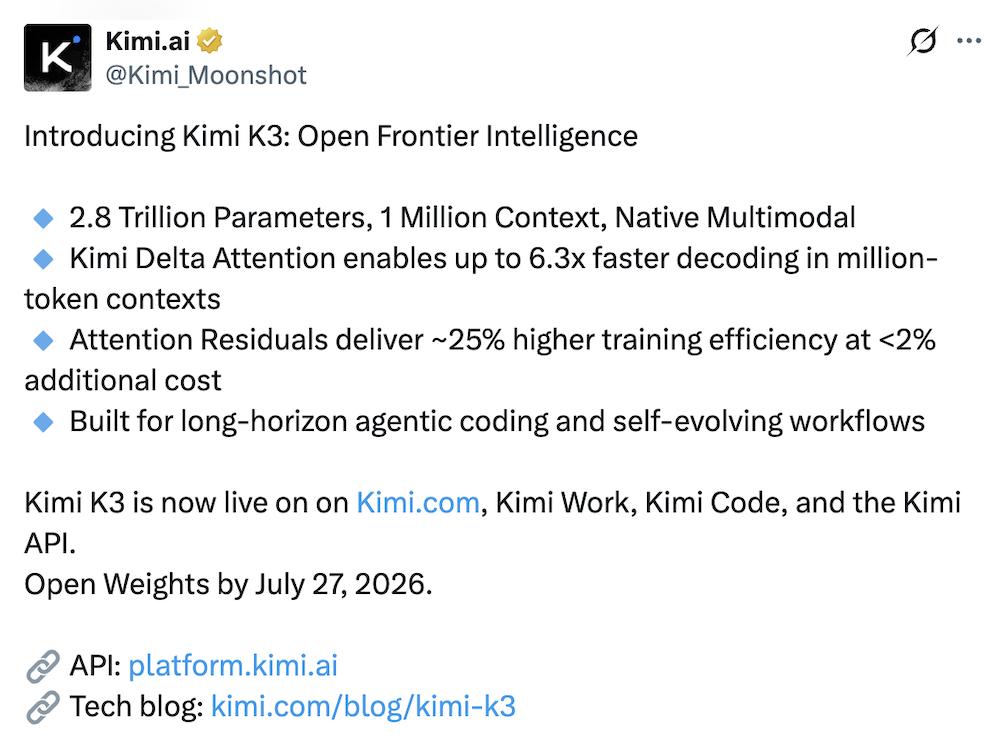
2026年7月,人工智能领域迎来了一场无声却剧烈的地震。月之暗面(Kimi)正式发布其迄今能力最强的Kimi K3模型,这一举动被业界广泛视为“中国的Fable 5时刻”。作为全球首个开源的3万亿参数级别大模型,Kimi K3不仅在参数量上达到了2.8万亿的惊人高度,更在原生视觉理解、100万Token超长上下文窗口支持以及综合性能上,实现了对外部顶级闭源模型的正面突破。
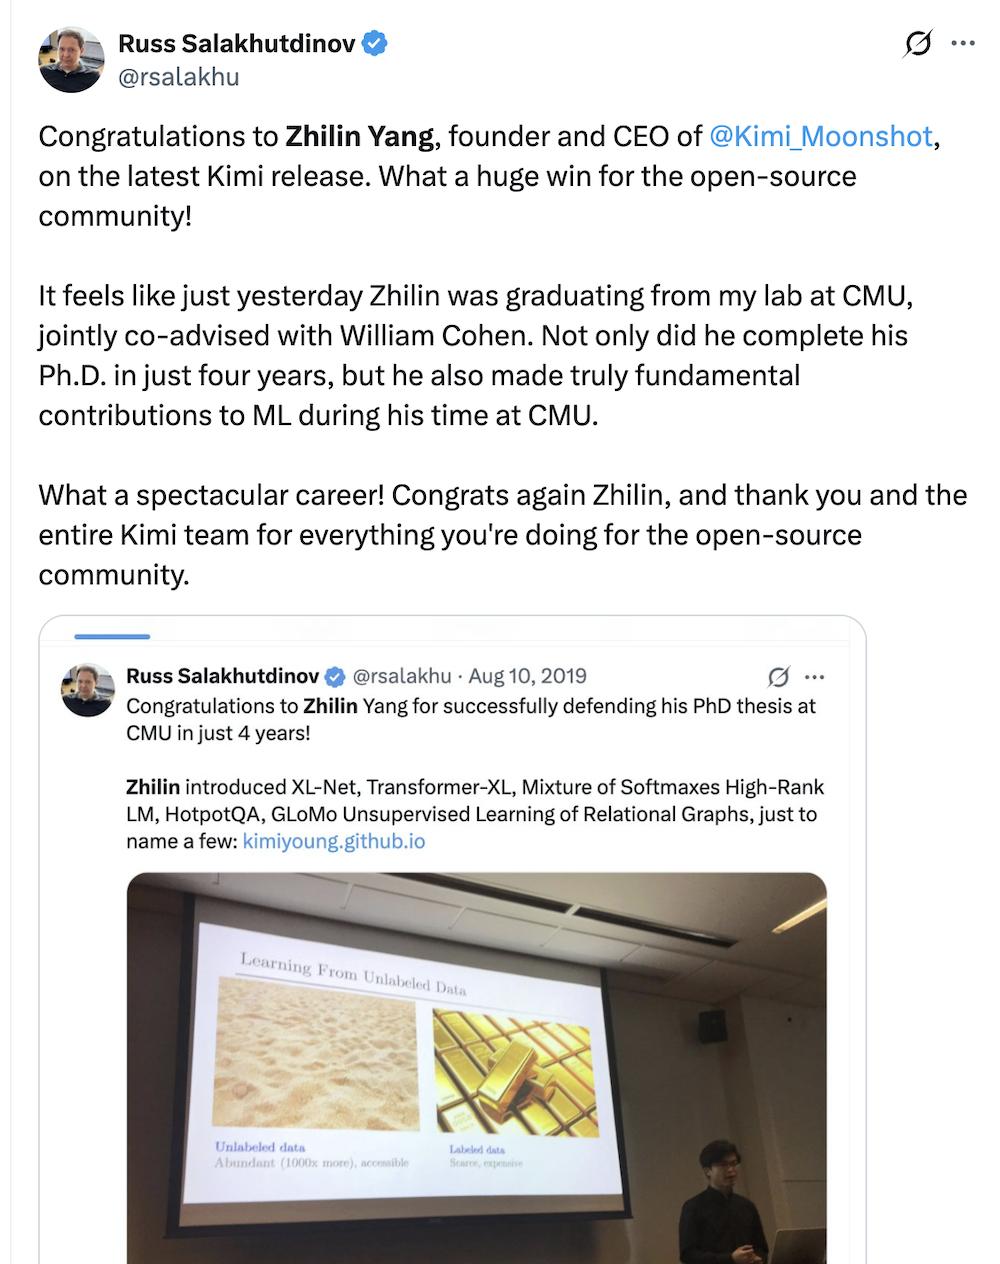
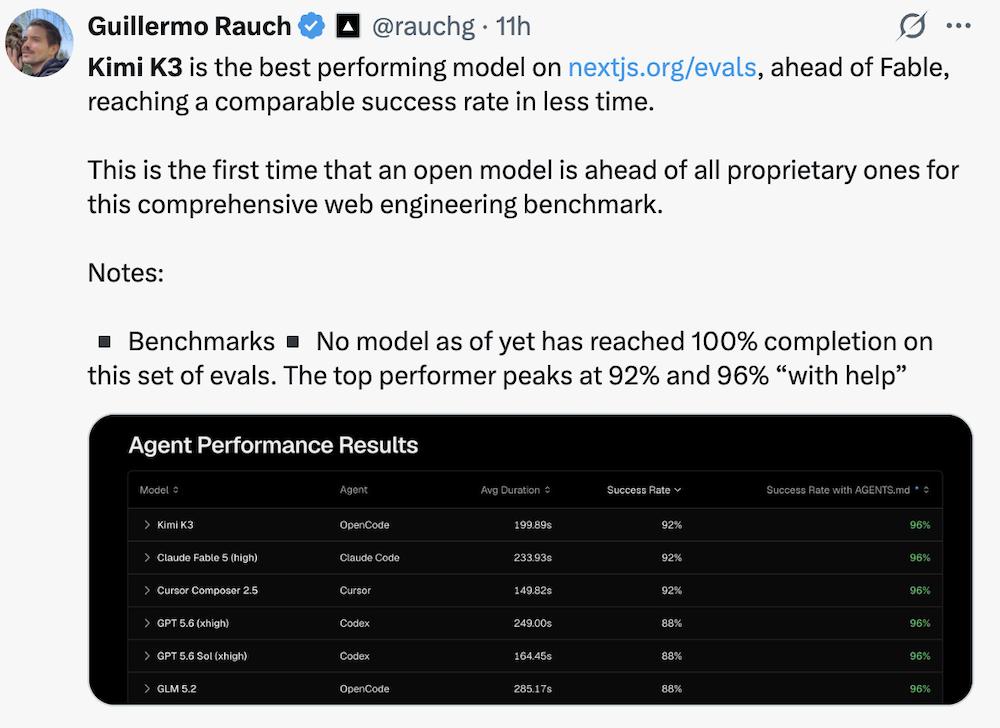
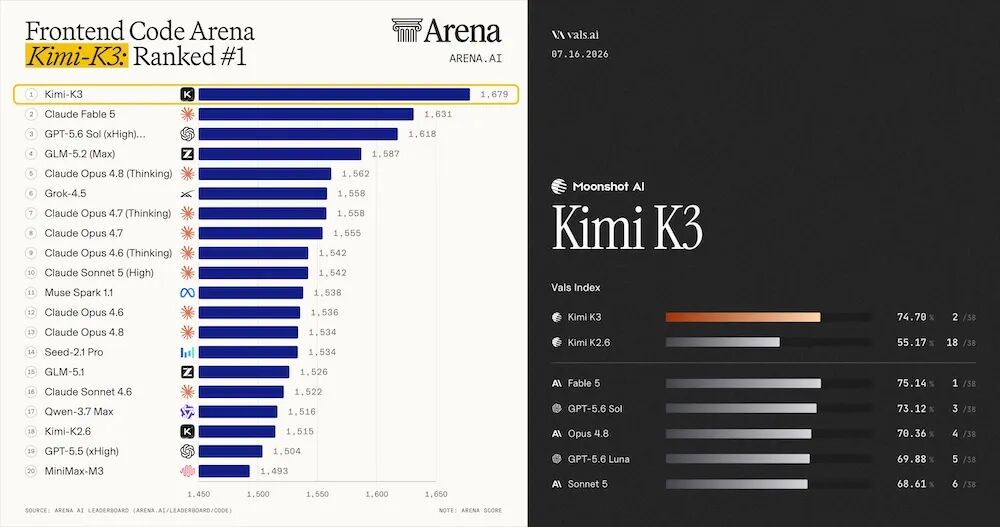
这一发布迅速引发了全球技术社区的热议。卡内基梅隆大学机器学习泰斗Russ Salakhutdinov,即Kimi创始人兼CEO杨植麟的博士生导师,公开称赞Kimi K3为开源社区带来了重大突破。与此同时,云平台Vercel创始人Guillermo Rauch在专业网页工程AI评测中,确认Kimi K3综合表现位列第一,首次有开源模型在该权威榜单上超越全部海外闭源模型。这种从“追赶”到“局部超越”的态势,标志着全球AI竞争格局正在发生结构性变化。
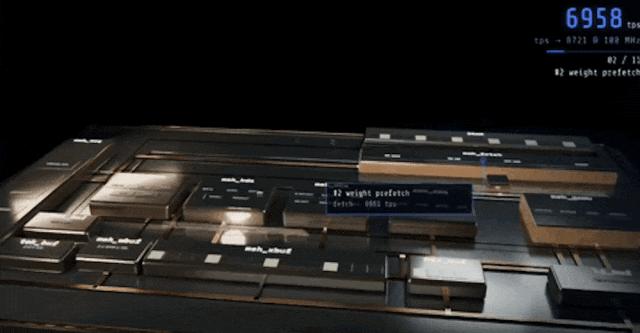
Kimi K3的出现并非偶然的参数堆砌,而是技术架构、训练策略与工程能力长期积累后的集中爆发。它不仅仅是一个语言模型,更像是一个能够处理复杂工作流、具备多模态理解与生成能力的智能体(Agent)。从代码开发到芯片设计,从产业研究到科学可视化,Kimi K3展示了大模型从单纯的内容生成向复杂任务执行和完整工作流交付演进的清晰路径。
架构创新:KDA与AttnRes的双轮驱动
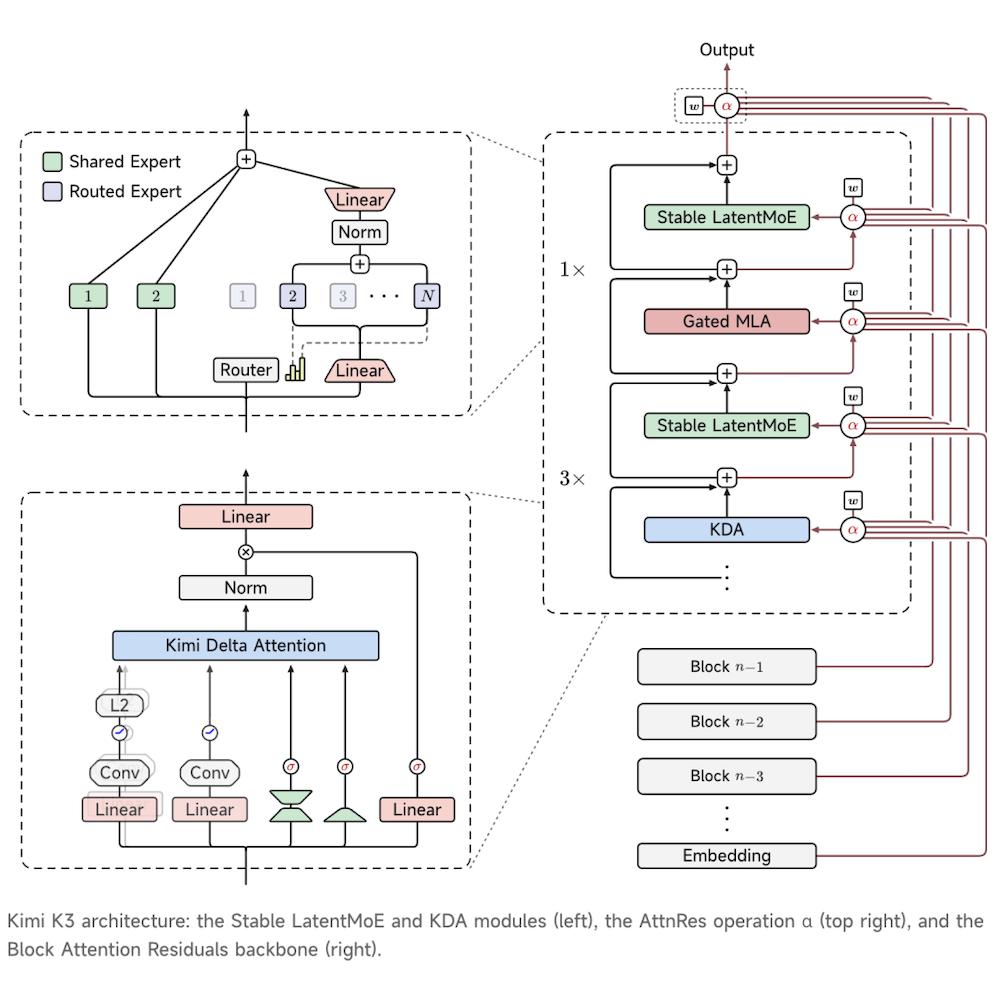
在参数规模突破万亿级大关的背后,是底层架构的重大革新。Kimi K3并非简单地增加网络深度或宽度,而是通过两项核心架构升级:Kimi Delta Attention(KDA)和Attention Residuals(AttnRes),解决了大模型在长序列信息处理和扩展效率上的痛点。
传统Transformer架构在处理超长上下文时,往往面临注意力机制的计算复杂度爆炸问题。KDA通过增量注意力机制,使得信息能够在更长序列和更深模型中流动得更加顺畅,极大地降低了长程依赖处理的计算开销。而AttnRes则引入了注意力残差连接,进一步稳定了深层网络的训练过程,提升了模型的收敛速度和最终性能。
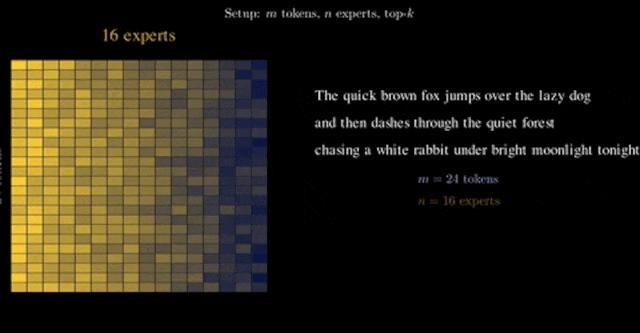
此外,Kimi K3采用了更高稀疏性的MoE(Mixture of Experts,混合专家)设计。结合Stable LatentMoE框架,该模型能够在896个专家中高效激活仅16个。这种极致的稀疏性设计,使得模型在保持庞大参数量带来的知识储备的同时,显著降低了推理时的计算资源消耗。数据显示,相比前代Kimi K2,Kimi K3的整体扩展效率提升了约2.5倍。这意味着在相同的算力投入下,Kimi K3能够释放出远超以往的能力上限,将算力更有效地转化为智能水平。
在训练与部署层面,Kimi团队从监督微调(SFT)阶段开始采用量化感知训练,使用MXFP4权重和MXFP8激活值,并通过平衡专家并行训练提升吞吐量。针对长上下文推理,团队还向vLLM社区贡献了KDA相关实现代码,使得Kimi K3在2.8万亿参数和百万Token上下文条件下,仍能保持相对可控的推理成本。这种对工程细节的极致追求,是开源模型能够与闭源巨头抗衡的关键基础设施支撑。
实测透视:多模态创意与代码生成的降维打击
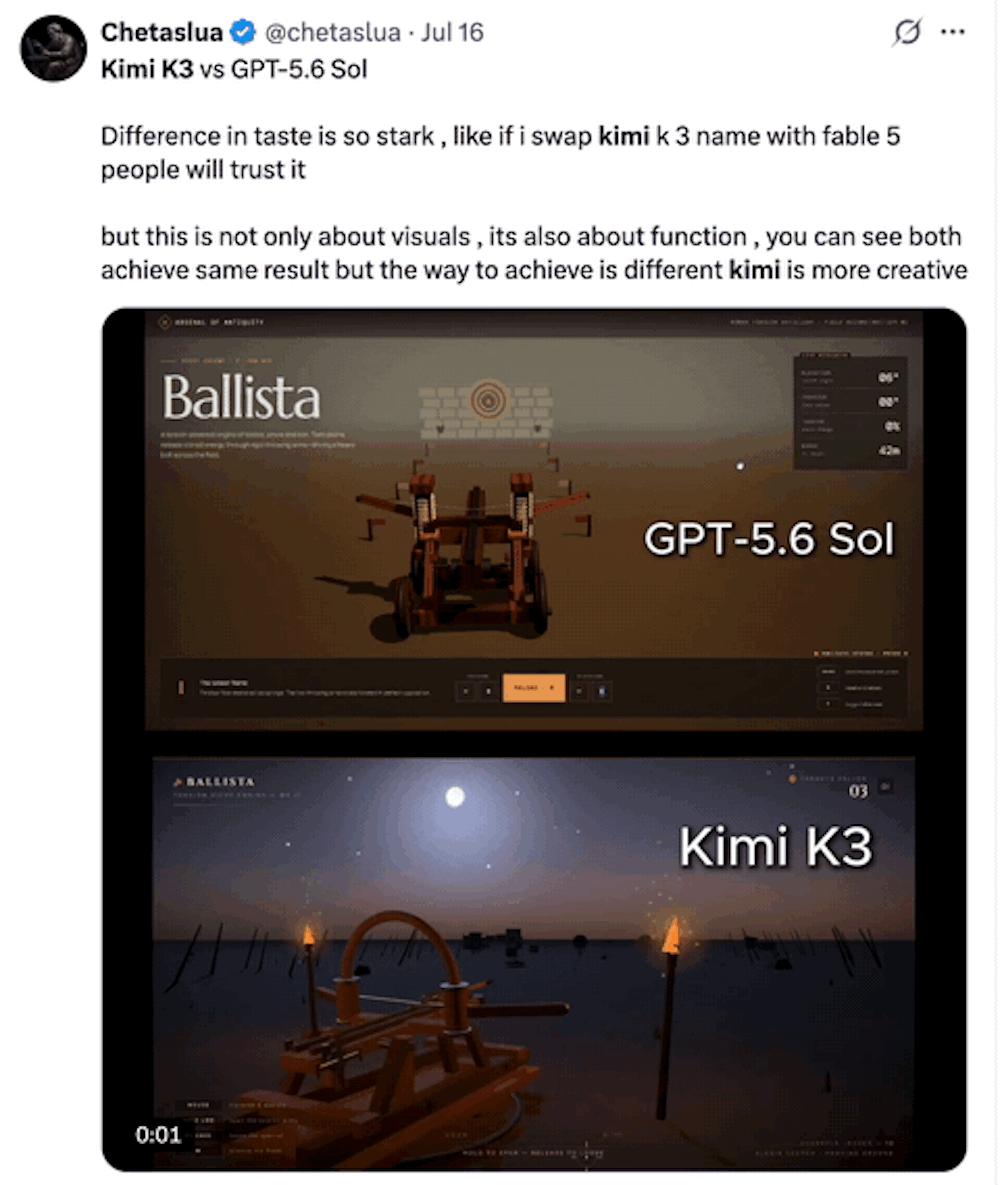
为了验证Kimi K3的真实能力,多项独立第三方测评和开发者实测展示了其在具体应用场景中的卓越表现。在代码生成领域,Kimi K3展现了惊人的效率与质量。
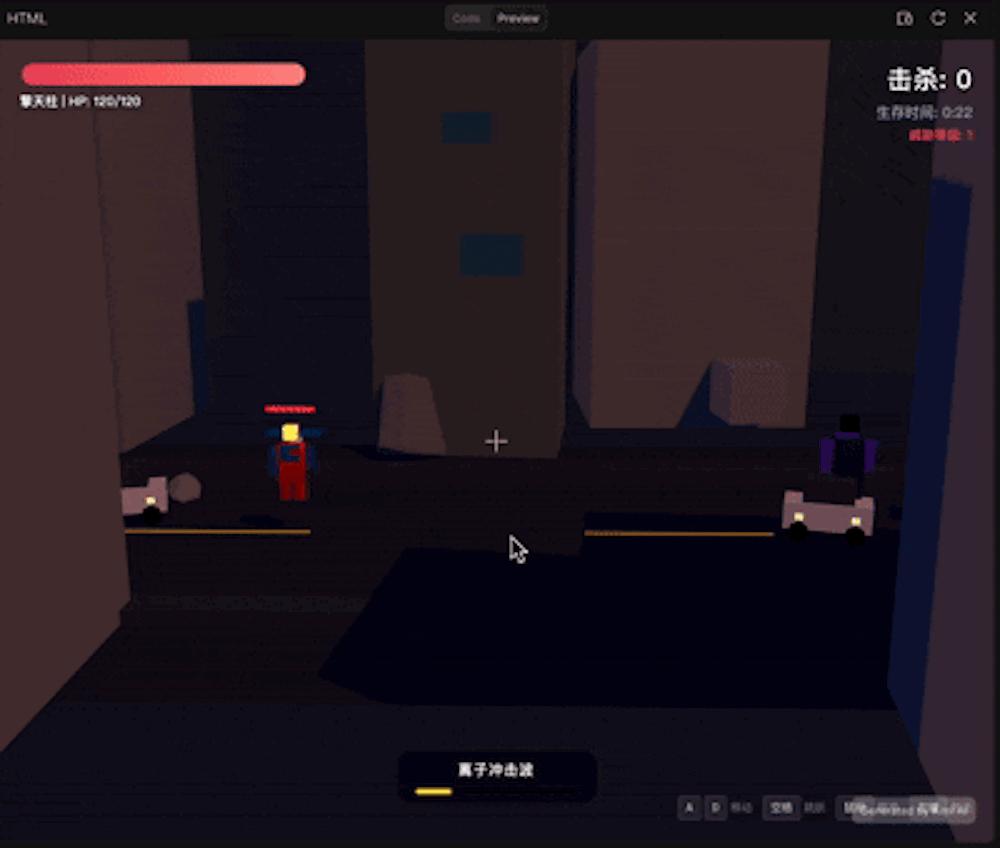
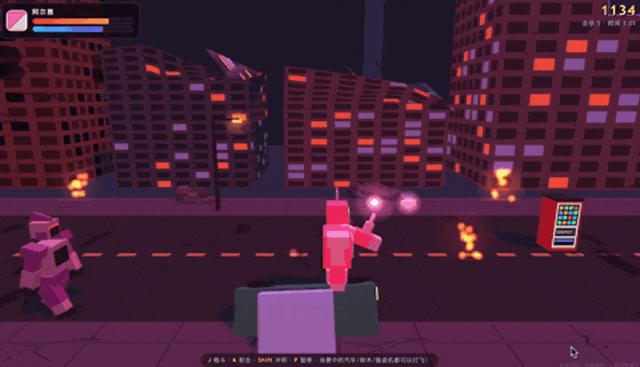
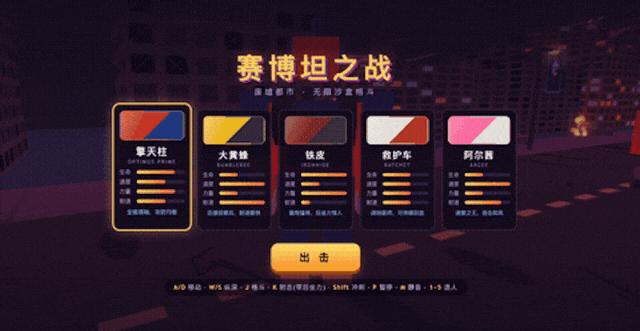
在一项针对3D横版格斗游戏生成的测试中,智东西使用Kimi K3 Max模式,要求模型创建一个以破败城市为背景、包含赛博坦机器人敌人的3D游戏。Kimi K3仅用一次调用便完成了代码构建,且逻辑无误。与之前的Kimi K2.6相比,Kimi K3对提示词的理解更加精准,没有出现玩家控制异常的问题,画面元素也更符合“低多边形风格”和“卡通美学”的要求。更令人惊喜的是,模型在无提示的情况下,自动为游戏增加了射击和击打两种攻击模式,展现了极强的泛化创造力。
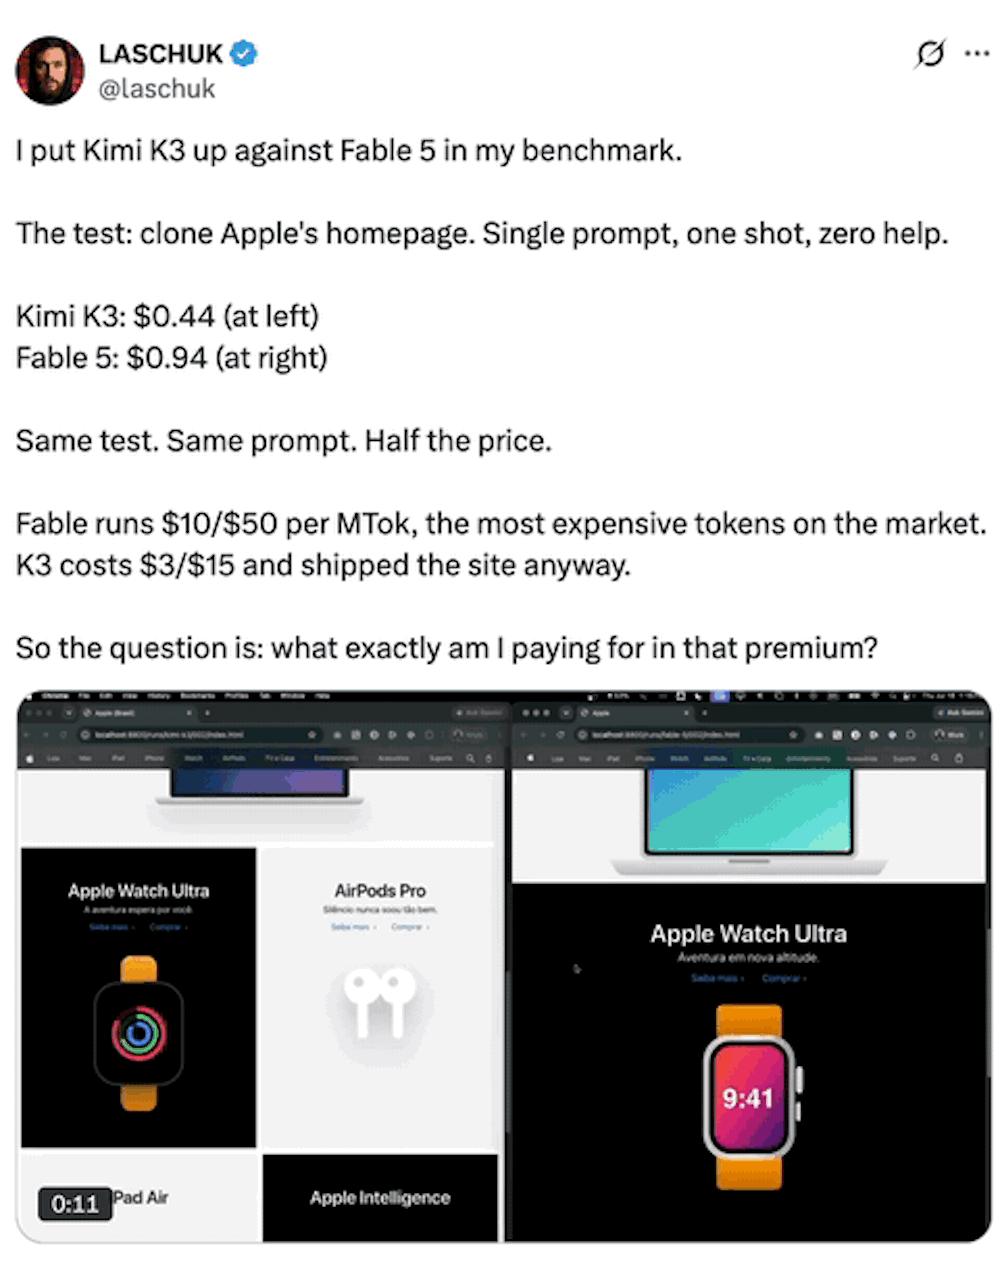
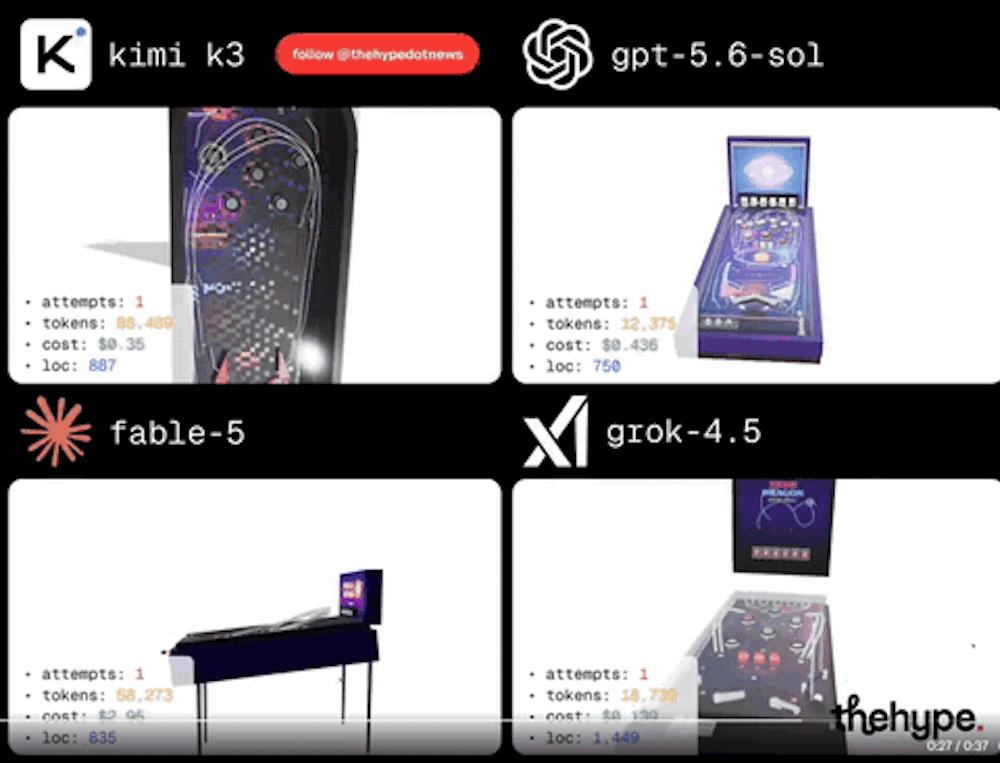
另一位开发者LASCHUK在复刻苹果官网的测试中,对比了Kimi K3与Claude Fable 5。结果显示,两者均能高质量完成页面开发,但Kimi K3的单次调用成本仅为0.44美元,而Claude Fable 5高达0.94美元,前者成本仅为后者的一半。按百万Token计价,Kimi K3的价格更是远低于市面绝大多数模型,这对追求成本效益的企业开发者极具吸引力。
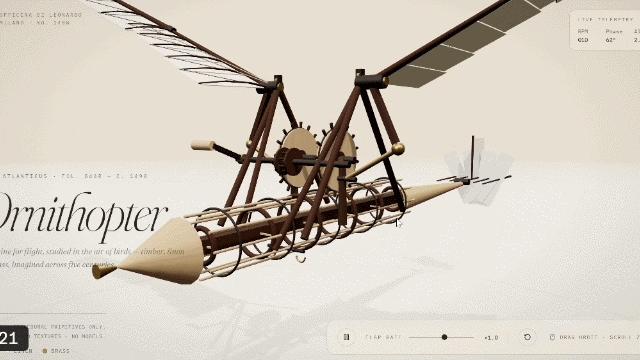
在多模态创意方面,Kimi K3同样表现出色。海外网友利用其生成了一个“达芬奇工坊”模拟器,不仅复现了视觉风格,还深入理解了达芬奇扑翼机的历史背景和空气动力学原理,将材料、结构知识与生成结果深度融合。这种跨领域知识整合能力,表明Kimi K3已不再是简单的像素或文本拼接器,而是具备了一定科学推理深度的智能主体。
Agent演进:从单点任务到长程工作流交付
Kimi K3最具颠覆性的能力,在于其长程Agent式执行能力的飞跃。它能够将编程、视觉理解、工具调用和知识工作串联成完整的闭环流程,自主完成过去需要人类专家数天甚至数月才能完成的工作。
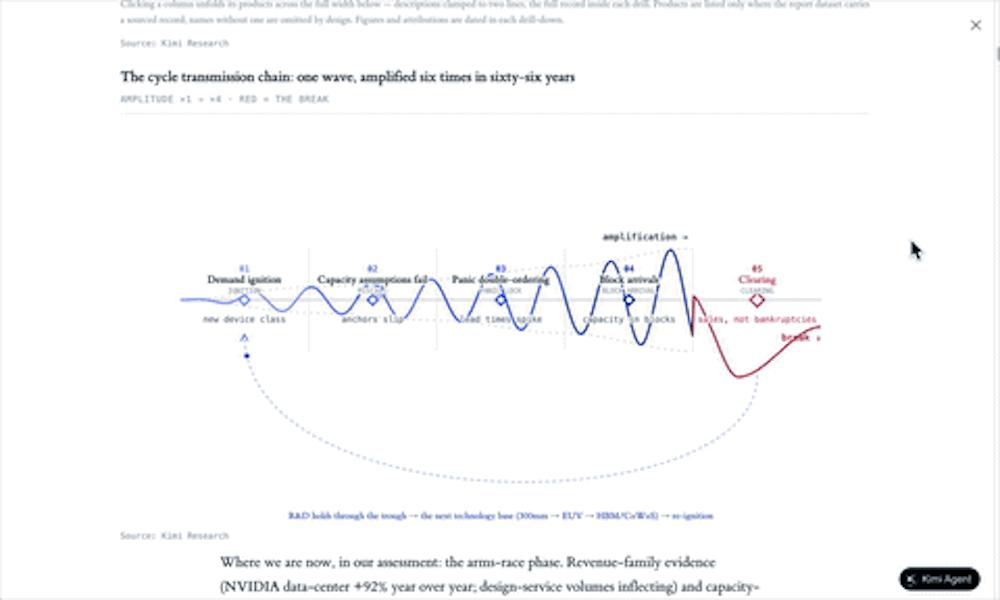
在官方展示的ASIC行业研究案例中,Kimi K3面对的是一个跨度42年的研究网站。它通过120多轮迭代,自主完成了2800多次网页搜索与抓取、1100多次终端数据提取,处理了87份季度报告和99份原始PDF。最终,模型生成了一份包含定制图表、动画示意图和交互式可视化叙事的深度研究报告。这一过程完全自动化,无需人类干预,展现了惊人的持久性和任务分解能力。
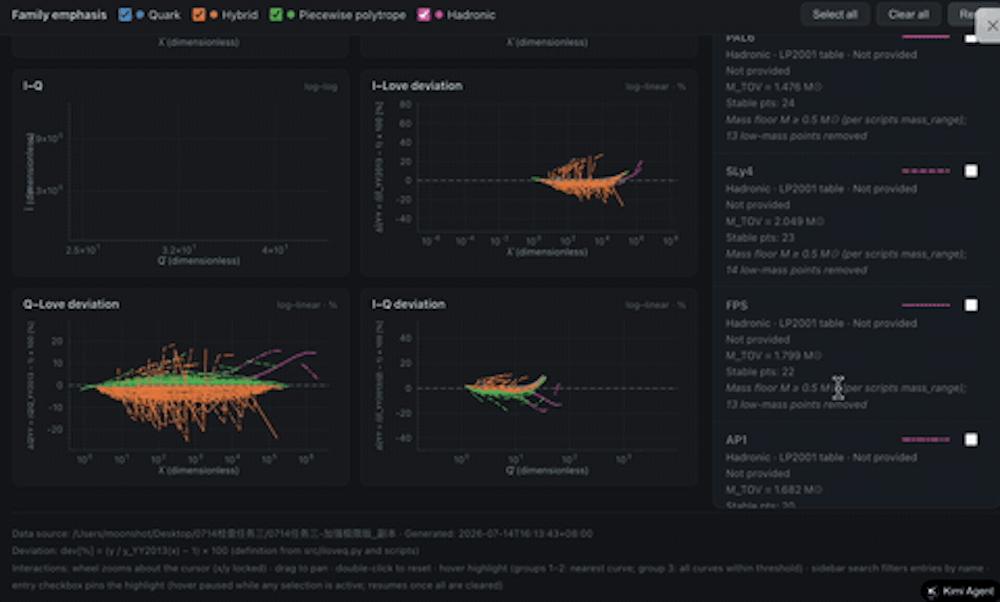
在知识创作领域,Kimi K3对GWTC-5引力波数据的分析报告更具代表性。模型启动了20多个并发Subagents(子智能体),对391个引力波事件进行分析,生成了7张科学可视化图和2张表格,并综合了10多篇论文的内容。这种多任务并行处理与结果融合的能力,是传统单点模型无法企及的。
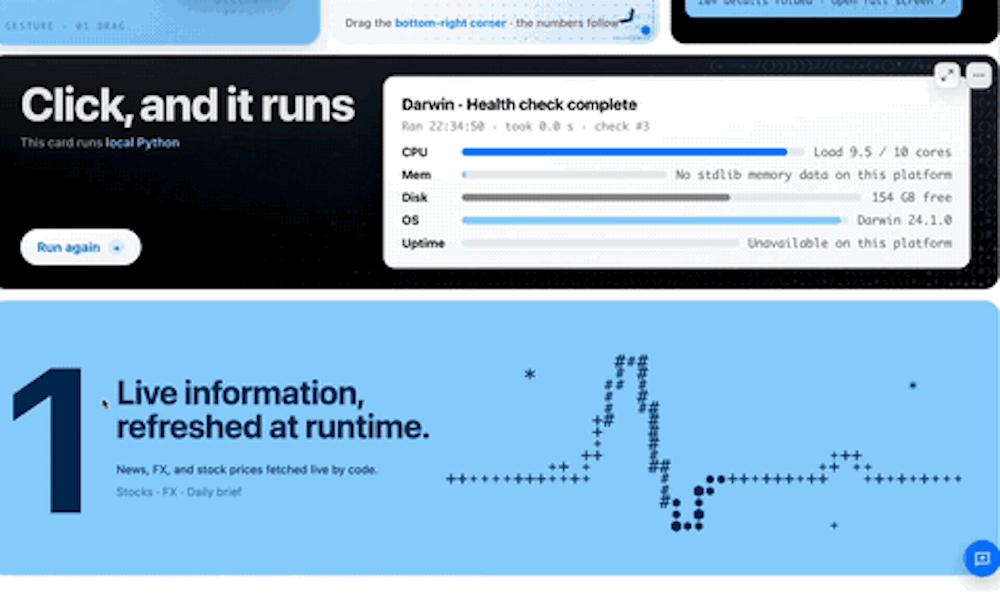
此外,Kimi Work推出的“小组件”和“看板”功能,基于Kimi K3增强了模型交互的可视化和持续管理能力。用户可以生成可交互内容,连接本地数据或外部插件,形成围绕项目目标的长期工作空间。这意味着AI助手不再是一次性问答的工具,而是可以长期驻留、逐步完善项目的数字同事。
性能对标:在基准测试与现实体验中寻找平衡
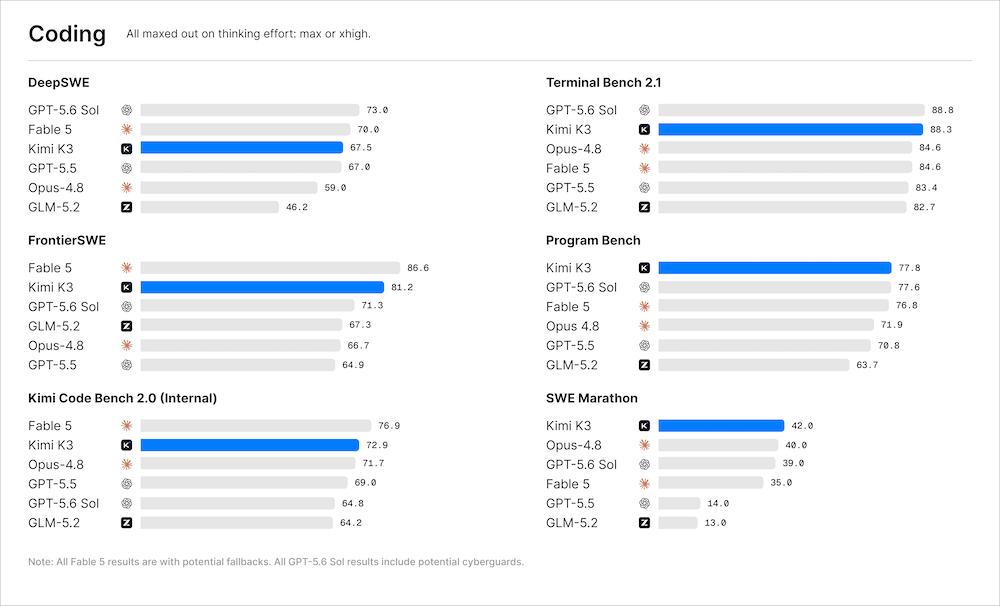
在权威基准测试中,Kimi K3的表现令人瞩目。在Arena.AI的前端代码测试中,它超越了Claude Fable 5;在Vals AI的综合测试中,得分74.7,位列第二,超越了GPT-5.6。在编程专项测试如SWE Marathon和Program Bench中,Kimi K3均取得第一;在Terminal Bench 2.1中达到88.3分,与GPT-5.6 Sol接近。
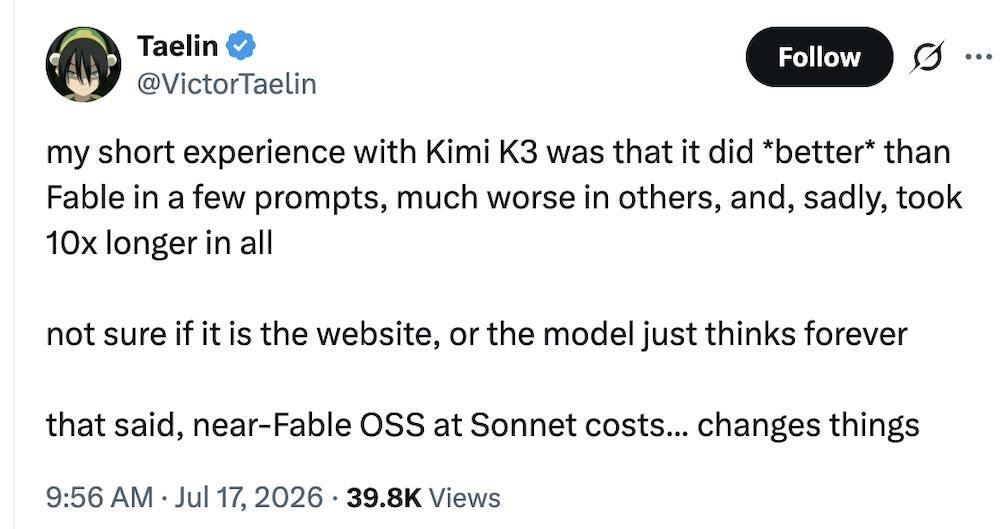
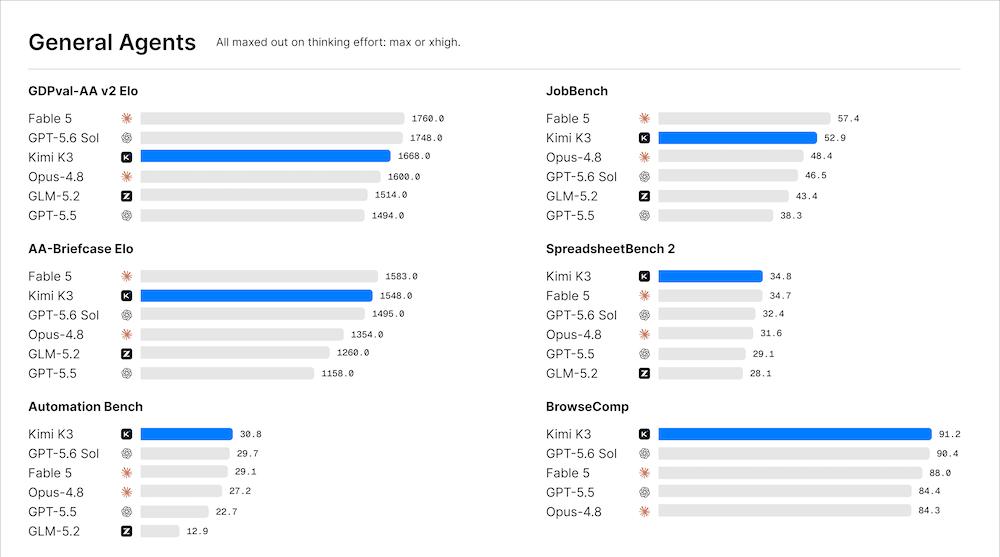
然而,客观地看,Kimi K3并非在所有维度上都完美无缺。在某些综合白领任务评测如GDPval-AA v2和APEX-Agents中,它仍弱于Claude Fable 5等顶级闭源模型。测评博主Taelin指出,虽然Kimi K3在某些题目上表现优异,但在处理部分复杂题目时耗时较长,且稳定性略逊一筹。这提示我们,大模型的性能评估是多维度的,基准测试高分并不等同于所有场景下的最佳体验。
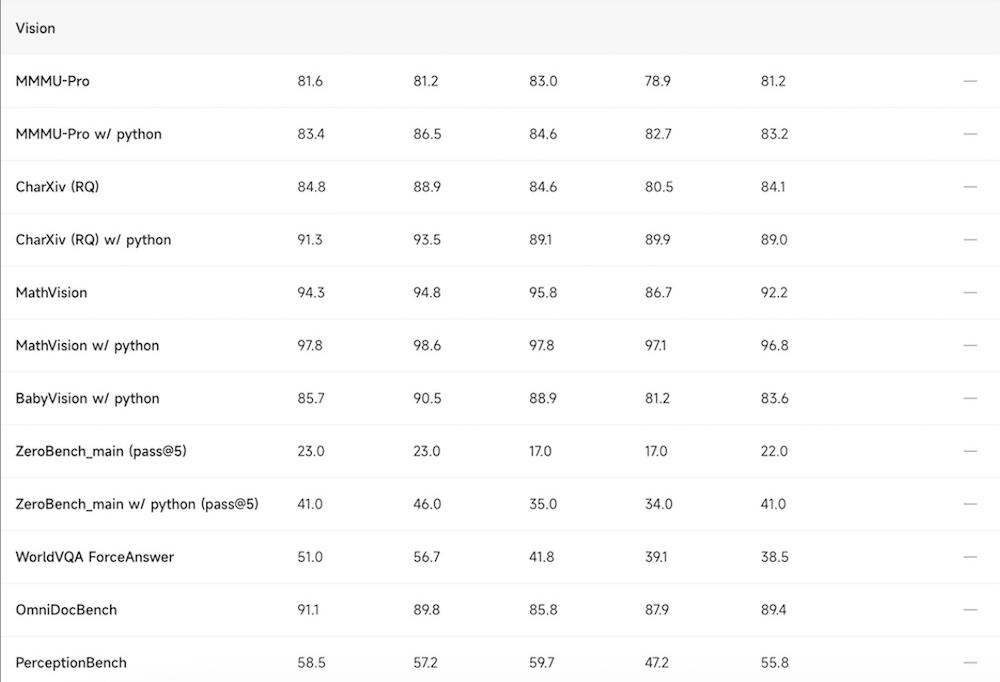
在视觉推理任务中,如Zerobench,Kimi K3也存在一定差距。这反映了当前多模态模型在零样本视觉工具使用上的共性挑战。尽管如此,Kimi K3在OmniDocBench文档分析等任务中达到91.1分,超过多款竞品,显示其在文档理解领域的强大优势。
值得注意的是,Kimi团队也坦诚指出了Kimi K3目前的使用限制。由于采用保留思维历史的训练模式,如果Agent框架未正确返回完整历史,或在会话中切换模型,生成质量可能不稳定。此外,针对长期复杂任务的强化训练可能导致模型在用户意图不明确时过于主动。建议用户通过系统提示词或AGENTS.md文件设置更明确的行为边界,以优化交互体验。
经济账本:极致性价比引发的行业震荡
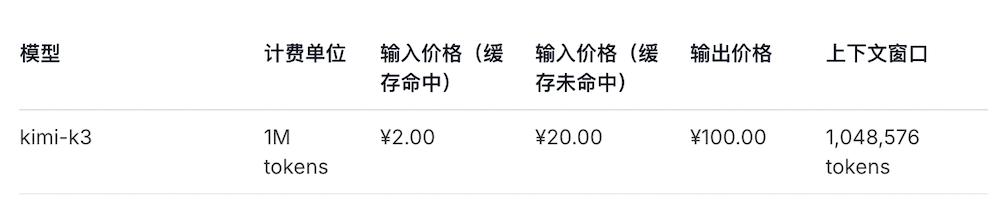
如果说技术突破是Kimi K3的内核,那么极具竞争力的价格策略则是其引爆市场的催化剂。Kimi K3维持了分级计费模式,虽然相比Kimi K2.6有明显上涨(输入价格从6.5元涨至20元,输出价格从27元涨至100元),但相比顶级闭源模型,其价格优势依然巨大。
以Claude Fable 5为例,其API输入价格为每百万Token 10美元(约67.78元人民币),输出价格为50美元(约338.88元人民币)。相比之下,Kimi K3在缓存命中情况下的输入价格仅为2元,输出价格100元,整体成本仅为Claude Fable 5的三分之一甚至更低。
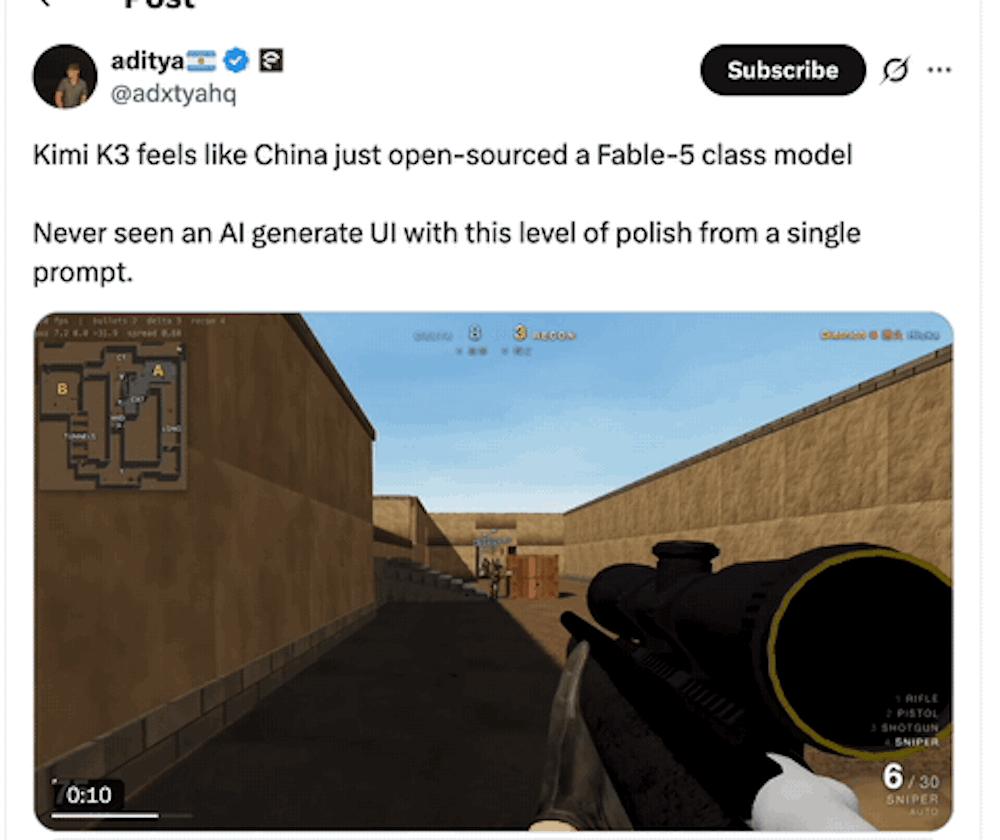
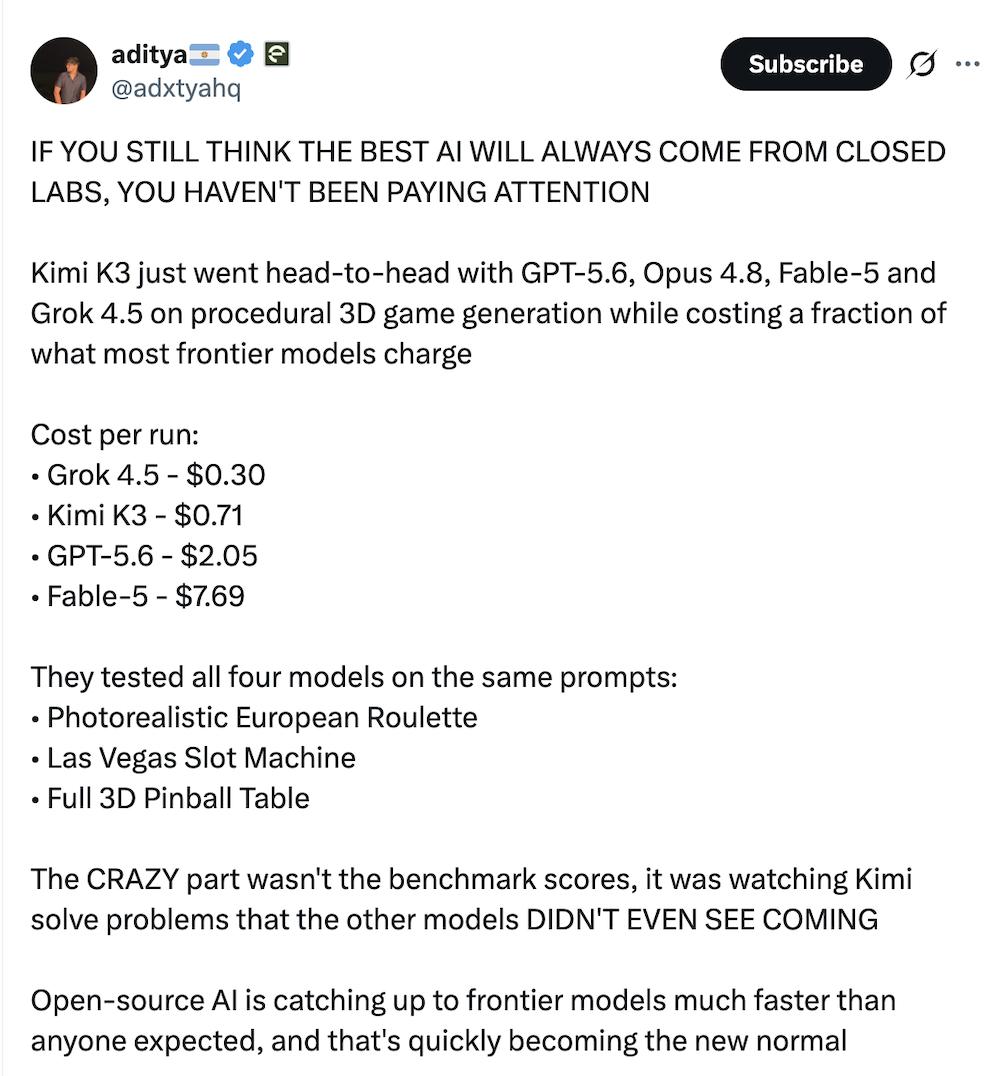
这种定价策略对开发者生态产生了深远影响。测评博主aditya指出,用Claude Sonnet 5的价格就能买到接近Claude Fable 5的开源模型,彻底改变了他对开源模型价值的认知。高价闭源模型的溢价价值受到质疑,开发者们开始重新评估自建模型与使用API之间的成本效益比。对于中小企业和个人开发者而言,Kimi K3的开源权重发布(计划于7月27日)意味着他们可以本地部署,进一步降低长期运营成本,摆脱对单一云服务商的依赖。
未来展望:开源大模型的新范式
Kimi K3的发布,不仅仅是参数量的跃迁,更是开源大模型发展范式的一次重要转变。它证明了通过架构创新和工程优化,开源模型完全有能力在性能上逼近甚至局部超越闭源巨头,同时提供更具经济性的解决方案。
然而,挑战依然存在。随着模型规模的扩大,推理效率、能耗控制以及安全性问题日益凸显。如何在保持高性能的同时降低碳足迹,如何确保Agent在长程任务中的可靠性和可解释性,仍是业界需要共同面对的课题。
Kimi K3的成功,激励了更多开源团队投身于超大模型的研发。它打破了“只有闭源才能做到极致智能”的迷思,为构建一个更加开放、多元、高效的AI生态系统奠定了技术基础。未来,我们可能会看到更多基于Kimi K3架构优化的垂直领域模型涌现,推动AI技术在工业、科研、教育等领域的深度落地。
对于用户而言,Kimi K3意味着更强大的工具、更低的使用门槛和更多的选择权。对于行业而言,这意味着竞争将更加激烈,创新将更加频繁。在这个由算力、数据和算法共同驱动的新纪元,Kimi K3只是起点,而非终点。随着开源社区的持续贡献和技术迭代,我们有理由期待一个更加智能、普惠的AI未来正在加速到来。