企业Agent落地困境:为何评估体系比模型能力更关键?
在人工智能技术飞速迭代的当下,企业级智能体(Agent)被视为释放生产力潜能的关键钥匙。亚马逊云科技(AWS)CEO Matt Garman曾描绘了一幅宏伟蓝图:数十亿个智能体将在各行各业广泛运行,从库存管理到人才招聘,无所不能。然而,理想丰满,现实骨感。根据MIT Project NANDA发布的报告,尽管全球企业在生成式AI领域投入了数百亿美元,但仅有5%的组织成功实现了规模化部署并获得了显著的财务回报。这种“高采用率、低转化率”的现象,被称为“GenAI鸿沟”。
在智能体细分领域,这一鸿沟表现得尤为剧烈。许多企业在Demo阶段看到的效果令人振奋,但一旦接入真实业务场景,系统便频频失效。问题的根源往往不在于底层大模型的能力不足,而在于工程化落地的复杂性被严重低估。传统软件工程的评估测试体系在面对智能体时全面失效,导致企业生产环节陷入停滞。要跨越这一鸿沟,核心不在于追求更强大的模型,而在于建立一套适应智能体特性的评估方法论。
传统软件工程范式的失效
智能体与传统软件存在着三个本质的差异,这些差异使得传统的SDLC(软件开发生命周期)方法不再适用。首先是非确定性。传统软件的运行逻辑是确定性的,同样的输入必然产生同样的输出,且存在明确的对错标准。而智能体基于大模型运行,其输出具有概率性特征。今天测试通过的用例,明天可能因模型的微小波动而失败,目前没有任何主流模型提供商能承诺完全确定性的输出。
其次是**“Prompt即源代码”**的特性。在传统开发中,修改代码会有版本控制、静态分析工具介入,影响范围可控。而在智能体开发中,自然语言提示词即便只微调一个词,也可能引发行为的剧烈波动。当前行业缺乏成熟的工具来精准评估这种改动的影响范围,导致调试过程如同在黑盒中摸索。
最后是隐式依赖。智能体对底层大模型存在强烈的隐式依赖。模型提供商在后台进行无声的升级优化,应用代码一行未动,但智能体的服务质量、响应速度甚至逻辑判断可能已经发生巨大变化。这三个差异叠加,构成了企业落地智能体的最大工程壁垒。
从SDLC到ADLC:评估为核心的飞轮
面对上述挑战,亚马逊全球副总裁储瑞松提出了一个反直觉的观点:底层技术平台可以通过采购获得,但评估标准必须由企业自主掌控。企业的核心竞争壁垒,在于其自有的“黄金数据集”和评估体系。这一观点揭示了智能体开发的新范式:从线性的SDLC转向非线性的ADLC(Agent Development Lifecycle,智能体开发生命周期)。
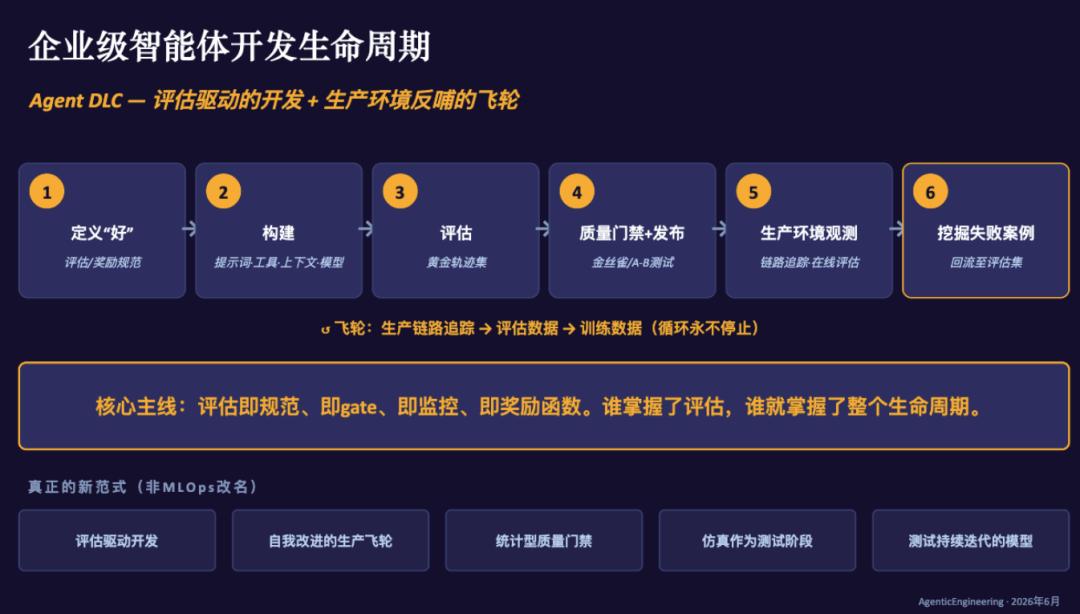
ADLC并非简单的流程迭代,而是一个持续旋转的飞轮。它包含六个关键环节:定标准、开发实现、效果评估、灰度上线、持续监控、改进循环。与传统的“开发→测试→上线”不同,ADLC强调评估既是起点也是终点。在启动开发之前,企业必须定义何为“好”的智能体,包括其定义、语气个性、工具参数以及基准数据集。上线后,生产环境的数据需通过可观测性系统(如OpenTelemetry)回流至评估体系,驱动标准的更新与模型的再优化。
这种闭环机制要求系统架构本身具备可评估性。指南推荐采用三层设计:认证层确认用户身份,授权层(Gateway)控制智能体权限,会话隔离层确保不同用户间的互不干扰。只有当系统架构能够被清晰观察和量化评估时,飞轮才能真正转动起来。
评估方法论:“两根支柱”体系
在智能体落地过程中,开发者常遇到“间歇失效”的痛点:同一类请求,十次中有一两次出错。这揭示了智能体的能力(Capability)与一致性(Consistency)是两个独立维度。“能做到”不等于“每次都能做到”,由于智能体耦合了多步推理、工具调用和外部状态,任何环节的随机性都会被链式放大。解决这一问题的唯一路径,是构建基于“两根支柱”的系统化评估方法论。
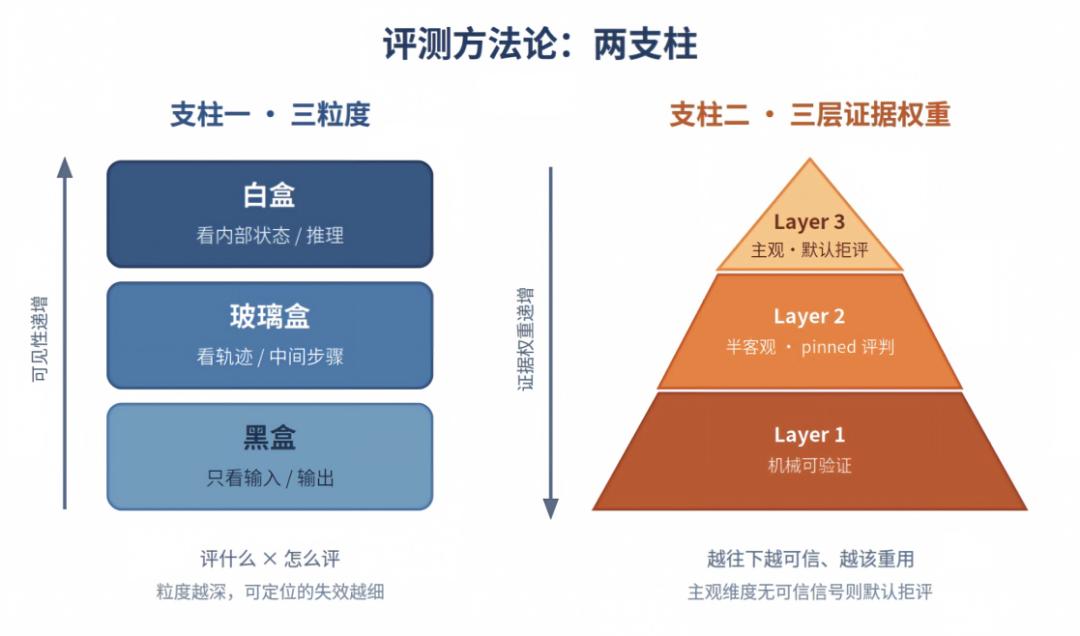
第一根支柱决定评估的粒度。
- 黑盒评估:仅关注最终响应。用户提问,智能体回答,判断结果对错。适用于快速筛查。
- 玻璃盒评估:观察完整执行轨迹。分析智能体做了哪些决策、调用了哪些工具、每一步推理是否合理。这是日常开发中最核心的评估方式,能深入理解智能体的内部逻辑。
- 白盒评估:聚焦单步细节。验证某一个工具调用是否正确、某一段推理是否成立。适用于深层调试。
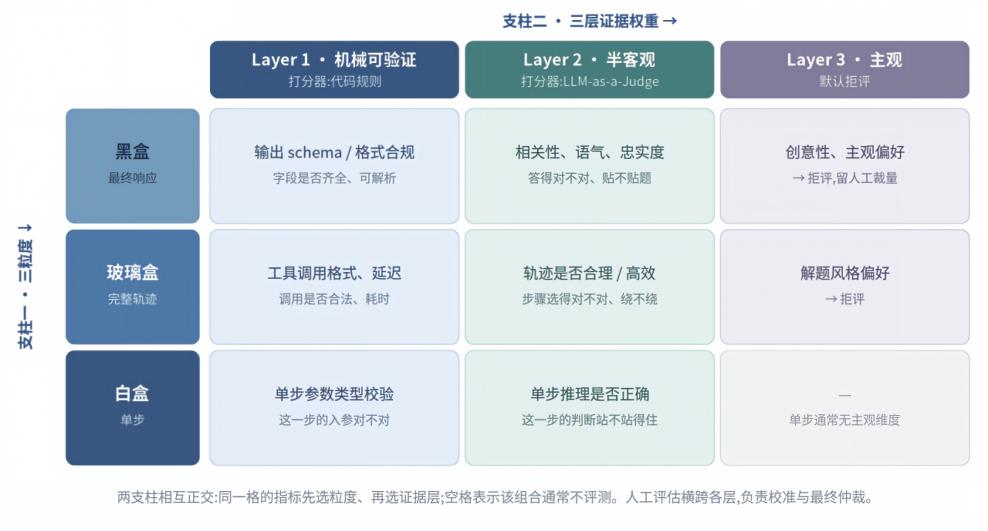
第二根支柱决定证据的权重。
- Layer 1 机械验证:完全自动化,零主观判断。例如检查JSON格式是否合法、字段是否缺失。这是最基础的底线保障。
- Layer 2 半客观评判:使用固定的评估器和明确的评分标准,对特定维度进行打分。例如,利用模型作为裁判,基于预设规则对回答的相关性进行评级。
- Layer 3 主观默认评判:没有固定标准,依赖人工专家或高阶LLM的判断力。适用于复杂场景下的语义理解、价值观对齐等难以量化的维度。
这两根支柱正交组合,形成一个3×3的评估矩阵。通过选择不同粒度和证据强度的组合,企业可以对智能体的输出进行全方位、多层次的量化评估。例如,AWS在开发客服智能体时,针对“意图识别”这一核心风险点,采用了“真实数据+虚拟客户模拟”的双轨评估方法。通过低成本扩展测试范围至边缘场景,既验证了意图识别的准确度,也保证了多轮对话的连贯性。
核心资产:黄金数据集与可观测性
评估体系的有效性,上限取决于数据集的质量。由于评估过程中大量依赖模型自动评判,如果训练或测试数据本身存在偏差或噪声,评估结果将失去参考意义。因此,建设经过人工标注、经业务验证的高质量测试集,成为企业的核心战略资产。这个“黄金数据集”不仅是智能体的训练燃料,更是衡量其表现的标尺。
此外,可观测性系统是支撑持续评估的基础设施。没有完善的日志记录和链路追踪,生产环境的数据无法回流,飞轮就会卡死。企业需要建立从用户交互到内部推理、再到工具调用的全链路监控能力,确保每一次“失败”都能被捕获、分析并转化为改进的动力。
不同形态的智能体,其评估维度侧重点各异。客服智能体关注意图识别准确率与对话连贯性;工具使用智能体侧重工具选择的正确率与参数准确性;多智能体协作系统则需考察任务拆分的合理性与执行稳定性。尽管具体指标千差万别,但底层逻辑一致:智能体是生产力工具,能否交付可衡量的业务结果,是判断其价值的终极标准。
结语:决心与投入的挑战
进入智能体时代,企业面临的是一场技术与商业的双重考验。AWS提供的指南和方法论仅为一种参考路径,而非万能药。智能体的规模化部署,要求企业在技术架构、数据治理、评估体系上投入巨大的决心与资源。唯有摒弃“模型越强越好”的单一思维,转而构建自主可控的评估闭环,企业才能跨越GenAI鸿沟,让智能体从演示Demo真正走向生产一线,创造实实在在的商业价值。这不仅是一场技术升级,更是一次管理范式与工程哲学的深刻变革。