万亿Token时代降临:PPIO如何构建新一代智能算力基础设施?
算力范式的根本性转移
2026年的AI产业正在经历一场深刻的结构性变革。国家数据局披露的数据显示,截至2026年3月,中国日均Token调用量已突破140万亿大关。这一数字相较于2024年初的1000亿增长了逾1000倍,在短短两年内完成了四个数量级的跃升。Token,这个曾经仅存在于技术文档中的计量单位,如今已演变为AI时代最基础的交易单元,其增长速度远超人类历史上任何一种基础资源,如电力或燃油。
全球范围内,IDC预测显示,全球年度Token消耗量将从2025年的0.0005 Peta Token激增至2030年的15万Peta Token,年复合增长率高达3418%。这一爆炸式增长的背后,是AI应用从“回答问题”向“动手干活”的实质性跨越。WAIC 2026上展示的多款智能体应用表明,AI正从单一的对话交互,转向具备自主规划、工具调用及多步骤执行能力的智能实体。每一次智能体的决策循环,都在以指数级方式消耗算力资源。
驱动这场变革的核心动力,在于AI产业重心从“训练”向“推理”的全面切换。IDC测算指出,2026年中国AI服务器市场规模预计达到3500亿元,需求结构已正式从“训练驱动”转变为“训练+推理双轮驱动”,且推理服务器的出货量已逼近训练机型。这种转变不仅体现在硬件需求上,更深刻影响了底层架构的设计理念。传统的云计算架构,原本是为人类开发者设计的,旨在服务长期、稳定的虚拟机部署;而Agent时代的算力需求,则呈现出碎片化、高频化及7×24小时不间断的特征。
传统云架构的局限与Agent时代的挑战
为人类设计的云计算体系,难以直接适配智能体(Agent)的运行逻辑。PPIO联合创始人兼CEO姚欣指出,传统云计算场景中,程序员开启一台虚拟机后,通常需使用数天乃至数月,负载具有明显的波峰波谷特征,且遵循人类的作息规律。然而,Agent对算力的调用则是连续且密集的,不存在睡眠周期,全天候持续运行。
在延迟容忍度方面,二者亦存在显著差异。人类用户对延迟的容忍度通常在秒级,而智能体在完成复杂任务时,需反复调用模型数十次甚至上百次。若每次调用存在数百毫秒的延迟,经过循环放大后,将导致任务执行效率急剧下降,甚至不可接受。此外,随着智能体应用的萌芽,推理成本虽呈现断崖式下降,但单纯的算力资源供给已无法构成竞争壁垒。当推理成本每年以10倍速度下降时,商业模式的核心价值转向了谁能以更高效率、更低成本、更优体验交付Token。
这一现状促使行业重新审视算力基础设施的定义。Token工厂应运而生,成为调节算力运力的关键节点。根据灼识咨询数据,按2025年及2026年第一季度平均每日Token消耗量计,PPIO在中国独立AI云计算服务提供商中排名第一。2026年6月,平台日均Token消耗量突破1.2万亿次,较2025年同期增长超8倍。与此同时,平台全球注册开发者从2024年末的12.5万人激增至2026年6月的超过66.6万人,显示出市场对高效Token生产体系的强烈需求。
智能Token工厂:重新定义生产力公式
PPIO提出的“智能Token工厂”,并非简单的算力堆砌,而是一套围绕Token全生命周期进行优化的大规模生产与交付体系。其核心逻辑在于解决“如何高质量、高效率地生产更智能的Token”这一命题。姚欣提出Agent时代的核心公式:Agent生产力=Token智能密度×Agent Loop时长。
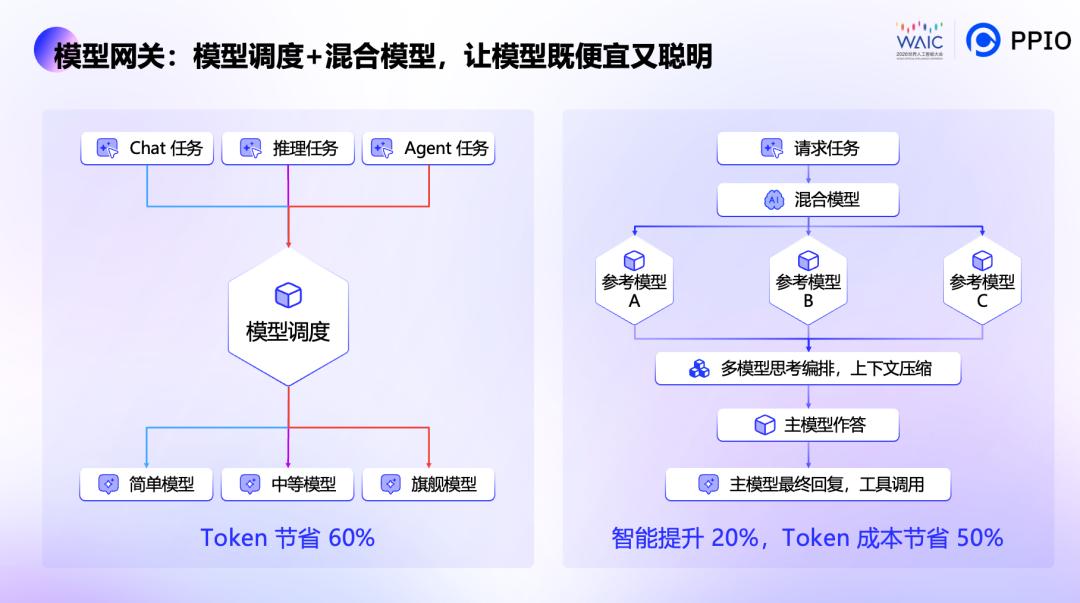
Token智能密度决定了智能体每一步决策的质量上限,直接关联任务执行的准确性与合理性;Agent Loop时长则决定了智能体能持续运行多久、完成多复杂的任务链。围绕这一公式,PPIO在国内率先推出了智能模型网关,作为AI Agent的智能调度中心。该网关通过混合模型机制,实现关键决策由高精度模型把关,简单任务自动分流至轻量级模型,从而在最低Token成本下实现最高的智能性能。
在混合模型的应用上,PPIO正在测试将两到三款不同模型组合使用,形成互相PK与讨论的机制。内部测试数据显示,这种混合推理方式在部分任务执行上已超越单一模型(如GPT-5.6)。尽管单模型在绝对性能上可能存在小幅差距,但通过工程化的外部组合策略,有效突破了模型智能的上限。这种“专家会诊”式的推理机制,使得每次模型调用都成为优化后的最佳组合,显著提升了Token的智能密度。
差异化还体现在对典型场景的深度定制。PPIO识别出人对话、智能体调用、AI编程三种场景对性能参数的不同要求:人追求秒级响应,智能体要求毫秒级低延迟,AI编程则对精度要求极高,力求少出错。基于场景的定制化优化,构成了PPIO区别于其他通用云平台的重要护城河。平台支持200余款开源模型统一接入,开发者切换模型仅需修改一行代码,这种中立定位消除了生态绑定的顾虑,建立了深厚的开发者信任。
极致效率:算力利用率的革命
在算力成本节节攀升的背景下,能否最大化利用现有算力,直接决定企业的盈利能力。行业平均GPU利用率通常在40%至50%之间,而PPIO长期维持在75%以上。这一成就得益于其自研的推理加速引擎与分布式算力调度能力。
PPIO打通全球六大洲5000余个算力节点,利用东西半球时区差异进行错峰调度。通过将不同时间、空间和请求频次的负载进行高质量融合,后台呈现出接近直线的利用率曲线。这种调度策略不仅提升了资源利用率,还有效降低了单位算力成本。自底向上,PPIO搭建了从GPU集群、推理服务优化到应用场景深度理解的全栈式AI云能力。其Sandbox最小结算单元已细化至秒级,专门适配Agent负载的碎片化与连续性特征。
这种极致的效率能力,在开发者生态中得到了验证。2026年4月,平台日均Token消耗量达1.03万亿次,AI云计算收入从2024年的1038.7万元跃升至2025年的1.192亿元,同比增长超10倍。数据表明,市场愿意为高效、低成本的Token交付服务支付溢价。PPIO的选择是不做封闭花园,而是做AI时代的互补者,通过开源与中立策略,拥抱更广泛的开发者生态。
Agentic Cloud:面向未来的基础设施
智能Token工厂解决了“今天如何高效生产Token”的问题,而Agentic Cloud则回答了“明天Token将被谁、以何种方式消耗”的宏观命题。2026年,全球云巨头不约而同地发布Agentic Cloud战略。谷歌提出Agentic Cloud战略并发布Agent Engine;阿里云完成全栈智能体化升级;亚马逊推出AgentCore;微软的Foundry Agent Service正式商用。其共同目标均为让Agent成为云基础设施的核心受众。
PPIO在WAIC 2026上正式发布“Agentic Cloud”全新定位,明确指出云的第一用户正在从人转向AI Agent。姚欣分享了一组引人深思的数据:全球80亿人口中,约20%使用AI,真正付费者仅5%。相比之下,智能体的调用正在发生指数级增长。以PPIO自身为例,300多名员工后台已部署近千个Agent,涵盖开发、运维、客服等环节。每个人可拥有数十乃至上百个Agent,每个Agent均7×24小时消耗Token,这种多元需求催生了新的产品架构。
PPIO的Agentic Cloud架构分为三层:基础设施层、模型服务层及Agent Harness平台层。其中,Harness作为专门用于约束、指导、验证和纠错Agent执行的工程框架,涵盖了上下文构建、工具编排、验证循环、成本控制及可观测性等关键环节。沙箱是Harness的核心组件。PPIO推出的国内首款兼容E2B接口的Agent沙箱,为Agent提供安全隔离的运行环境。
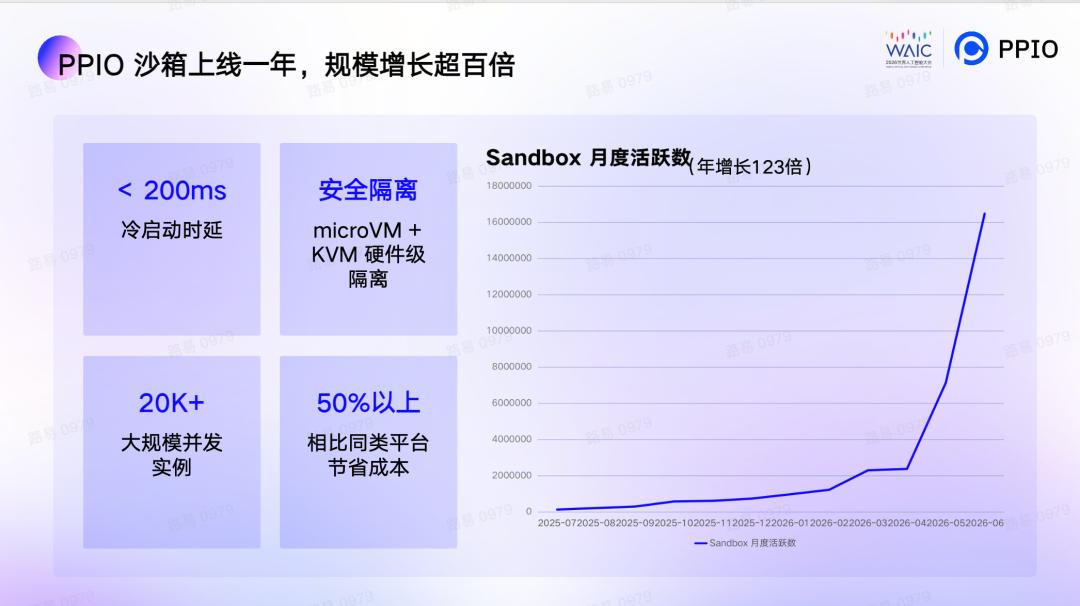
Agent沙箱采用系统级安全隔离,每个任务运行在独立虚拟机环境中,冷启动时延低于200毫秒,支持上万个沙箱同时创建。任务空闲时自动暂停计费,综合使用成本较同类产品降低90%以上。上线一年,业务规模增长超120倍。这一技术突破,解决了早期行业对智能体理解的局限,即从简单的“模型调用手脚”转向长程、复杂任务的持续执行支持。
结语:效率至上的新竞争法则
Token定价规律已显现出新的趋势:编程最贵,其次是智能体,对话服务最便宜。这一排序预示了未来Token消耗的主要方向。PPIO服务的对象正从人类开发者延伸至智能体,乃至未来的机器人。这种转变正在重塑云计算的商业模式,过去比拼功能数量与生态封闭性,如今则比拼让硅基生命跑得更快、更便宜、更稳定。
在Token经济重构算力价值尺度的进程中,效率成为核心竞争力。PPIO通过智能Token工厂与Agentic Cloud战略,构建了从底层算力调度到上层Agent执行框架的完整闭环。其成功不仅在于技术的领先,更在于对Agent时代本质的深刻洞察:算力不再是静态资源,而是动态流转的 Token 生产要素。在这场重构中,唯有持续优化效率、降低成本、提升智能密度,才能在未来的云竞争中获得最终的船票。对于整个行业而言,这标志着云计算从“服务人”向“服务智能体”的历史性跨越,一场关于效率与智能的新一轮竞赛已经全面展开。