Linux Socket编程深度解析:从网络通信本质到核心API实战
网络通信的底层逻辑与抽象
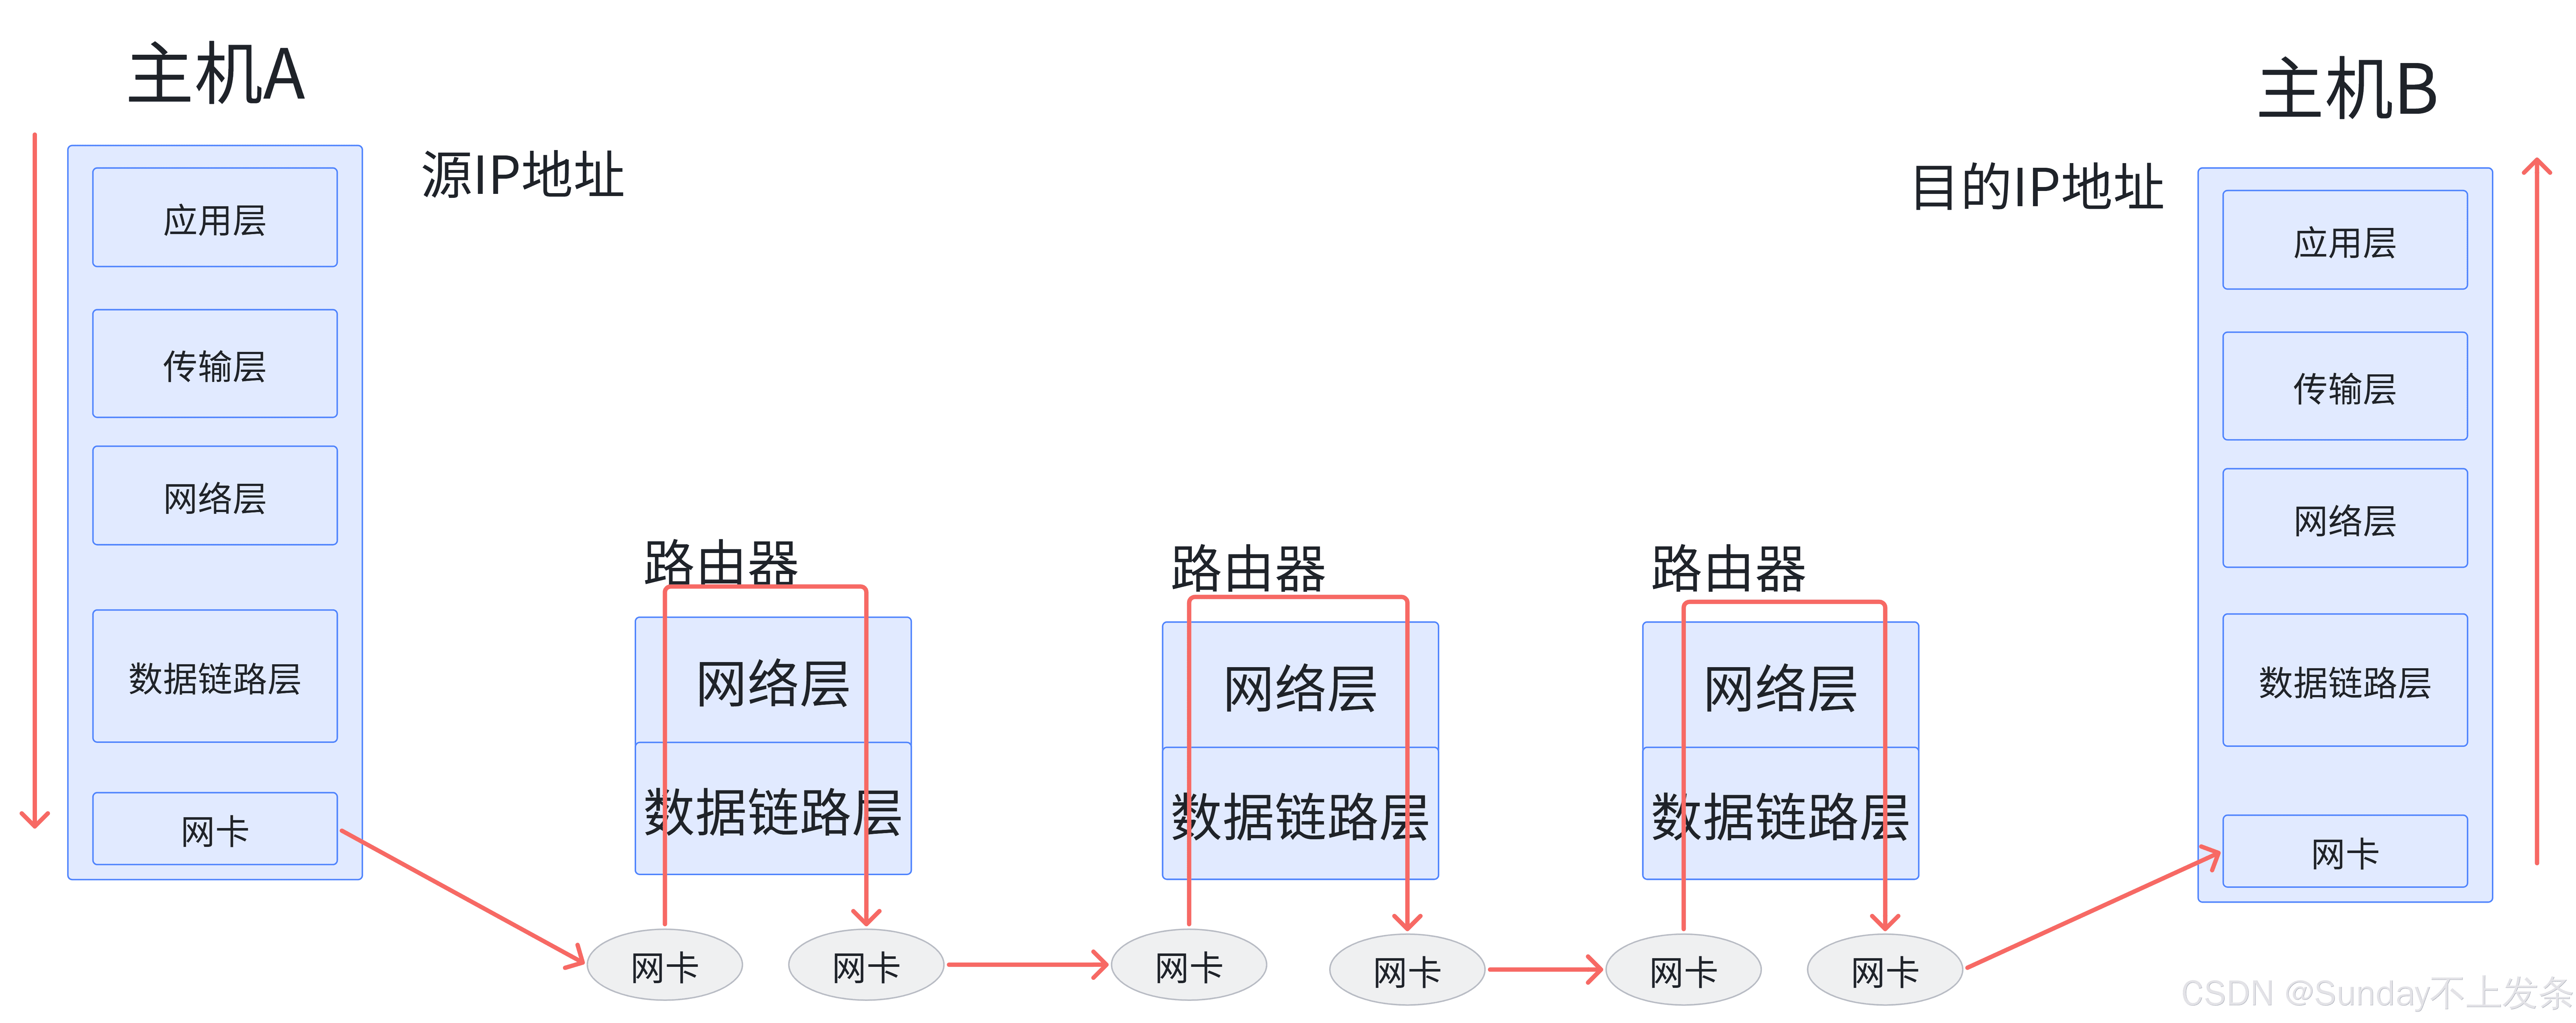
在现代分布式系统中,网络通信构成了数据流动的基石。从操作系统的视角来看,网络通信的本质并非单纯的数据包传输,而是不同主机上的进程之间进行的数据交互。对于参与通信的两个进程而言,网络仅仅被视为一份共享的资源池,它们通过读取和写入这份资源来实现信息的交换。要实现这一过程,必须解决两个核心定位问题:首先,发送方主机必须能够准确定位接收方主机;其次,数据包到达目标主机后,必须被精准投递给特定的目标进程。
IP地址在网络体系中承担了主机的身份标识职能。源IP地址用于标记数据包的发出者,而目的IP地址则指向接收者。然而,主机层面的路由仅完成了第一步定位。由于一台服务器通常运行着数十甚至数百个应用程序,操作系统必须通过另一种机制将数据从主机层面进一步分发到进程层面。这就是端口号存在的意义。端口号是一个16位的整数,它在特定主机内唯一标识一个进程,从而构成了完整的通信寻址体系。IP地址定位主机,端口号定位进程,二者结合形成的套接字(Socket),即为网络通信的终点。
端口体系与Socket抽象
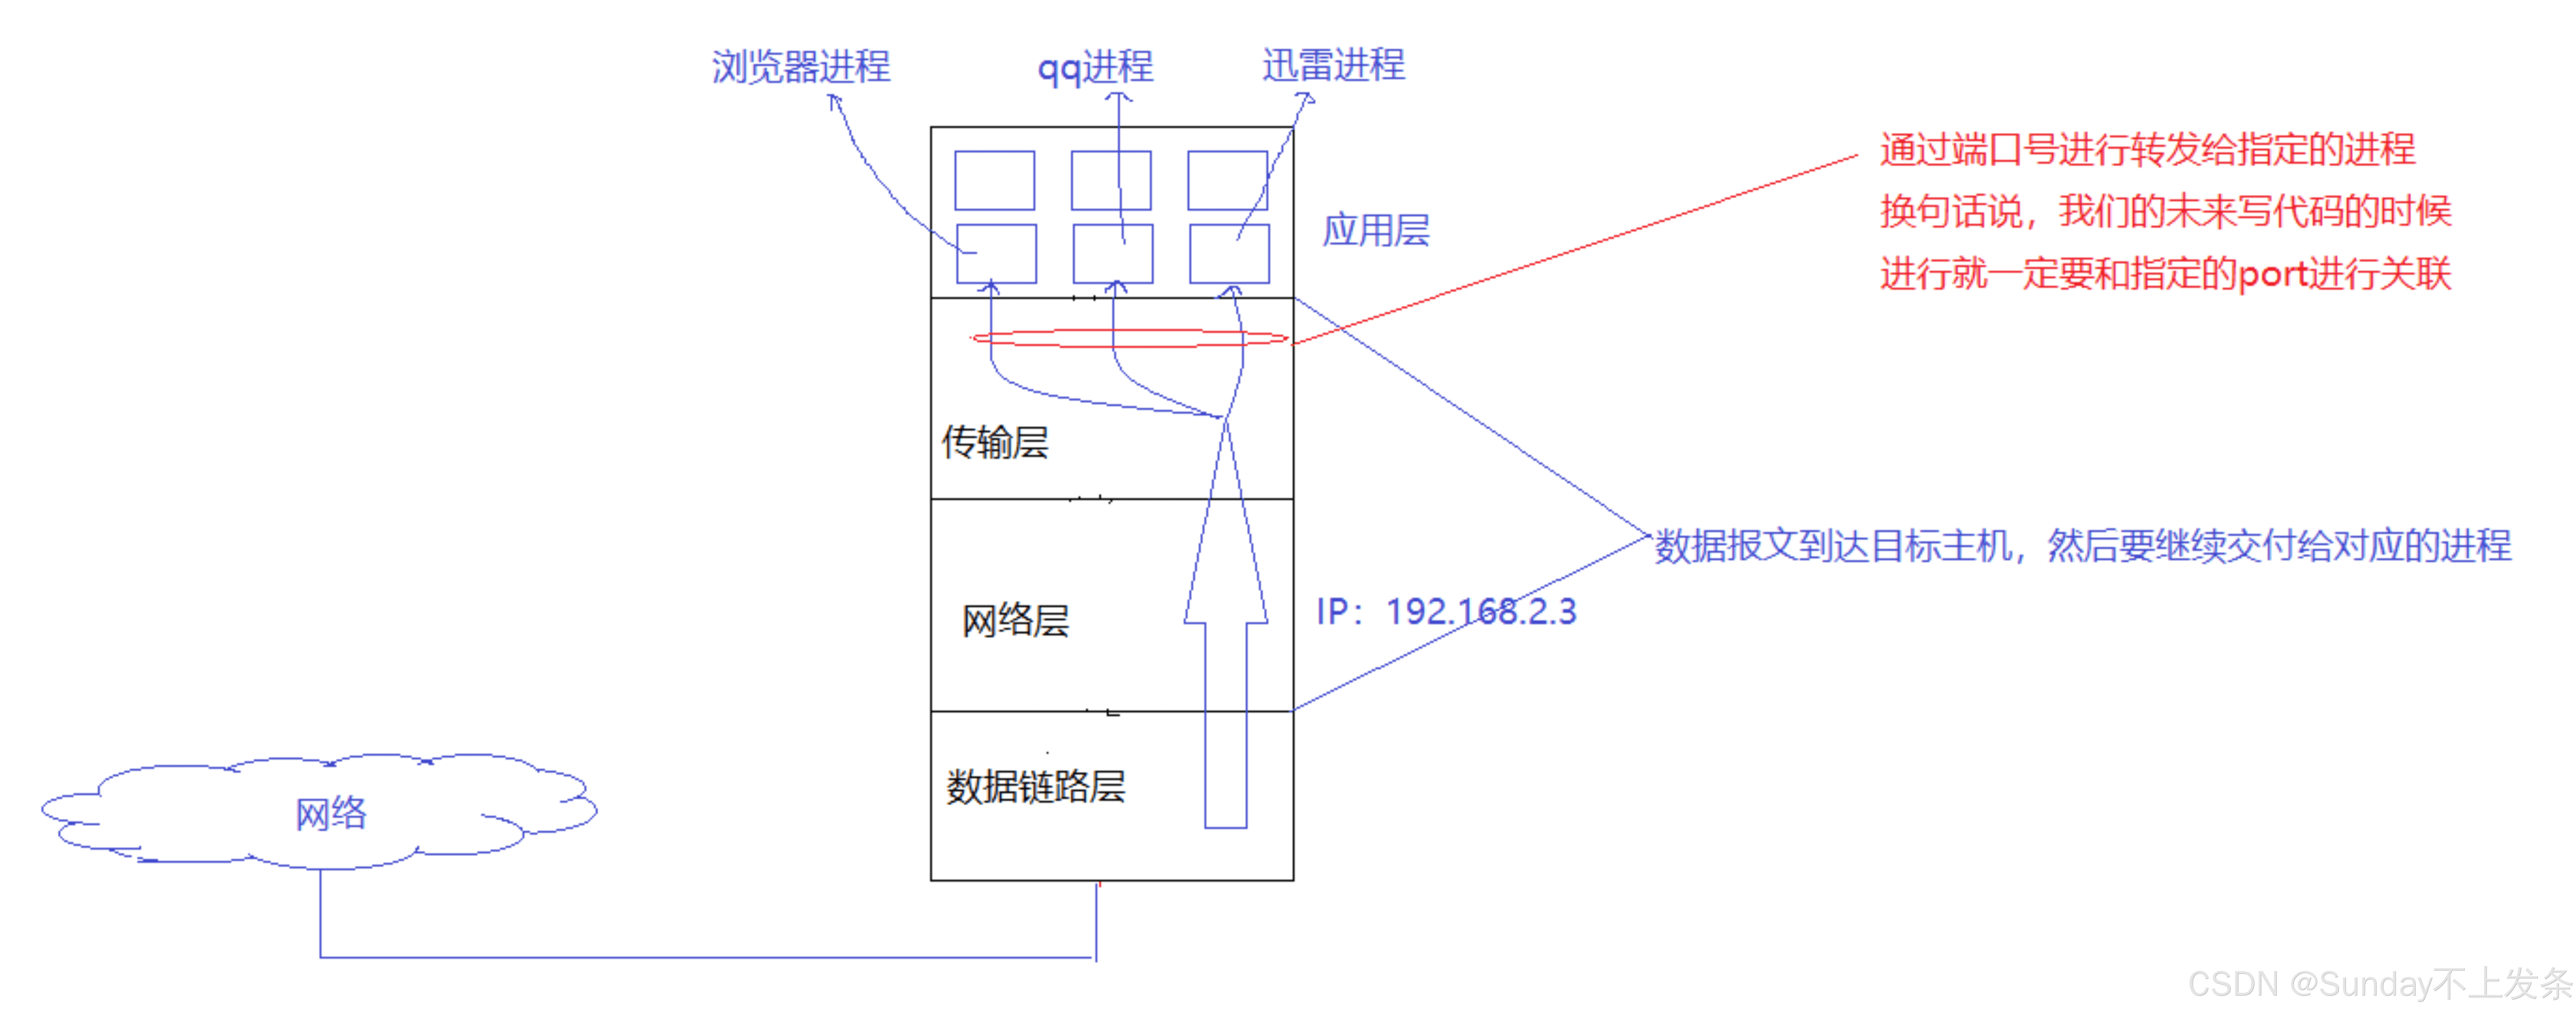
端口号的空间范围为0到65535。其中,0到1023属于知名端口或系统端口,通常被HTTP、FTP、SSH等核心服务独占。这种固定映射机制极大地简化了客户端的访问流程,使得用户无需记忆复杂的IP地址即可通过标准端口访问服务。而1024到65535之间的动态端口则主要由客户端程序使用,操作系统在进程启动网络通信时,会从该范围内随机分配一个未被占用的端口作为临时通信端点。
需要特别强调的是端口与进程的一对一绑定关系。虽然一个进程可以监听多个端口,但一个端口在同一时刻只能被一个进程绑定。这种排他性保证了数据路由的唯一性。从软件架构的角度看,Socket位于应用层与传输层之间,充当了两者之间的桥梁。它向上提供统一的API接口,向下屏蔽TCP/IP协议栈的复杂性。应用程序无需关心数据包在协议栈中的分片、重组及错误校验等底层细节,只需调用Socket API即可实现数据的发送与接收。这种分层设计不仅提高了开发效率,也增强了系统的可移植性和可维护性。
数据一致性与网络字节序
在异构网络环境中,不同计算机硬件架构对多字节数据的存储顺序存在差异。主流架构分为大端模式和小端模式。大端模式将高位字节存储在低地址,符合人类阅读习惯;小端模式则将低位字节存储在低地址。例如,十六进制数0x12345678在大端机器中内存布局为12 34 56 78,而在小端机器中则为78 56 34 12。
若两台采用不同字节序的主机直接通信,接收方解析数据时将产生严重错位。为确保跨平台数据解析的一致性,网络协议标准规定,所有在网络中传输的多字节数据必须采用大端字节序,即网络字节序。因此,主机在发送数据前,必须使用转换函数将主机字节序转为网络字节序。常用的转换函数包括htonl(Host to Network Long)用于32位IP地址转换,htons(Host to Network Short)用于16位端口号转换。反之,接收端收到数据后,需使用ntohl和ntohs将数据转回主机字节序进行业务处理。这一机制是保证网络通信可靠性的关键环节。
Socket编程核心接口剖析
Socket编程基于一组标准的系统调用接口,这些接口构成了应用程序与内核网络协议栈交互的边界。理解这些API的设计意图与行为特征是编写高质量网络代码的前提。
套接字的创建
socket函数用于创建一个通信端点。其原型为int socket(int domain, int type, int protocol);。参数domain指定协议族,如AF_INET代表IPv4,AF_INET6代表IPv6。参数type指定通信类型,SOCK_STREAM对应TCP协议,提供面向连接、可靠、有序的字节流服务;SOCK_DGRAM对应UDP协议,提供无连接、不可靠的数据报服务。参数protocol通常设为0,由系统根据前两个参数自动推导。
调用socket时,内核会在内部创建一个socket对象,分配缓冲区等资源,并返回一个文件描述符(fd)。在Linux系统中,一切皆文件,网络套接字也不例外,这使得我们可以利用标准的文件IO操作(如read/write)来处理网络数据。协议族的选择不仅决定了通信的物理范围,还决定了后续绑定地址时所需使用的结构体类型。
地址绑定
bind函数用于将特定的IP地址和端口号绑定到套接字上,主要应用于服务端。其原型为int bind(int sockfd, const struct sockaddr *addr, socklen_t addrlen);。对于客户端而言,操作系统通常会自动分配临时端口,因此往往不需要显式调用bind。而对于服务端,必须通过bind明确指定监听地址,否则其他客户端将无法找到该服务。绑定过程类似于手机注册号码,只有绑定了地址,内核才知道将该地址收到的数据包转发给哪个进程。
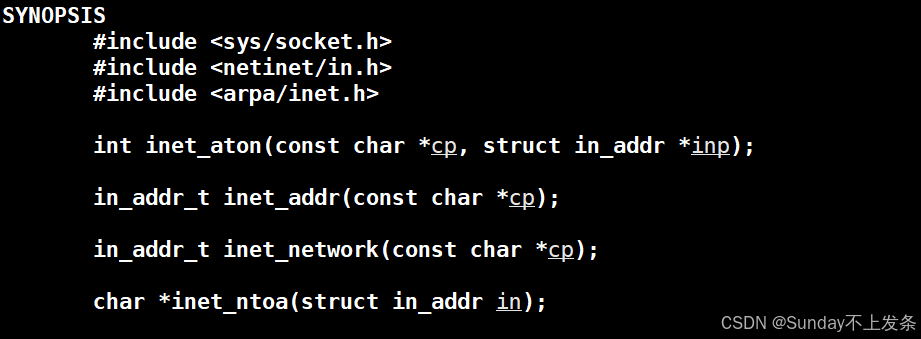
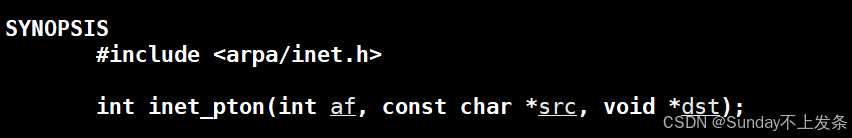
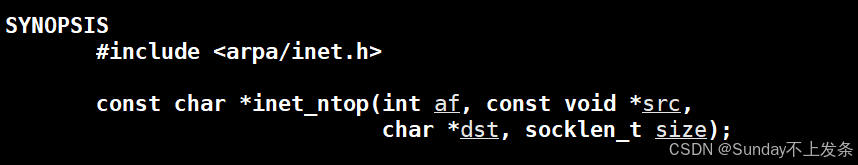
地址结构体sockaddr是一个通用的地址结构,但在实际编程中,IPv4通信通常使用sockaddr_in结构体。该结构体包含地址族、端口号和IP地址字段。需要注意的是,端口号和IP地址在结构体中必须存储为网络字节序。此外,IP地址的转换也是一个常见痛点,开发者需要将点分十进制字符串转换为32位二进制整数。现代编程推荐使用inet_pton和inet_ntop函数,它们不仅支持IPv4和IPv6,且具备更好的安全性和扩展性。
TCP与UDP的服务模型差异
TCP和UDP在编程模型上存在显著差异,这源于它们不同的传输语义。
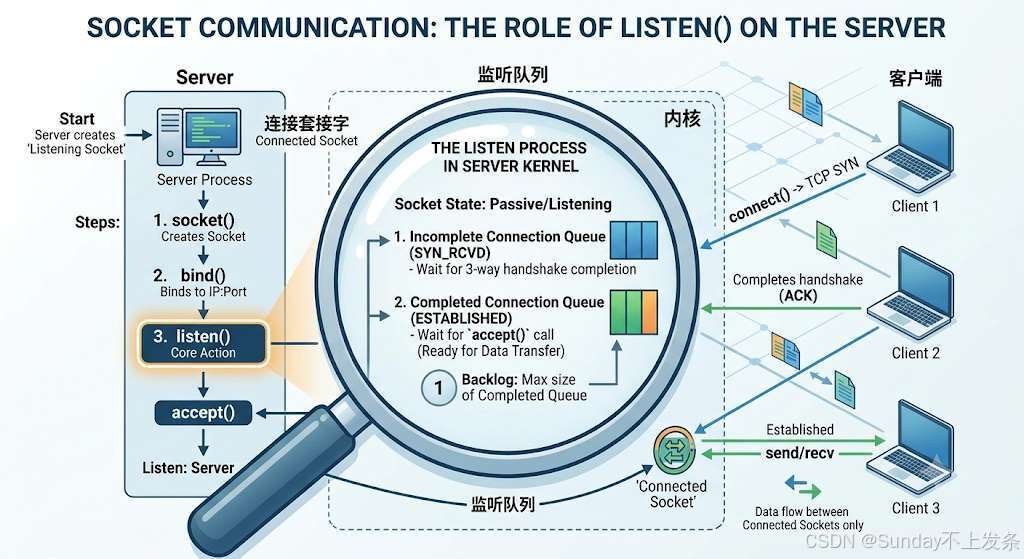
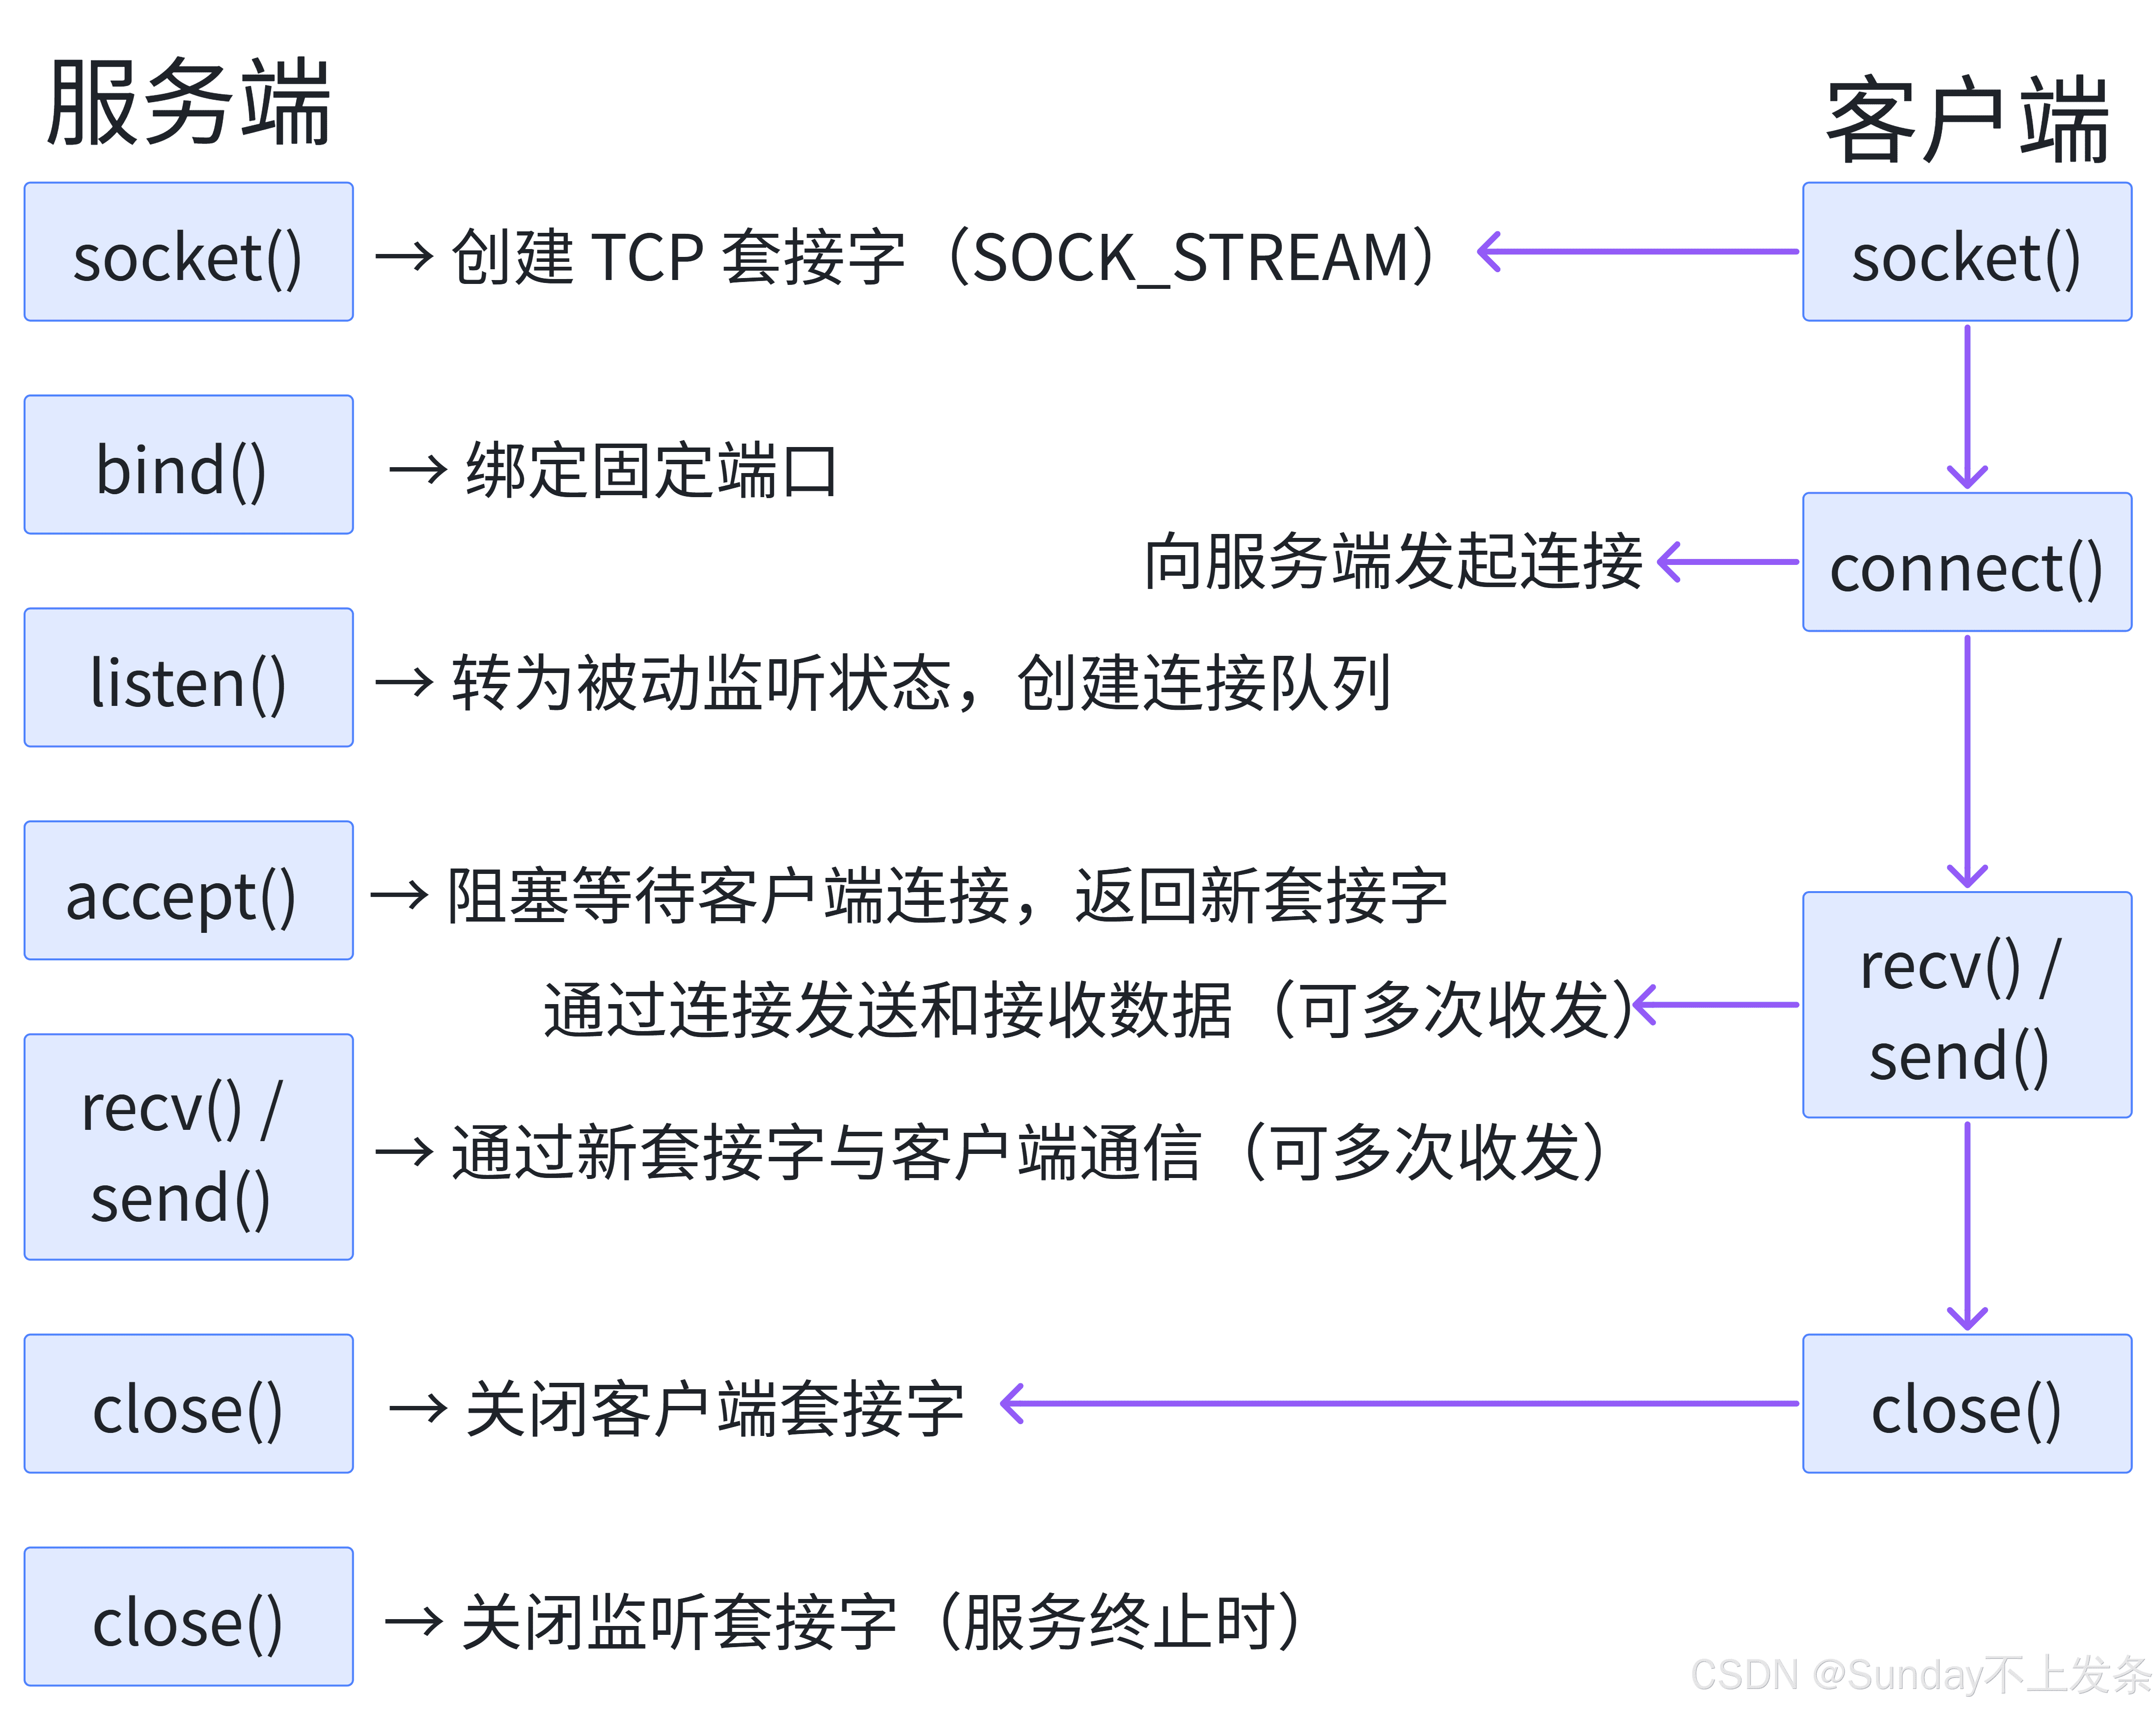
TCP是面向连接的协议,类似于打电话。通信前必须建立连接,通信后必须断开连接。服务端通常需要执行socket、bind、listen三步。listen函数将套接字状态改为监听,并设置半连接队列和全连接队列的长度。随后,服务端调用accept阻塞等待客户端连接。当客户端发起connect连接请求并完成三次握手后,accept返回一个新的套接字描述符,该描述符专门用于与该客户端进行数据交换。原来的监听套接字继续保持监听状态,迎接新的连接。这种分离设计使得服务端能够并发处理多个客户端连接,即监听套接字负责“接客”,已连接套接字负责“服务”。
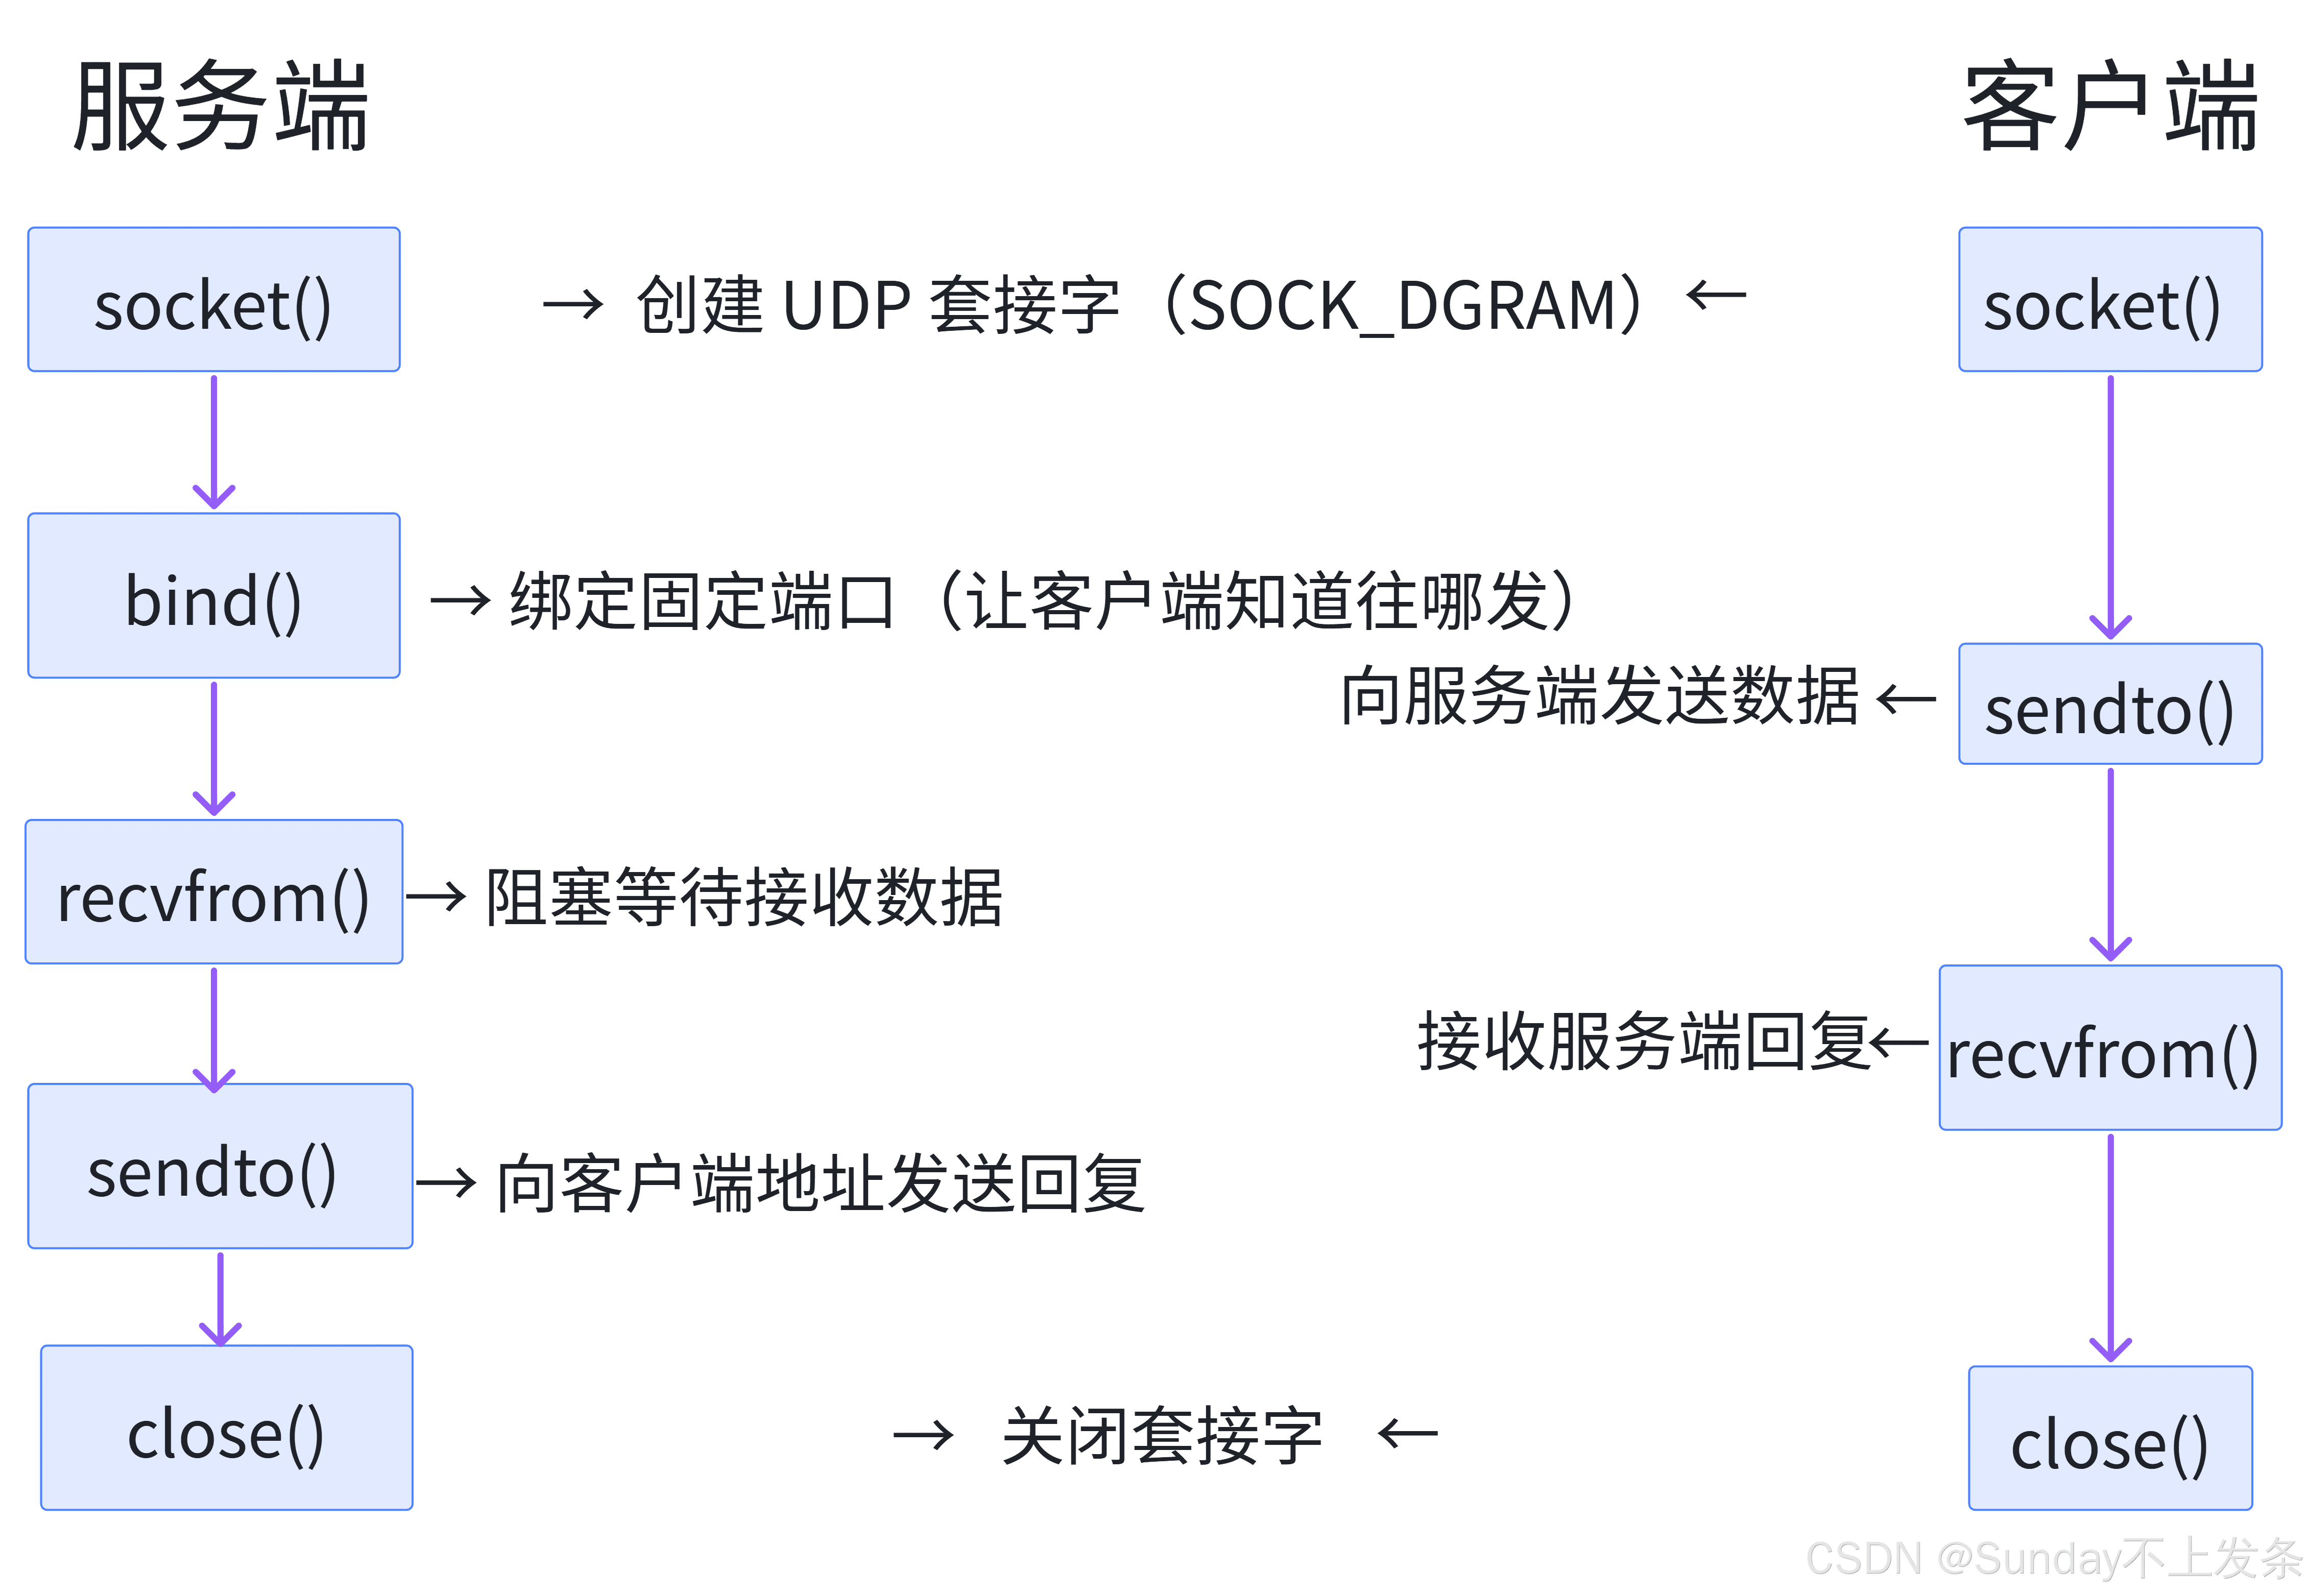
相比之下,UDP是无连接的协议,类似于寄信。服务端只需socket和bind即可开始工作,无需listen和accept。发送端使用sendto指定目标地址发送数据,接收端使用recvfrom接收数据并获取发送方地址。UDP不维护连接状态,数据包之间相互独立,不存在顺序保证和可靠性机制。因此,UDP编程模型更为简单直接,适用于对实时性要求高、可容忍少量丢包的应用场景,如视频流媒体或在线游戏。
深度解析:监听与连接的生命周期
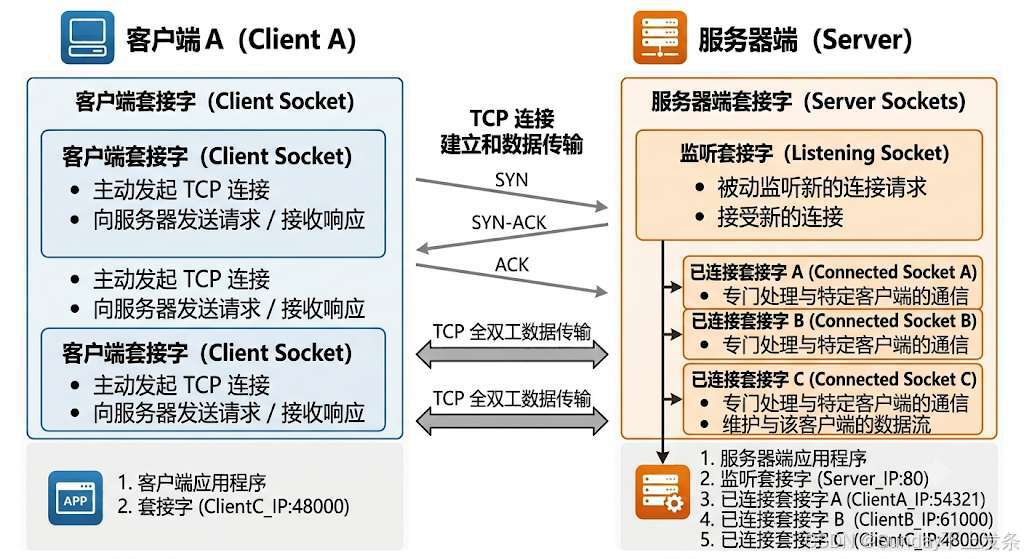
在TCP编程中,区分监听套接字和已连接套接字至关重要。监听套接字的生命周期贯穿整个服务器进程的运行期,它不存储任何用户数据,仅用于接受新的连接请求。一旦accept成功,内核会创建一个新的已连接套接字,该套接字与特定的客户端四元组(源IP、源端口、目的IP、目的端口)绑定。所有的数据收发操作均在已连接套接字上进行。如果复用监听套接字进行数据收发,将导致严重的数据混乱和逻辑错误,因为监听套接字不具备接收已连接数据的机制。
这种设计模式不仅解决了并发问题,还体现了良好的职责分离原则。监听套接字专注于连接管理,而已连接套接字专注于数据传输。在实际的高并发服务器开发中,通常会将已连接套接字交给专门的线程或事件循环处理,从而实现高性能的网络服务架构。
结语与展望
Socket编程是Linux网络开发的核心技能。从底层的IP路由、端口分发,到中层的字节序转换、地址格式化,再到上层的API调用与协议选择,每一个环节都蕴含着精妙的设计思想。掌握TCP与UDP的本质区别,理解Socket对象在内核中的行为,是编写健壮、高效网络程序的基础。随着网络技术的不断发展,QUIC等新型协议的出现正在挑战传统的TCP/IP模型,但Socket作为用户态与内核态交互的标准接口,其核心地位依然稳固。深入理解这些基础概念,有助于开发者在面对复杂的网络问题时,能够透过现象看本质,设计出更优的系统架构。