AI吃AI是伪命题?2026年模型坍塌背后的数据纠错真相
穿透情绪化叙事:重新审视“模型坍塌”的边界
当2024年7月《Nature》封面刊登Shumailov等人关于“模型坍塌”(Model Collapse)的研究时,行业内的恐慌情绪迅速蔓延。研究揭示了一个令人不安的理论极值:在一个完全封闭的递归训练环境中,AI模型在经历九代迭代后,其输出特征会从复杂的中世纪建筑退化为根本不存在的兔子物种。这一发现仿佛给AI的无限进化蒙上了阴影,暗示着如果AI开始依赖并吞噬自己的输出,最终将导致智能的彻底退化。
然而,站在2026年的节点回望,局势已发生微妙变化。斯坦福发布的最新AI指数报告显示,互联网新内容中AI生成比例已突破51.72%,AWS的研究也指出约57%的网络文本经过AI处理。随着高质量人类文本数据可能在2026至2032年间耗尽,合成数据因其极低的成本优势(合成图像标注成本仅为人工标注的1%左右)成为行业主流依赖。在这种背景下,“AI吃AI会完蛋”的悲观论调似乎找到了现实土壤。
但作为产品从业者,我们必须穿透这种情绪化的叙事,回归工程与产品的底层逻辑。模型坍塌并非不可逆的技术天花板,而是一个典型的数据治理问题。将实验室中的极端封闭条件直接等同于现实世界的复杂场景,是典型的认知偏差。真正的风险不在于递归本身,而在于缺乏有效的纠错与数据锚定机制。我们需要从产品架构的维度,重新定义AI数据的生命周期管理。
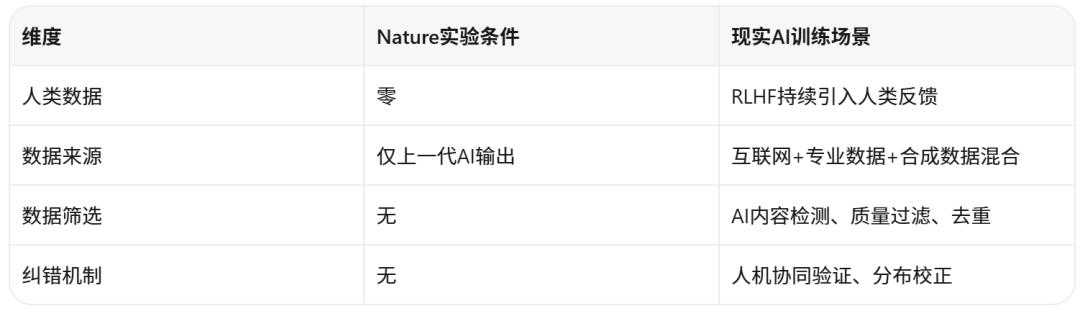
认知纠偏:为何人类文明未因“递归”停滞?
要理解AI数据管线的关键,不妨将视角拉远,观察人类文明的发展轨迹。人类文明的演进本质上也是一种递归过程:绝大多数个体都在使用少数精英创造的知识成果,而非每次从零开始原创。然而,人类文明并未因此陷入停滞或退化,反而持续进步。其核心差异在于,人类社会建立了一套精密的“纠错机制”。
人类文明的递归模型可以概括为:少数人进行原创创造 -> 多数人进行套用与传播 -> 通过实验验证、同行评议及现实反馈启动纠错机制 -> 实现知识的迭代升级。中世纪经院哲学的教训在于,当纯粹封闭的递归(仅引经据典而缺乏实验验证)占据主导时,知识体系便陷入了千年的停滞。而科学革命的突破,正是引入了对真实世界的锚定与实验验证,从而打破了封闭循环。
这一逻辑同样适用于AI系统。递归本身不是问题,缺乏纠错机制的封闭递归才是退化螺旋。事实上,业界已有针对这一问题的初步解决方案。2025年,上海交通大学LUMIA实验室联合清华、北大等机构在ICML 2025上提出了“标记级编辑”(Token-Level Editing)方法。该方案的核心并非拒绝合成数据,而是对合成数据进行精细化的标记级修正,从而保留真实数据的长尾分布特征。
更具说服力的是2026年5月挪威科技大学与伦敦国王学院在《物理评论快报》上发表的研究。实验证明,即使在海量合成数据中,只要加入极少量(甚至仅一条经过清洗的)真实人类数据,就能有效阻止模型的坍塌趋势。这一发现彻底颠覆了“AI必须完全由AI训练”的假设,证明了“真实数据锚点”在维持模型智能稳定性中的决定性作用。
产品框架:构建RAID数据纠错机制
基于上述分析,AI产品的核心竞争力正在从单纯的算法参数优化,转向训练数据管线的质量管控。为此,我们提出一套可落地的“数据锚定、纠正、智能、监控”(RAID)模型框架,旨在为不同风险等级的AI产品提供分级防御策略。
1. 数据锚定(Anchor):确立真实性的基准线
在每一代训练数据管线中,强制保留一定比例的真实人类数据作为“锚点”,是防止模型漂离现实世界的根本措施。
- 定义真实数据标准:必须明确何为“真实数据”,包括人类原创创作、经权威机构验证、具有长尾分布特征的内容。
- 设定硬杠杆比例:根据产品风险等级设定最低真实数据占比。对于高风险领域如医疗AI、法律AI,真实数据比例应不低于50%;对于通用对话或娱乐AI,可适度放宽至30%。
- 建立新鲜度机制:真实数据并非静态资源,需定期补充新用户生成内容(UGC)或权威数据许可,避免锚点因时过境迁而失效。
- 产品决策权衡:真实数据是稀缺且昂贵的资源。产品经理需在成本与质量之间做权衡,高风险场景宁可牺牲迭代速度,也要确保锚点的纯度与比例。
2. 纠正(Correct):嵌入自动化的反馈闭环
纠正机制旨在训练循环中嵌入质量评估与反馈修正环节,确保每一代模型在继承前代能力的同时,修复退化信号。
- 多维质量评估指标:建立包含输出多样性、长尾知识覆盖率、事实准确性的综合评估体系。
- 退化早期检测:对比每代模型输出与前代的分布差异,利用统计指标检测模式坍缩的早期信号。
- 自动化纠错触发:当退化指标超过预设阈值时,自动触发纠错流程,包括引入新鲜真实数据、调整合成数据生成策略或应用标记级编辑技术。
- 纠错频率优化:人类纠错以年为单位(如论文发表),而AI纠错可以以小时为单位。设计自动化纠错管线,减少人工干预延迟,是实现模型持续进化的关键。
3. 智能(Intelligent):数据源的透明化与溯源
对训练数据池中的AI生成内容进行识别和标记,建立全链路的数据来源可追溯体系,是防止“数据污染”的关键。
- 部署内容检测器:利用AI内容检测技术,对爬取或采购的数据进行AI生成概率评估。尽管目前检测准确率约为80-90%,存在误判风险,但作为辅助信号仍具重要价值。
- 建立来源标签体系:为每条数据打上来源标签(人类创作、AI生成、混合生成),便于后续的分层管理与分析。
- 污染预警机制:当数据池中AI生成内容占比超过特定阈值时,触发系统预警,提示产品经理介入审查。
- 全链路溯源:从数据采集、清洗、标注到模型训练,实现每一步骤的可追溯,确保数据污染的源头可查。
4. 监控(Monitor):分布特征的实时守护
分布监控是模型坍塌的“早期预警系统”,通过持续监控训练数据和模型输出的分布特征,防止长尾知识的消失。
- 训练数据分布监控:关注词汇多样性、主题覆盖度及长尾知识占比,确保数据池的结构均衡。
- 模型输出分布监控:实时监测输出的多样性指标、重复率及新颖性评分,及时发现模式坍缩迹象。
- 偏差告警与修复:当输出分布与目标分布偏差超过阈值时,自动告警并启动分布校正或数据增强机制。
- 可视化监控面板:为产品经理和工程师设计直观的实时分布监控面板,让数据健康度变得可见、可控。
场景化应用:分级防御与核心能力重塑
RAID模型并非一刀切的解决方案,而是需要根据应用场景进行差异化配置。
在医疗AI领域,由于涉及生命安全,必须采用最高级别的数据锚定(≥50%真实数据)、高精度检测以及实时分布监控。纠错频率需达到单次或高频自动触发,确保任何细微的偏差都能被立即修正。
在娱乐AI或内容生成场景下,对事实准确性的要求相对较低,可适当降低真实数据比例(30%左右),采用标准精度的检测手段,并将监控频次调整为每日或每周。这有助于在控制成本的同时,维持基本的智能水平。
结论:从模型参数到数据管线的范式转移
“AI吃AI会完蛋”是一个伪命题,它混淆了理论极值与现实工程约束。真正的风险不在于递归本身,而在于缺乏纠错机制的封闭递归。人类文明的递归成功证明了,有纠错机制的递归是进步引擎,而无纠错机制的递归才是退化螺旋。
对于AI产品经理而言,核心能力正在发生深刻变化。传统的模型参数调优和功能设计已不足以应对未来的挑战,数据管线质量管理和纠错机制设计成为新的核心竞争力。RAID模型提供了一套可落地的框架,帮助从业者在合成数据泛滥的时代,守住智能的底线。
此外,模型坍塌带来的最大产业机遇在于AI数据基础设施。真实数据资产管理、合成数据质量工程、人机协同验证平台——这些细分赛道将成为AI产品的新蓝海。未来,谁掌握了高质量数据管线的构建能力,谁就掌握了AI进化的方向盘。这不是技术的末日,而是数据治理新纪元的起点。