具身智能榜单乱象:当“第一”泛滥,我们该如何去伪存真?
在具身智能这一前沿科技赛道,资本的狂热与技术的稚嫩形成了鲜明对比。随着各大初创企业融资消息频传,一份份宣称“全球第一”的榜单也随之涌现。然而,当“第一”变得唾手可得,甚至出现同一榜单多家并列榜首的荒诞景象时,这些排行榜究竟是在衡量技术硬实力,还是在测试企业的讲故事能力?这已成为行业内外共同关注的焦点。
近期发生的千寻智能事件为这场信任危机敲响了警钟。其基座模型Spirit v1.6曾在RoboArena榜单上短暂超越英伟达相关模型,随后因评测数据存在大量来自关联账号的异常记录而被官方除名。这一事件并非孤例,而是揭示了当前具身智能评测体系中存在的深层结构性问题。在技术路线尚未收敛、真机部署成功率普遍徘徊在五六成的背景下,榜单成为了外界认知企业实力的主要窗口,但也因此成为了营销博弈的重灾区。
要厘清榜单的可信度,首先需要对现有的评测体系进行结构化梳理。目前的具身智能榜单大致可分为三类,各自承担不同的评估职能,且互不可替代。第一类是VLA(视觉-语言-动作)操作综合榜,如RoboChallenge Table30和MolmoSpaces,这类榜单侧重于考察机器人在真实或高保真仿真环境中执行具体任务的成功率,是检验“手脚利索程度”的关键指标。第二类是世界模型榜,以World Arena和WorldModelBench为代表,主要评估模型对物理世界规律的理解与推演能力,即“大脑”的逻辑严密性,而不直接涉及机械执行。第三类则是专项基准榜,如RoboTwin 2.0、LIBERO等,旨在通过极端场景或特定任务(如双臂协同、仿真到真机迁移)来暴露模型的短板。
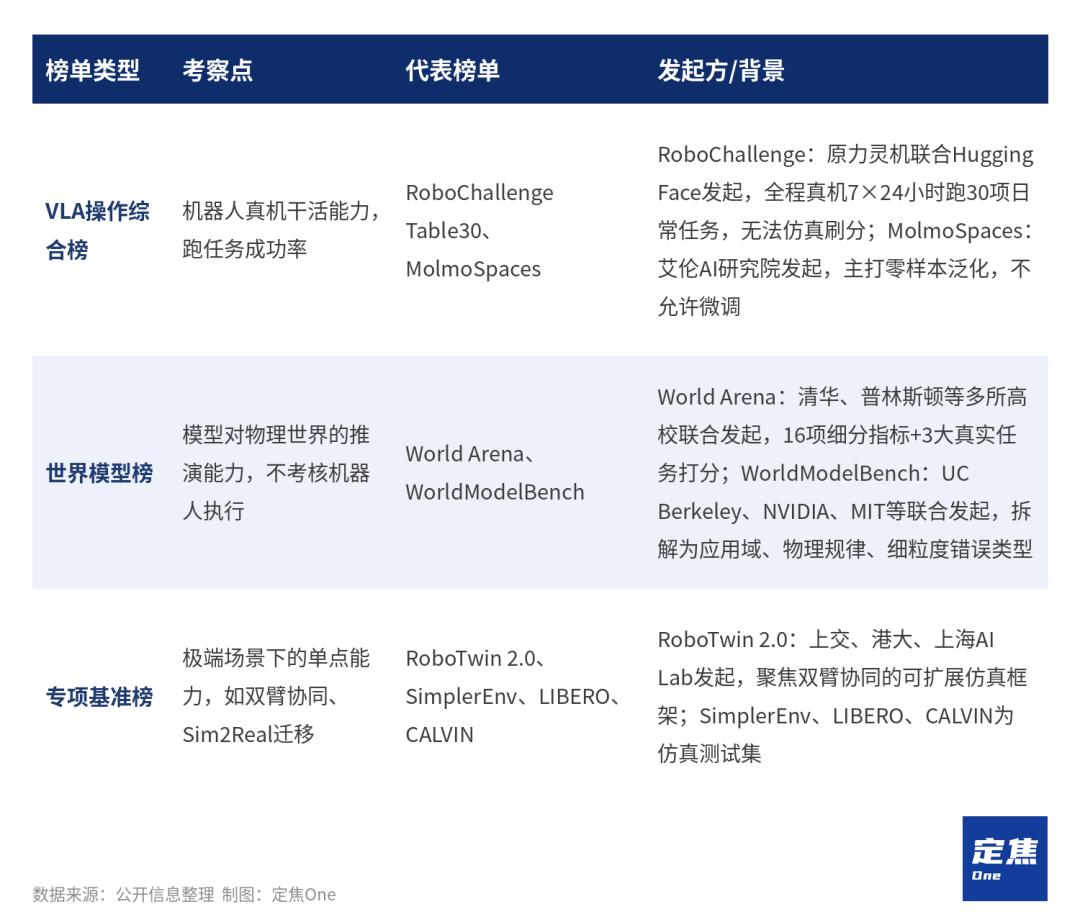
然而,正是这种多维度的评测体系,为“选择性展示”提供了操作空间。近半年来,星动纪元、智元、跨维等头部企业纷纷宣布在不同细分榜单中夺冠。这种现象部分源于物理世界的固有随机性。与大语言模型在固定题库中得分稳定不同,具身智能受光照、物体位置、机械公差等变量影响极大,同一模型多次运行结果可能存在显著波动。此外,部分榜单任务分布公开,使得企业可以通过针对性采集数据和微调模型来实现“定向优化”,导致榜首更迭频率远高于传统AI领域,有时甚至以周为单位变化。
更为隐蔽的问题在于“第一”定义的模糊化。以World Arena为例,不同企业在不同子赛道(如感知响应与数据引擎)分别取得领先,但在对外宣传时往往省略限定词,统称为“登顶World Arena”。这种信息不对称使得非专业受众难以分辨技术细节,容易将局部优势误解为整体领先。同时,商业媒体榜与学术基准榜的界限日益模糊,部分缺乏透明评测标准的“产业榜”与严谨的真机测试榜混为一谈,进一步加剧了排名的通货膨胀。
深入探究“第一”的生产机制,可以发现行业内已形成一套成熟的运作逻辑。最基础的手段是话术包装,通过将“单项第一”扩大为“综合第一”,利用信息差提升品牌声量。进阶手段则是利用评测机制漏洞进行“刷题”。由于部分榜单允许针对公开任务进行训练,企业可以通过过拟合特定场景来获取高分。更极端的案例则涉及操纵评测过程,如利用开放注册机制,通过多个关联账号集中评测自家模型,同时避免与强劲对手交手,从而人为抬高Elo评分。千寻智能事件中,72%的评测数据来自两个特定账号,正是此类操作的典型体现。
除了技术手段,资源置换也是榜单乱象的重要推手。部分媒体或咨询机构与企业存在商务合作,通过联合发布报告的方式,将商业利益包裹在“权威评测”的外衣下。这种非技术性的排名生成方式,不仅扭曲了市场竞争秩序,也误导了依赖榜单进行决策的投资机构,尤其是那些对技术细节缺乏深入了解的地方引导基金或国资背景资金。
面对如此复杂的局面,从业者和投资者应如何建立有效的筛选机制?首先,必须摒弃对单一总分排名的迷信,转而关注评测数据的细粒度透明度。一个可信的榜单应当详细披露各项子任务的得分情况,展示模型的优势与短板,而非仅提供一个笼统的综合分数。例如,RoboChallenge之所以具有较高参考价值,在于其公开了30项具体任务的逐项成功率,使得观察者能够评估模型的泛化能力而非记忆能力。
其次,评测主体的独立性与反作弊机制至关重要。理想的榜单应由无利益关联的第三方机构运营,并采用“裸考”模式,禁止针对测试集进行微调。同时,引入环境扰动、随机化参数等抗干扰设计,增加“刷题”成本,确保高分反映的是真实的泛化性能而非过拟合结果。MolmoSpaces和LIBERO-Plus在这方面的设计值得借鉴,它们通过增加测试难度和不确定性,有效筛选出具备真正鲁棒性的模型。
最后,需理性看待榜单的更新频率与评测机制之间的关系。更新快并不必然意味着水分大,关键在于其背后的动态排名算法是否严密。相反,更新慢的榜单若因真机评测成本高而显得稀缺,其数据往往更具说服力。物理世界的测试需要耗费大量时间与资源,这种成本约束本身就是一种天然的防伪屏障。
当前,具身智能行业仍处于早期阶段,出货量与营收尚不稳定,榜单成为企业获取关注和融资的重要工具。这种“榜单焦虑”本质上是资本对技术不确定性的一种补偿心理。然而,随着行业逐步走向成熟,评判标准必将回归商业本质:交付数量、客户复购率以及盈利能力。届时,那些依靠营销包装获得的虚名将迅速褪色,而真正致力于解决物理世界难题、实现规模化落地的企业,将在去泡沫化的过程中脱颖而出。
对于观察者而言,理解榜单背后的生成逻辑比关注排名本身更为重要。在技术路线未定、标准缺失的窗口期,保持批判性思维,穿透营销话术,聚焦于模型的泛化能力、鲁棒性以及实际应用场景的匹配度,才是把握具身智能发展脉络的正确姿势。毕竟,机器人最终是要走进工厂和家庭干活的,而不是活在排行榜的数字游戏里。