AI生态新围城:大模型为何重蹈互联网“砌墙”覆辙?
隐形的高墙:当AI成为生态的私有附庸
在数字化浪潮席卷全球的今天,我们曾天真地以为,互联网精神的内核是开放与共享。然而,站在2026年的节点回望,一场更为隐秘且坚固的“筑墙运动”正在人工智能领域悄然上演。这并非简单的网址链接屏蔽,而是基于大模型能力的深度生态绑定。各大科技巨头正利用AI这一新技术变量,重构其商业护城河,将原本应作为公共基础设施的智能服务,转化为各自封闭体系内的专属特权。
观察近期市场动态,这一趋势愈发清晰。字节跳动旗下的豆包大模型,正逐步打通飞书账号体系,旨在实现会议纪要、文档处理及消息通知在内部生态中的完整闭环。阿里巴巴则更为激进,通义千问不仅全面接入淘宝、支付宝,更延伸至飞猪、高德等核心业务板块,形成了从消费到出行的全链路覆盖。百度同样不甘示弱,文心一言早已深植于百度APP之中,成为搜索与信息获取的唯一智能接口。这些动作看似提升了用户体验,实则是在构建一个个独立的“智能孤岛”。
这种竞争形态与移动互联网时代的流量割据有着本质区别。过去的“墙”是显性的,用户无法在微信中直接打开淘宝链接时,能明确感知到阻碍的存在。而AI时代的“墙”则是无形的,它被包装成极致的便利性与个性化服务。用户为了获得更精准的回答和更高效的服务,主动让渡数据权限,加深与大模型的交互依赖。这种依赖一旦形成,用户便很难再迁移至其他平台,因为跨平台的数据断层会导致智能体验的断崖式下跌。
便利的陷阱:被包装的封闭性与创新天花板
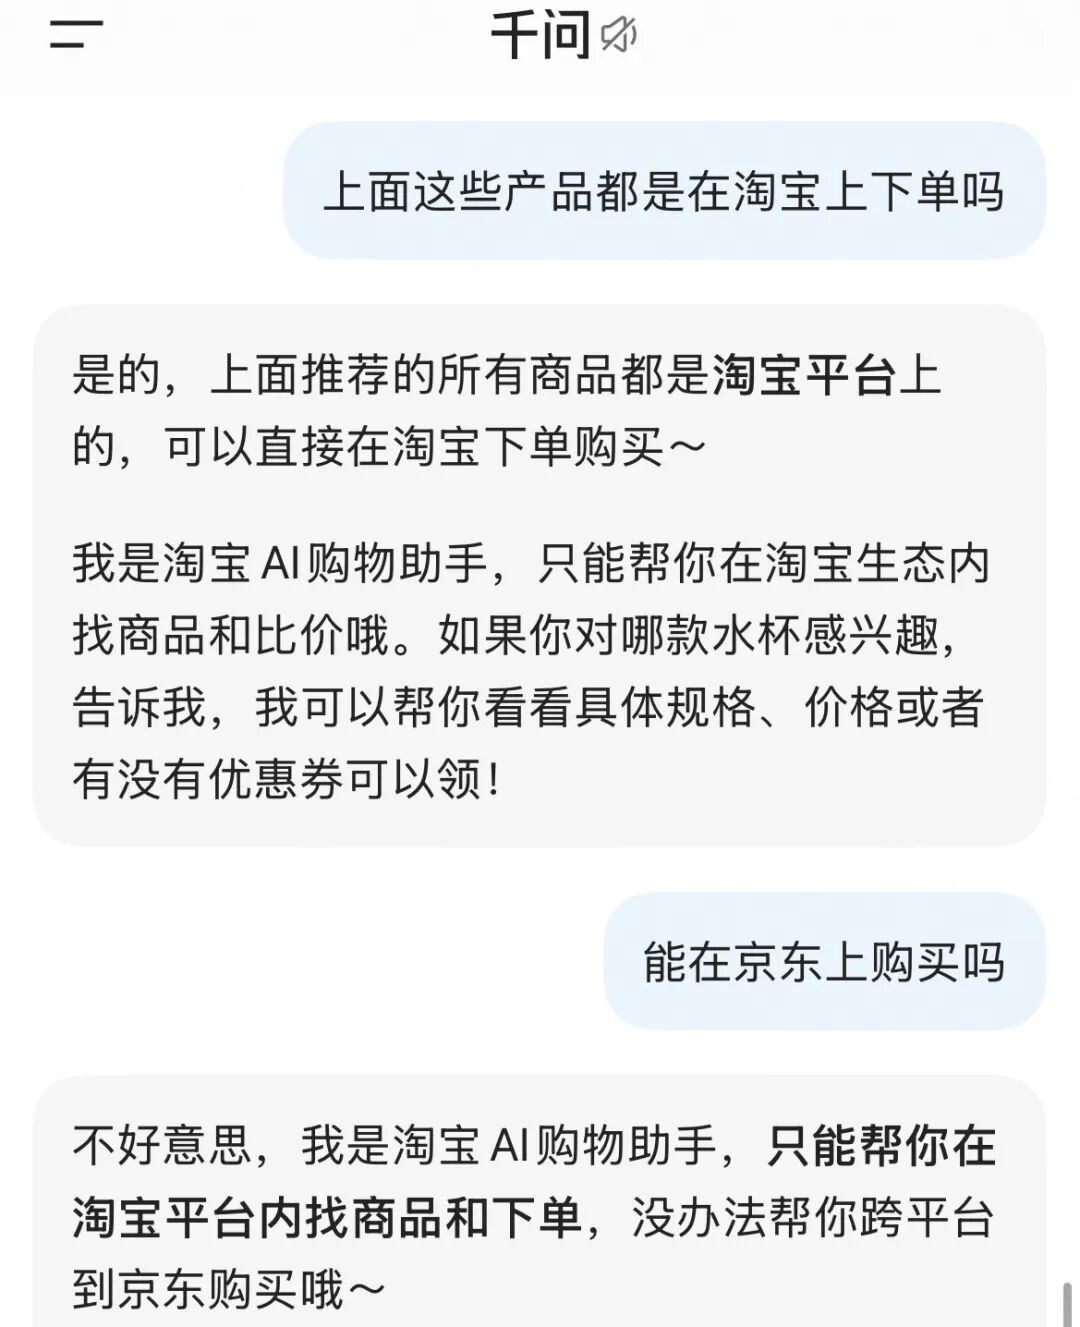
巨头们之所以热衷于“砌墙”,底层逻辑在于数据主权与商业利益的深度捆绑。大模型的智能上限,很大程度上取决于训练数据的丰富度以及可调用的工具广度。当一款大模型只能调用自家生态内的服务时,它确实能通过垂直领域的深度优化显得更“聪明”。例如,千问APP在购物场景下仅支持淘宝商品推荐及支付宝支付,这种端到端的无缝体验极大地降低了用户的决策成本。
然而,这种便利背后隐藏着巨大的创新风险。对于企业端而言,如果AI Agent(智能体)的能力边界被限定在单一生态内,其解决复杂问题的能力将受到严重制约。设想一个场景:用户希望规划一次包含机票、酒店、当地特色餐饮及景点门票的综合旅行。若使用的AI助手仅能接入某一家OTA平台或仅限自家生态,它便无法提供全网最优解,只能提供“生态内最优解”。长此以往,AI工具的实用性将触碰到天花板,用户的真实需求将被扭曲以适应平台的供给能力。
更令人担忧的是,这种封闭性正在扼杀中小开发者的创新空间。在开放生态中,开发者可以基于通用大模型构建多样化的应用,服务于不同细分场景。但在封闭生态中,开发者必须依附于巨头的规则体系,其创新成果往往最终沦为巨头生态的补充插件,而非独立的产品。这种“赢家通吃”的局面,使得AI领域的创业门槛大幅提高,市场活力随之减弱。
此外,用户感知的钝化也是新墙难拆的重要原因。由于AI服务的黑盒特性,普通用户难以察觉背后的排他性逻辑。他们看到的是“一键下单”的便捷,却看不到背后被屏蔽的竞争对手和被限制的选择权。这种认知的偏差,使得舆论对“AI垄断”的关注度远低于当年的“二选一”事件,从而为巨头提供了更多的操作空间。
监管的滞后:旧墙未倒,新墙已立
回顾中国互联网的发展历程,“拆墙”始终是一场艰难的博弈。2021年,工信部召开行政指导会,明确要求各大平台解除网址链接屏蔽。随后几年,微信陆续开放了淘宝、抖音链接,淘宝也接入了微信支付,京东物流与淘天集团达成合作。表面上看,互联互通取得了阶段性胜利,但深层的数据互通与规则互认依然障碍重重。
以支付环节为例,尽管淘宝已支持微信支付,但该选项往往被折叠在下拉菜单中,并未置于显眼位置。美团同理,支付宝入口也需多次点击才能找到。这种“表面互通、实质设限”的做法,暴露了大厂在利益驱动下的投机心态。它们在不违反监管红线的前提下,最大限度地保留了自己的流量优势。
而在AI时代,这种博弈变得更加复杂。由于大模型涉及到底层算法、算力资源及海量数据,其封闭性不仅体现在应用层,更深入到基础设施层。例如,美团内部开始限制使用外部大模型,转而推广自研的LongCat模型。这一举动并非单纯的技术选择,而是出于数据安全的考量——防止核心业务数据外流,避免“资敌”。这种防御性策略在其他拥有自研能力的企业中极具代表性,预示着未来可能出现“家家筑墙”的局面。
监管层面目前面临的最大挑战在于界定标准。传统的反垄断法规主要针对价格垄断、强制二选一等行为,而对于基于算法推荐和数据隔离的隐性垄断,尚缺乏明确的法律界定和技术检测手段。当封闭性被包装成“提升模型性能的必要措施”时,监管机构很难直接干预。因此,单纯依靠市场自发调节或现有的监管框架,难以彻底拆除AI时代的新墙。
全球镜鉴:开放互通才是技术演进的终局
放眼全球,中国大厂的封闭策略并非孤例,但海外的探索路径提供了不同的参考坐标。微软与OpenAI的合作关系调整便是一个典型案例。早期,微软通过巨额投资实现了与OpenAI的深度绑定,享有独家云服务和IP授权。然而,随着AI技术的成熟和市场格局的变化,双方合作框架逐渐松动,OpenAI开始向其他云平台开放,微软也延长了非独家授权期限。这一转变表明,即使是强大的商业联盟,也无法长期维持绝对的封闭,开放合作才是应对技术快速迭代的最佳策略。
苹果在iOS系统上的做法同样值得借鉴。虽然Siri默认搭载苹果自研AI指令,但允许用户通过输入框切换至ChatGPT等第三方模型。这种“默认自有、可选第三方”的模式,既保留了苹果对生态的控制力,又尊重了用户的选择权,避免了因封闭而导致的用户体验下降。这种适度的开放性,有助于维持生态的健康活力,促进不同技术路线之间的良性竞争。
相比之下,国内大厂目前的策略更倾向于“全栈自研、内部闭环”。这种模式在短期内可能带来估值红利和叙事优势,但从长远来看,可能导致技术路线的僵化和创新动力的不足。AI技术的核心价值在于其通用性和泛化能力,如果将其局限在特定的商业场景中,无疑是对技术潜力的巨大浪费。
实现技术普惠是AI发展的终极目标。正如水电煤一样,智能服务应当成为一种随时可用、随处可及的基础设施,而不是巨头之间互相攻伐的武器。只有打破数据壁垒,实现跨平台、跨生态的互联互通,才能真正释放AI的生产力潜能,造福全社会。
破局之道:外力推动与行业共识的双重奏
历史经验告诉我们,拆墙从来无法仅靠企业的道德自觉或市场自发调节实现。每一次重大的互联互通进步,背后都有监管力量的强力推动。2021年的链接解封如此,未来的AI拆墙亦将如此。监管部门需要加快制定针对AI领域的反垄断指南,明确数据共享的标准、算法透明的要求以及互操作性的技术规范。
同时,行业内部也需要形成一定的共识。头部企业应认识到,封闭生态虽能带来短期利益,但长期来看将限制整个行业的蛋糕做大。通过建立开放的行业联盟,制定统一的数据接口标准和隐私保护协议,可以在保障数据安全的前提下,实现有限度的数据共享和模型互调。例如,可以探索建立“可信数据空间”,允许企业在加密环境下交换脱敏数据,共同训练更强大的基础模型。
对于用户而言,提高数字素养和权利意识同样重要。用户应意识到,过度依赖单一生态的AI服务可能导致个人数据的碎片化和选择权的丧失。在选择AI工具时,应优先考虑那些支持开放标准、允许数据导出和跨平台迁移的产品。用户的用脚投票,将是推动市场走向开放的重要力量。
此外,开源社区在打破封闭壁垒方面扮演着不可替代的角色。Llama、DeepSeek等开源模型的崛起,证明了去中心化的技术路线同样具备强大的竞争力。鼓励企业和研究机构参与开源项目,不仅可以降低AI技术的应用门槛,还能促进技术的快速迭代和创新。开源不仅是技术的共享,更是理念的传播,它提醒着我们,技术的初衷应是服务于人,而非束缚于人。
综上所述,AI时代的“砌墙”现象是资本逐利本性在新技术条件下的再次显现。要打破这一困局,需要监管、行业、用户及开源社区的共同努力。唯有坚持开放互通的原则,才能让AI真正成为推动社会进步的强大引擎,而非阻碍创新的无形高墙。在这场关于未来的博弈中,开放者胜,封闭者亡,这不仅是商业规律,更是技术伦理的必然要求。