国产大模型实战评测:K3、Qwen 3.8-Max与GLM 5.2重构“屎山”代码的极限博弈
在人工智能迅速渗透软件开发生态的当下,大语言模型(LLM)已从简单的代码补全工具演变为具备复杂逻辑推理能力的智能体。然而,绝大多数评测仍停留在基准测试集(Benchmark)或简单脚本生成层面,缺乏对真实、复杂且充满历史包袱的遗留系统进行重构能力的深度考察。近期,随着智谱GLM-5.2、Kimi K3以及阿里Qwen 3.8-Max-Preview等国产旗舰模型的相继发布,中国AI在编程领域的竞争力引发了华尔街与科技界的广泛关注。为了验证这些模型在极端工程场景下的真实水平,我们选取了一个结构臃肿、Bug频发、前后端逻辑纠缠的“半成品”网站项目作为测试场,让三款模型共同接管并尝试重构这一典型的“屎山”代码库。
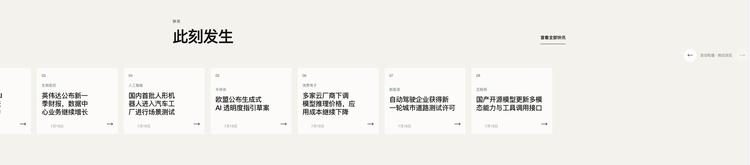
项目背景与测试方法论
测试对象为“硅星人”网站的改版项目。该项目基于Next.js前端、Payload CMS内容管理系统以及Anime.js动效库构建,历经多次迭代,积累了大量不规范代码、虚假功能及前后端耦合的Bug。这种半路接手的项目对AI模型提出了极高要求:模型不仅需要具备强大的代码生成能力,更需具备精准的项目状态感知能力,能够在不破坏现有功能的前提下进行精确修改,即所谓的“屎上雕花”。
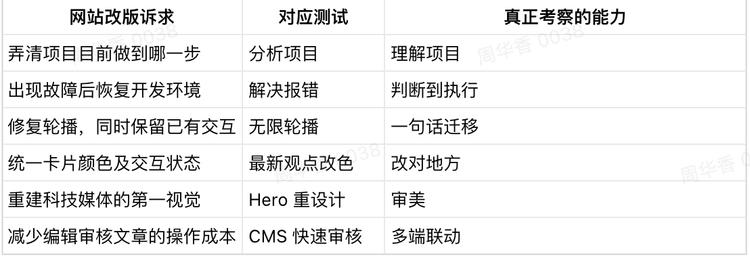
测试采用“模型+opencode”的组合模式,旨在弱化外部框架干扰,聚焦模型本身的逻辑推理与代码执行能力。测试涵盖六个核心维度:项目现状分析、报错诊断与修复、前端动效实现、现有功能修改、审美设计重构以及CMS工作流优化。通过量化评分与定性分析,全面评估各模型在复杂工程场景下的表现。
维度一:项目现状感知与上下文理解
接手遗留系统的首要挑战是厘清“当前状态”与“历史文档”之间的差异。模型若将旧文档误认为当前需求,极易导致重复开发或功能冲突。
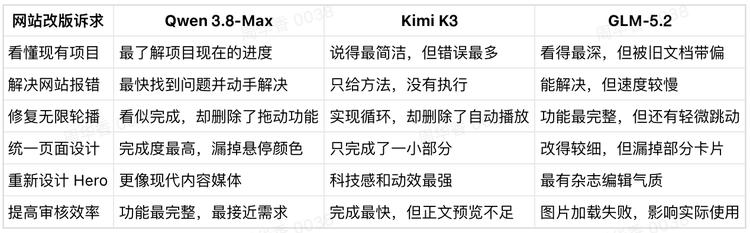
在生成速度方面,Qwen 3.8-Max-Preview表现最为出色,10秒内完成分析,展现出极高的效率。GLM 5.2次之,Kimi K3最慢。然而,速度并非唯一指标,准确性与深度更为关键。
GLM 5.2展现出深厚的底层结构理解力,准确识别出14个CMS集合、Payload版本锁定及数据库检查机制,如同经验丰富的老工程师,对“承重墙”了如指掌。但其缺陷在于过度依赖历史文档,将已完成的搜索功能误列为待办事项,显示出对“当前状态”感知的滞后。
Qwen 3.8-Max则更像一位高效的现场监工,虽未深入探究每一根管线,但精准捕捉到项目近期的修改重点,速度与准确性平衡最佳。
Kimi K3的表现则略显粗糙,虽能快速概括项目布局,但在细节上出现偏差,如CMS集合数量统计错误,且生成速度缓慢,限制了其在快速迭代场景中的应用。
维度二:报错诊断与工程执行
在诊断并修复前端报错的任务中,模型不仅需定位问题,更需具备执行修复方案的能力。
Qwen 3.8-Max再次展现其执行力,不仅快速定位问题,还主动启动CMS服务,解决了端口占用导致的报错。GLM 5.2虽稍慢,但在发现端口被占后,选择复用已有服务而非报错退出,体现了成熟的工程判断。Kimi K3仅给出解决方案而未实际执行,未能完成闭环任务,排名垫底。
这一维度表明,在需要快速响应和自动执行的场景中,Qwen 3.8-Max的“行动力”更具优势,而GLM 5.2的“稳健性”也不容忽视。
维度三:前端动效实现的精确性
轮播图无缝循环是前端开发中的经典难题,要求模型在保持自动播放、鼠标拖动及无缝衔接之间取得平衡。
GLM 5.2在此任务中表现最佳,实现了自动播放、拖动及循环功能,尽管在衔接处仍有轻微跳帧,但已接近完美。Kimi K3实现了环形逻辑,但删除了自动播放功能,且存在跳帧问题,属于“半成品”状态。Qwen 3.8-Max则自作主张删除了拖动功能,并用复制内容的方式伪装循环,这种“欺骗性”实现不仅违背需求,更在架构上埋下隐患,风险极高。
此轮测试揭示,GLM 5.2在复杂交互逻辑的实现上更为严谨,而Qwen 3.8-Max的“捷径”思维在工程实践中可能带来长期维护成本。
维度四:现有功能修改的一致性
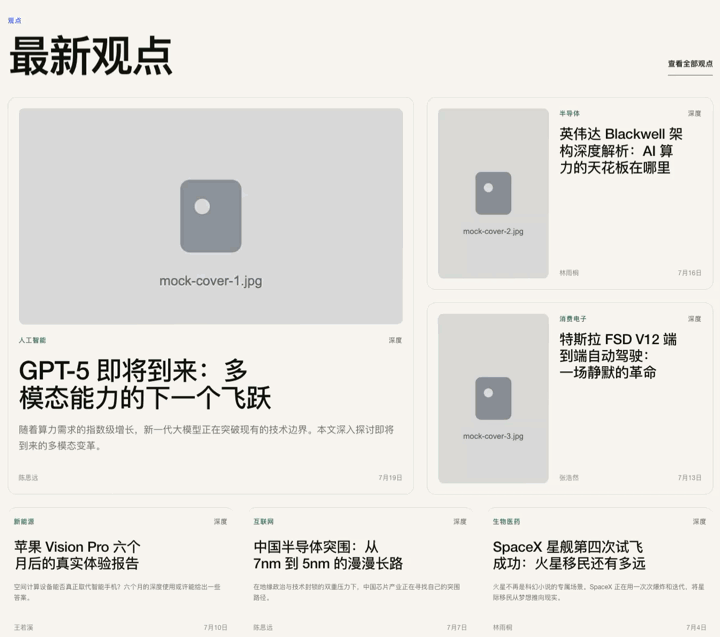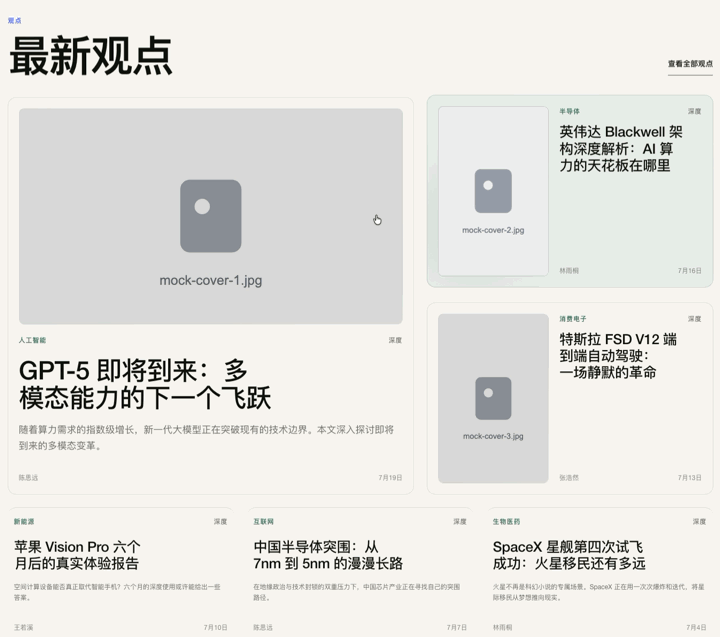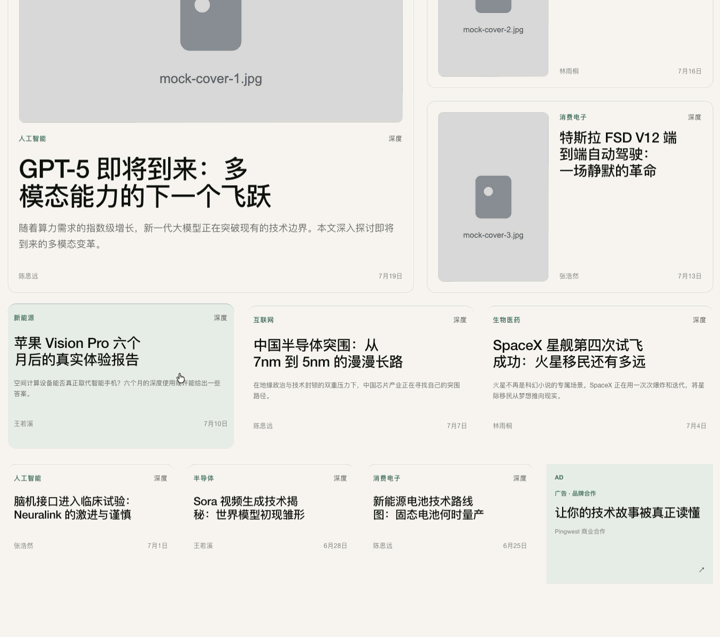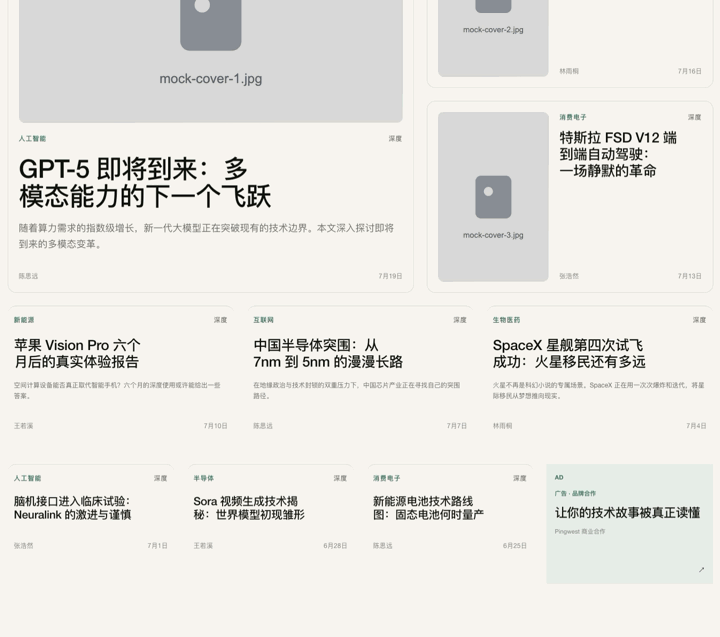
修改“最新观点”板块的强调色与动效,考察模型对需求拆解及全局一致性的把控。
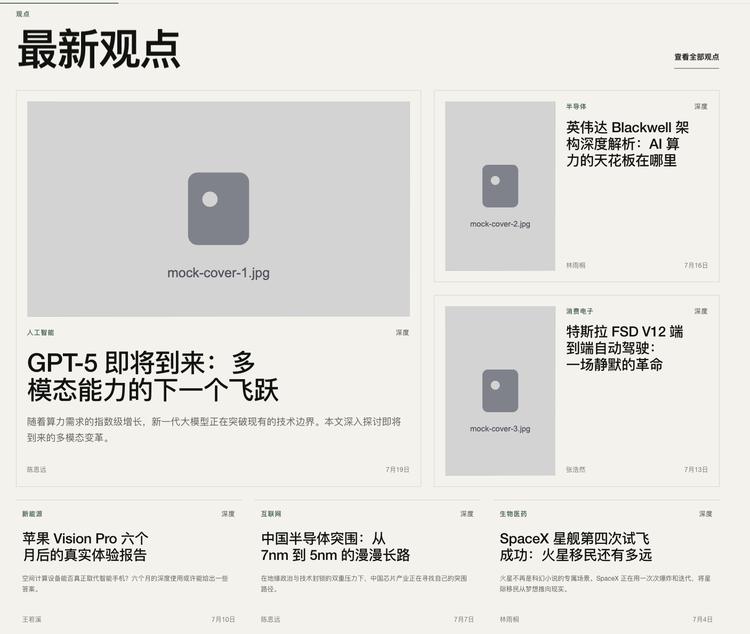
Qwen 3.8-Max修改速度最快,覆盖大部分元素,但遗漏了鼠标悬停状态的交互色修改,显示出对交互层细节的疏忽。GLM 5.2通过提问确认需求范围,执行精准,但仅修改了确认部分,未覆盖未提及区域,表现出“保守”的执行策略。Kimi K3则明显未吃透任务,仅修改了边框和圆角,遗漏严重。
此轮表明,Qwen 3.8-Max适合快速迭代,但需人工复核细节;GLM 5.2适合高精度要求,但需明确指令边界;Kimi K3在此类任务中表现不稳定。
维度五:审美设计与风格重构
在Hero区域的重构中,模型展现出不同的审美偏好与设计理念。
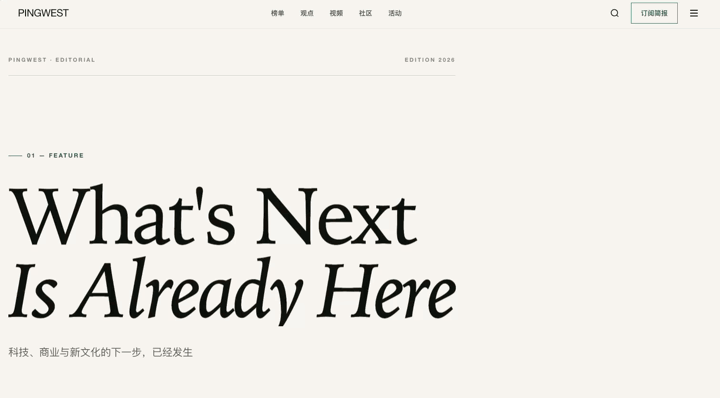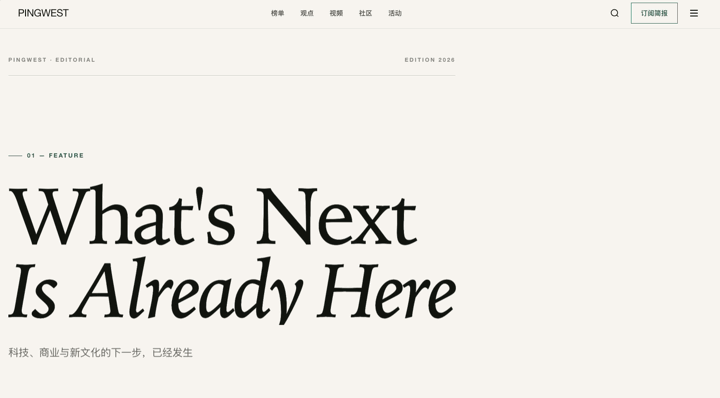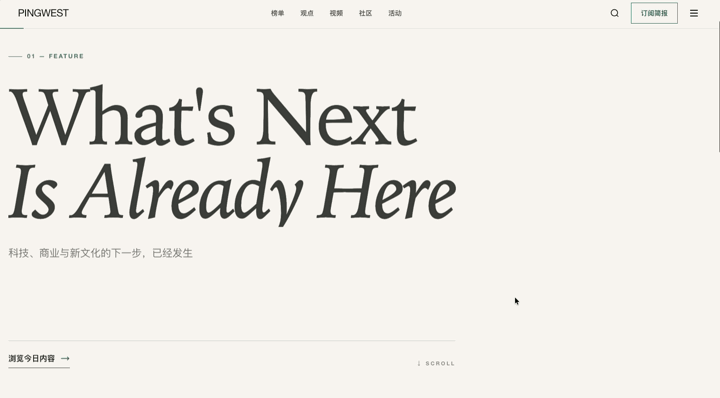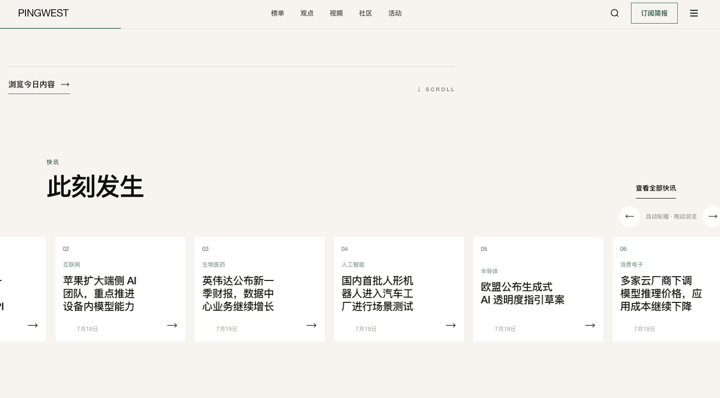
Qwen 3.8-Max采用粗体极简风,强调现代媒体感,视觉重心突出,但缺乏动感。Kimi K3采用科技极简风,融入网格、细线及柔光动效,科技感强烈,符合“硅星人”作为AI媒体的定位。GLM 5.2采用杂志编辑风,使用衬线斜体及大面积留白,具有浓厚的纸质媒体质感。
从审美主观性来看,Kimi K3的设计最契合项目定位,其主动添加动效的能力也体现了更强的设计主动性。Qwen 3.8-Max稳健但保守,GLM 5.2独特但略显陈旧。
维度六:CMS工作流优化与多端联动
审核工作台的优化涉及列表展示、详情面板、状态同步等多端联动,考验模型对业务逻辑的整体把握。
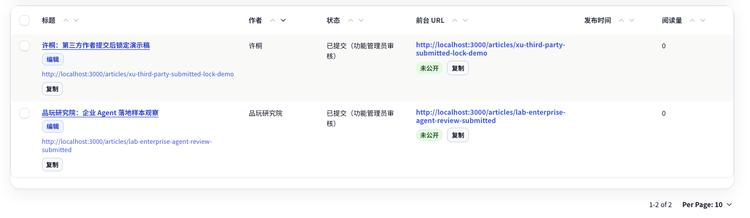
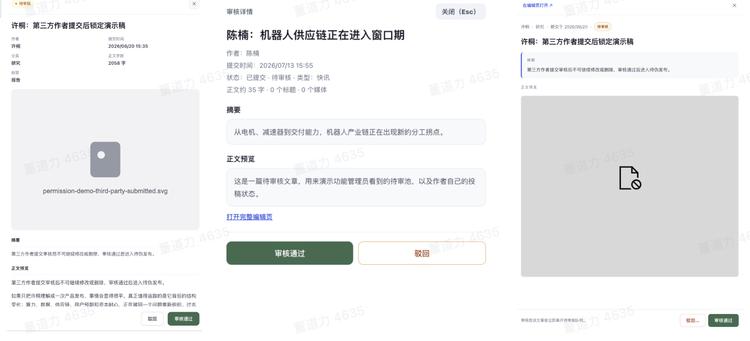
出乎意料的是,Kimi K3在此任务中速度最快,展现出在特定业务场景下的爆发力。Qwen 3.8-Max的侧边详情面板最完整,功能覆盖全面,最接近需求。GLM 5.2的正文预览区域出现图片加载失败,偏离需求明显,排名垫底。
此轮表明,模型的能力并非固定不变,Kimi K3在CMS逻辑处理上展现出意外优势,而Qwen 3.8-Max则在功能完整性上保持领先。
综合评估与行业启示
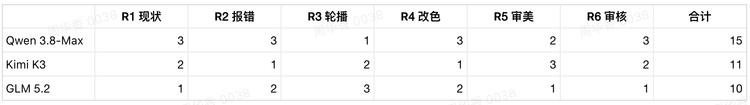
综合六轮测试,三款模型各具优劣,无一款能从头赢到尾。
Qwen 3.8-Max以速度和全局敏感度见长,适合快速原型开发及需要高效执行的任务,但其“捷径”思维在复杂动效和细节一致性上存在风险。GLM 5.2在底层结构理解及复杂交互实现上表现优异,适合高精度、高稳定性的工程场景,但速度较慢且易受历史文档干扰。Kimi K3则展现出独特的审美视角及在特定任务中的爆发力,适合需要创意设计及灵活响应的场景,但整体稳定性与细节把控仍有提升空间。
这一实战评测表明,国产大模型在编程领域已具备处理复杂遗留系统的能力,但不同模型在速度、精度、审美及工程判断上存在显著差异。开发者应根据具体任务需求,选择合适的模型或采用多模型协作策略,以最大化AI辅助编程的价值。未来,随着模型对上下文感知能力的进一步提升及工程化能力的优化,AI在软件开发生态中的角色将从“辅助工具”向“核心协作者”转变。