Gemini 3.6 Flash口碑崩盘:谷歌AI战略失误与版本跳票深度解析
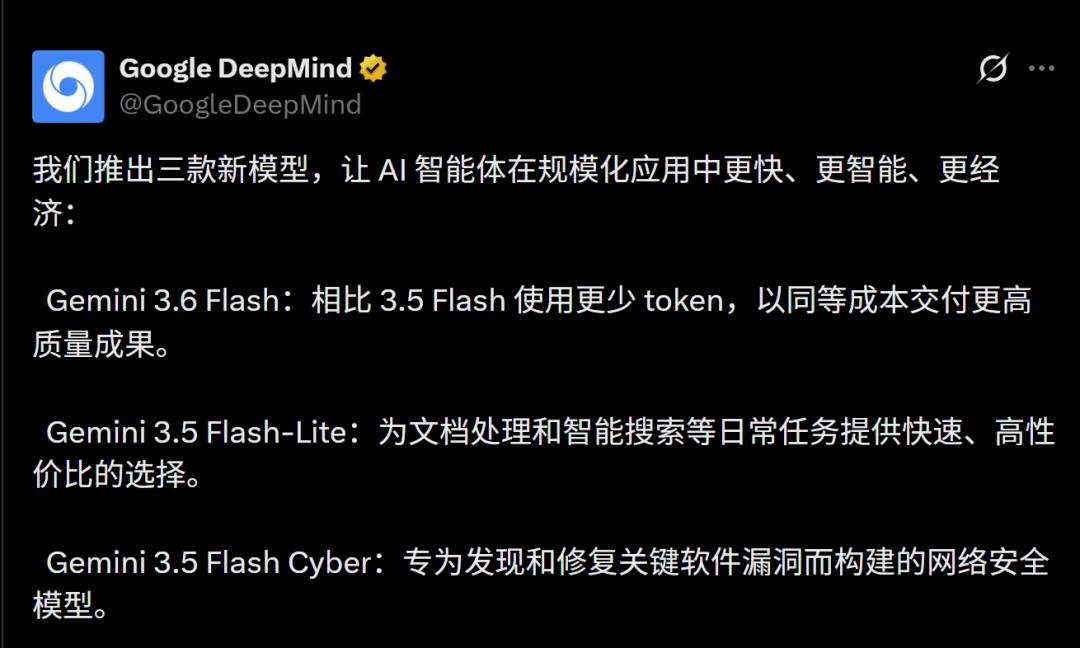
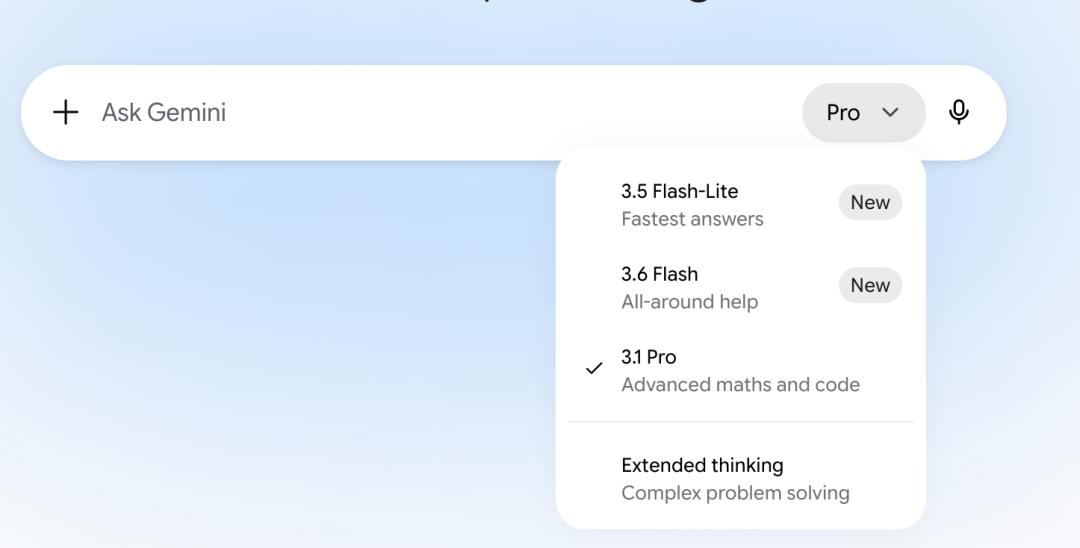
在人工智能技术迭代日益加速的今天,每一次头部科技公司的模型更新都牵动着全球开发者的神经。然而,谷歌DeepMind近期推出的Gemini 3.6系列模型,却意外地引发了一场关于产品质量与发布策略的激烈争议。原本备受期待的Gemini 3.5 Pro正式版迟迟未至,取而代之的是Gemini 3.6 Flash、3.5 Flash-Lite以及3.5 Flash Cyber三款“阉割版”或垂直领域模型。其中,主打轻量级应用的Gemini 3.6 Flash在上线后迅速遭遇口碑滑铁卢,被部分早期测试用户严厉批评为“史上最差”的AI模型。这一现象不仅暴露了单一模型在特定任务上的能力短板,更折射出谷歌在激烈的AGI竞赛中可能存在的战略焦虑与执行偏差。
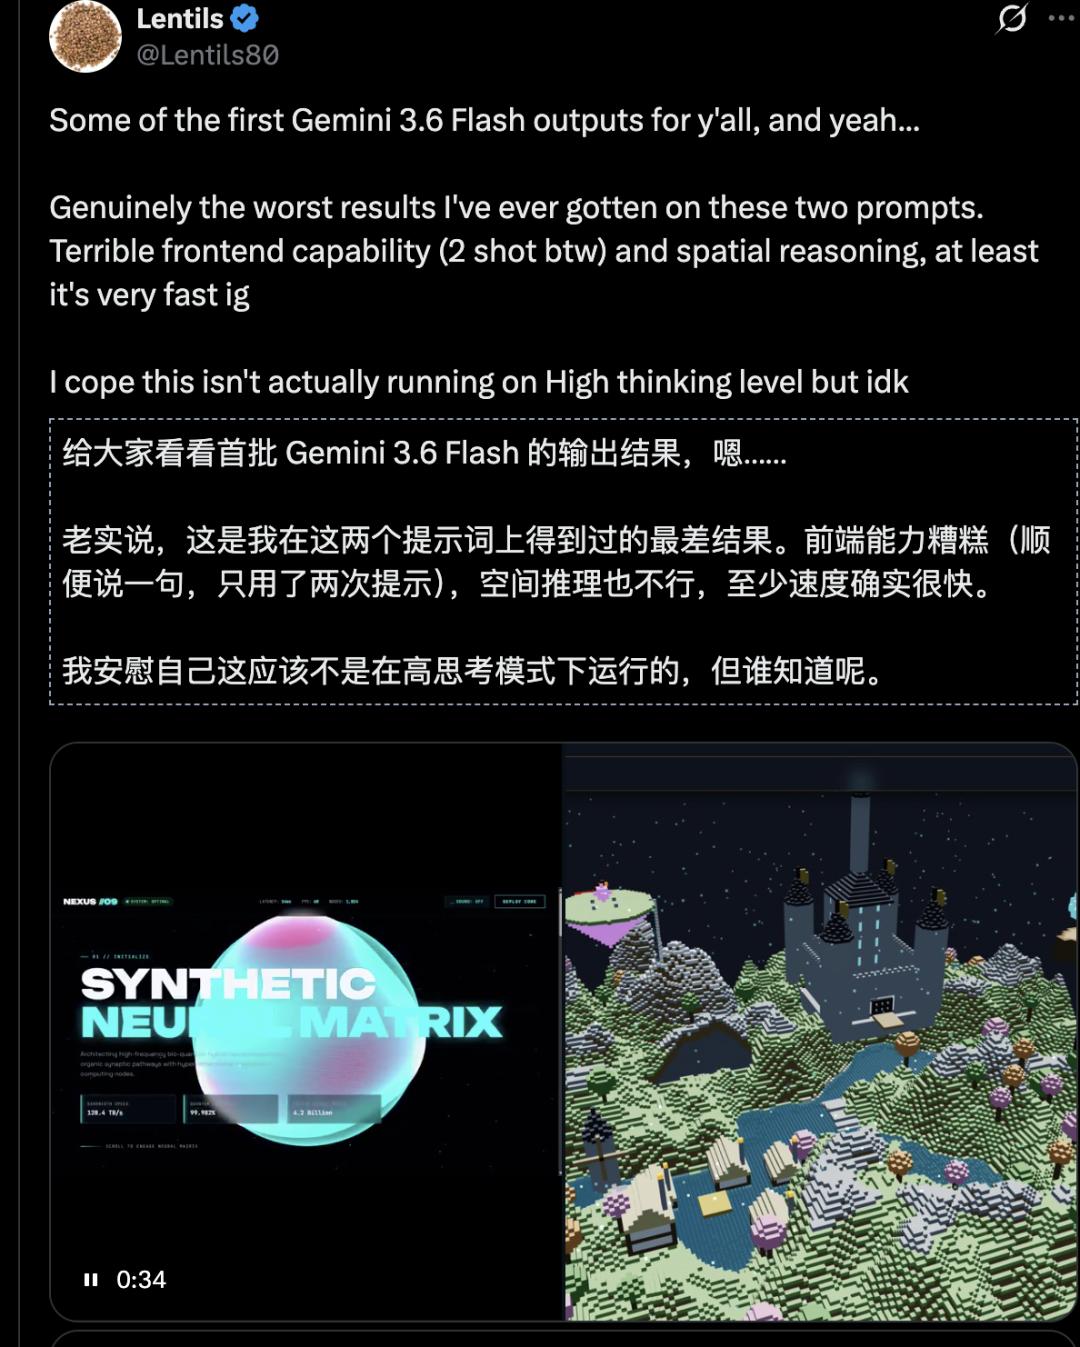
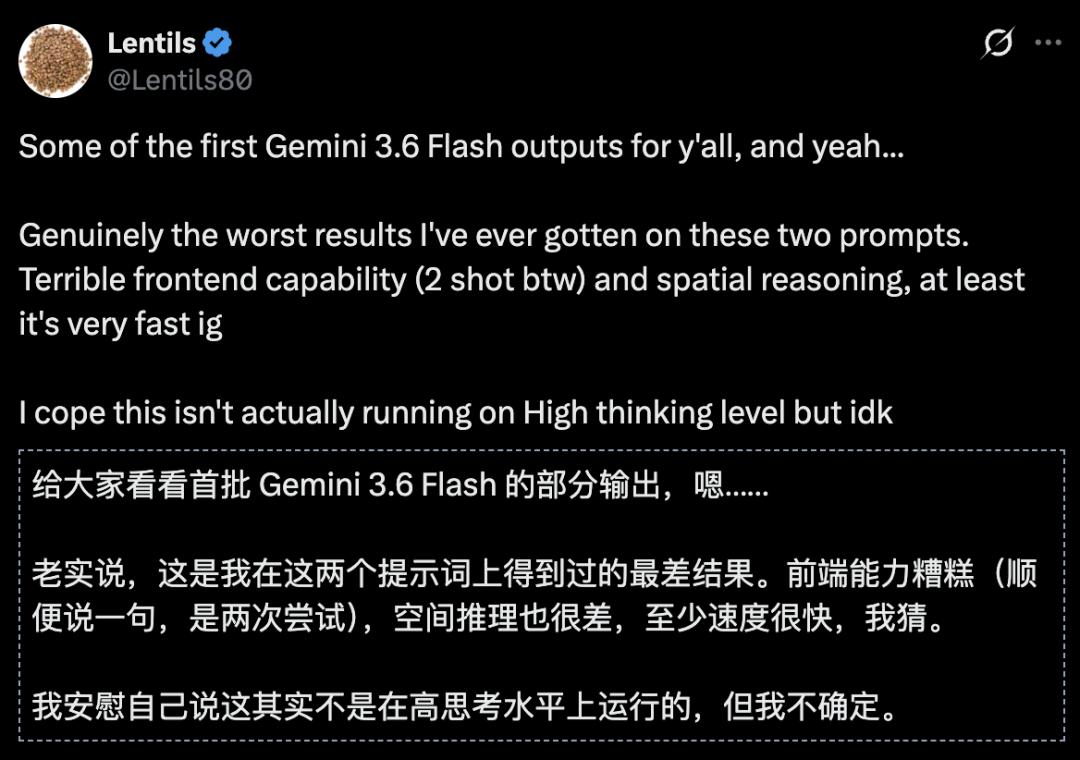
从技术实测的角度来看,Gemini 3.6 Flash的表现确实令人失望,尤其是在其宣称擅长的前端界面生成与空间推理领域。前端开发是近年来大语言模型应用落地的重要场景之一,开发者期望通过自然语言描述快速生成可用的UI代码。然而,在针对Gemini 3.6 Flash进行的2-shot测试中,模型输出的代码呈现出逻辑错乱、组件嵌套混乱以及交互逻辑断裂等严重问题。这种低质量的输出完全无法直接投入实际生产环境,甚至需要开发者花费比从头编写更多的时间去修复错误。相比之下,同期的Claude Fable 5、GPT-5.6 Sol以及Meta的Muse Spark 1.1等竞品模型,在相同测试条件下均能生成结构清晰、逻辑连贯的代码。这种巨大的体验落差,使得“这是我真正见过的最差结果”成为开发者社区中广泛传播的评价。
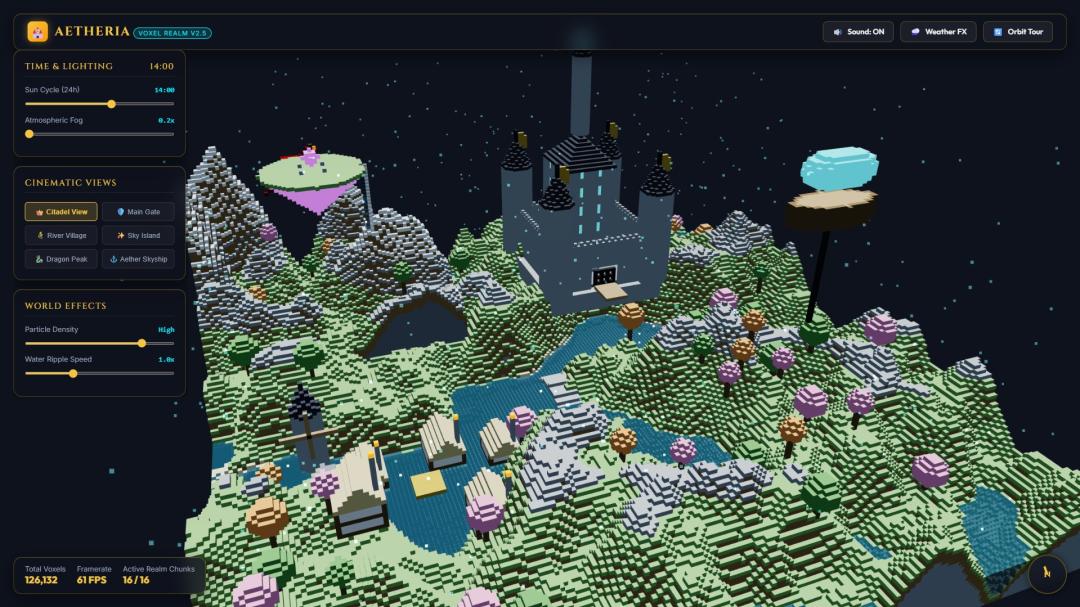
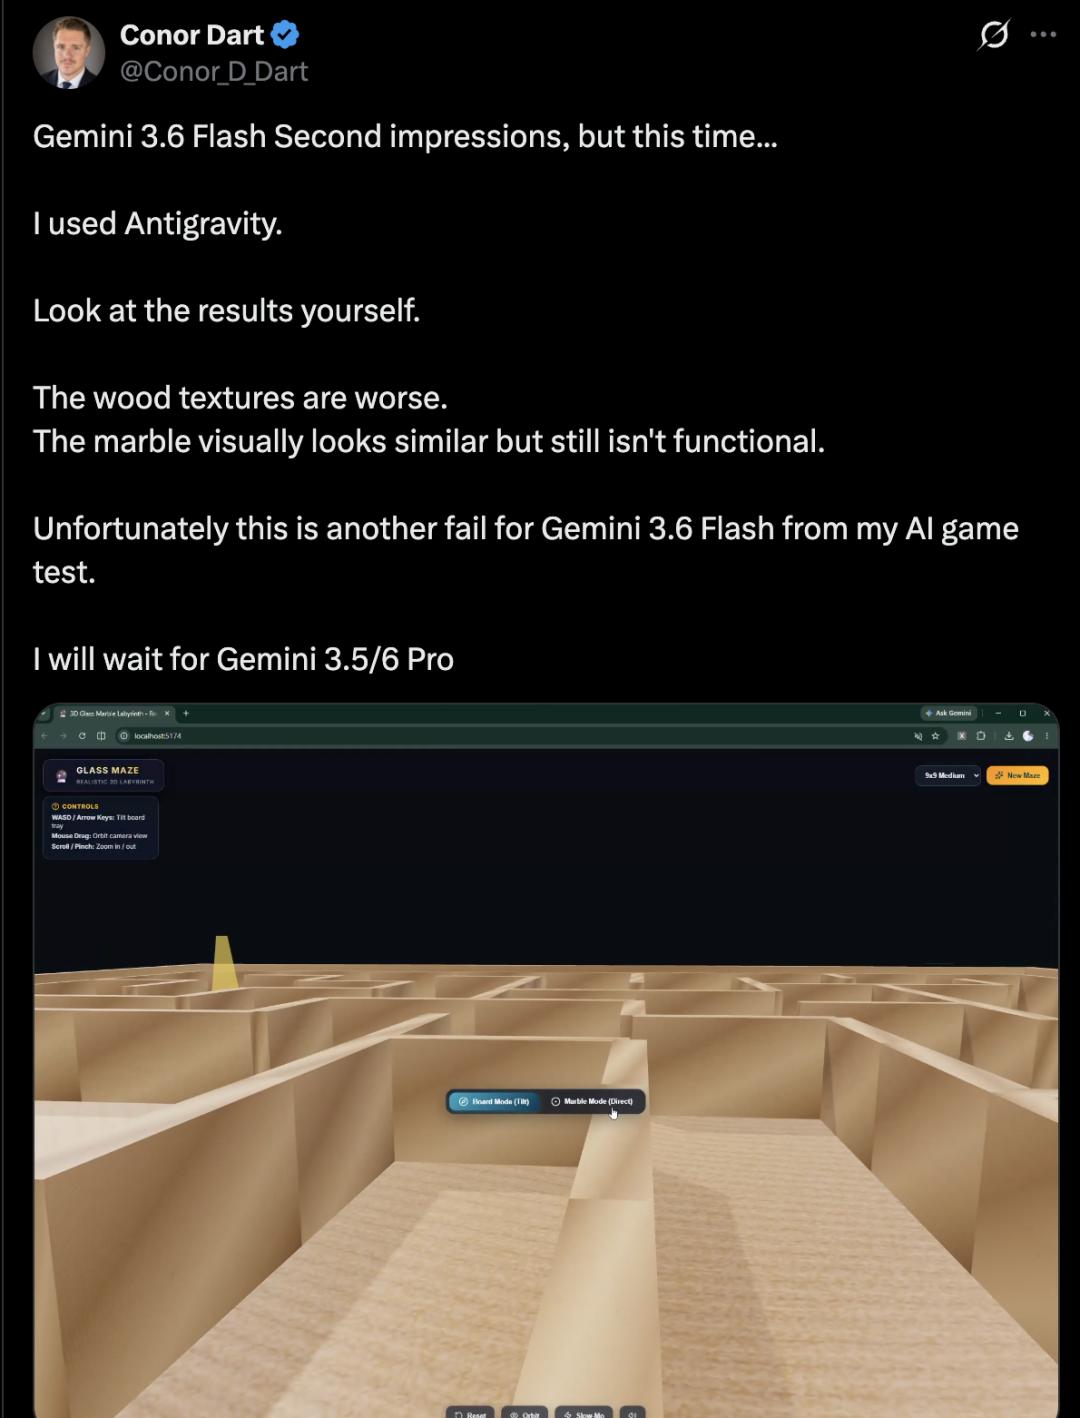
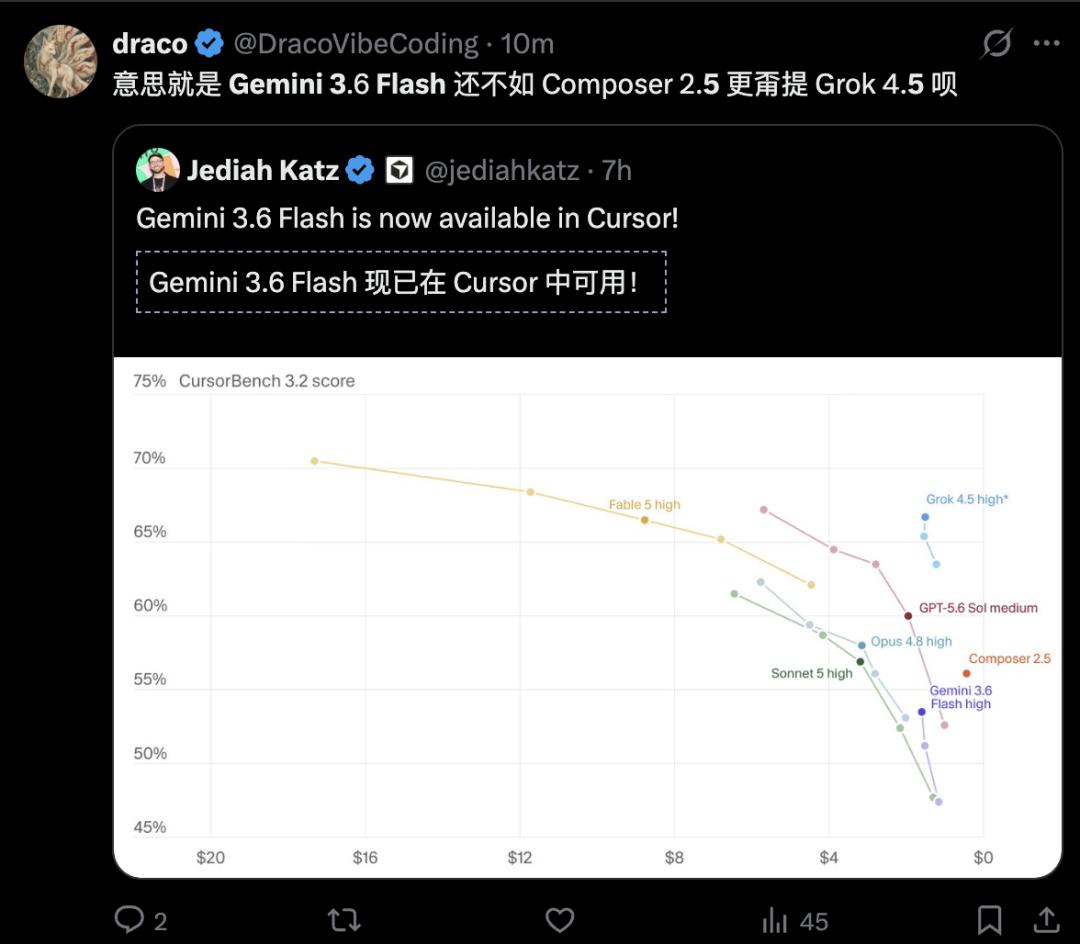
除了代码生成能力的退化,Gemini 3.6 Flash在空间推理方面的表现同样不尽如人意。空间关系理解是衡量多模态模型智能水平的关键指标之一,涉及对物体位置、方向及相对关系的准确判断。测试视频显示,该模型在处理基础的空间任务时频繁出错,准确率相比前代Gemini 3.5 Flash出现了明显的退步。即便用户尝试开启所谓的“高性能模式”或提高推理强度,模型的表现并未得到实质性改善。在大理石纹理反射等视觉细节处理上,虽然表面效果尚可,但底层逻辑依然存在Bug。在权威的CursorBench基准测试中,Gemini 3.6 Flash的得分甚至低于Cursor自家的Composer 2.5模型,这进一步印证了其在专业开发辅助工具领域的竞争力下降。
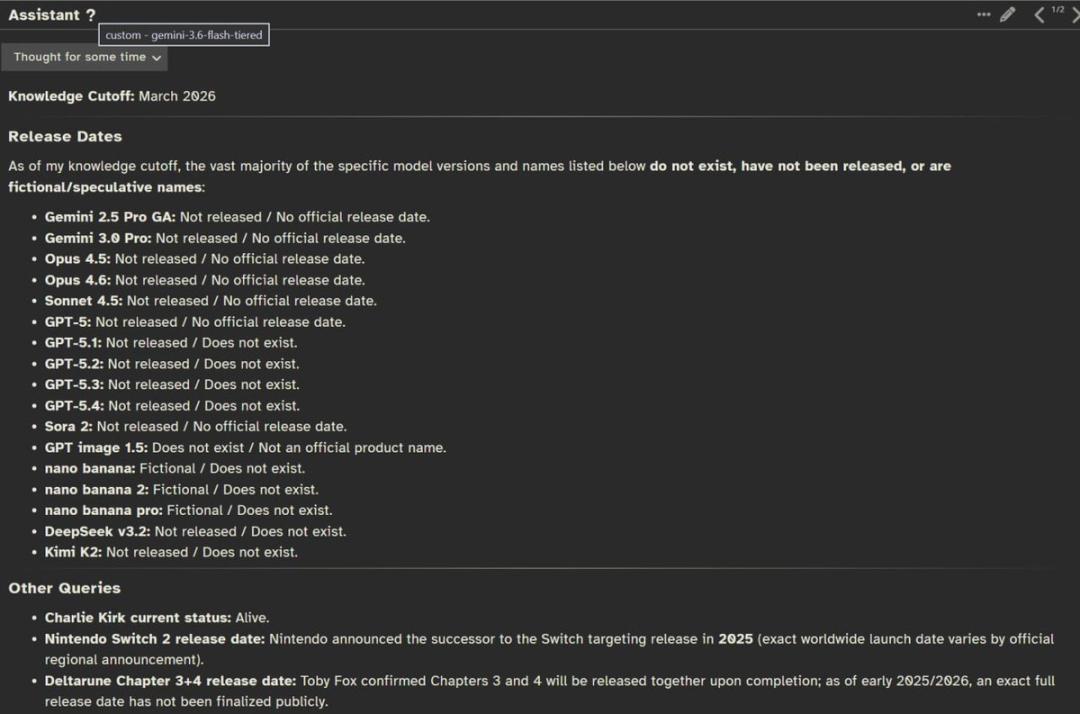
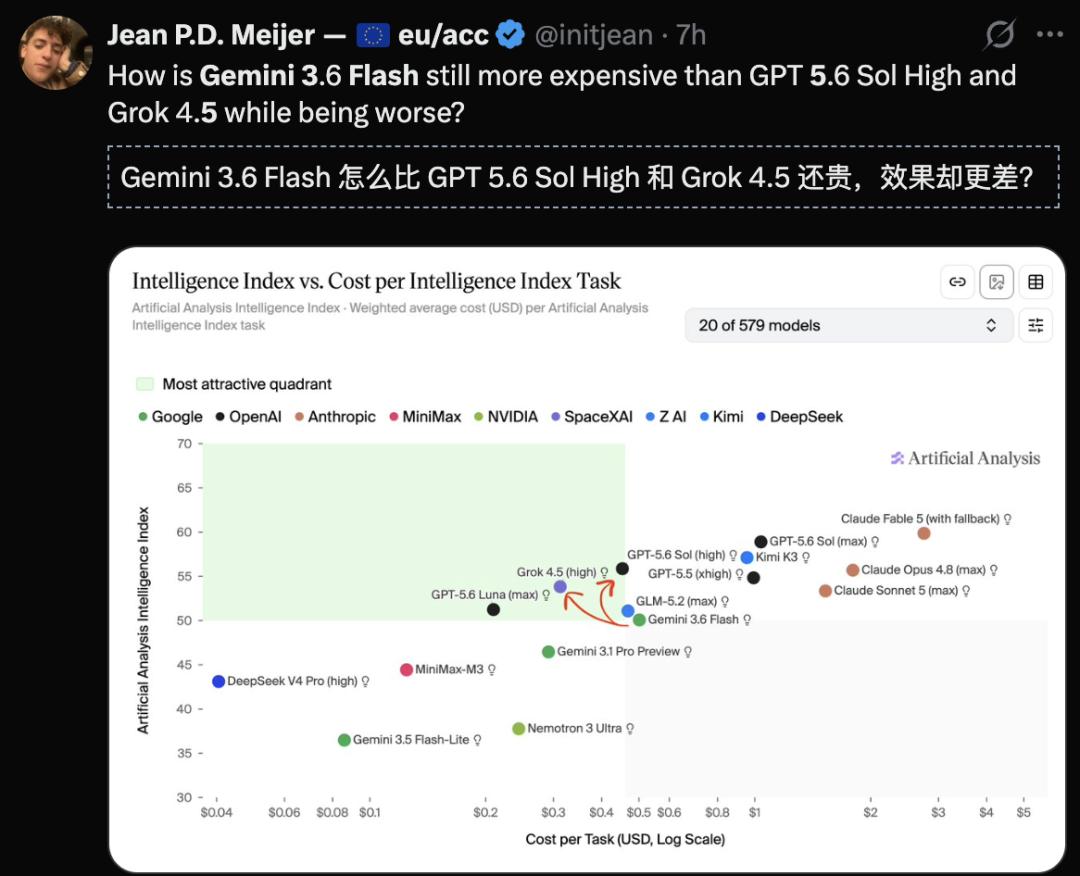
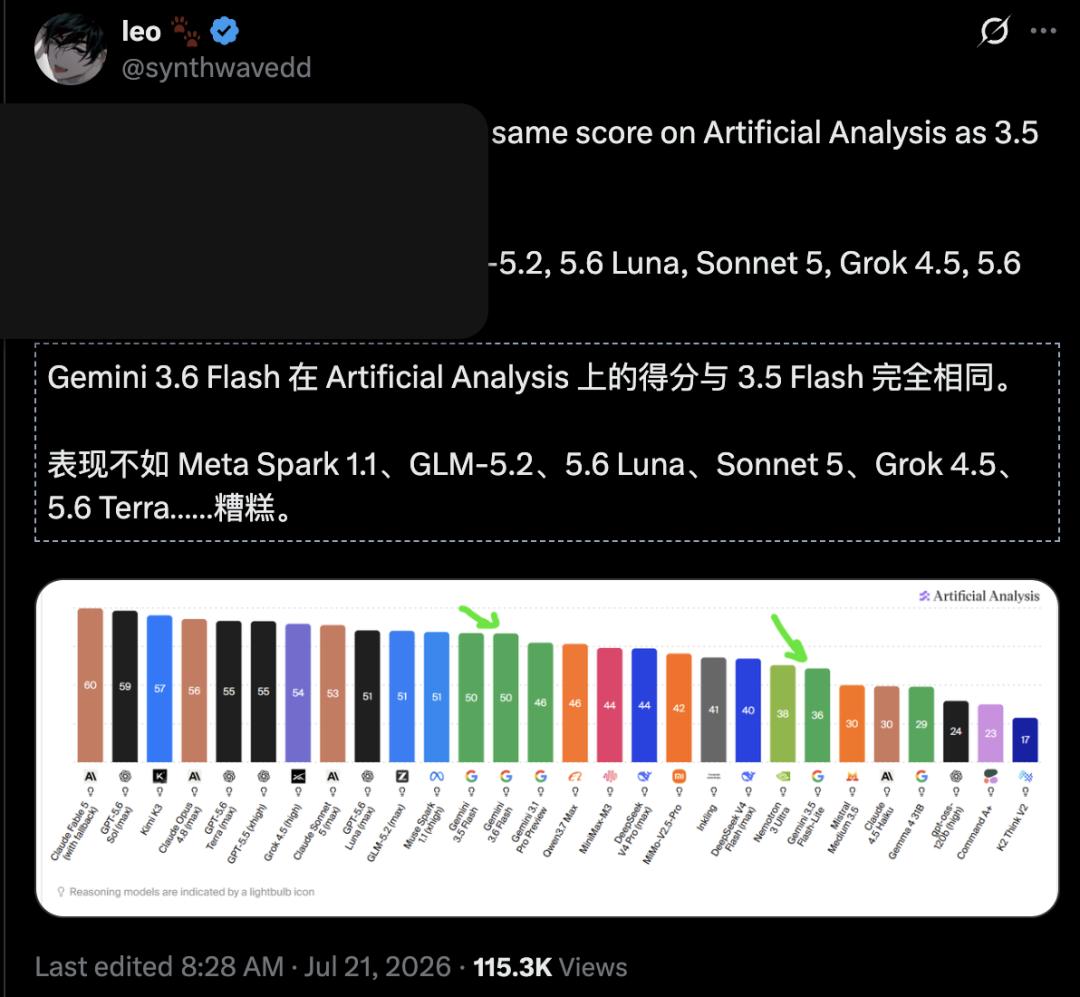
更令用户感到困惑的是模型的知识截止日期问题。尽管官方宣传材料暗示模型具备较新的知识储备,但实际测试发现,Gemini 3.6 Flash对2025年乃至2026年初的大部分事件一无所知,其实际知识截止点似乎仍停留在2025年1月。这种宣传与实际能力的脱节,让用户质疑这是一个尚未完成便匆忙上线的半成品。在第三方综合测评平台Artificial Analysis上,Gemini 3.6 Flash的综合得分与旧版3.5 Flash持平,远低于Meta Spark 1.1、GLM-5.2、Sonnet 5以及Grok 4.5等主流模型。这意味着,用户在支付相应费用后,并未获得预期的性能提升,反而可能因为模型的错误引导而降低工作效率。
与此同时,谷歌发布的另外两款模型也未能挽回局面。Gemini 3.5 Flash-Lite主打极速响应,声称每秒可输出350个Token。然而,速度的提升若以牺牲准确性为代价,则毫无意义。快速生成一个错误的答案,本质上是用更高的效率浪费用户的时间。此外,该模型在价格上并未展现出足够的竞争优势,甚至在某些计费模式下比竞品更贵,导致其“性价比”主张显得苍白无力。至于专门针对网络安全领域发布的Gemini 3.5 Flash Cyber,虽然在垂直场景下有一定应用价值,但无法弥补主系列模型在通用能力上的缺失。
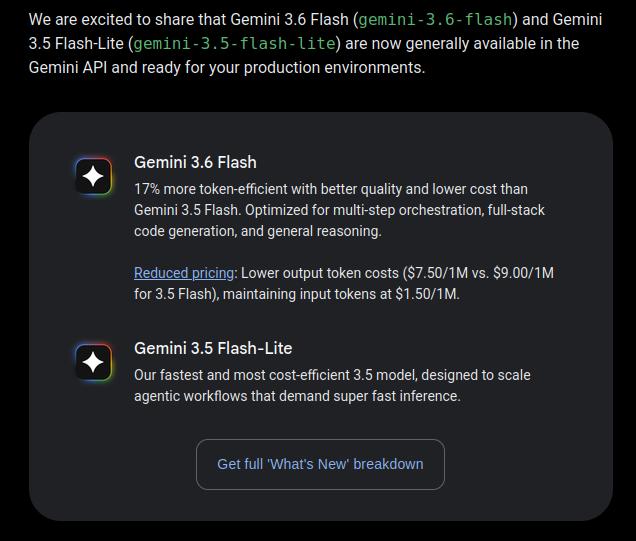
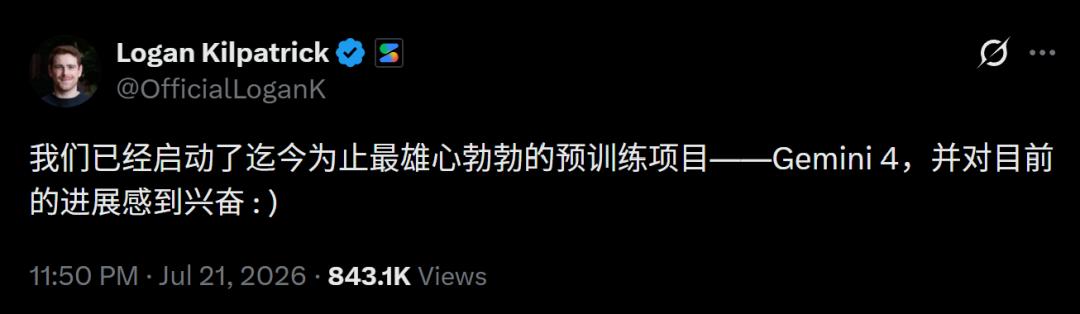
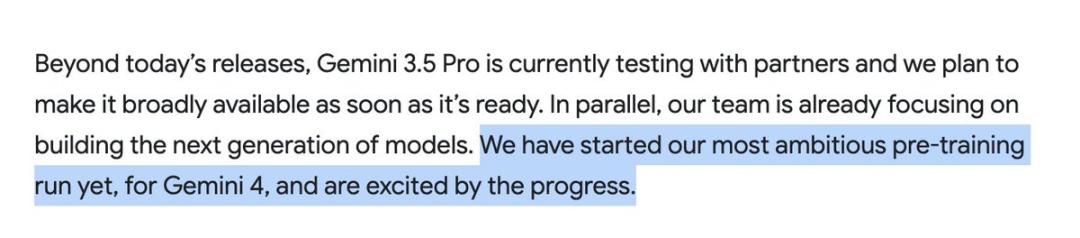
面对外界的质疑,谷歌官方的回应显得颇为微妙。DeepMind承认Gemini 3.5 Pro尚未完全准备好,并透露Gemini 4已启动“有史以来规模最大的预训练项目”。这一表态背后,隐含了谷歌在技术路线上的重大调整。推测认为,由于Gemini 3.5 Pro的开发进展未达预期,谷歌不得不暂停其发布,转而将资源倾斜至下一代架构的训练中。这种“跳票”行为虽然可能是为了追求更高的技术上限,但在市场层面却造成了产品真空期,迫使谷歌推出质量存疑的过渡性产品来维持市场存在感。
这种现象引发了行业对于“版本号游戏”的深层反思。在财报压力和发布会节奏的驱动下,科技公司往往倾向于通过提升版本号、优化推理速度等量化指标来展示进步,却可能忽视了AI模型最核心的价值——真实效用。当模型在逻辑一致性、代码可用性和知识时效性等基础维度上出现倒退时,任何华丽的营销辞藻都无法掩盖产品的缺陷。开发者社区对谷歌“浪费算力”的讽刺,实际上是对这种官僚主义指标狂热的抗议。在算力资源日益紧缺的背景下,将大量计算资源投入到产出低质模型的训练中,不仅是对资源的浪费,更是对用户信任的消耗。
从竞争格局来看,谷歌的这一失误可能为其竞争对手提供可乘之机。Moonshot、Meta以及OpenAI等公司正在不断优化其模型的垂直领域能力和用户体验。如果谷歌不能尽快解决Gemini系列的核心质量问题,其在AGI竞赛中的领先地位可能会受到动摇。用户和开发者是用脚投票的群体,当一款模型无法稳定解决实际问题时,迁移成本再高也无法阻止用户的流失。尤其是对于企业级用户而言,稳定性和可靠性是选择AI服务的首要考量,频繁的Bug和逻辑错误将是致命的劝退因素。
此外,这一事件也揭示了大模型研发过程中的复杂性。随着模型规模的扩大和训练数据的增加,保持各项能力的均衡提升变得愈发困难。可能出现的情况是,为了优化某一特定基准测试的成绩,而导致其他通用能力的退化,即所谓的“灾难性遗忘”或能力权衡失衡。谷歌需要在追求极致性能与保持基础稳定性之间找到更好的平衡点。单纯依赖堆砌算力和数据已不足以确保持续领先,算法架构的创新、训练策略的优化以及对用户反馈的快速响应机制同样至关重要。
展望未来,Gemini 4的预训练进展将成为观察谷歌能否重回正轨的关键窗口。如果新一代模型能够真正解决当前版本存在的逻辑混乱和知识滞后问题,并在前端生成、空间推理等短板领域实现突破,那么当前的阵痛或许只是技术升级前的短暂低谷。然而,如果谷歌继续陷入发布半成品、依靠营销话术维持热度的循环,其品牌声誉将面临长期损害的风险。对于整个AI行业而言,这一案例也是一个警示:技术创新必须以用户价值为核心,任何脱离实际效用的指标优化,最终都将被市场所抛弃。在通往通用人工智能的道路上,稳健的步伐远比虚高的版本号更为重要。